Metaは、2026年10月30日に発効するビジネス向けの「Meta商用利用規約」の改定版から、ウェブサイトから集めたコンテンツをAIの「トレーニング」に使えると読める文言を削除しました。
米国の報道機関Nieman Labが10月15日(米国時間)に「ニュースサイトのスクレイピングを許す条文だ」と報じ、批判が広がったことを受けた対応です。
ただ、規約の英語版を2026年10月18日に確認すると、Metaが自動ソフトウェアやテスト認証情報を使って関連サイトにアクセスできるという部分は残っていました。
日本語版はまだ旧文言のままです。Facebookページやインスタグラムを事業で使っている企業のSEO担当者や編集者にとっては、自社の記事がAIにどう扱われるかを左右し得る話です。
この記事では、何が変わり何が残ったのか、そしてクローラー設定で何を確認すべきかを整理していきます。
この記事のポイント
- 「トレーニング」の文言は英語版から削除
- 目的は広告・ビジネス製品向けなどに変更
- 自動ソフトウェアとテスト認証情報の許可は残る
- 日本語版は10月18日時点で旧文言
- AI学習用クローラーはrobots.txtで指定できる
本記事の内容は、2026年10月18日20時台(日本時間)に確認したMetaの規約ページ・公式ドキュメント・報道にもとづいています。規約は10月30日の発効までにさらに変わる可能性があるため、最新の条文もあわせて確認してください。
Meta商用利用規約の改定で何が問題になったのか
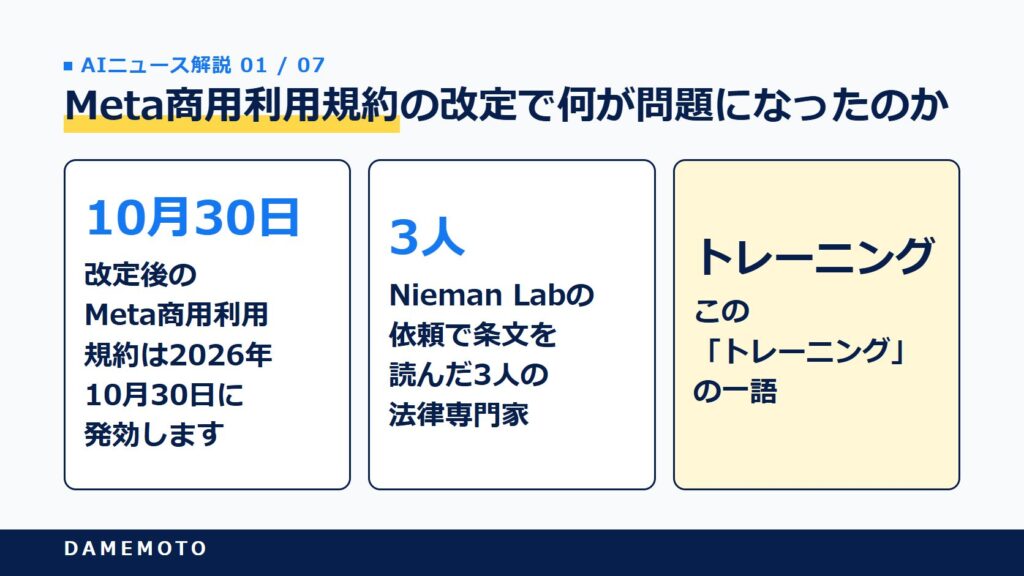
今回の騒動は、ビジネス向けの規約という、ふだんあまり読まれない文書から始まりました。Metaは10月初めにブログとMeta Business Suiteで改定を知らせていましたが、注目が集まったのはNieman Labの報道がきっかけです。
問題になった「スクレイピング許可」の条文
改定版の規約には、Metaが自動ソフトウェアとテスト認証情報を使い、事業者の商品やサービスに関連付けられたドメインやウェブページにアクセスし、収集できるという条文が入っていました。
自動ソフトウェアの例として、ウェブスクレーパー、ボット、スパイダー、クローラー、ユーザーエージェントが挙げられています。
さらに当初の条文は、集めたコンテンツをMeta製品の「提供、開発、改善、調査、トレーニング」に使えると続いていました。この「トレーニング」の一語が、AI学習への利用を認める条文ではないかと受け止められたわけです。
法律専門家が指摘した3つの論点
Nieman Labの依頼で条文を読んだ3人の法律専門家は、主に次の点を指摘しました。
- AI学習の許可になり得る:コーネル大学ロースクールのJames Grimmelmann教授は、ニュースサイトのコンテンツでAIを学習させる許可を意味すると述べました
- テスト認証情報で登録の壁を越えられる:同教授は、偽の利用者として登録し、登録が必要なページに入る余地があると指摘しました
- 抱き合わせに近い:ウィスコンシン大学のBenjamin Sobel教授は、ビジネス製品の利用とクロールの許可を結びつける点が、独占禁止法でいう「抱き合わせ」に似ていると述べました
メディア・知財分野の弁護士であるMatt Topic氏(Loevy & Loevy)は、「利用規約に紛れ込ませるには驚くべき条項だ」と批判し、ライセンス市場なら数百万ドル規模になり得る素材にMetaがアクセスできることになると述べています。
報道時点では、10月30日より前に新しい規約をオプトアウトする方法はなく、同意しない場合は事業目的での利用をやめるよう規約に書かれていました。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
Metaの反論と文言削除までの経緯
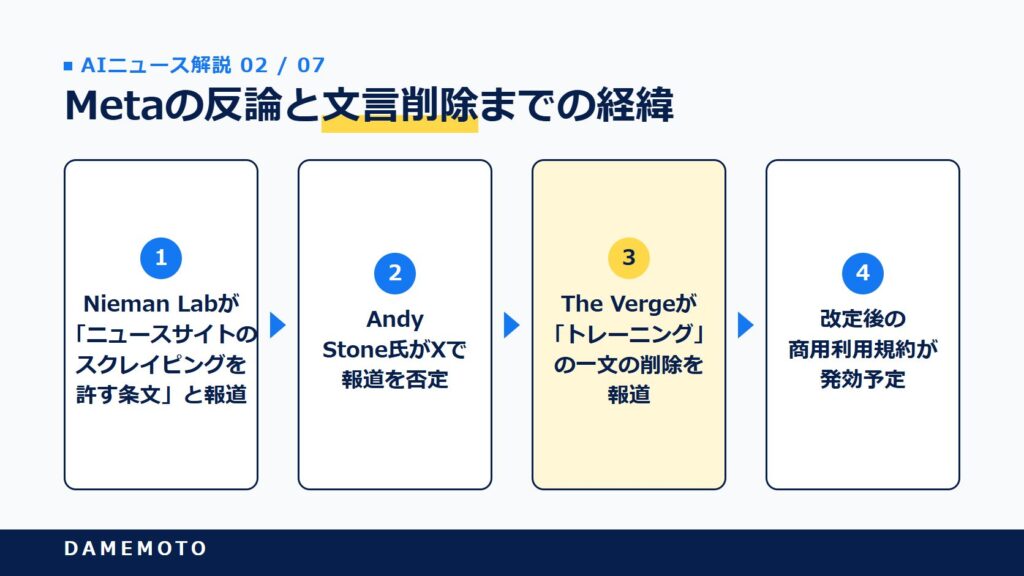
Metaの対応は、まず否定し、その後に条文そのものを直すという2段階でした。報道から文言の削除までは、日本時間で2日ほどです。
広報担当副社長は「クローラーの使い方は変わらない」と否定
Metaの広報担当副社長Andy Stone氏は、報道から約21時間後の10月16日夜(日本時間23時半ごろ)、Xで「これは誤り」と投稿しました。
Metaがウェブクローラーを使う方法に変更はなく、コンテンツの所有者はこれまでどおりrobots.txtで意向を示せるという説明です。
目的は、第三者サイトで売られている商品の正確な情報を広告やおすすめに使うことで、ニュースサイトのスクレイピングではないとしていました。

否定の声明だけでなく、条文が実際にどう直ったかまで見ておきたいところです
「トレーニング」を消し、目的を広告・ビジネス製品に限定
The Vergeは日本時間10月18日0時すぎ、問題の一文が商用利用規約のページから消えたと報じました。
広報担当のDaniel Roberts氏は、集約したクロール関連の条項は広告とビジネス製品にだけ適用されるもので、robots.txtで示した意向に優先する新たな権利を与えるものではないと説明しています。
TechCrunchも同日、文言の削除を伝えました。
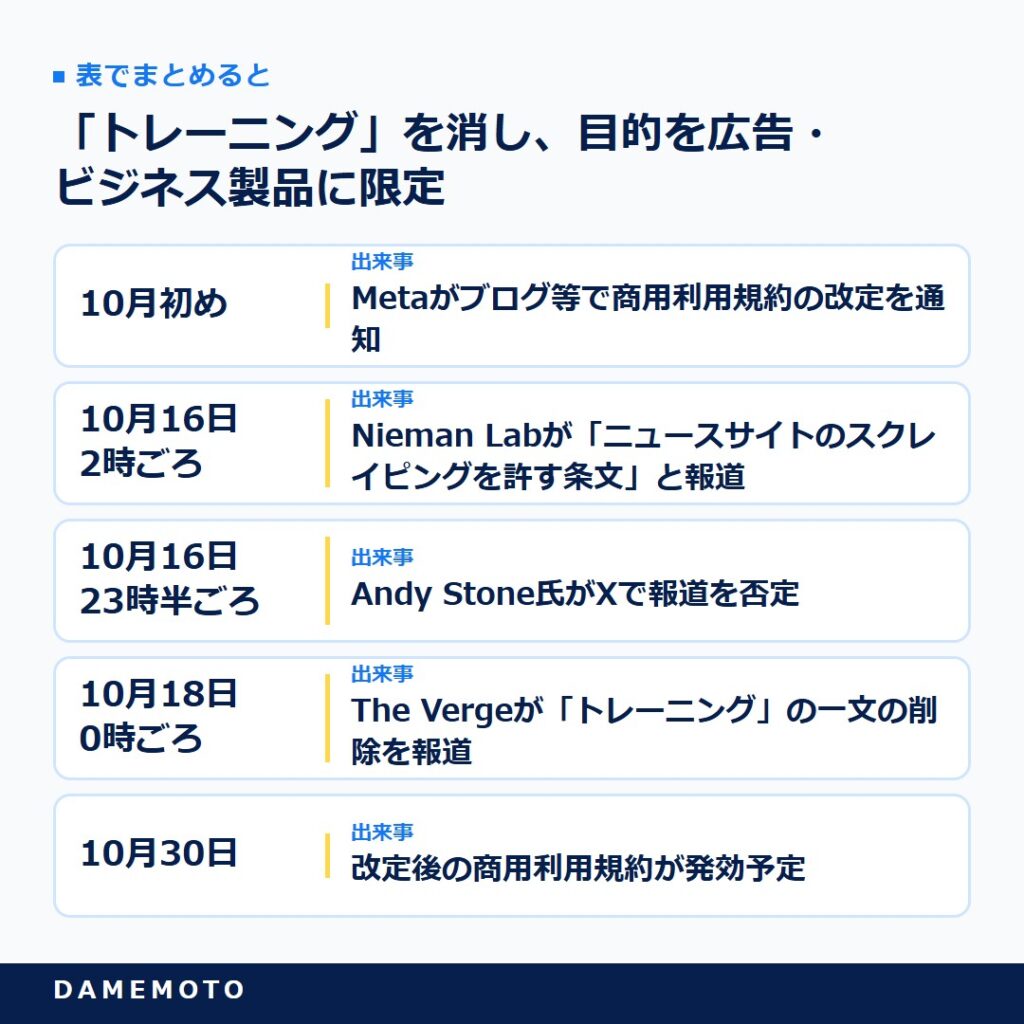
流れを時系列でまとめると、次のようになります。
表で詳しく見る
| 日時(日本時間) | 出来事 |
|---|---|
| 10月初め | Metaがブログ等で商用利用規約の改定を通知 |
| 10月16日 2時ごろ | Nieman Labが「ニュースサイトのスクレイピングを許す条文」と報道 |
| 10月16日 23時半ごろ | Andy Stone氏がXで報道を否定 |
| 10月18日 0時ごろ | The Vergeが「トレーニング」の一文の削除を報道 |
| 10月30日 | 改定後の商用利用規約が発効予定 |
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
改定後の規約で削除された点と残った点
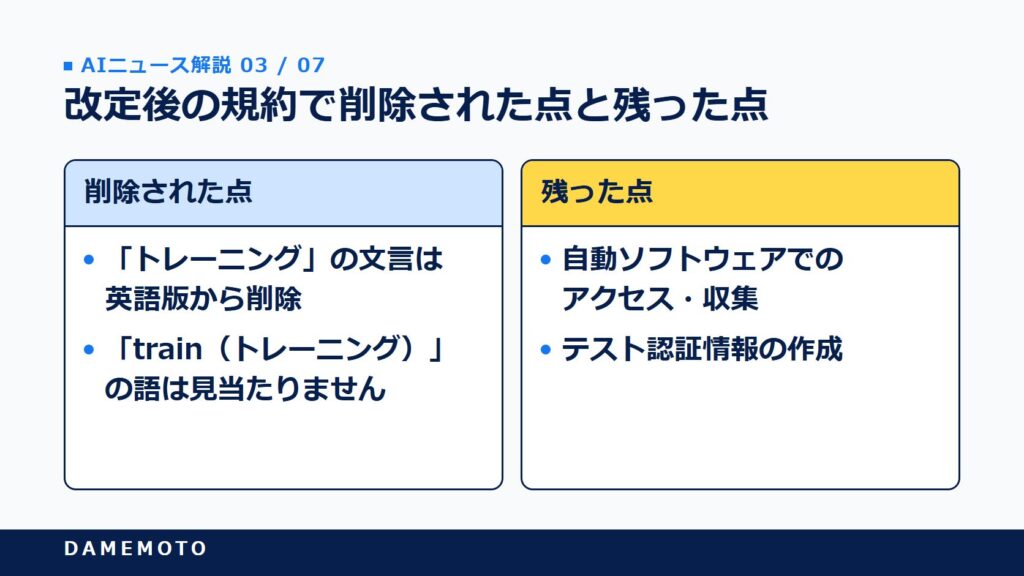
「削除された」という見出しだけを読むと、条文がまるごと消えたように感じるかもしれませんね。実際に英語版の最新条文を読むと、消えた部分と残った部分がはっきり分かれています。
英語版の最新条文で確認できたこと
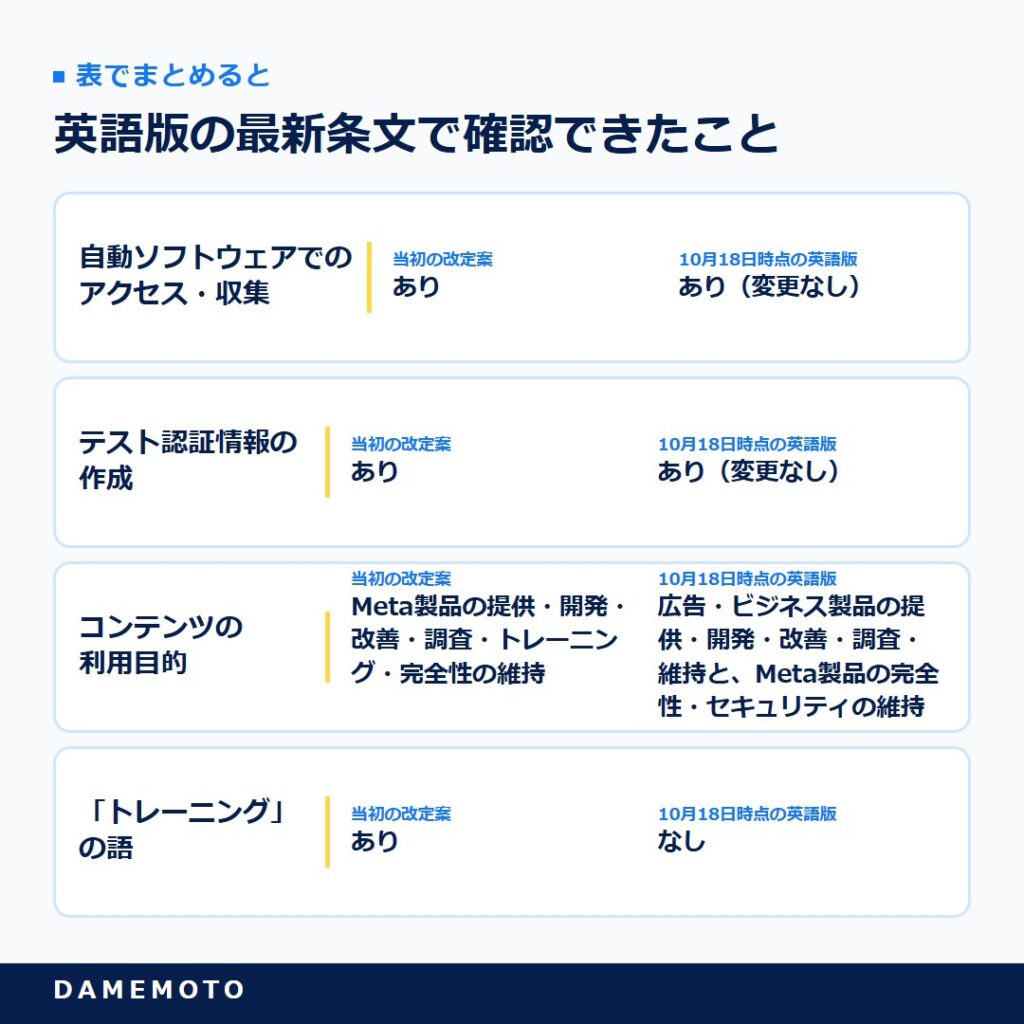
2026年10月18日に英語版の改定規約を確認したところ、集めたコンテンツの利用目的は広告・ビジネス製品の提供・開発・改善・調査・維持と、Meta製品の完全性・セキュリティの維持に書き換えられていました。
「train(トレーニング)」の語は見当たりません。
表で詳しく見る
| 項目 | 当初の改定案 | 10月18日時点の英語版 |
|---|---|---|
| 自動ソフトウェアでのアクセス・収集 | あり | あり(変更なし) |
| テスト認証情報の作成 | あり | あり(変更なし) |
| コンテンツの利用目的 | Meta製品の提供・開発・改善・調査・トレーニング・完全性の維持 | 広告・ビジネス製品の提供・開発・改善・調査・維持と、Meta製品の完全性・セキュリティの維持 |
| 「トレーニング」の語 | あり | なし |
一方で、自動ソフトウェアとテスト認証情報を使ったアクセスの許可はそのまま残っています。テスト認証情報で有料記事などを回避するのかというNieman Labの質問に、Metaは答えていません。ここは今後も注目しておきたい点だと思います。
日本語版は旧文言のまま(2026年10月18日確認)
同じ時刻に日本語版の改定規約を開くと、「提供、開発、改善、調査、トレーニング、およびその完全性を維持する目的で使用することができます」という旧文言がまだ残っていました。英語版と日本語版で中身が食い違っている状態です。
翻訳の更新が遅れているだけの可能性が高いでしょう。とはいえ、日本の事業者が規約を確認するときは、日本語版だけで判断せず英語版もあわせて見ておくほうが安心です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
このニュースで誰の何が変わるのか
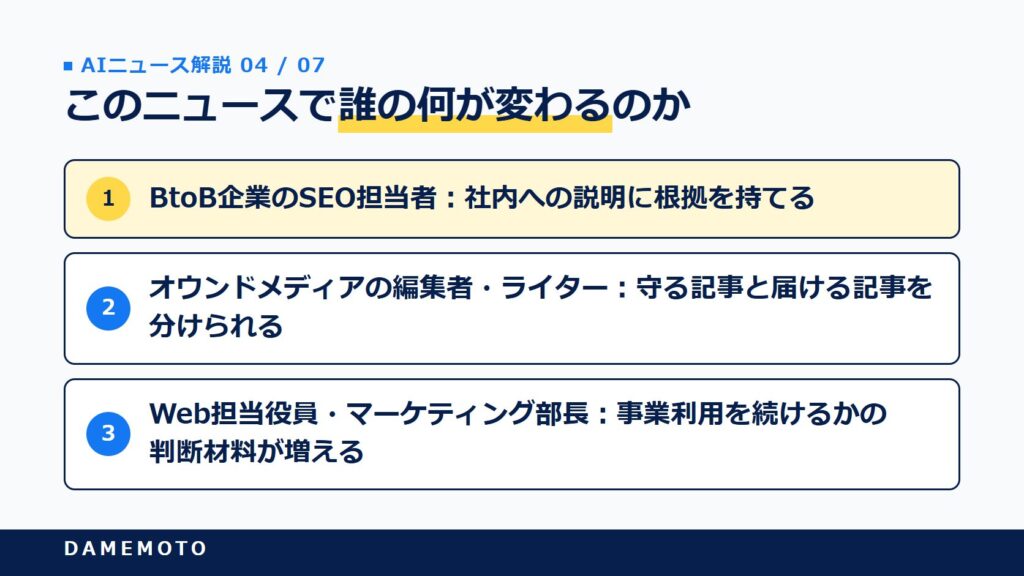
規約の一文が消えたというニュースは、立場によって意味がまったく違ってきます。ここでは、影響が大きい3つの立場ごとに、いま抱えている悩みと、このニュースで変わること、明日からやることを整理してみます。
BtoB企業のSEO担当者:社内への説明に根拠を持てる
Facebookページや広告を運用していると、「うちの記事がMetaのAIに使われるのでは」と上司に聞かれて、答えに詰まることがありますよね。
今回、英語版の条文から「トレーニング」が消え、利用目的が広告・ビジネス製品向けなどに書き換えられたことで、条文と公式ドキュメントを根拠に、現時点の状況を説明できるようになりました。
明日からやることは2つです。
自社サイトのrobots.txtにMetaのクローラーの指定があるかを確認すること、そして10月30日の発効前に英語版の最終的な条文をもう一度読むことです。
AI企業ごとのクローラーと規約を確かめて社内の方針として残す作業は、今後SEO担当者の定常業務になっていく可能性があります。
オウンドメディアの編集者・ライター:守る記事と届ける記事を分けられる
時間をかけて書いた記事が、知らないうちにAIの材料になるのは落ち着かないものです。一方で、AI検索で引用されれば新しい読者に届くかもしれません。
公式ドキュメント上、AI学習(Meta-ExternalAgent)とAI検索(Meta-WebIndexer)は別のクローラーなので、robots.txtで分けて設定できます。
ただし、規約にもとづく収集とこれらのクローラーの対応関係を、Metaは明示していません。
ただし、自動ソフトウェアとテスト認証情報によるアクセスの許可は残っています。
会員登録が必要な記事を持つメディアなら、どの記事を公開し、どの記事を登録の内側に置くかを見直すきっかけになるでしょう。
記事ごとに「引用されたいか、学習に使われたくないか」を決める運用が広がっていくと考えられます。
Web担当役員・マーケティング部長:事業利用を続けるかの判断材料が増える
改定のお知らせには、同意しない場合は事業目的での利用をやめるよう書かれています。広告や集客をMetaに頼っている会社にとって、利用をやめるのは現実的ではないかもしれません。
今回の削除で、「Meta製品全般のトレーニングに使える」と読める直接の根拠だった一語は、英語版の条文から消えました。
ただ、広告・ビジネス製品の開発や改善にAIの学習が含まれるかどうかまでは、条文に書かれていません。
判断の前にやることは、10月30日時点の英語版の条文と日本語版の食い違いを担当者に確認してもらうことです。主要なプラットフォームの規約変更を定期的に追う体制は、今後リスク管理の一部として求められていく可能性があります。
サイト運営者が確認したいMetaのクローラーとrobots.txt
Metaは一貫して「robots.txtで意向を示せる」と説明しています。では、どのクローラーを止めると何が起きるのでしょうか。公式ドキュメントで確認していきましょう。
Metaの5つのクローラーと役割
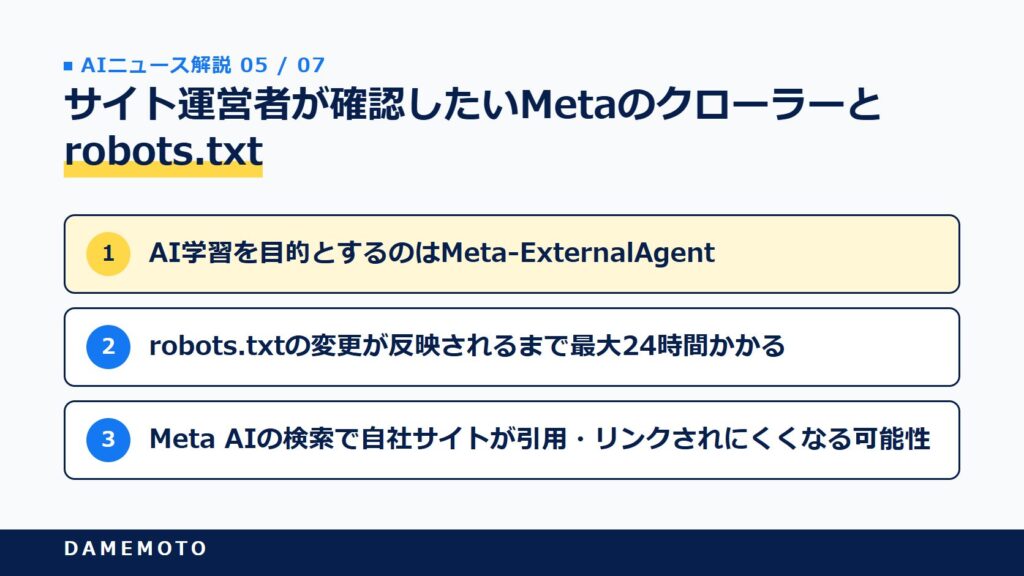
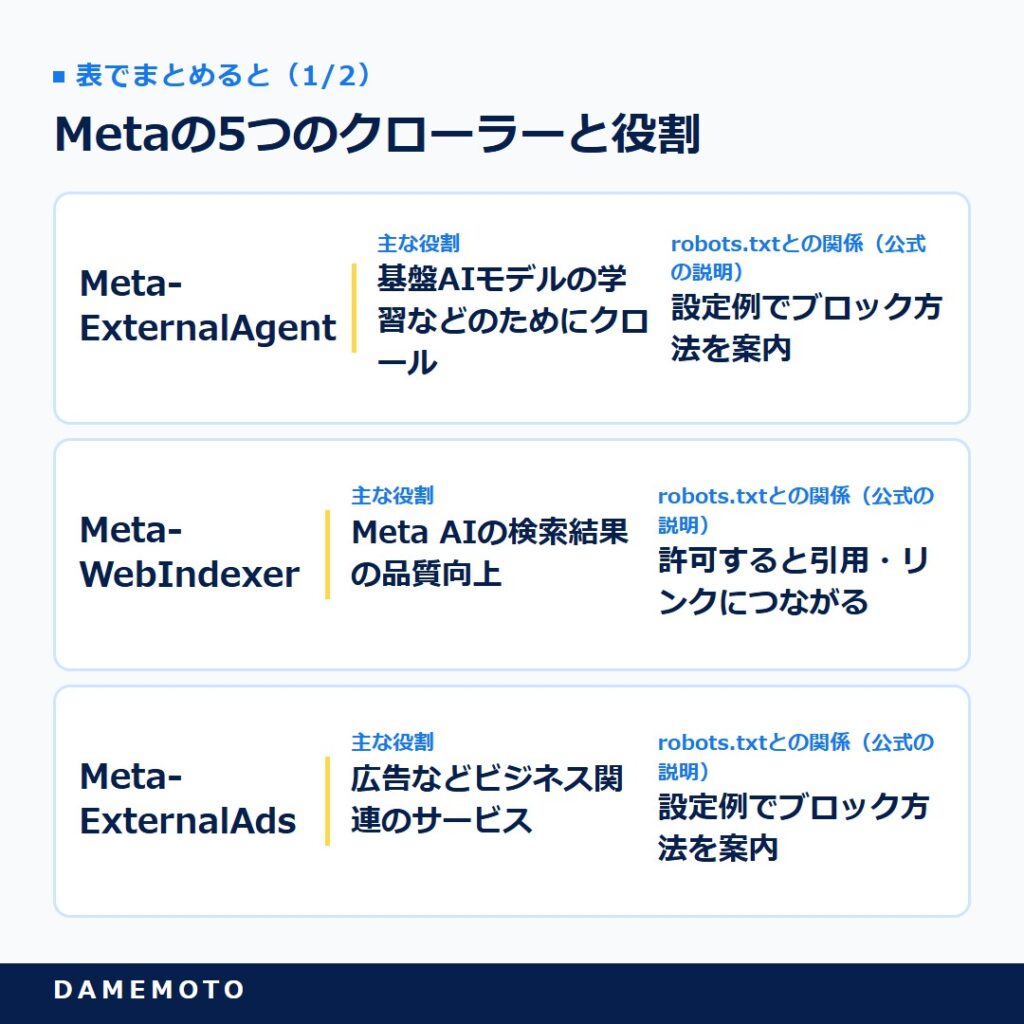
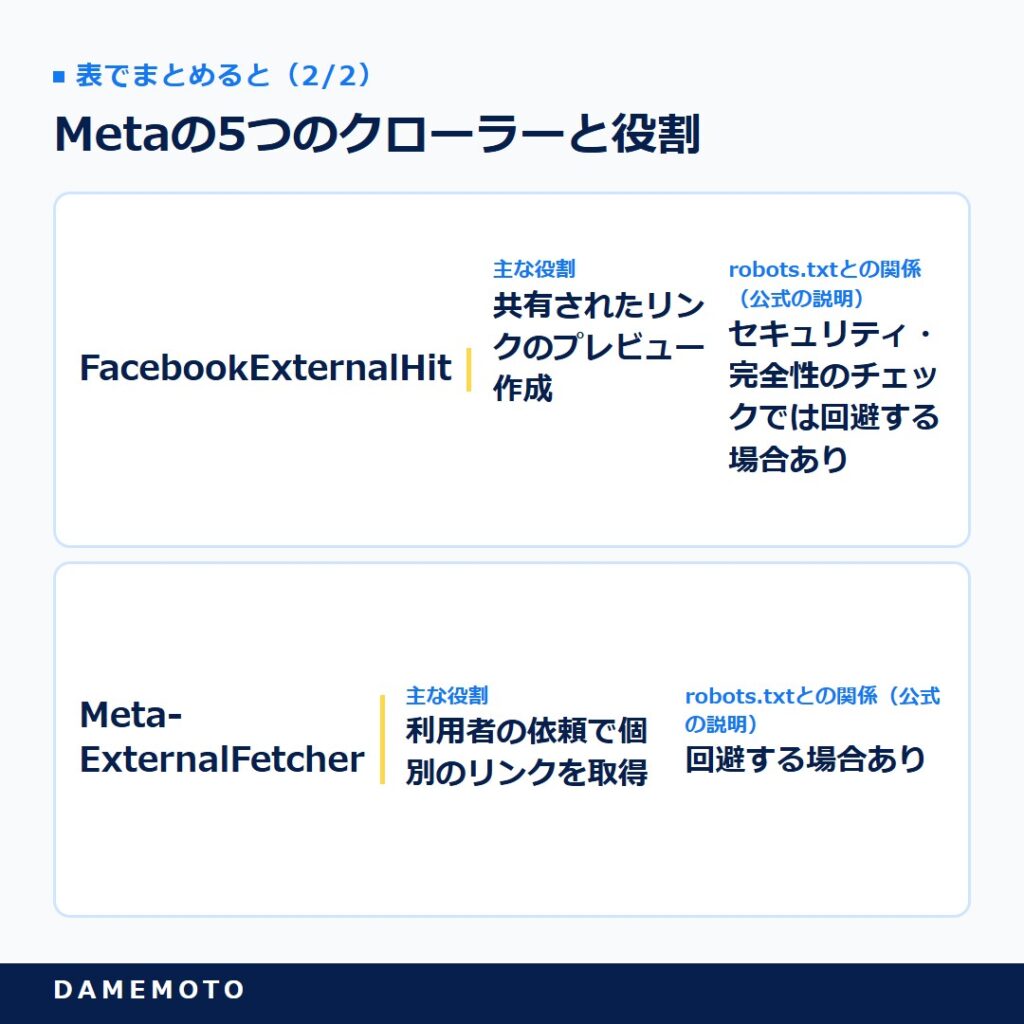
Metaの開発者向けドキュメントには、5つのクローラーが載っています。AI学習を目的とするのはMeta-ExternalAgentで、基盤AIモデルの学習などのためにウェブを巡回すると説明されています。
表で詳しく見る
| クローラー | 主な役割 | robots.txtとの関係(公式の説明) |
|---|---|---|
| Meta-ExternalAgent | 基盤AIモデルの学習などのためにクロール | 設定例でブロック方法を案内 |
| Meta-WebIndexer | Meta AIの検索結果の品質向上 | 許可すると引用・リンクにつながる |
| Meta-ExternalAds | 広告などビジネス関連のサービス | 設定例でブロック方法を案内 |
| FacebookExternalHit | 共有されたリンクのプレビュー作成 | セキュリティ・完全性のチェックでは回避する場合あり |
| Meta-ExternalFetcher | 利用者の依頼で個別のリンクを取得 | 回避する場合あり |
今回の規約が触れている広告・ビジネス製品向けの収集は、名前からするとMeta-ExternalAdsの領域に近いと考えられます。ただし規約とクローラーの対応関係をMetaは明示していないため、ここは推測の域を出ません。
robots.txtの設定例と注意点
AI学習への利用を避けたい場合は、Meta-ExternalAgentを指定してブロックします。公式ドキュメントの設定例を参考に、サイト全体を対象にするなら次のように書きます。
User-agent: meta-externalagent
Disallow: /公式ドキュメントはMeta-ExternalAgentの用途として商品の改善も挙げているため、止めるとその用途も対象になる点は押さえておきたいところです。
もう一つ注意したいのは、robots.txtの変更が反映されるまで最大24時間かかることです。
Metaのクローラーはrobots.txtの内容を最大24時間キャッシュすると公式に書かれています。
また、Meta-WebIndexerまで止めると、Meta AIの検索で自社サイトが引用・リンクされにくくなる可能性があります。
止めたい用途と残したい用途を分けて、クローラーごとに決めるのが現実的だと感じます。
ほかのAIクローラーも含めた全体の考え方は、LLMO対策完全ガイドで整理しています。
DAMEMOTO代表鈴木ブロックする前に、AI検索で引用されたいかどうかも考えておきたいですね
よくある質問
- Metaは自社サイトの記事をAI学習に使えるようになったのですか?
-
2026年10月18日時点の英語版の改定規約では「トレーニング」の文言は削除され、利用目的は広告・ビジネス製品の提供・開発・改善・調査・維持と、Meta製品の完全性・セキュリティの維持に書き換えられています。ただし発効は10月30日で、それまでに条文が変わる可能性もあります。
- 改定後のMeta商用利用規約はいつから有効になりますか?
-
Metaの規約ページによると、改定後のMeta商用利用規約は2026年10月30日に発効します。
- Meta商用利用規約はどんな事業者が対象になりますか?
-
広告の利用、商品の販売、ページやグループの管理など、事業や商用の目的でMetaの製品を使う場合に商用利用規約が適用されます。Facebookページやインスタグラムを事業で運用しているサイトも含まれます。
- robots.txtでMetaのAI学習用クローラーを止められますか?
-
Metaの公式ドキュメントは、AI学習などに使うMeta-ExternalAgentをrobots.txtで指定する設定例を載せています。サイト全体を止めるなら「Disallow: /」と書きます。反映まで最大24時間かかる点に注意してください。
- robots.txtを守らない可能性があるMetaのクローラーはありますか?
-
公式ドキュメントでは、利用者の依頼でリンクを取得するMeta-ExternalFetcherはrobots.txtを回避する場合があり、FacebookExternalHitもセキュリティや完全性のチェックでは回避する場合があると説明されています。
- Meta商用利用規約の日本語版はどうなっていますか?
-
2026年10月18日に確認した時点では、日本語版の改定規約に「トレーニング」を含む旧文言が残っていました。英語版とあわせて確認することをおすすめします。
- Metaの新しい規約に同意したくない場合はどうなりますか?
-
改定のお知らせには、同意しない場合は事業目的または商用目的でのMeta製品の利用をやめるよう記載されています。Nieman Labの報道時点では、10月30日より前に新しい規約をオプトアウトする方法はありませんでした。
まとめ
Metaは批判を受けて、商用利用規約の改定版から「トレーニング」の文言を消し、利用目的を広告・ビジネス製品向けなどに書き換えました。
とはいえ、自動ソフトウェアとテスト認証情報によるアクセスの許可は残っており、日本語版は10月18日時点で旧文言のままです。
- 発効日の10月30日までは、英語版の条文の変化を追う
- AI学習を避けたいならMeta-ExternalAgentをrobots.txtで指定する
- AI検索での引用を残したいならMeta-WebIndexerは許可したままにする
AIの学習や検索とサイトの関係は、規約の一文で大きく変わります。大事なのは、見出しだけで判断せず条文と公式ドキュメントで確かめることでしょう。
AI検索との付き合い方全体は、AI検索最適化とは?AIO・LLMO・GEO・AEOの違いと統合戦略もあわせて読んでみてください。
参考・出典
- Meta「Meta Commercial Terms(改定版・英語)」:https://www.facebook.com/legal/commercial_terms_preview?locale=en_US
- Meta「Meta商用利用規約(改定版・日本語)」:https://www.facebook.com/legal/commercial_terms_preview
- Meta for Developers「Meta Web Crawlers」:https://developers.facebook.com/docs/sharing/webmasters/web-crawlers
- Andy Stone氏(Meta広報担当副社長)のX投稿:https://x.com/andymstone/status/2111101865769201850
- Nieman Lab「Meta’s new commercial terms will allow the scraping of news sites, legal experts say」:https://www.niemanlab.org/2026/10/metas-new-commercial-terms-will-allow-the-scraping-of-news-sites-legal-experts-say/
- The Verge「Meta removes language that may have allowed it to scrape news sites」:https://www.theverge.com/tech/1013409/meta-removes-language-that-may-have-allowed-it-to-scrape-news-sites
- TechCrunch「Meta removes language that raised scraping and AI training concerns」:https://techcrunch.com/2026/10/17/meta-removes-language-that-raised-scraping-and-ai-training-concerns/






