中国のAI企業DeepSeekは2026年10月17日、自社開発の検索エンジンを外部から使える「Search API」と、指定したページの内容をMarkdownで取り出す「Fetch API」を一般公開しました。
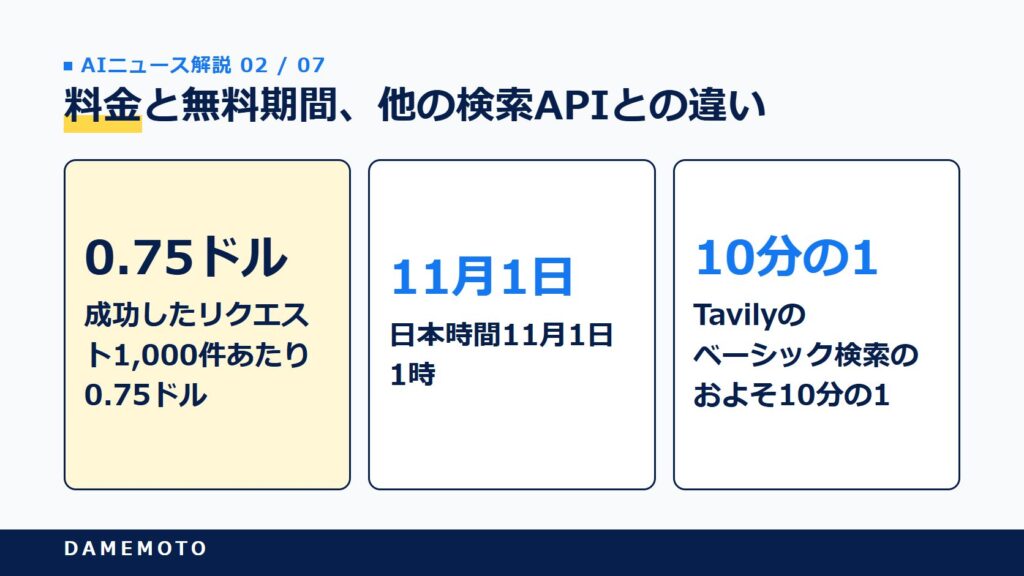
料金はどちらも成功したリクエスト1,000件あたり0.75ドルです。
AIエージェントが調べものに使う「検索の入口」が安く増えることは、AI検索での引用を狙うSEO担当者や編集者にとって、自社の記事がどう選ばれるかに関わる話といえます。
DeepSeekは、この検索エンジンがSEOスパムやGEO操作、低品質なAI生成コンテンツを除外すると公式の更新履歴で明言しました。
検索結果には情報源の権威性を示すスコアも付きます。この記事では、2つのAPIの中身と料金、他の検索APIとの違い、そして日本の企業が使う前に確認したい点を整理していきます。
この記事のポイント
- Search APIとFetch APIを2026年10月17日に一般公開
- 料金はどちらも成功1,000件あたり0.75ドル
- Harness・Claude Code・Codex経由の呼び出しは日本時間11月1日1時まで無料
- SEOスパム・GEO操作・低品質AIGCを除外すると明記
- 結果に権威度(authority)のスコアが付く
本記事の内容は、2026年10月19日16時台(日本時間)に確認したDeepSeekの公式ドキュメント・料金表・更新履歴と、各社の報道にもとづいています。
同日に公開されたモデル「DeepSeek-V4.1-Flash-1017」の性能比較は扱わず、検索APIがサイト運営者に与える影響に絞ってまとめます。
DeepSeekが公開したSearch APIとFetch APIとは
AIに最新の情報を答えさせるには、どこかでウェブを検索し、ページを読み込む仕組みが要りますよね。DeepSeekはその2つの部品を、それぞれ単独のAPIとして売り出しました。
検索するSearch APIと、ページを読むFetch API
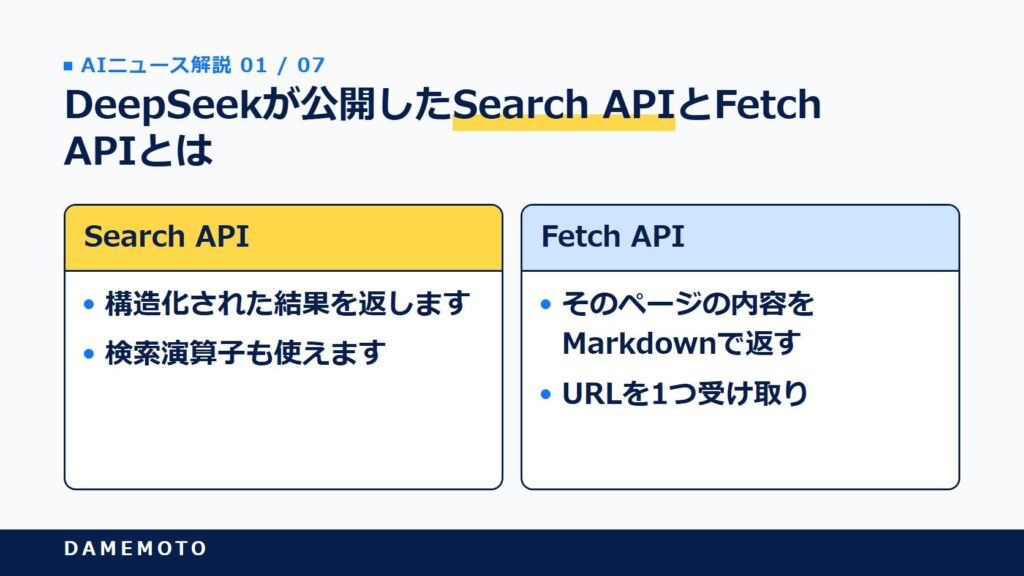
公式ガイドによると、Search APIは検索語を受け取ってウェブページを探し、構造化された結果を返します。
Fetch APIはURLを1つ受け取り、そのページの内容をMarkdownで返す仕組みです。AIエージェントが「探す」と「読む」を分けて呼び出す使い方を想定しています。
DeepSeekは公式ニュースで「Search & Fetch APIs are now open to everyone!」と発表し、X(旧Twitter)でも日本時間10月17日17時35分に告知しました。
基盤は自社開発の検索エンジンで、世界で1日に数億件のリクエストを処理しているとしています。
数千億ページを索引するAIネイティブの検索エンジン
10月17日付の更新履歴では、DeepSeek Searchを数千億のウェブページを索引するAIネイティブの汎用検索エンジンと説明しています。多言語検索にも対応しているとのことです。検索演算子も使えます。
- site: / -site::特定のサイトに絞る・除く
- “フレーズ” / -語:完全一致で探す・語を除く
- lang::言語で絞る(例:lang:zh,en)
- after: / before::公開日で絞る
日付で絞れる点は、ニュースや最新情報を扱うAIにとって大きいと感じます。古い記事より新しい記事が選ばれやすくなる場面が増えるかもしれません。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
料金と無料期間、他の検索APIとの違い
今回いちばん話題になっているのは価格でしょう。AIに検索させる仕組みは便利な反面、呼び出すたびに費用がかかるのが悩みどころでした。
成功した1,000件あたり0.75ドル、失敗は無料
公式の料金表とガイドによると、Search・Fetchとも成功したリクエスト1,000件あたり0.75ドルです。課金されるのは、HTTP 200で結果やページ内容が返ったときだけ。
失敗・空の結果・タイムアウトは課金されず、1回で受け取る件数(最大50件)を増やしても料金は変わりません。
もう一つ見落とせないのが無料期間です。
DeepSeek Harness・Claude Code・CodexでDeepSeek APIを使っている場合、サーバー側のツール呼び出しで両APIがすでに使われています。
この呼び出しは現在無料で、北京時間2026年11月1日0時(日本時間11月1日1時)から1件ごとの課金が始まります。
Tavilyの公開料金と比べると
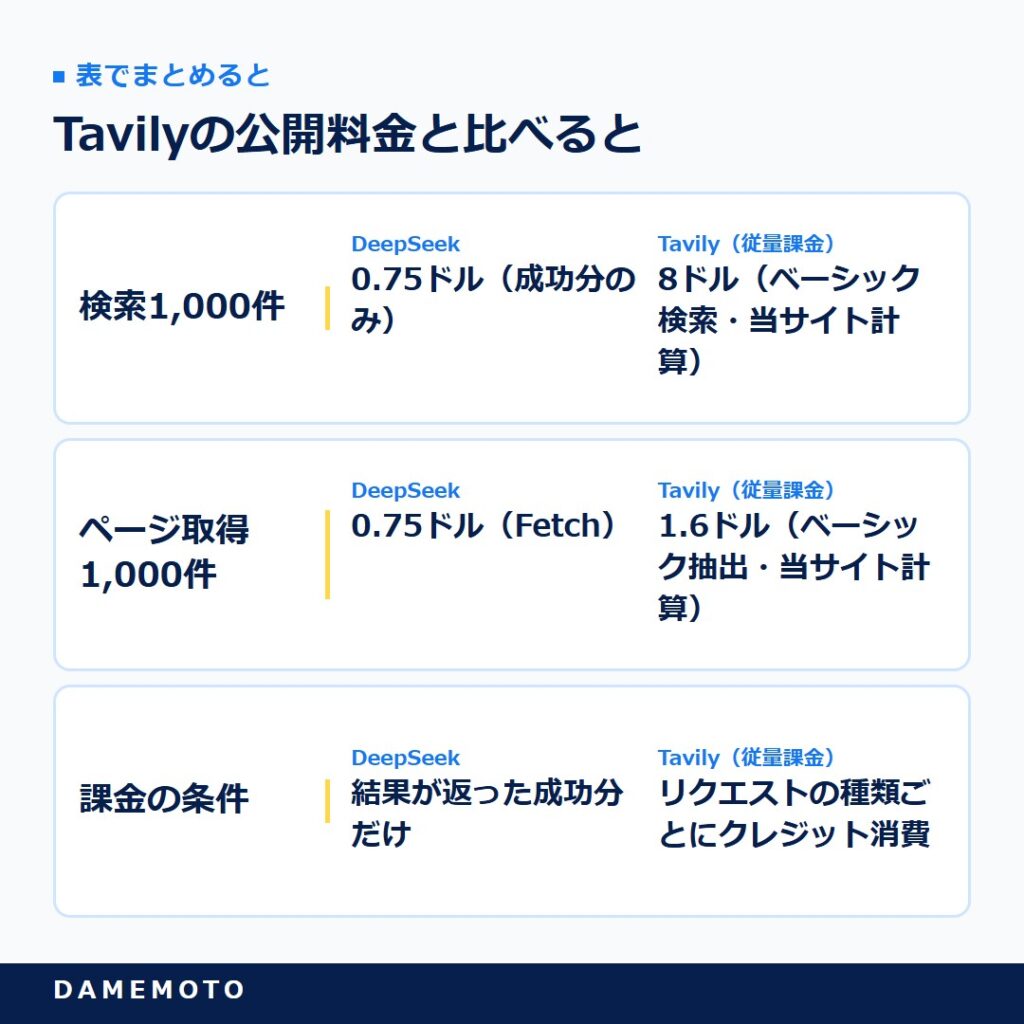
AIエージェント向け検索APIとして使われているTavilyの公開料金と並べてみます。Tavilyは従量課金で1クレジット0.008ドル、ベーシック検索は1リクエスト1クレジットです。
表で詳しく見る
| 項目 | DeepSeek | Tavily(従量課金) |
|---|---|---|
| 検索1,000件 | 0.75ドル(成功分のみ) | 8ドル(ベーシック検索・当サイト計算) |
| ページ取得1,000件 | 0.75ドル(Fetch) | 1.6ドル(ベーシック抽出・当サイト計算) |
| 課金の条件 | 結果が返った成功分だけ | リクエストの種類ごとにクレジット消費 |
数字だけを見ると、検索1,000件あたりの料金はTavilyのベーシック検索のおよそ10分の1です。ただし検索の質や対応言語、使える機能は同じではありません。
価格だけで乗り換えを決めるより、自社の用途で結果の質を試してから判断するほうが安全でしょう。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
検索結果に付く権威度とSEOスパム除外の仕組み
SEOに携わる人にとって、いちばん気になるのはここかもしれませんね。AIがどんな基準でページを選ぶのかが、APIの項目から一部読み取れるからです。
rerank_scoreとauthorityの2つのスコア
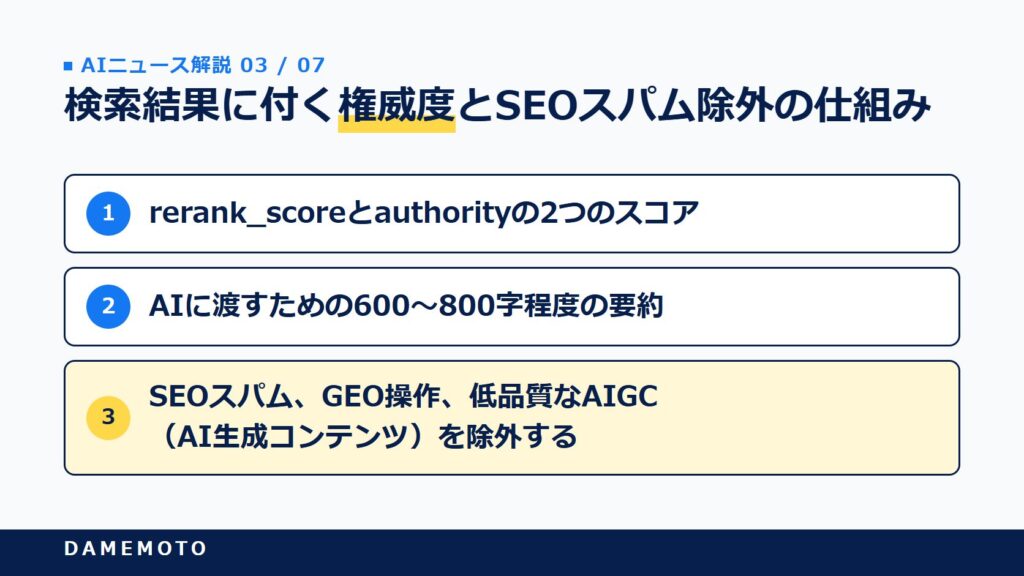
Search APIの結果には、タイトル・URL・スニペットに加えて2つのスコアが付きます。APIリファレンスの説明は次のとおりです。
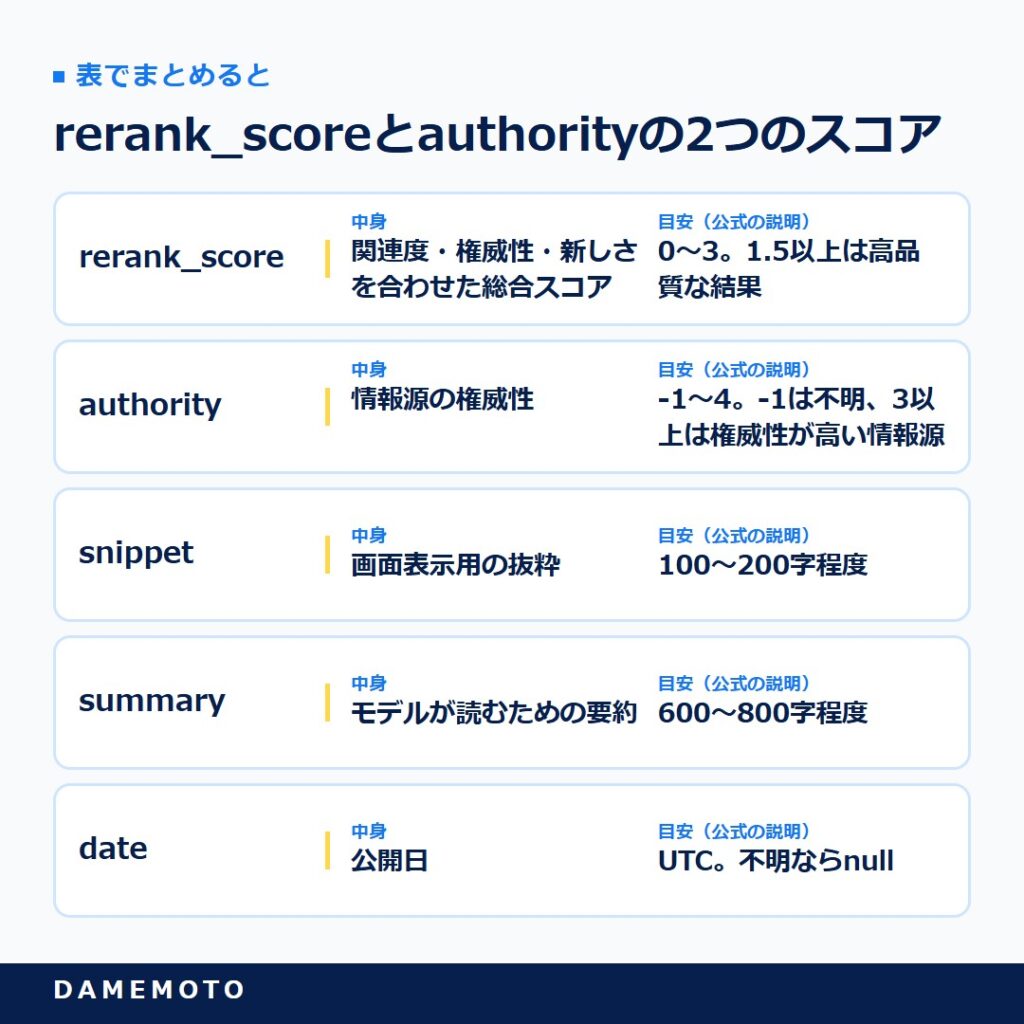
表で詳しく見る
| 項目 | 中身 | 目安(公式の説明) |
|---|---|---|
| rerank_score | 関連度・権威性・新しさを合わせた総合スコア | 0〜3。1.5以上は高品質な結果 |
| authority | 情報源の権威性 | -1〜4。-1は不明、3以上は権威性が高い情報源 |
| snippet | 画面表示用の抜粋 | 100〜200字程度 |
| summary | モデルが読むための要約 | 600〜800字程度 |
| date | 公開日 | UTC。不明ならnull |
注目したいのは、AIに渡すための600〜800字程度の要約が、ページごとに用意されている点です。
AIは本文全体ではなく、この要約を読んで答えを組み立てる場面が多くなると考えられます。記事の要点が要約に残りやすい書き方かどうかが、これまで以上に問われそうです。
「SEOスパム・GEO操作・低品質AIGC」を除外と明記
10月17日付の更新履歴には、DeepSeek Searchが厳しい検出の仕組みでSEOスパム、GEO操作、低品質なAIGC(AI生成コンテンツ)を除外すると書かれています。
GEOとは、生成AIの回答に引用されるための最適化のことです。筆者が確認した範囲では、検索事業者が公式文書で「GEO操作」を名指しした例は多くありません。
どんな手法を「操作」とみなすのか、その基準は公開されていません。ただ、AIに引用されることだけを狙った不自然な文章や、中身の薄い量産記事が不利になる方向性は読み取れます。
正攻法のGEOについては、GEO対策完全ガイド|論文の9手法と実装7ステップで整理しています。

引用を狙う工夫と「操作」の境目は、これから各社が線を引いていくところですね
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
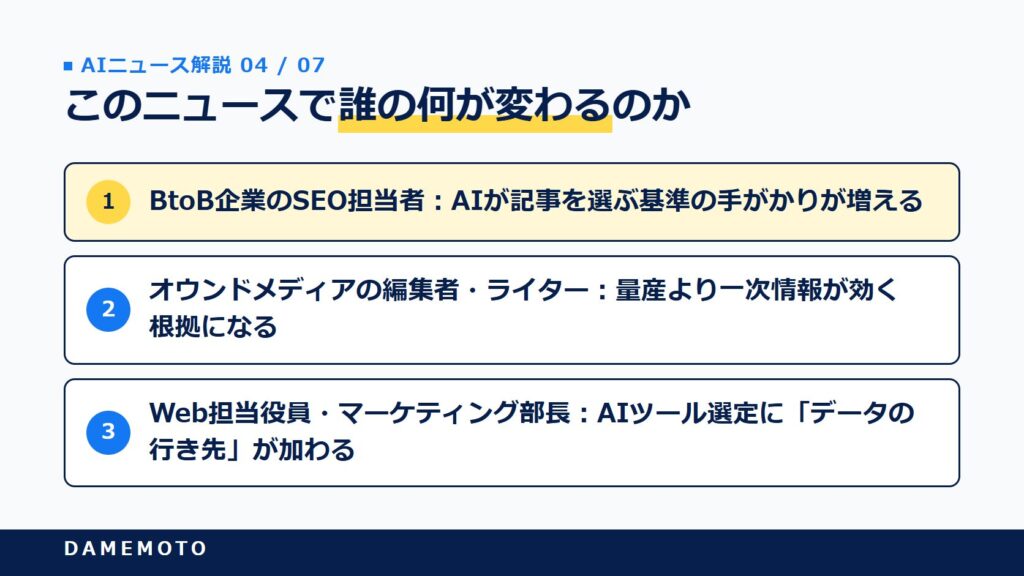
このニュースで誰の何が変わるのか
中国企業の新しいAPIと聞くと、自分には関係ないと感じる人も多いかもしれません。
ところが、AIが記事を探して読む仕組みの一部が見えるようになったという意味では、日本のサイト運営者にも無関係ではないのです。影響が大きい3つの立場ごとに見ていきましょう。
BtoB企業のSEO担当者:AIが記事を選ぶ基準の手がかりが増える
AI検索への対応を任されても、AIが何を見て記事を選んでいるのかが分からず、施策の優先順位を決めにくいですよね。
今回のAPIでは、関連度と権威性のスコア、公開日、AI向けの要約という項目が公開されました。
AI向け検索が「関連度・権威性・新しさ」で記事をふるいにかける作りであることが、仕様として確認できるようになったわけです。
明日からできることは2つあります。主要な記事に公開日・更新日を正しく表示しているかを確かめること、そして冒頭の数百字で記事の結論が伝わるかを見直すことです。
数か月から1年のうちに、AIに渡される「要約」に残る書き方が、検索順位と並ぶ評価軸になっていく可能性があります。
オウンドメディアの編集者・ライター:量産より一次情報が効く根拠になる
AIで記事を量産すべきか、手間をかけて一次情報を集めるべきか、社内で意見が割れることはありませんか。DeepSeekは低品質なAI生成コンテンツを除外対象として公式に明記しました。
少なくともこの検索エンジンは、低品質なAI生成コンテンツを結果から除外する設計だと説明しています。
まずは、自社の記事のうち独自の取材・データ・事例がない記事を洗い出してみてください。そのうえで、加筆するか統合するかを決めていきます。
AIが検索の入口になるほど、「その記事にしかない情報」を持つメディアが引用を集める流れが強まると考えられます。
Web担当役員・マーケティング部長:AIツール選定に「データの行き先」が加わる
社内でAIエージェントを試す部署が増え、どのサービスなら使ってよいのか判断を求められる場面が増えていますよね。
今回の発表で見えたのは、Claude CodeやCodexでDeepSeek APIを使うと、検索とページ取得もDeepSeekのサーバー側で行われるという点です。
使っているツールの名前だけでは、検索語がどこに送られているか分かりにくくなっています。
やることは、社内で使われているAIツールが、どの会社のモデルとAPIにつながっているかを一覧にしておくことです。
11月1日に課金が始まる前に、意図しない利用がないかも確かめておきたいところです。AIツールの審査項目に「検索語やページの行き先」を加える企業は、今後増えていく可能性があります。
日本企業が使う前に確認したい注意点
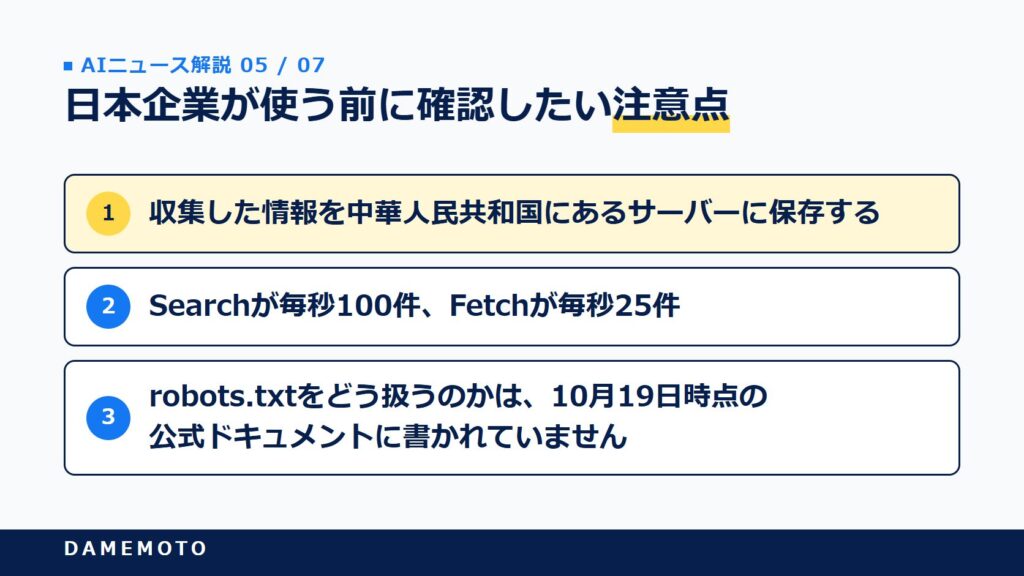
安さに目が行きがちですが、業務で使うなら確認しておきたい点がいくつかあります。公式文書で確認できた範囲で整理しておきます。
データの保存先とプライバシーポリシー
DeepSeekのプライバシーポリシー(2026年2月10日更新)には、収集した情報を中華人民共和国にあるサーバーに保存すると書かれています。
アプリなどの検索機能について、第三者のAPIを組み込み、入力したキーワードを共有するという記載もあります。
なお同ポリシーは、開発者がAPIで作ったサービスのエンドユーザーの情報は対象外としています。
このポリシーがSearch APIとFetch APIにどこまで当てはまるのか、公式ドキュメントには書かれていません。顧客名や未公開の製品名など、外に出したくない語を検索語に含めない運用にしておくのが無難だと思います。
流量の上限とFetchで取得できないページ
2026年10月19日に確認した公式ガイドでは、上限はアカウント単位でSearchが毎秒100件、Fetchが毎秒25件です。Fetchにはドメインごとの上限もあります。
なお公開直後の一部報道は毎秒5件と伝えており、上限は今後も変わる可能性があります。
Fetchは対象サイトの可用性とアクセスポリシーに左右され、サイトのポリシーで止められたページは「使えるコンテンツなし」として返ります。
ただ、どのクローラー名でアクセスし、robots.txtをどう扱うのかは、10月19日時点の公式ドキュメントに書かれていません。
AIクローラーへの向き合い方全体は、LLMO対策完全ガイドも参考になります。
DAMEMOTO代表鈴木サイト側から見ると、どのクローラーで来るのかの公開を待ちたいところです
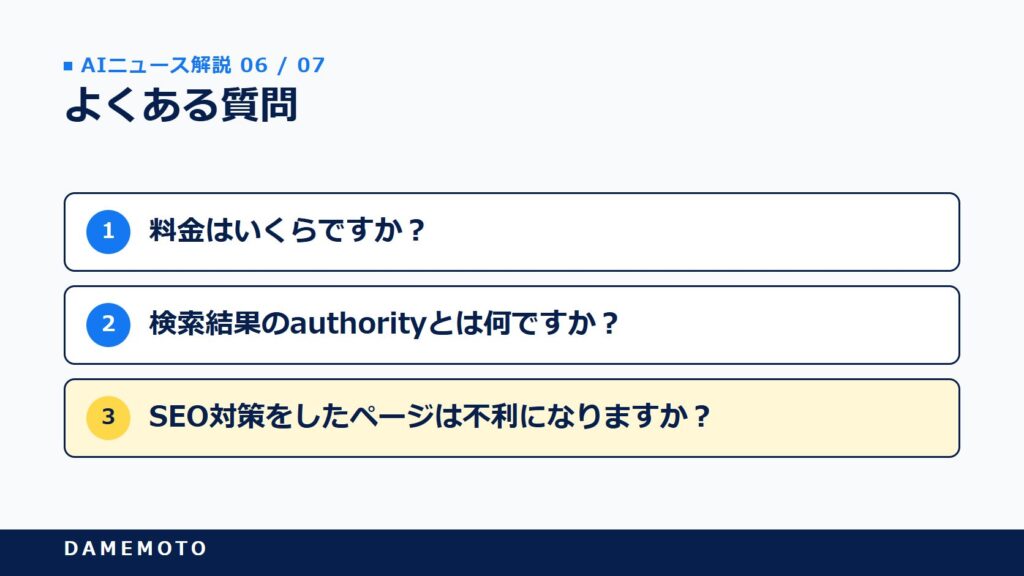
よくある質問
- DeepSeekのSearch APIとFetch APIはいつ公開されましたか?
-
2026年10月17日に一般公開されました。DeepSeekは同日、公式ドキュメントのニュースとXで公開を告知しています。
- DeepSeekの検索APIの料金はいくらですか?
-
Search・Fetchとも、成功したリクエスト1,000件あたり0.75ドルです。失敗・空の結果・タイムアウトは課金されず、1回で受け取る件数を増やしても料金は変わりません。
- DeepSeekのSearch・Fetch APIを無料で使える期間はありますか?
-
DeepSeek Harness・Claude Code・CodexでDeepSeek APIを使う場合のサーバー側のツール呼び出しは現在無料です。北京時間2026年11月1日0時(日本時間11月1日1時)から1件ごとの課金が始まります。
- DeepSeekのFetch APIでは何ができますか?
-
URLを1つ渡すと、そのページのタイトルと内容をMarkdownで返します。対象サイトの可用性やアクセスポリシーによっては取得できないことがあります。
- DeepSeek Search APIの検索結果にあるauthorityとは何ですか?
-
情報源の権威性を示すスコアで、-1から4の値をとります。-1は不明、3以上は権威性が高い情報源とAPIリファレンスで説明されています。
- DeepSeekの検索でSEO対策をしたページは不利になりますか?
-
DeepSeekが除外すると明記したのは、SEOスパム、GEO操作、低品質なAI生成コンテンツです。通常のSEO対策まで除外するとは書かれていませんが、何を「操作」とみなすかの基準は公開されていません。
- 日本企業がDeepSeekの検索APIを業務で使っても問題ありませんか?
-
DeepSeekのプライバシーポリシーは、収集した情報を中華人民共和国にあるサーバーに保存すると記載しています。社内の情報管理の規程に照らし、外に出したくない語を検索語に含めない運用を決めてから試すのが安心です。
- DeepSeekが同時に発表したモデルは何ですか?
-
同じ10月17日に「DeepSeek-V4.1-Flash-1017」が公開されました。Web・アプリ・APIで提供され、APIの呼び出し方法と料金は前のバージョンから変わっていません。
まとめ
DeepSeekは2026年10月17日、自社の検索エンジンを使うSearch APIと、ページをMarkdownで取り出すFetch APIを、成功1,000件あたり0.75ドルで公開しました。
検索結果には関連度・権威性のスコアとAI向けの要約が付き、SEOスパムやGEO操作、低品質なAI生成コンテンツは除外すると明記されています。
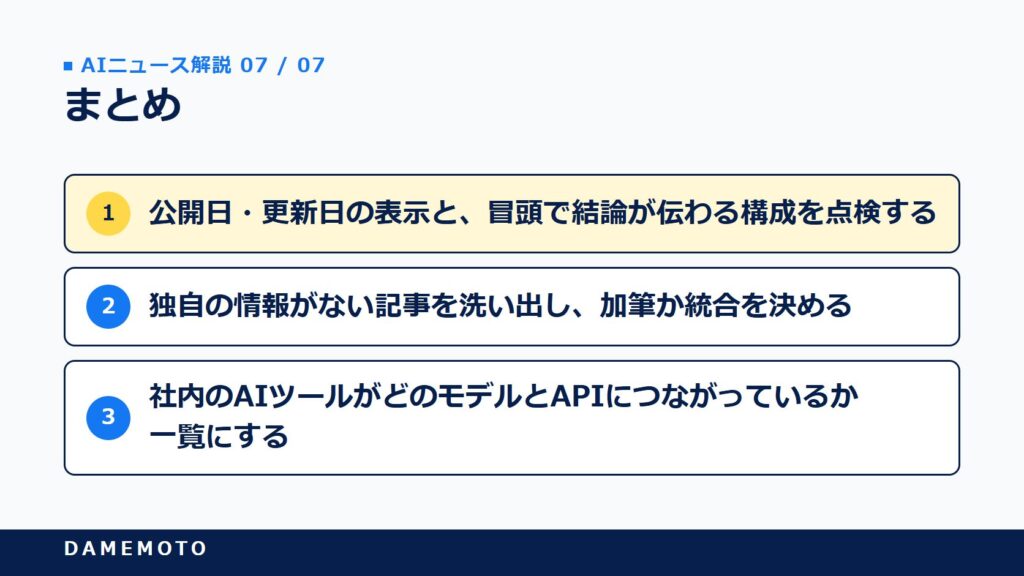
- 公開日・更新日の表示と、冒頭で結論が伝わる構成を点検する
- 独自の情報がない記事を洗い出し、加筆か統合を決める
- 社内のAIツールがどのモデルとAPIにつながっているか一覧にする
AI向けの検索エンジンが「何を落とすか」を公式に書いたことで、引用されやすい記事の条件が少しずつ見えてきました。小手先の対策より、一次情報と分かりやすい構成を積み上げることが近道だといえるでしょう。
参考・出典
- DeepSeek API Docs「News 2026/10/17」:https://api-docs.deepseek.com/news/news261017
- DeepSeek API Docs「Search & Fetch」:https://api-docs.deepseek.com/guides/search/
- DeepSeek API Docs「Search API Reference」:https://api-docs.deepseek.com/api/search
- DeepSeek API Docs「Change Log」:https://api-docs.deepseek.com/updates
- DeepSeek API Docs「Models & Pricing」:https://api-docs.deepseek.com/quick_start/pricing/
- DeepSeek(@deepseek_ai)のX投稿:https://x.com/deepseek_ai/status/2111375650414309859
- DeepSeek「プライバシーポリシー」:https://cdn.deepseek.com/policies/en-US/deepseek-privacy-policy.html
- Tavily「Pricing」:https://www.tavily.com/pricing
- Tavily Docs「API Credits」:https://docs.tavily.com/documentation/api-credits
- GIGAZINE「DeepSeekの検索APIが登場、1000回のリクエスト成功ごとに0.75ドルで競合より安価」:https://gigazine.net/news/20261019-deepseek-search-fetch-api/
- Startup Fortune「DeepSeek Opens Its Search and Fetch APIs at $0.75 per 1,000 Calls」:https://startupfortune.com/deepseek-opens-its-search-and-fetch-apis-at-075-per-1000-calls/






