Jack Dorsey氏が率いる米Blockは、米国時間2026年10月23日(日本時間10月24日)、聞きながら同時に話せる全二重の音声AI「Dessa(デッサ)」を発表しました。
Blockによると、テキストも既存のAIモデルも使わず、人の会話の音声だけでゼロから学習したモデルで、MacBook Pro(M4 Max以上)の手元のPCで動くといいます。
ただし研究プレビューの段階で、API・価格・評価結果は公開されていません。
電話応対やウェビナー、音声での問い合わせに音声エージェントを使うか考えているマーケティング・CS担当にとっては、「会話の自然さ」と「データをどこで処理するか」が選ぶ基準として重くなっていく兆しといえるニュースです。
この記事のポイント
- 米国時間10月23日、Blockの研究ラボが音声AI「Dessa」を発表
- 音声で聞いて音声で返す全二重モデル。テキストなしで学習とBlockは説明
- 「世界初」「ローカル動作」などの性能はすべてBlockの主張で、第三者の評価はまだない
- 使えるのは少数のAI安全性研究者だけ。API・価格・日本語対応は未公開
- 日本語の全二重なら、国内の研究機関が公開したモデルもある
本記事は、BlockのDessa公式ページとDorsey氏・開発責任者のXでの発表を一次情報とし、The Verge、TechCrunch、CoinDesk、Gizmodo、Indian Expressの報道と照らし合わせています。
比較にはOpenAIと国内の大学・研究機関の公式発表を使いました。情報は2026年10月25日時点のものです。
Blockが発表した音声AI「Dessa」とは
今の音声ボットと話していて、こちらが話し終わるまで黙って待たれる、あの間の悪さが気になったことはありますよね。Dessaは、その「順番待ち」をなくす方向のモデルです。
米国時間10月23日、公式ページとXで公開
Dorsey氏は米国時間2026年10月23日(日本時間10月24日午前3時23分ごろ)、Xで「声は知能とやりとりする最も自然な方法だと考え、これまでで最も本物らしい全二重の音声モデルDessaを作った」と投稿しました。
発表にあわせてBlockのサイトのDessaの公式ページで詳細が示され、開発責任者のRagavan Thurairatnam氏も同じ日にXで「音声のためのGPT-3の瞬間だ」と投稿しています。
プレスリリースや別のブログ記事は見当たらず、この公式ページが事実上の発表文の役割を果たしていると見てよいでしょう。
音声で聞いて音声で返す全二重のモデル
公式ページの説明では、Dessaは音声を入れて音声を出す「speech-to-speech」のモデルです。
全二重(フルデュプレックス)なので、人と同じように聞きながら同時に話せるとされています。
実際の会話から学んだため、割り込むタイミングや「うんうん」「なるほど」といった相づちも身につけたそうです。
Blockは、今の音声AIの多くは声をテキストに変える際に多くの情報を捨てていると指摘しました。
Dessaは感情・皮肉・笑い・ため息・悲しみで震える声を、テキストを介さずに聞き取り、話せると説明しています。
Dorsey氏はXで「LLMは何か」と聞かれ、「speech to speech. no llm.」と答えたとIndia Todayが伝えました。
Dorsey氏直属の小さな研究ラボが開発
開発したのは、Blockの中にある「(とても)小さなAI研究ラボ」です。
カナダ・トロントの深層学習スタートアップ「Dessa」の元メンバーが立ち上げ、Blockの共同創業者で会長のDorsey氏に直接報告する体制だと公式ページに書かれています。
なお、旧Dessaが2020年にSquareに買収されたという経緯はCoinDeskの報道によるもので、今回の公式ページには書かれていません。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
確定していること・まだ分からないこと
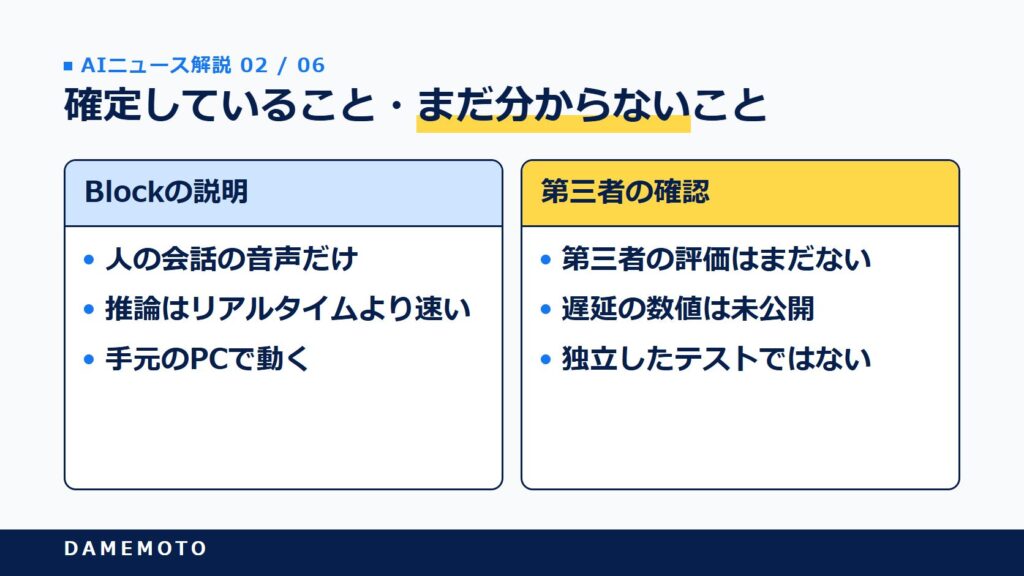
話題性は大きい一方で、検証できる材料はまだ少ない状態です。Blockの説明と第三者の確認を分けて整理しました。
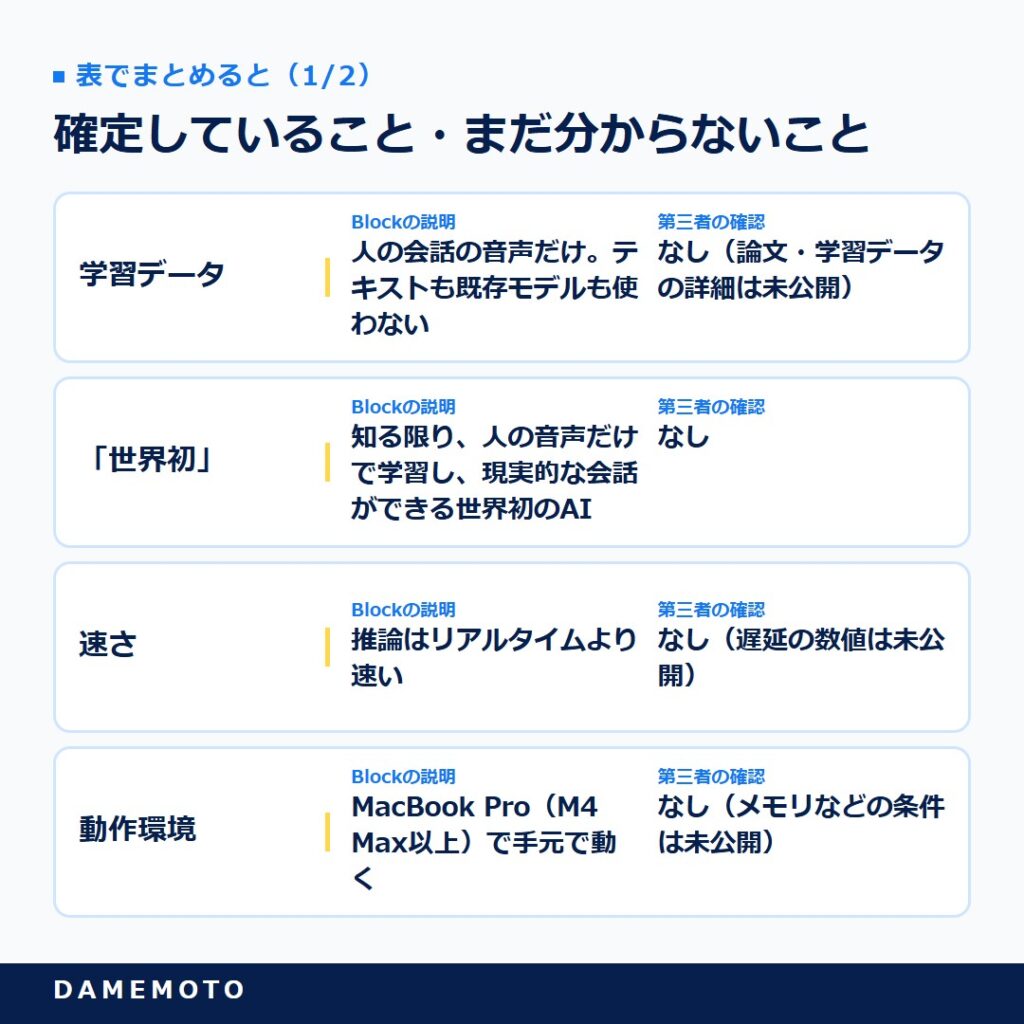
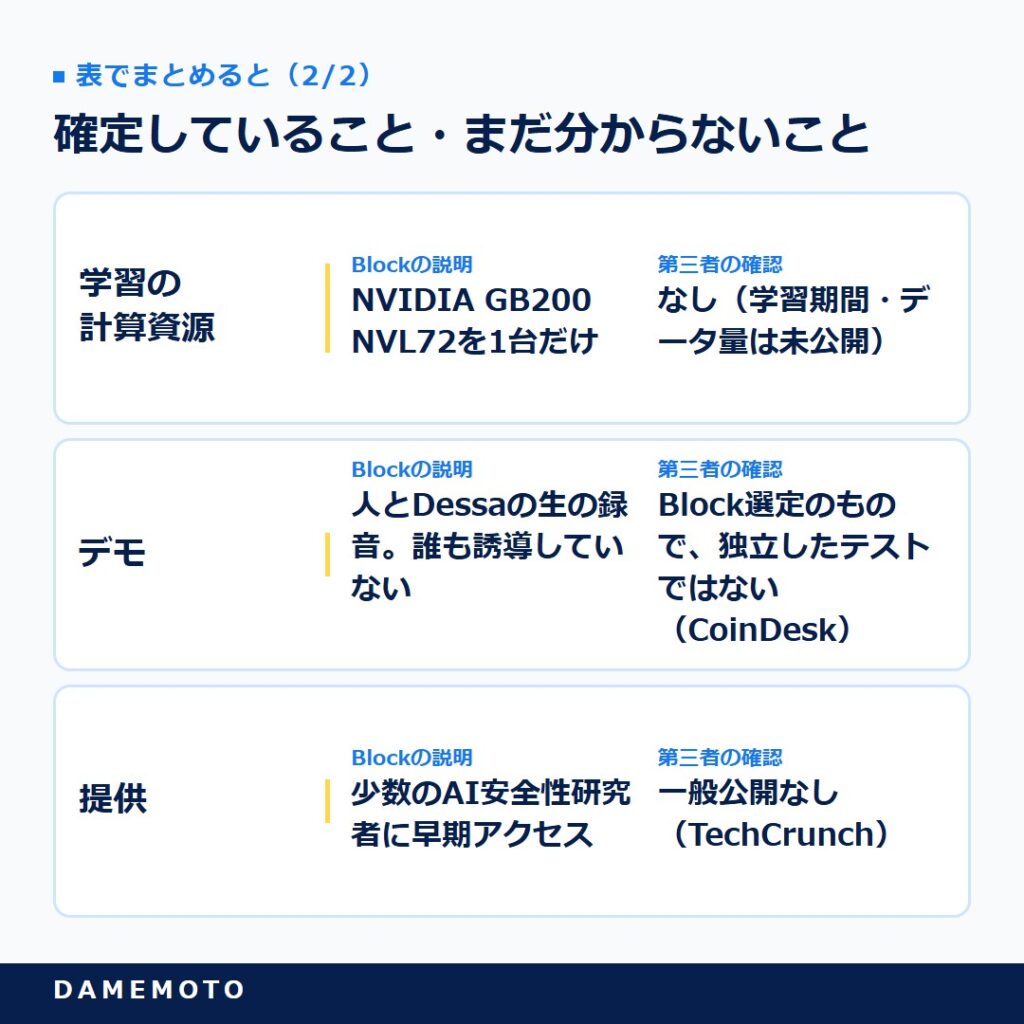
表で詳しく見る
| 項目 | Blockの説明 | 第三者の確認 |
|---|---|---|
| 学習データ | 人の会話の音声だけ。テキストも既存モデルも使わない | なし(論文・学習データの詳細は未公開) |
| 「世界初」 | 知る限り、人の音声だけで学習し、現実的な会話ができる世界初のAI | なし |
| 速さ | 推論はリアルタイムより速い | なし(遅延の数値は未公開) |
| 動作環境 | MacBook Pro(M4 Max以上)で手元で動く | なし(メモリなどの条件は未公開) |
| 学習の計算資源 | NVIDIA GB200 NVL72を1台だけ | なし(学習期間・データ量は未公開) |
| デモ | 人とDessaの生の録音。誰も誘導していない | Block選定のもので、独立したテストではない(CoinDesk) |
| 提供 | 少数のAI安全性研究者に早期アクセス | 一般公開なし(TechCrunch) |
「テキストなしで学習」「世界初」はBlockの説明
公式ページは、Dessaを「ゼロから、人間の会話だけで学習した」と書いています。
さらに「私たちの知る限り」という前置きつきで、人の音声だけで学習し、現実的なライブの会話ができる世界初のAIだと説明しました。
「世界初」はBlock自身の主張で、比べた範囲や方法は示されていません。
言語の習得についても、LLMより数百分の1の単語数で学んだとしていますが、どう数えたかは書かれていないのが現状です。
速さ・ローカル動作・計算資源も自己申告
Blockによると、推論はリアルタイムより速く、気まずい待ち時間がないといいます。
手元のMacBook Pro(M4 Max以上)で動き、学習もNVIDIA GB200 NVL72を1台使っただけだそうです。
ただ、遅延の数値、測定の条件、パラメータ数はどれも公開されていません。
Indian Expressは「パラメータ数・API・価格・重み・公開された評価のないまま、ウェイティングリストの奥にある研究プレビュー」と書き、能力を示す証拠は公開されたデモだけだと指摘しました。
読むときに気をつけたい点もあります。
同じIndian Expressの記事は「遅延なし」「数百語から言語を学んだ」とも書いていますが、公式ページの表現は「リアルタイムより速い」「数百分の1の単語数」です。
海外報道をもとにした記事には、こうした強めの言い換えが混ざることもあるので、数字は公式ページで確かめるのが安全だと思います。
The Vergeはデモのぎこちなさも伝えた
The Vergeは、Blockが公開した会話は「ときどき少しぎこちなく、不気味」だと書きました。
開発責任者が共有した会話では、やり取りはおおむね自然だったものの、モデルが最初に話し手を「Ronaldo」という別人と取り違えています。
クリストファー・ノーラン監督の映画の話から、ブライアン・シンガー監督のスーパーマン映画へ予想外に脱線した例もありました。
一方で、OpenAIのGPT-Live-1との会話では、Dessaのほうが自然に聞こえたとも伝えています。
反応は賛否が分かれているようです。CoinDeskによると、子ども向けの教育に使えそうだという声がある一方、「詐欺電話がパンデミック級になる」と心配する投稿もありました。
TechCrunchは、安全性研究者に試させるのは、音声エージェントが相手をだます場面を確かめる狙いがありそうだと見ています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
GPT-Liveや国内の全二重モデルとの違い
全二重の音声AIそのものは、Dessaが初めてではありません。新しいのは「テキストを使わずに学習した」「手元のPCで動く」という作り方の主張です。性能の優劣は第三者の評価がないので比べず、方式と提供の状況だけを並べてみよう。
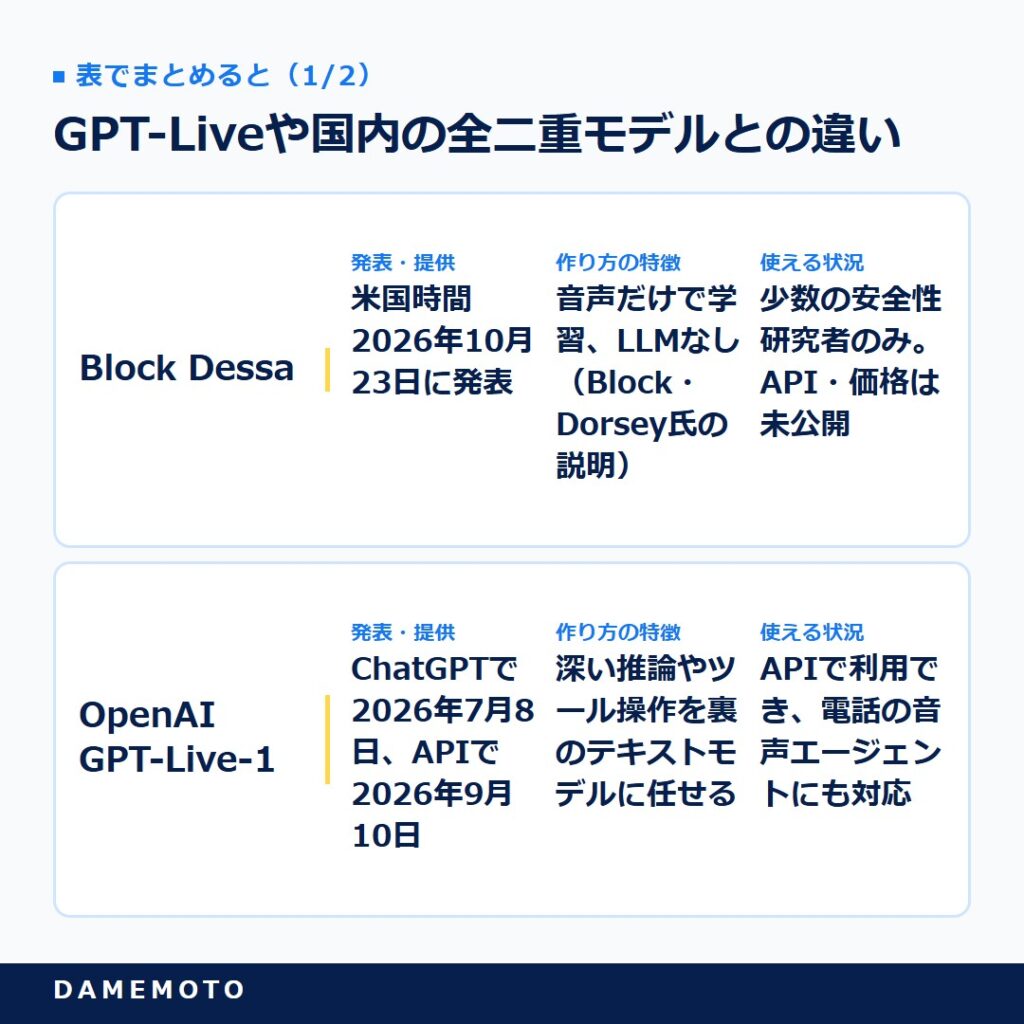
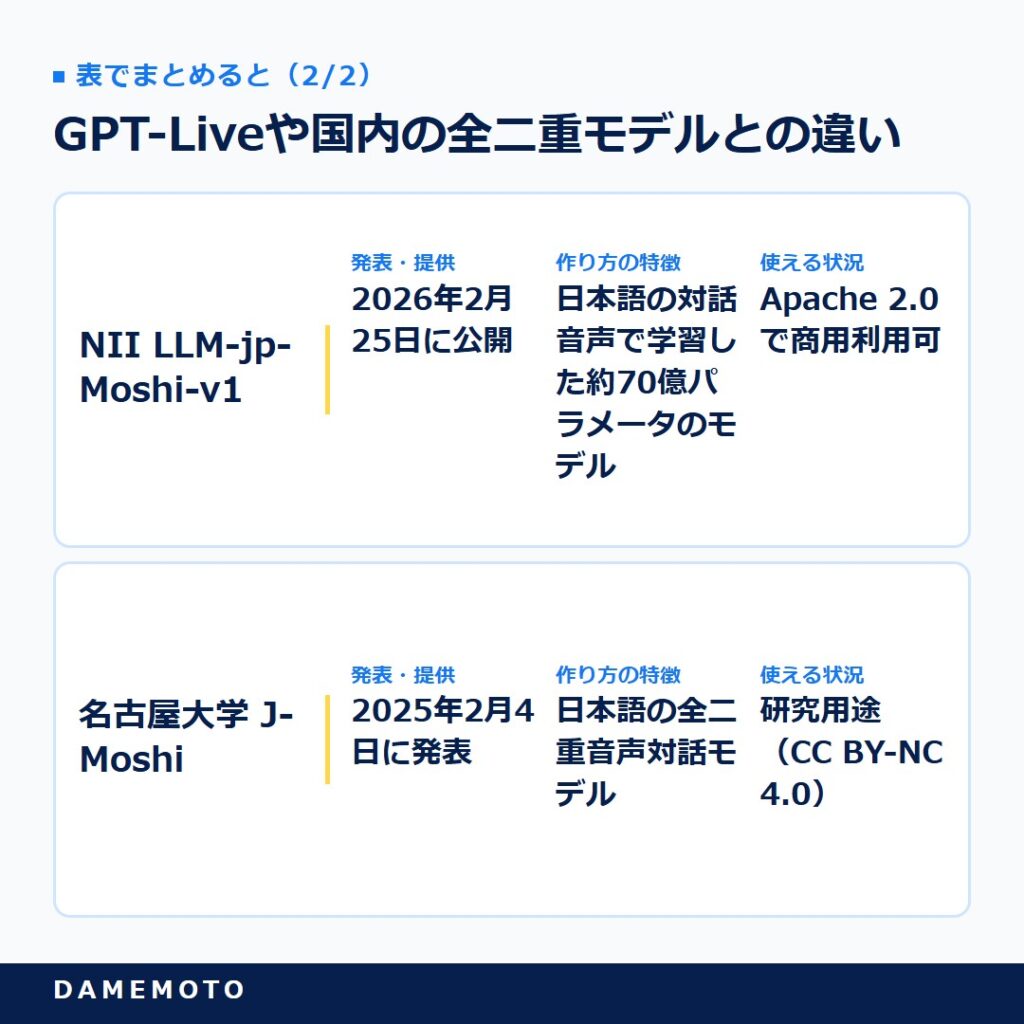
表で詳しく見る
| モデル | 発表・提供 | 作り方の特徴 | 使える状況 |
|---|---|---|---|
| Block Dessa | 米国時間2026年10月23日に発表 | 音声だけで学習、LLMなし(Block・Dorsey氏の説明) | 少数の安全性研究者のみ。API・価格は未公開 |
| OpenAI GPT-Live-1 | ChatGPTで2026年7月8日、APIで2026年9月10日 | 深い推論やツール操作を裏のテキストモデルに任せる | APIで利用でき、電話の音声エージェントにも対応 |
| NII LLM-jp-Moshi-v1 | 2026年2月25日に公開 | 日本語の対話音声で学習した約70億パラメータのモデル | Apache 2.0で商用利用可 |
| 名古屋大学 J-Moshi | 2025年2月4日に発表 | 日本語の全二重音声対話モデル | 研究用途(CC BY-NC 4.0) |
GPT-Liveは「考える部分」を裏のモデルに任せる
OpenAIのGPT-Live-1も、聞きながら話す全二重のモデルにあたります。
OpenAIは、聞く・話すを1つのモデルで扱い、深い推論やツールの呼び出しはGPT-6 Astraなどのテキストモデルに任せる設計です。
電話にも対応し、レストランの予約からカスタマーサポートまで使えるとしています。
Dessaは、この「裏で考えるテキストモデル」を持たない方向です。
TechCrunchは、音声モデルは知識の取り出しのためにLLMと組み合わせるのが普通だが、Blockは知識が会話データから来ていると説明した、と書いています。
商品の在庫や料金のような正確さが求められる情報をどう扱うのかは、まだ分かりません。
音声エージェントの選び方そのものは、Eleven Realtimeの発表を整理した記事や、Mistral Voxtral 3の料金と日本語の注意点をまとめた記事も参考になるはずです。
日本語なら国内の全二重モデルがすでにある
確認した範囲では、Dessaの公式ページにも報道にも、日本語に対応するという記述は見当たりません。日本語の全二重なら、国内の研究機関がすでにモデルを出しています。
国立情報学研究所(NII)は2026年2月25日、ポッドキャストの対話データ約69,000時間などで学習した「LLM-jp-Moshi-v1」を公開しました。
NIIは日本語で商用利用できる全二重の音声対話モデルとして世界初と説明し、用途の例にコールセンターを挙げています。
企業の動きもあります。
NTTは2025年度からFull-duplex型の音声対話AIを研究開発し、2025年11月のNTT R&Dフォーラム2025でコールセンターの自動応対AIの試作(PoC)を展示し、2026年度中の実証実験を準備していると技術誌で紹介しました。
AI insideも2026年4月8日に全二重型の音声対話モデルの開発を発表しています。日本語で試せる選択肢も手元に置いておくと、比べる軸がぶれにくいかもしれませんね。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
このニュースで誰の何が変わるのか
Dessaは今すぐ使える製品ではないものの、音声エージェントを比べる「物差し」を見直すきっかけになります。影響が大きそうな3人の立場で考えてみました。
CS・コールセンター責任者:評価項目に「割り込み」と「感情」を足す
電話の一次応対を自動化したいけれど、音声ボットが相手の言い直しに追いつけず、怒っているお客様にも同じ調子で話し続けてしまう。
そんな不安から導入を見送っている方もいるのではないでしょうか。Dessaが示したのは、割り込み・相づち・声の感情を、テキストに変えずに扱おうとする方向です。
全二重そのものは、GPT-Live-1のように電話に対応したAPIでもう選べます。
明日からは、通話の記録から「お客様が途中で話をさえぎった」「声を荒らげた」場面を10件ほど拾い、ベンダー比較の評価シナリオにするのが手堅い一歩です。
あわせて、AIから人へ引き継ぐ条件を文章にしておきたいところ。
この先1年ほどで、音声エージェントの比較は「正答率」だけでなく「会話の間合いと感情への反応」まで問われるようになると考えられます。
マーケ担当:ウェビナーや音声検索の「話し言葉の質問」に備える
ウェビナーの質疑や電話の問い合わせでは、文章で検索されるときとは違う聞き方をされますよね。FAQは整えたのに、口頭の質問にはうまく答えられていない。そう感じている担当者は少なくないと思います。
注目したいのは、音声エージェントが自社の情報をどこから得るのかという点です。
GPT-Live-1は裏のテキストモデルやツールに推論を任せる作りなので、Webサイトや社内の文書に書いた内容が答えの材料になりえます。
テキストを持たないDessaに自社の情報をどう渡すのかは、まだ公開されていません。だからこそ当面は、文章で整えた情報が音声の答えの土台になり続けると考えてよさそうです。
- 過去のウェビナーの質疑を書き起こし、口頭で多かった質問をFAQに足す
- FAQの答えを、1文目だけ読み上げられても意味が通る形に直す
数か月から1年の単位で見ると、声で質問して声で答えが返る場面が増え、「読み上げられても伝わる文章か」がコンテンツの点検項目に加わる可能性があります。
Web担当役員・経営層:なりすましとデータの置き場所を決める
人の声と区別しにくいAIが増えると、社内外の電話を信じてよいのか迷う場面も出てきます。CoinDeskが伝えたように、詐欺電話の増加を心配する声はすでに上がっています。
一方で、Blockが説明するように手元の端末で動く音声AIが製品になれば、通話の音声を外部のクラウドに送らずに処理する選択肢が生まれるかもしれません。
これは推測で、Dessaの提供条件はまだ何も発表されていない段階です。
明日からできることは2つあります。1つは、電話で送金や個人情報の提供を求められたときの折り返し確認の手順を、全社で決め直すこと。
もう1つは、自社が音声AIを使うときに「AIであることを最初に名乗るか」「録音をどこに置くか」の方針を先に決めておくことです。
音声AIが自然になるほど、こうしたルールの有無が顧客の信頼を左右するようになると考えられます。

Dessaを今すぐ使えるわけではありません。ただ、「自然に話せるか」「どこで処理するか」「AIだと名乗るか」の3つは、どの音声AIを選ぶときにも効いてくる問いだと感じます
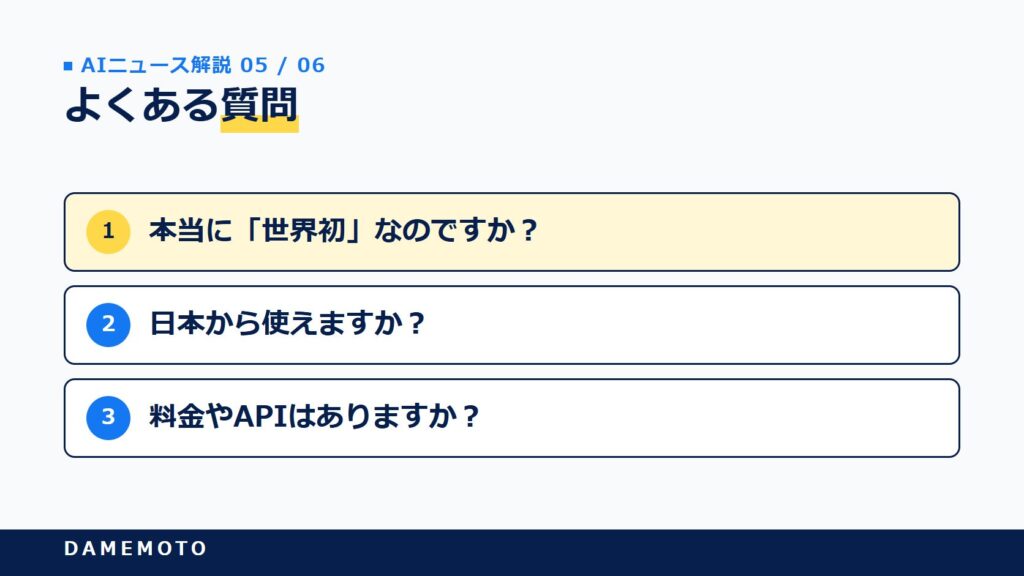
よくある質問
- Dessaとは何ですか?
-
米Blockの社内AI研究ラボが米国時間2026年10月23日(日本時間10月24日)に発表した音声AIです。音声を聞いて音声で返し、聞きながら同時に話せる全二重のモデルで、人の会話の音声だけで学習したとBlockは説明しています。
- 日本からDessaを使えますか?
-
2026年10月25日時点では、一般の企業や個人が使える状態ではありません。早期アクセスは少数のAI安全性研究者に限られています。日本語に対応するかどうかも、公式ページや報道では確認できませんでした。
- Dessaに料金やAPIはありますか?
-
いずれも未公開です。API、価格、パラメータ数、モデルの重み、評価結果、公開の時期は、どれも公式ページには書かれていません。
- Dessaは本当に「世界初」なのですか?
-
Blockは「私たちの知る限り」という前置きつきで、人の音声だけで学習し現実的な会話ができる世界初のAIだと説明しています。第三者による検証はまだなく、確定した事実とはいえません。
- Dessaがパソコンで動くというのは本当ですか?
-
公式ページには、MacBook Pro(M4 Max以上)で手元で動くと書かれています。必要なメモリなどの条件や、実際の遅延の数値は公開されていません。
- BlockのDessaは、OpenAIのGPT-Liveと何が違いますか?
-
どちらも全二重の音声モデルです。GPT-Live-1は深い推論やツール操作を裏のテキストモデルに任せる設計で、APIで使えます。Dessaは音声だけで学習しLLMを使わないとされ、一般には使えません。第三者が性能を比べた評価も、まだ出ていない状況です。
- 日本語で試せる全二重の音声AIはありますか?
-
国立情報学研究所が2026年2月25日に公開したLLM-jp-Moshi-v1は、Apache 2.0のライセンスで商用利用できます。名古屋大学が2025年2月4日に発表したJ-Moshiは、研究用途に限られます。
まとめ
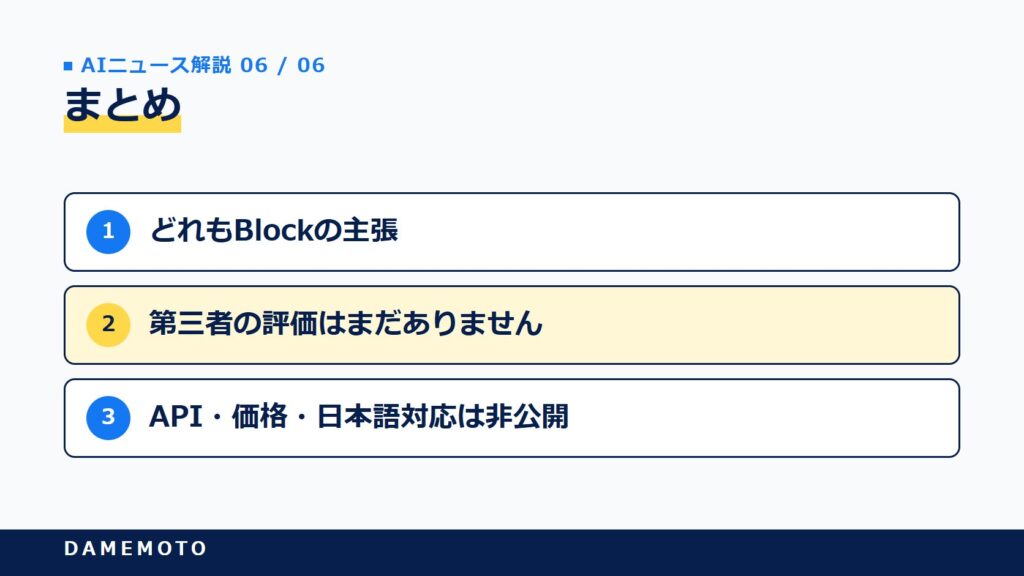
Blockは米国時間2026年10月23日(日本時間10月24日)、全二重の音声AI「Dessa」を発表しました。
テキストを使わず人の会話の音声だけで学習し、手元のPCで動くという説明はどれもBlockの主張で、第三者の評価はまだありません。
今は研究プレビューの段階で、API・価格・日本語対応は非公開です。
- 音声エージェントの評価シナリオに、割り込みと感情への反応を加える
- 口頭で多い質問をFAQに足し、読み上げても伝わる答えに直す
- 電話での送金・個人情報の依頼に、折り返し確認のルールを決める
Dessaが実際に使えるようになるかは、今後の公開内容しだいです。ただ、声のまま会話するAIへの流れははっきりしてきました。製品を選ぶ日が来る前に、評価の物差しと社内のルールを整えておくのが、いちばん無駄にならない準備だと思います。
参考・出典
- Block「Dessa」公式ページ:https://block.xyz/dessa
- Jack Dorsey氏のX投稿(2026年10月23日・米国時間):https://x.com/jack/status/2113697902916751661
- OpenAI「GPT-Live-1 in the API」(2026年9月10日):https://openai.com/index/introducing-gpt-live-1-in-the-api/
- OpenAI「Introducing GPT-Live」:https://openai.com/index/introducing-gpt-live/
- 国立情報学研究所「LLM-jp-Moshi-v1の公開」(2026年2月25日):https://www.nii.ac.jp/news/release/2026/0225.html
- 名古屋大学「J-Moshi」(2025年2月4日):https://www.nagoya-u.ac.jp/researchinfo/result/2025/02/-ai-j-moshi.html
- NTT技術ジャーナル:https://journal.ntt.co.jp/article/39223
- AI inside(2026年4月8日):https://inside.ai/news/2026/0408_full-duplex/
- The Verge(2026年10月23日):https://www.theverge.com/ai-artificial-intelligence/1017906/jack-dorsey-block-dessa-ai-voice-speech
- TechCrunch(2026年10月24日):https://techcrunch.com/2026/10/24/blocks-new-voice-model-sounds-eerily-human/
- CoinDesk(2026年10月24日):https://www.coindesk.com/tech/2026/10/24/block-s-new-voice-ai-sounds-eerily-human-sparking-awe-and-scam-fears
- Gizmodo(2026年10月24日):https://gizmodo.com/check-out-the-many-uncanny-human-ish-voices-from-blocks-new-ai-model-2000830237
- Indian Express(2026年10月24日):https://indianexpress.com/article/technology/artificial-intelligence/jack-dorsey-voice-ai-dessa-block-inc-10934777/
- India Today(2026年10月24日):https://www.indiatoday.in/technology/news/story/jack-dorseys-block-makes-ai-that-talks-like-humans-it-runs-without-internet-on-macbook-3024055-2026-10-24






