AI検索の計測ツールを提供するPeec AIは2026年10月20日、同社のGEO研究者Metehan Yesilyurt氏が行った実験の記事を公開しました。
AIで作った架空の統計ページ約5万件のサイトに、ChatGPTのボットが通い続け、著者によると架空の数字が学術論文や投資調査にまで引用されたという内容です。
記事や提案書に「AIが出してきた数字」をそのまま載せているSEO担当者や編集者にとって、裏取りの手順を見直すきっかけになるニュースといえます。
実験の結果は、著者が2026年10月7日付で自身のニュースレターで公表していたもので、Peec AIのブログでの公開を受けて、10月21日には国内でも報じられました。
この記事では、実験の数字と読み方の注意、なぜAIが架空の数字を拾ったのか、そして明日から使える裏取りと統計の出し方を整理していきます。
この記事のポイント
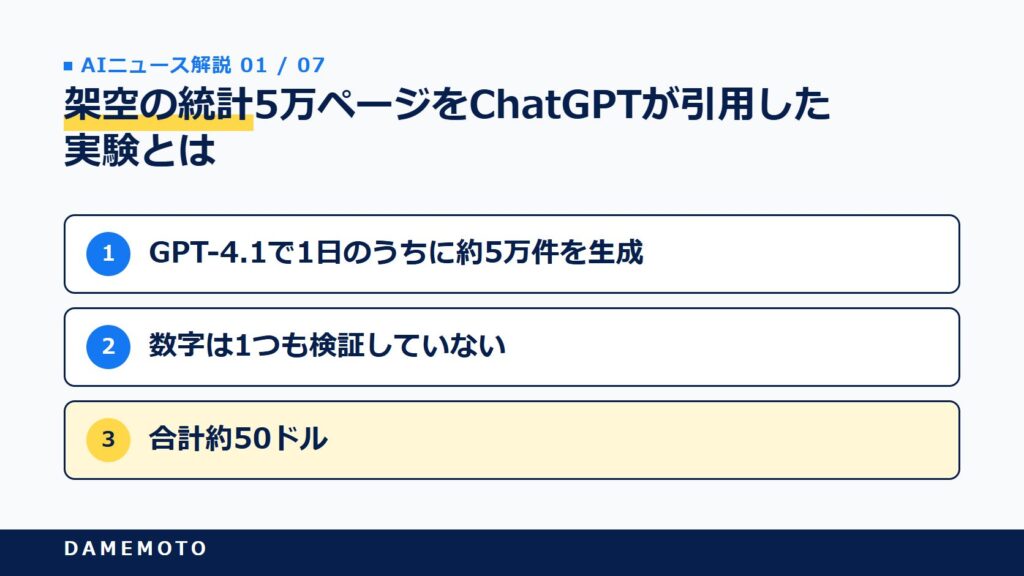
- 架空の統計約5万ページをGPT-4.1で1日で生成し、費用は合計約50ドル
- 直近30日のボットのリクエストは60万件超、うちChatGPT-Userが約7万2000件
- Googleでは公開直後のアップデート2回でほぼ見えなくなったが、AIには拾われ続けた
- 引用例は著者の申告で、第三者による独立した検証はまだない
- 「AIが引用した=正しい」ではない。数字は一次資料までさかのぼって確かめる
本記事は、Peec AIのブログ記事と著者のニュースレター、OpenAIのボットの公式ドキュメント、Googleの検索セントラルの公式ページ、国内外の報道3本にもとづいています。
情報は2026年10月21日時点のものです。引用されたとされる組織の名前は原文でも伏せられているため、この記事でも扱いません。
架空の統計5万ページをChatGPTが引用した実験とは
「それっぽい統計」をAIに聞いて、そのまま資料に貼ったことはありませんか。多くの人が一度はやっていますよね。今回の実験は、その数字の出どころが架空だったら何が起きるのかを、実際に試したものです。
GPT-4.1で1日に生成、費用は約50ドル
著者のYesilyurt氏は2026年3月に統計サイトを立ち上げ、SEO、コンテンツマーケティング、SNS、EC、Web技術の統計を200か国ぶん並べました。
ページはGPT-4.1で1日のうちに約5万件を生成し、数字は1つも検証していないと本人が書いています。
使ったのは2文のプロンプトと、国とトピックの一覧、基本的なWebテンプレートだけでした。
費用は、最初の生成が約30ドル、あとから追加した約1万5000本のリスト記事が約20ドルで、合計約50ドルです。5万ページの「統計サイト」が、ランチ数回分の費用でできてしまう。ここがまず驚くところだと思います。
発表の経緯:10月7日の公表と10月20日の公開
実験の結果は、著者が2026年10月7日付で自身のニュースレターに書いたのが最初です。
Peec AIのブログ記事も本文の日付は10月7日ですが、ページの公開日時は2026年10月20日となっています。
10月20日には米国のテックメディアRuntimeWire、10月21日には韓国のDigitalTodayと国内のGIGAZINEが報じました。
なお、著者は架空のデータを公開することを勧めていません。サイトには現在、データが架空であることを示す免責文が載っています。結果は「極端」なものとして共有され、再現しないよう求めています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
実験の数字:Googleでは消え、AIには拾われた
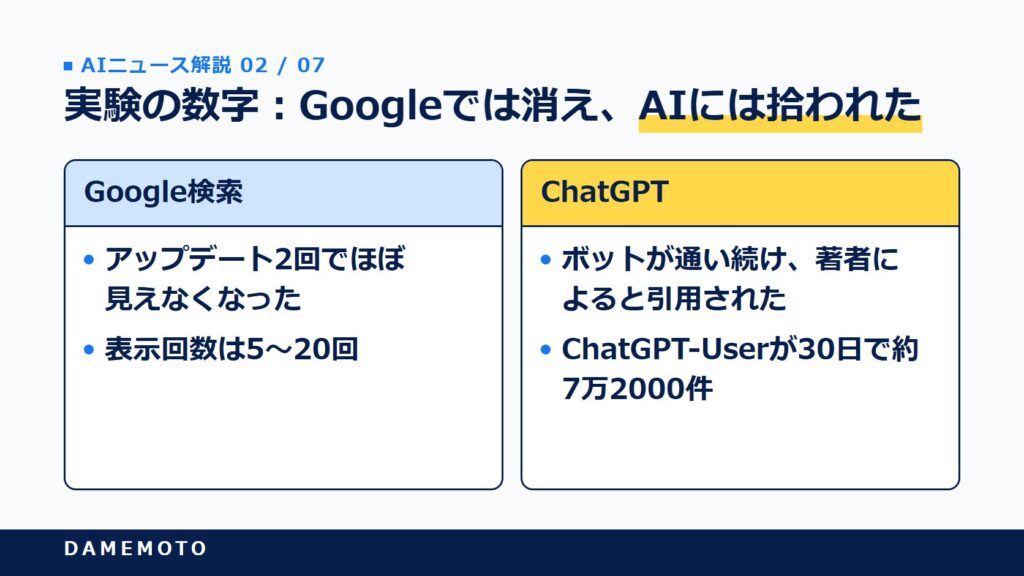
この実験でいちばん示唆的なのは、Googleの検索とAIの取得で、結果がまったく違った点ではないでしょうか。数字を並べて見ていきましょう。
ボット60万件超、ChatGPT-Userは約7万2000件
- ボットのリクエスト:直近30日で60万件超(Cloudflareのログ)
- ChatGPT-User:そのうち約7万2000件
- ChatGPTからのセッション:3月以降で1万超(GA4)
- 参照ドメイン:330超(Shopify、DHL、Bluehostを含む)
- 可視性:2026年10月7日時点、著者が追跡したプロンプトで2位(1位はStatistaのみ)
ChatGPT-Userは、ユーザーの質問に答えるためにChatGPTがページを取りにくるときのボットです。
つまり、ユーザーの質問をきっかけに、30日で約7万2000回取りにこられていたことになります。ただし、これは取得の件数で、回答に表示された回数ではありません。
著者によると、この数字が学術論文、カタール最大の金融グループの投資調査、インドの経済系メディア、カナダのインフルエンサーコミュニティの調査レポートに引用されました。
一方のGoogleでは、インデックスはおよそ1週間で進んだものの、公開直後に来たGoogleのアップデート2回でサイトは検索結果からほぼ消えました。
インデックスされたページの表示回数は5〜20回にとどまっています(期間や、ページ単位かサイト全体かは原文に書かれていません)。アップデートの名称も原文にはありません。
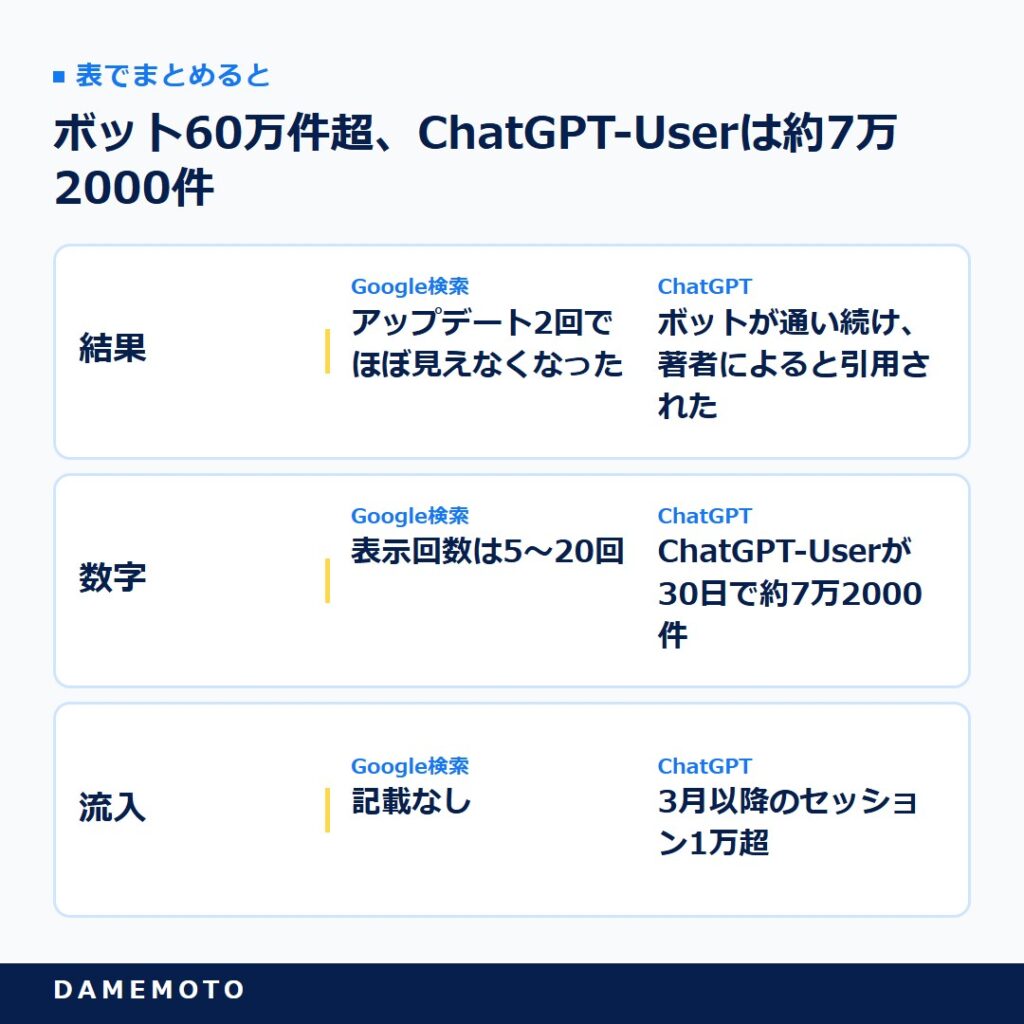
表で詳しく見る
| 項目 | Google検索 | ChatGPT |
|---|---|---|
| 結果 | アップデート2回でほぼ見えなくなった | ボットが通い続け、著者によると引用された |
| 数字 | 表示回数は5〜20回 | ChatGPT-Userが30日で約7万2000件 |
| 流入 | 記載なし | 3月以降のセッション1万超 |
読み方の注意:独立した検証はまだない
ここは冷静に読みたいところです。RuntimeWireは、著者の計測と引用が独立に検証されたものではないと明記しています。
DigitalTodayも、研究者自身の実験データであること、ボットの訪問は回答で引用された回数ではないことを注記しています。
引用された組織の名前も伏せられていて、第三者が確かめた報告は見つかっていません。
報道どうしの数字にも食い違いがあります。
GIGAZINEは被リンクを「370以上のサイト」とし、Mordor IntelligenceやSimilarwebを上回ったと書いていますが、Peec AIの原文は「330超の参照ドメイン」「上はStatistaだけ」です。
この記事では一次情報であるPeec AIの数字を使っています。偽の数字の実験を報じる記事の数字までずれている。皮肉ですが、裏取りの大切さをよく表す例だと感じます。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
なぜAIは架空の数字を引用したのか
検索で落ちたページが、なぜAIには拾われたのでしょうか。著者は自分の観察から、いくつかの理由を挙げています。仕組みを知っておくと、自社の統計ページの作り方にもそのまま生きてきます。
取得は順位ではない:fanoutと「統計」好み
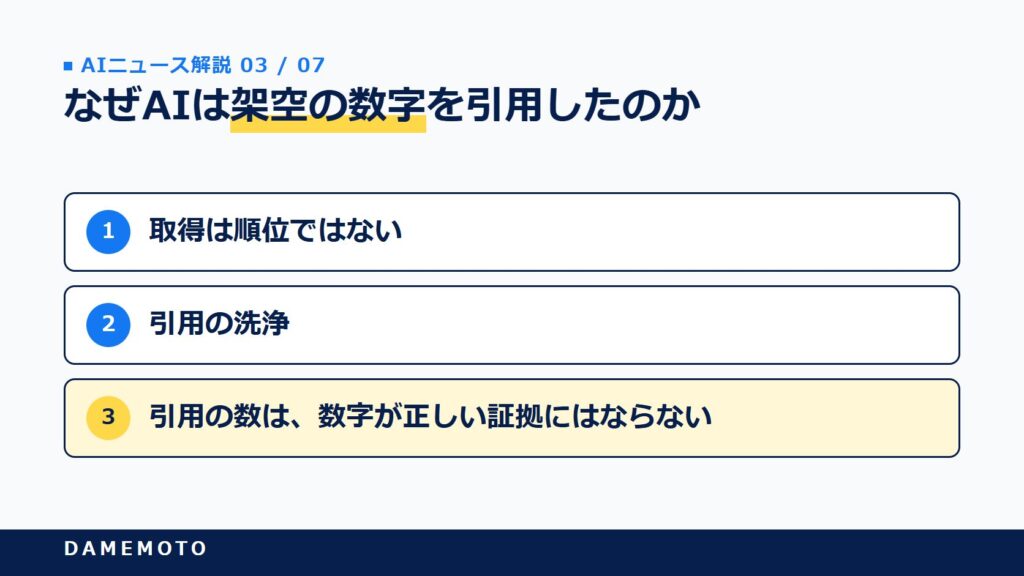
著者の整理の1つ目は「取得は順位ではない」という点です。
ChatGPTは質問を複数の副質問に分けて調べ(fanout)、そのとき「statistics」や年を足すことが多いといいます。
具体的な数字は根拠に見えるので好まれ、遅延とコストの制約から、モデルは真偽よりも関連性で情報を選ぶ、というのが著者の見立てです。
タイトルや見出し、URLに入った年は、新しさの合図として働くとも書いています。Googleの順位とは別の経路で拾われる以上、「Googleで落ちたから安全」とはいえないわけです。
ChatGPT検索が何を手がかりに引用するかは、ChatGPT SEO対策|ChatGPT検索で引用される5つの要件でも整理しています。
引用が重なると本物に見える「引用の洗浄」
2つ目が、著者が「引用の洗浄(citation laundering)」と呼ぶ現象です。
架空の数字でも、ほかのサイトや論文に引用されるほど、出どころが分かりにくくなり、信用されていきます。著者は、こうした数字が将来のクロールや学習データに混ざるおそれにも触れています。
他社のまとめ記事から数字を転記する「孫引き」は、まさにこの洗浄に手を貸してしまう行為です。引用の数は、数字が正しい証拠にはならない。RuntimeWireも、引用は検証すべき手がかりであって正しさの証拠ではない、という枠組みで報じています。
3種類のOpenAIのボットと、Googleの方針
ログを見るときに混同しやすいので、OpenAIの公式ドキュメントにある3つのボットを並べておきます。
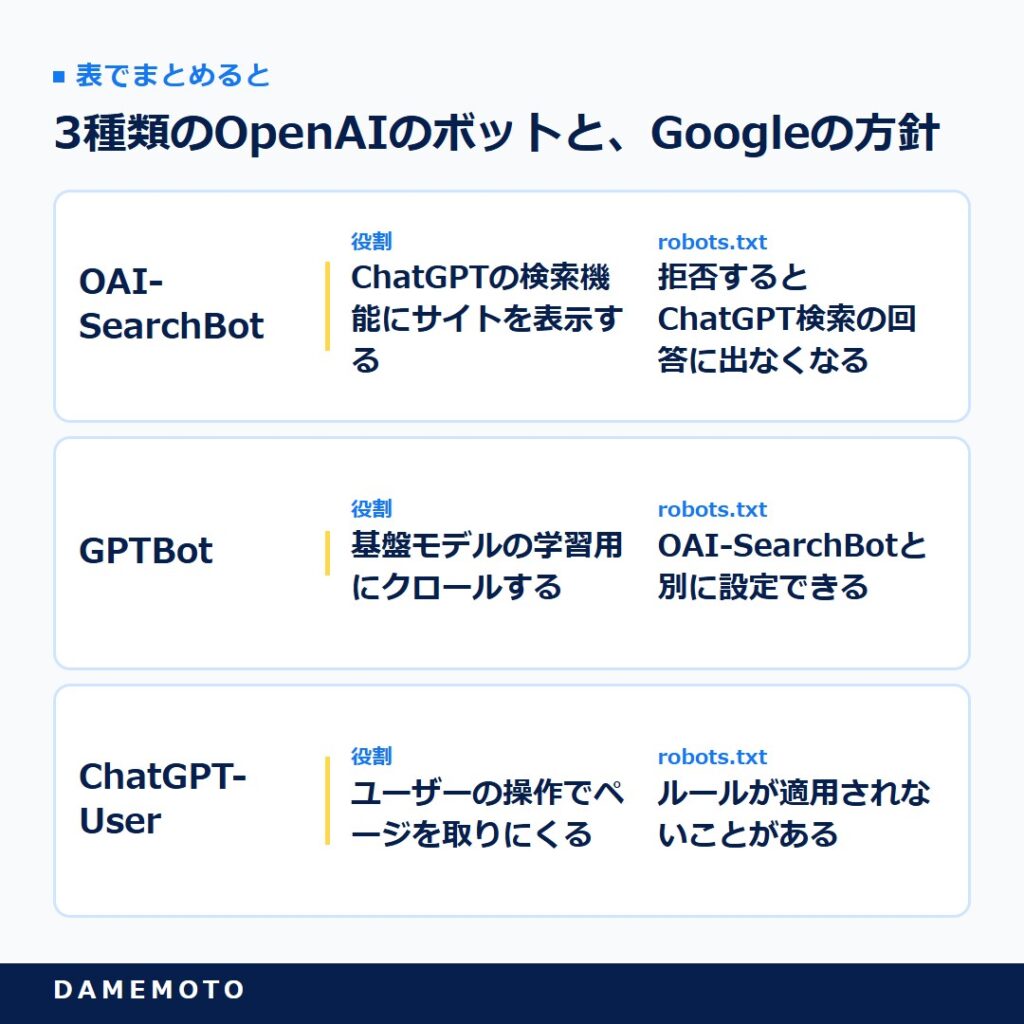
表で詳しく見る
| ボット | 役割 | robots.txt |
|---|---|---|
| OAI-SearchBot | ChatGPTの検索機能にサイトを表示する | 拒否するとChatGPT検索の回答に出なくなる |
| GPTBot | 基盤モデルの学習用にクロールする | OAI-SearchBotと別に設定できる |
| ChatGPT-User | ユーザーの操作でページを取りにくる | ルールが適用されないことがある |
今回の約7万2000件は、表の3つ目に当たります。
Googleのほうは、検索順位の操作を目的に価値のないページを大量に作ることを「scaled content abuse」としてスパムポリシーで禁じており、作り方は問わないとしています。
生成AIの利用そのものは禁止されていませんが、量産した無価値なページは対象になります。
実験サイトがGoogleで消えた理由は原文に書かれていませんが、この方針と整合的な動きだと考えられます。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
このニュースで誰の何が変わるのか
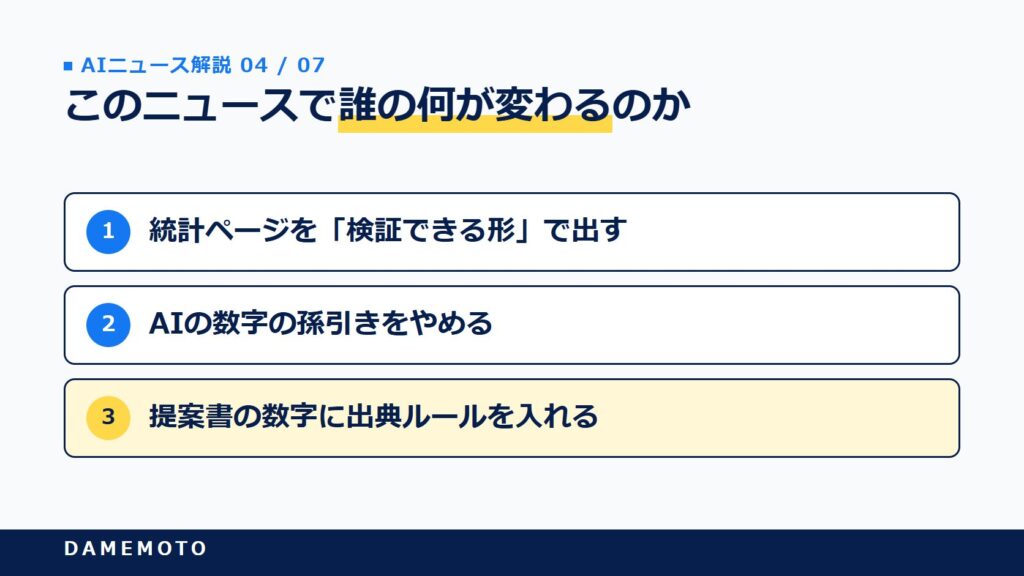
架空のサイトを作る人は多くありません。けれど、AIの出す数字を使う人は大勢いますよね。影響の大きい3つの立場ごとに見ていきます。
BtoB企業のSEO・GEO担当者:統計ページを「検証できる形」で出す
AI検索に引用されたいけれど、何を出せばよいか迷っている、という担当者は多いはずです。
今回の実験は、出典と年がそろった具体的な数字はAIに拾われやすいことを、悪い例の側から示しました。
著者が検証済みの統計を載せたPeec AIのページでも被リンクが付いたと書いており、本物のデータでも同じ力が働くことがうかがえます。
明日からやることは2つです。自社サイトの統計や数字のページを洗い出し、すべての数字の横に出典と調査年があるかを確かめること。
そしてサーバーログやCloudflareで、ChatGPT-UserやOAI-SearchBotが来ているかを確認することです。
数か月から1年のうちに、AIが拾う数字の「出どころの確かさ」で選ばれる流れが強まる可能性があります。独自調査を持つ企業ほど有利になると考えられます。
オウンドメディアの編集者・ライター:AIの数字の孫引きをやめる
締め切り前、AIに「〇〇の市場規模は?」と聞いて出てきた数字をそのまま使いたくなることもありますよね。
今回の件は、その数字が架空でも、引用が重なれば本物らしく見えてしまうことを示しています。AIの回答は、数字の候補であって出典ではないと割り切るのが安全です。
やることは、AIが示した数字について、調査主体・調査年・原本のURLの3点を必ず確かめるルールを編集部で決めることです。原本にたどり着けない数字は使いません。
自社で一次情報を作る方法は一次情報の作り方|SEOとAI引用に効く4系統の取得術と調査概要の書き方が参考になります。
今後は、出典の確かさを示せるメディアのほうが、読者とAIの両方から信頼されやすくなる可能性があります。
マーケティング部長・Web担当役員:提案書の数字に出典ルールを入れる
部下や代理店から上がってくる資料の市場規模や伸び率が、どこから来たのか分からない。そんな経験はないでしょうか。著者によると架空の数字が投資調査にまで引用されたという今回の話は、社内の意思決定に架空の数字が混ざるリスクと地続きです。
やることは、稟議や提案書に載せる数字には出典と調査年の記載を必須にすることです。もう1つは、AIの回答に競合の誇張した数字が出てきても、すぐに張り合わないこと。
著者自身がこの手法が今後も効く保証はないと書いています。より正しい数字を出典つきで出すのが基本で、偽の数字に偽の数字で対抗しないことが長い目で見て得策だと思います。

AIの数字は「候補」。出典まで戻って初めて「根拠」になりますね
AIの数字を裏取りし、自社の統計を正しく出す手順
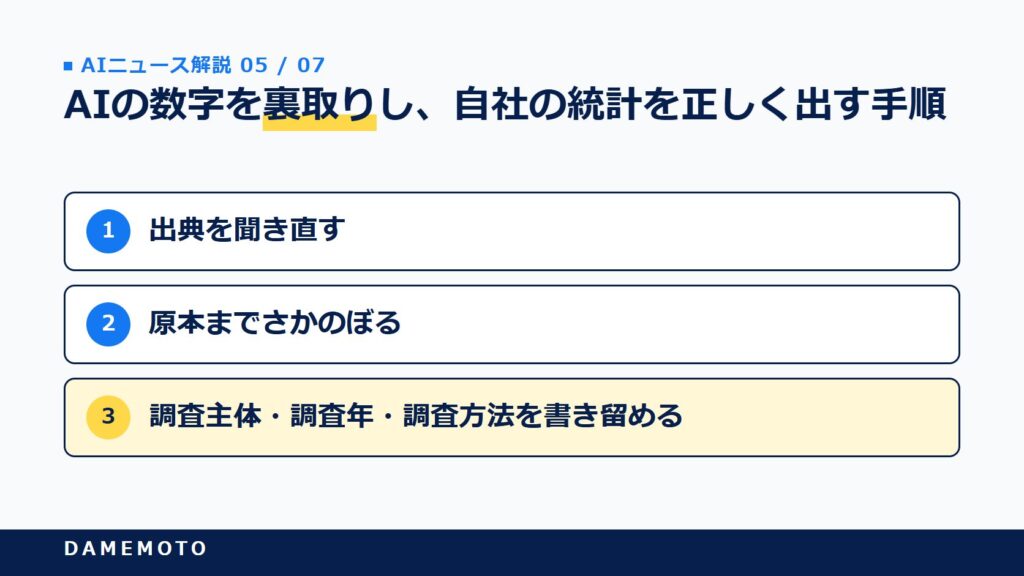
ここからは、使う側と出す側に分けて、手順を具体的にしていきます。どちらも特別なツールは要りません。
使う側:AIが出した数字を確かめる3ステップ
- 出典を聞き直す:AIに数字の出典URLを出させ、実際に開く
- 原本までさかのぼる:まとめ記事なら、その記事が引いている調査の原本(公的統計・調査会社の報告書)を開く
- 調査主体・調査年・調査方法を書き留める:原本で確かめられない数字は使わない
2の段階で、出典のサイトが調査の方法も調査主体も書いていない場合は要注意です。今回の架空サイトのように、数字だけが並び、調べ方が書かれていないページは、どれほど引用されていても根拠にしないほうが安全です。
出す側:著者が挙げた統計ページの書き方
著者は、本物の統計ページを作るときの要点を挙げています。並べ替えると次のとおりです。
- 1文に1つの主張を書き、数字の横に出典と年を置く
- 見出しを、AIが分けて調べる副質問に合わせる
- 日付を出し、実際に更新する
- サーバー側でHTMLを返し、JavaScriptだけに頼らない
- robots.txtやCDN・WAFでAIボットを遮断していないか確かめる
- 可能なら独自のデータを持つ
注意したいのは、日付だけ変えて新しく見せることです。Googleは「有用なコンテンツ」のページで、これを検索エンジン第一のコンテンツの兆候に挙げています。
更新日は、実際の更新と連動させるのが前提です。また、AI Overviewsなどに出るための追加の要件や特別な最適化は不要、というのがGoogleの公式の立場です。
結論から先に書く文章の型は結論ファーストでAI引用される記事の書き方|4つの型と文型テンプレ付きにまとめています。
よくある質問
- 架空の統計をChatGPTが引用した実験は、いつ、誰が発表したのですか?
-
Peec AIのGEO研究者Metehan Yesilyurt氏の実験です。著者は2026年10月7日付で自身のニュースレターに結果を書き、Peec AIのブログ記事は2026年10月20日に公開されました。
- 架空の統計ページはどうやって作られたのですか?
-
GPT-4.1で1日のうちに約5万ページを生成しました。2文のプロンプトと国・トピックの一覧、基本的なWebテンプレートを使い、数字は検証していません。費用はあとから追加した約1万5000本のリスト記事を含めて約50ドルです。
- ChatGPTの回答に何回表示されたのですか?
-
回答に表示された回数は公表されていません。分かっているのは、直近30日のボットのリクエストが60万件超で、うちChatGPT-Userが約7万2000件だったこと、3月以降のChatGPTからのセッションが1万超だったことです。
- 架空の数字が引用されたという論文や投資調査は確認されていますか?
-
組織の名前は原文で伏せられており、第三者による独立した検証は見つかっていません。RuntimeWireも、著者の計測と引用は独立に検証されていないと書いています。
- Googleの検索結果にも架空の統計は出たのですか?
-
ほぼ出ていません。公開直後にGoogleのアップデートが2回あり、サイトは検索結果からほぼ消えました。インデックスされたページの表示回数は5〜20回にとどまったと著者は書いています。
- robots.txtでChatGPT-Userを止められますか?
-
OpenAIの公式ドキュメントは、ChatGPT-Userはユーザーの操作で動くため、robots.txtのルールが適用されないことがあるとしています。ChatGPT検索への表示はOAI-SearchBot、学習はGPTBotで、それぞれ別に設定できます。
- 自社でも統計ページを量産すればChatGPTなどのAIに引用されますか?
-
勧められません。著者は架空のデータの公開を勧めておらず、手法が今後も効く保証はないと書いています。Googleも、価値のないページの大量生産をスパムポリシーで禁じています。出典つきの本物のデータを出すのが基本です。
- AIが出した数字を使うときは、何を確かめればよいですか?
-
調査主体、調査年、原本のURLの3点です。まとめ記事ではなく、公的統計や調査会社の報告書など原本までさかのぼり、確かめられない数字は使わないようにします。
まとめ
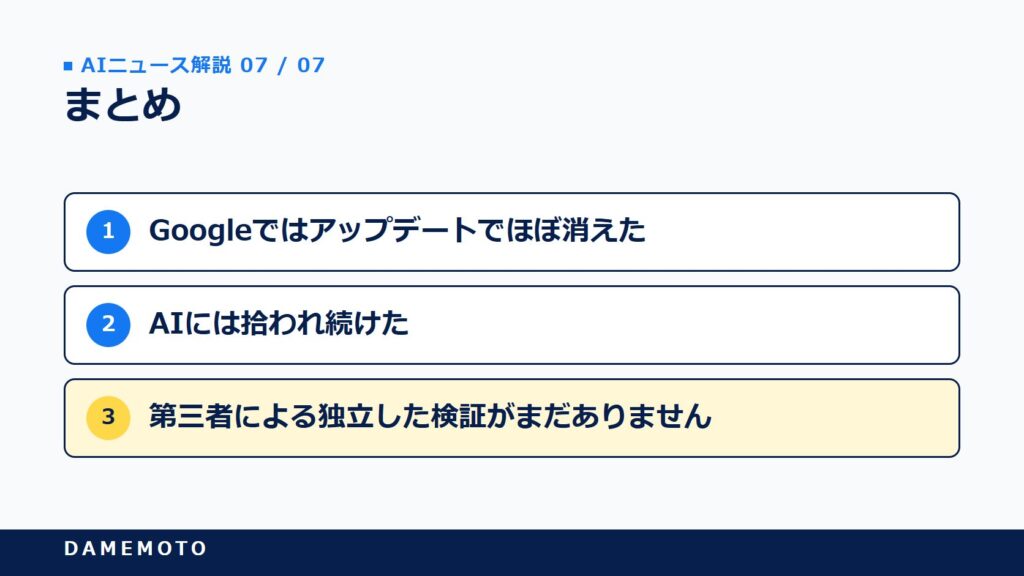
Peec AIが2026年10月20日に公開した実験では、AIで作った架空の統計約5万ページに、ChatGPT-Userが30日で約7万2000件通い、著者によると学術論文や投資調査にまで数字が引用されました。
Googleではアップデートでほぼ消えた一方、AIには拾われ続けた点が大きな特徴です。ただし引用の事実は、第三者による独立した検証がまだありません。
- AIが出した数字は、調査主体・調査年・原本のURLを確かめてから使う
- 自社の統計ページは、数字の横に出典と年を置き、更新日を実際の更新と連動させる
- サーバーログでChatGPT-UserとOAI-SearchBotの来訪を見分ける
AIが数字を検証せずに拾うなら、確かめる役目は人の側に残ります。裏を返せば、出典まで確かな数字を出せる会社やメディアは、それだけで選ばれる理由を持てるということです。今回の実験は、その当たり前の価値を改めて示したといえるでしょう。
参考・出典
- Peec AI「Publish stats, get cited: the tactic that put my data all over the web」(Metehan Yesilyurt、2026年10月20日公開):https://peec.ai/blog/publish-stats-get-cited-the-tactic-that-put-my-data-all-over-the-web
- Metehan Yesilyurt「My GEO experiment escaped the sandbox」(2026年10月7日):https://metehanai.substack.com/p/my-geo-experiment-escaped-the-sandbox
- OpenAI「Overview of OpenAI Crawlers」:https://developers.openai.com/api/docs/bots
- Google検索セントラル「Google ウェブ検索のスパムに関するポリシー」:https://developers.google.com/search/docs/essentials/spam-policies
- Google検索セントラル「有用で信頼性の高い、ユーザー第一のコンテンツの作成」:https://developers.google.com/search/docs/fundamentals/creating-helpful-content
- Google検索セントラル「AI 機能とウェブサイト」:https://developers.google.com/search/docs/appearance/ai-features
- RuntimeWire(2026年10月20日):https://runtimewire.com/article/metehan-yesilyurt-50000-fake-statistics-chatgpt
- DigitalToday(2026年10月21日):https://www.digitaltoday.co.kr/en/view/117670/fake-statistics-50000-pages-chatgpt-accesses-false-site-tens-of-thousands-of-times
- GIGAZINE(2026年10月21日):https://gigazine.net/news/20261021-ai-read-fake-statistics/






