クロールバジェット最適化とは、不要なURLへの巡回を減らし、重要URLをGoogleに見つけてもらいやすくする施策です。
その本質は「クロール上限を増やす」ことでなく「不要なURLを減らし、重要URLを見つけやすくする」ことです。
対象は大規模サイトに限られ、Googleは数千ページ程度の小規模サイトでは気にする必要はないと明言しています。
本記事は仕組み・robots.txt/noindexの使い分け・7つの施策・確認方法までを、Google公式情報を含む一次情報ベースで解説します。
この記事の結論
クロールバジェット対策の本質は、上限を増やすより不要なURLを減らすことだと考えています
今日からやること
- 自サイトのページ数と更新頻度を確かめる
- 重複URLをcanonicalで代表URLにまとめる
- クロール統計情報で回数の推移を見る
こんな人向け:数万ページ以上のECや求人サイトでインデックスの遅れに悩む担当者数値の出典:Google検索セントラル「大規模なサイト所有者向けのクロールバジェット管理ガイド」
クロールバジェットとは:仕組みと対象サイト
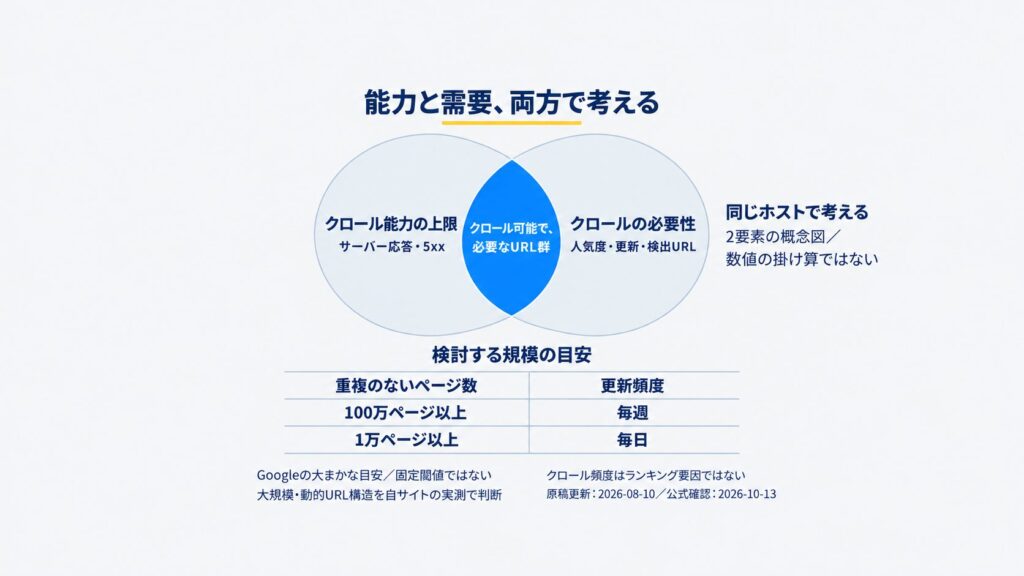
クロールバジェットとは、Googleが一定期間に1つのサイトをクロールできる上限量です。これは「クロール能力の上限」と「クロールの必要性」の2要素で決まります。
ただし、すべてのサイトで意識すべきものではありません。まず仕組みと、対策が必要なサイトを理解しましょう。
クロール能力の上限とクロールの必要性
クロールバジェットは、クロール能力の上限(Crawl Capacity Limit)× クロールの必要性(Crawl Demand)で決まります(Google検索セントラル)。
クロール能力の上限とは、サーバーに負荷をかけずに巡回できる上限値で、同時並行接続数と待ち時間から計算され、サーバーが安定・高速なほど高まります。
クロールの必要性とは、Googleが「頻繁に巡回する価値がある」と判断する度合いで、人気度(アクセス・更新頻度・被リンク)、古さ(再クロールの必要性)、検出されたURL群で決まります(SEM Plus)。
サーバーの安定性と更新の価値がバジェットを左右するのです。なお、ホスト名ごとに別々のバジェットが割り当てられます。
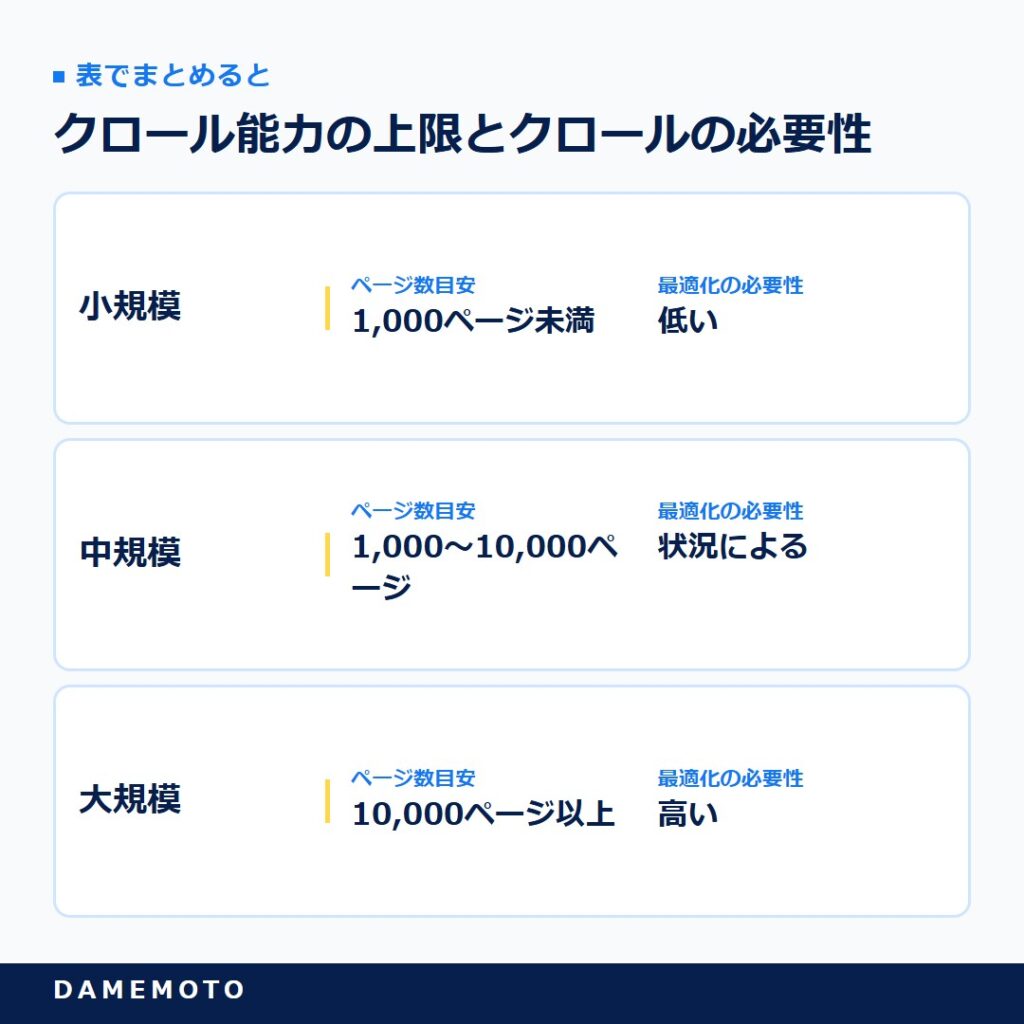
表で詳しく見る
| サイト規模 | ページ数目安 | 最適化の必要性 |
|---|---|---|
| 小規模 | 1,000ページ未満 | 低い |
| 中規模 | 1,000〜10,000ページ | 状況による |
| 大規模 | 10,000ページ以上 | 高い |
対策が必要なのは大規模・動的URLサイト
クロールバジェットは、すべてのサイトで重要なわけではありません。
Googleの公式見解では、数千ページ規模の小規模サイトでは通常クロールバジェットを意識する必要はないとされています(バクヤスAI)。
Googleはクロールバジェットの管理を検討すべき目安として、(毎週更新される)100万ページを超える大規模サイトや、日々更新される1万ページを超えるサイトを挙げています(Google検索セントラル)。
小規模サイトはサイトマップを最新に保ち、定期的にインデックス作成レポートを確認すれば十分です。
最適化が重要になるのは、こうした大規模サイトや、動的にURLが生成されるECサイト、求人・不動産・UGC・ニュースサイトなどです(inSite)。
これらは絞り込みや並べ替えで大量のURLが生成され、不要ページにクロールが分散しやすくなります。まず自サイトの規模を確認し、対策が必要かを判断することが第一歩です。
絞り込みURLが多いECサイトの考え方は、ECサイトのSEO戦略で整理しています。
 DAMEMOTO代表鈴木
まず確認するのは規模。ここを間違えると努力が空振りします
クロール頻度はランキング要因ではない
クロールバジェットには、いくつかの誤解があります。
「クロールが増えれば順位が上がる」と思われがちですが、クロールはインデックスされるために必要な前提に過ぎず、クロール頻度そのものはランキング要因ではありません(Google検索セントラル「クロールに関する誤解と事実」)。
また「サイトマップを送れば必ずクロール・インデックスされる」も誤りで、サイトマップは「見てほしいURL」の表明に過ぎません。
そして最も重要な誤解が、「クロール上限を増やすことが対策の本筋」という考えです。本筋はGoogleに見せる必要のないURLを減らすことです。
クロールバジェット最適化の目的は、限られたクロール量を重要なページに使ってもらいやすくすることにあります。増やすより、無駄をなくす発想が正解です。
クロールバジェットの相談で最初に確認するのは、「そもそも対策が必要なサイトか」です。数千ページのサイトで悩んでいるケースが意外と多い。
Googleが「気にしなくていい」と明言している規模なら、エネルギーは別のSEO施策に回す方が賢明です。
逆に数万ページのECや求人サイトなら、不要URLの整理だけで重要ページのインデックスが見違えるほど速くなる。規模の見極めが、最初の分かれ道だと感じています。
「クロール=順位」ではありません。ここは多くの人が誤解します
クロールバジェットがその中でどう位置づくか、あわせて確認してください。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
robots.txt・noindex・canonicalの使い分け
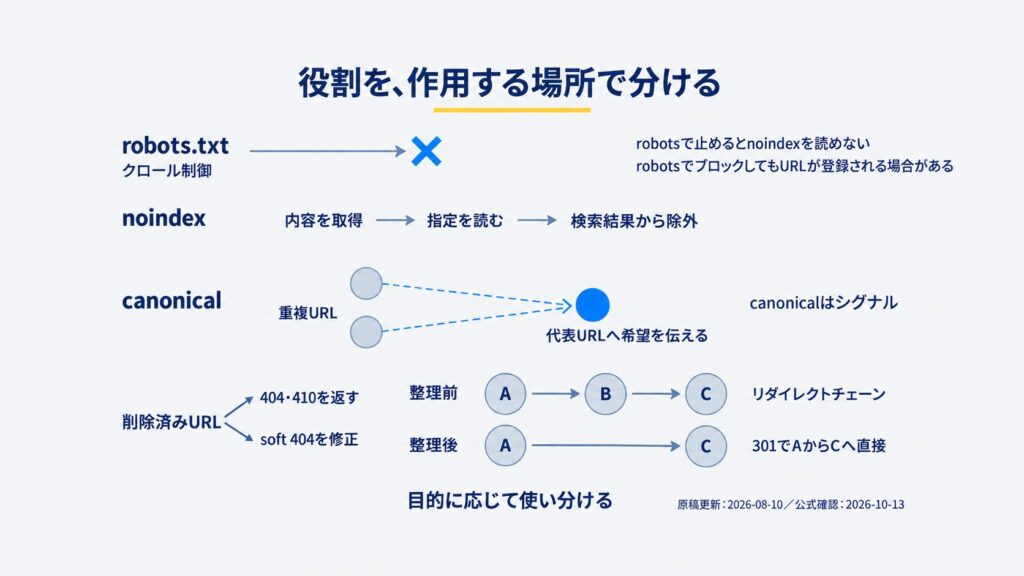
クロールバジェット最適化で混同されやすいのが、robots.txt・noindex・canonicalの役割です。これらは目的が異なり、誤って使うと逆効果になります。正しい使い分けが、効果的なクロール制御の前提です。
robots.txtはクロール制御、noindexは除外指定
最も重要な区別が、robots.txtとnoindexの違いです。robots.txtはクロール制御で、不要なファイルやディレクトリへの巡回を防ぎます。
一方、noindexはクロール後に検索結果から除外する指定で、クロール自体は発生します(inSite)。
Googleはnoindexルールを見つけるためにそのページをクロールする必要があるため、noindexはクロールを節約しないのです(Google検索セントラル「クロールに関する誤解と事実」)。
大量の不要ファイルへのクロールを効率的に防ぎたいならrobots.txt、インデックスを完全に防ぎたいならnoindexを使います(バクヤスAI)。
注意点として、robots.txtでブロックしても、外部からリンクされているとインデックスされる可能性があるため、目的に応じた使い分けが必要です。
同じURLでnoindexを読ませたいときは、robots.txtで取得を妨げないようにします。クロール制御の具体的な記述はrobots.txtの書き方でコピーできる例とあわせてまとめています。
canonicalで重複URLを代表URLに統合
重複URLの対策には、canonicalタグが有効です。
ECサイトは、並べ替え・フィルタリング・サイト内検索などで、同じまたはほぼ同じコンテンツが複数のURLに生成されがちです(Lumar)。
これらの重複URLをcanonicalで代表URL(正規URL)に統合することで、クロールの浪費を防ぎ、評価を集約できます。
たとえば、同じ商品が複数のカテゴリ経由のURLで存在する場合、1つの代表URLにcanonicalで寄せます。URLは常に1バージョンに保つことが重要です。
301リダイレクトで代表URLに寄せる方法もあります。重複の解消は、クロールバジェット最適化の中核施策の一つです。
404/410とリダイレクトを正しく返す
削除ページとリダイレクトの扱いも重要です。完全に削除されたページは、404または410を返すようにします(SEM Plus)。
これによりGooglebotは「このURLはもう存在しない」と認識し、無駄なクロールを減らせます。
逆に、存在しないのに200(正常)を返す「soft 404」は、Googlebotが実在ページと誤認して何度もクロールするため、必ず修正します。
また、リダイレクトチェーン(A→B→Cと連鎖するリダイレクト)は、クロール経路を長くしバジェットを浪費するため、A→Cと直接リダイレクトするよう整理します。
robots.txt・noindex・canonical・404/410・301は、それぞれ役割が違うため、混同せず目的に応じて使い分けることが大切です。
soft 404は地味な天敵。200を返し続けて無駄打ちを誘います
robots.txtはクロール制御、noindexは除外。混同しない
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
7つの最適化施策と進め方
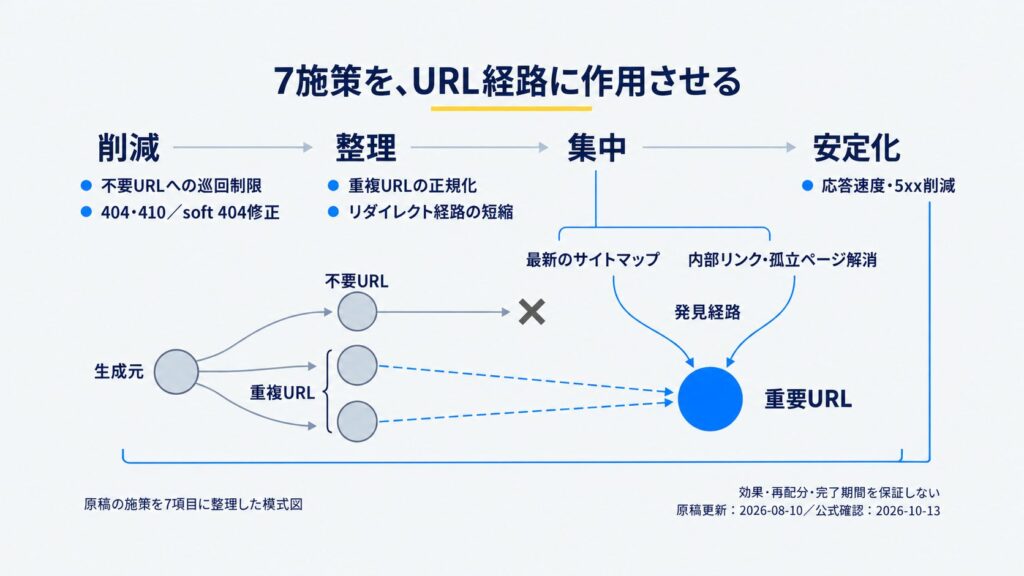
クロールバジェットの最適化は、7つの施策に整理できます。やみくもにでなく、「削減→整理→集中→安定化」の順で段階的に進めるのが効果的です。不要なクロールを止め、重要ページに集中させることが基本方針です。
無駄なクロールを止める(削減)
最優先は、無駄なクロールを止めることです。
重複コンテンツの統合、robots.txtでの不要ページ制限、削除ページの404/410化、soft 404の削除が該当します(SEM Plus)。
具体的には、パラメータ付きURLの整理、絞り込み検索URLの制御、低品質なタグページの削除・統合を行います(シンプリック)。
なおGoogleは、クロール予算の一時的な再配分を狙ってrobots.txtを使うのではなく、「そもそもクロールさせたくないページ」をブロックする用途で使うよう案内しています(Google検索セントラル)。
これらは即効性のある施策で、404エラーや重複ページへのクロールを減らすことで、比較的早くクロールパターンの改善が確認できます。
まずクロールの浪費を止めるのが、最も効果の高いアプローチです。不要URLを減らすほど重要ページに余力が回るという関係を意識します。重要ページにクロールを集中させる土台を作ります。
サイトマップと内部リンクで集中させる
削減の次は、重要ページにクロールを集中させます。XMLサイトマップを最新に保ち、見てほしい正規URLだけを載せます(inSite)。
リダイレクトチェーンを整理してクロール経路を短くし、内部リンクを強化して重要ページへの到達性を高めます。
孤立ページ(どこからもリンクされていないページ)を解消することも、クロール到達率の向上につながります。
Googleはクロール対象URLを重要度順に並べてクロールするため、サイトマップ・内部リンク・被リンクといったシグナルで重要ページの優先度を高めることが効きます(Lumar)。
重要なページを見つけやすく、たどり着きやすくすることが、集中の鍵です。サイトマップの記述と送信の手順は、sitemap.xmlの書き方もあわせて確認しておきたいところです。
サーバーを安定・高速化する(安定化)
仕上げは、サーバー環境の安定化です。クロール能力の上限はサーバー品質に左右され、サーバーが不安定だと検索エンジンは負荷を避けてクロール頻度を抑制します(シンプリック)。
表示速度を改善し、5xxエラーを削減し、不安定なホスティング環境を見直します。
GoogleのGary Illyes氏は「Googlebotはサーバーが低速化するまでクロールを継続する」と述べており、サイトが軽く速く読み込まれるほど、より多くのページをクロールできます(Lumar)。
GZIP圧縮でHTML・CSS・JSのファイルサイズを縮小し、サーバー応答を速くすることも有効です。サーバーの安定性が、クロールバジェットの土台を支えます。
DAMEMOTO代表鈴木速いサーバーほど多く回ってもらえる。地味だけど効きます
ページの表示速度改善はクロール許容量の向上に直結します。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
確認方法と注意点
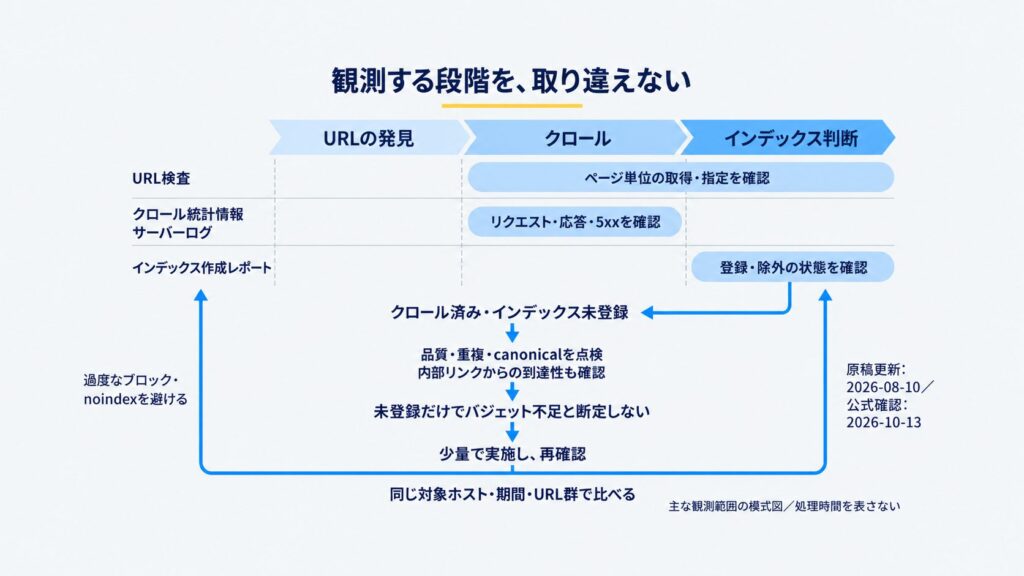
クロールバジェット最適化は、Search Consoleやサーバーログで状況を確認しながら進めます。また、「クロール済み-インデックス未登録」など、クロールバジェットと混同されやすい問題もあります。正しく状況を把握することが大切です。
Search Consoleとサーバーログで確認する
クロール状況の確認には、Google Search Consoleが基本です。
クロール統計情報レポートでクロール回数の推移を確認し、急減していればサーバーエラーや速度低下を疑います(シンプリック)。
インデックス作成レポートで登録・除外の状況を、URL検査ツールでページ単位の詳細を確認します。さらに踏み込むなら、サーバーログの分析が有効です。
サーバーログには全リクエストのデータが含まれ、Splunkなどの分析ツールを使うと、Googlebotのクロール頻度、最も頻繁に訪問されるページ、クロールされたファイル容量が分かります(Lumar)。
複数の角度から確認することで、どこに無駄があるかを正確に把握できます。推測でなくログとデータで判断するのが、効率的な最適化の前提です。
レポートの見方そのものは、Search Consoleの使い方を読むと迷いにくいはずです。
「クロール済み-未登録」は別の問題
注意したいのが、クロールバジェットと混同されやすい問題です。
Search Consoleの「クロール済み-インデックス未登録」は、多くの場合クロールバジェットでなく、品質・重複・canonicalの問題です(inSite)。
クロール済みである時点でバジェットは割り当てられており、インデックスを見送られている理由は別にあります。
本文の薄さ、既存ページとの重複、canonicalの設定、内部リンクからの到達性を点検します。クロール済みなら原因は品質・重複側にあると考えるのが基本です。
また、クローラビリティ(Googlebotが発見・クロールできる状態か)とクロールバジェット(限られたクロールをどのURLに使うか)は別の話です。
順序として、まずクローラビリティを整えてから、不要URLの整理に進むのが基本です。問題の切り分けが、的確な対策につながります。
過度な制限を避け段階的に進める
最適化を進める際は、過度な制限を避けることが大切です。
robots.txtで広範囲をブロックしすぎたり、必要なページまでnoindexにしたりすると、かえって重要ページがクロール・インデックスされなくなる恐れがあります。
慎重に進め、定期的な見直しを行います(バクヤスAI)。施策の効果は通常2〜4週間程度で現れ始めますが、サイト構造の大幅な変更は数か月かかることもあります。
Search Consoleのクロール統計情報を定期的に確認しながら、焦らず経過を観察します。
クロールバジェット対策は、日々のリリースや記事追加のたびに「このURLをGoogleに見せる必要があるか」を判断する習慣として、運用に組み込むのが理想です。継続的な視点が効きます。
クロール統計情報の見方とあわせて確認してください。
クロールバジェット対策が「不要」なのはどんなサイトか
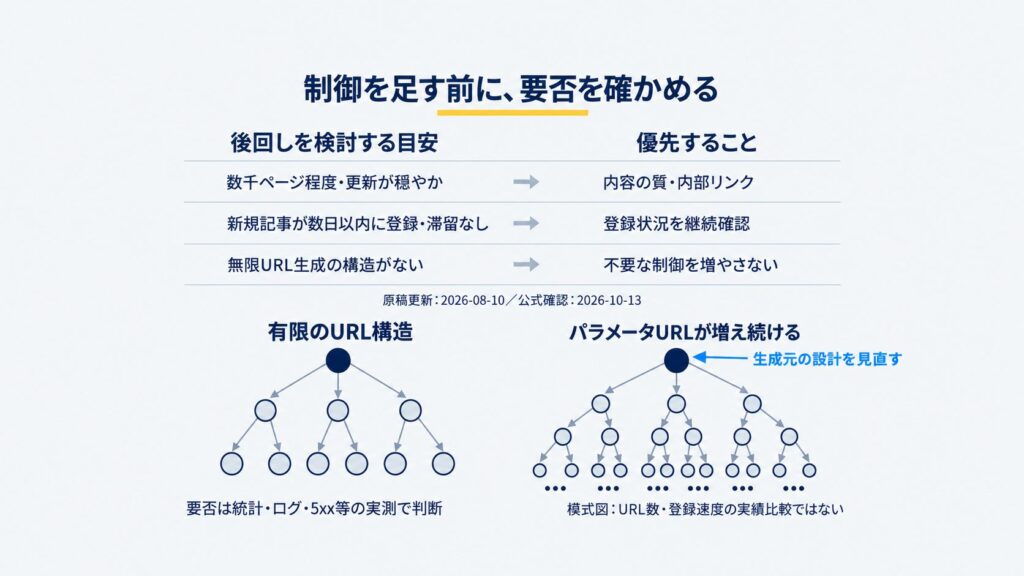
正直に書くと、この記事を読んでいる多くのサイトは、クロールバジェットを能動的に管理する必要がありません。
Google自身が「ほとんどのサイトでは気にしなくてよい」と説明しており、無理に制御を足すと逆効果になります。次に当てはまるなら、対策より先に取り組むべきことがあります。
- 総ページ数が数千程度で、更新頻度も穏やかなサイト(コンテンツの質と内部リンク整備が先)
- 新規記事がGoogleに数日以内でインデックスされており、滞留が起きていないサイト
- パラメータやファセットによる無限URL生成の構造を抱えていないサイト
また、本記事だけで分からないこともあります。自サイトの実際のクロール挙動は、Search Consoleのクロール統計情報やサーバーログを見なければ判定できません。
「うちは対策が要るのか」を一般論で決めず、必ず自サイトの実測(クロール回数の推移、クロール済み-未登録の件数、5xxの有無)から判断してください。
クロールバジェットは大規模サイトの武器ですが、小規模サイトにとっては優先度の低いテーマ。やみくもな制御は足を引っ張るだけだと、はっきり認識しておくことが大切です。
小規模サイトで先に取り組むべきことは、テクニカルSEO全体の優先順位で整理しています。
「やらない勇気」も最適化。要否は実測で決めましょう
よくある質問
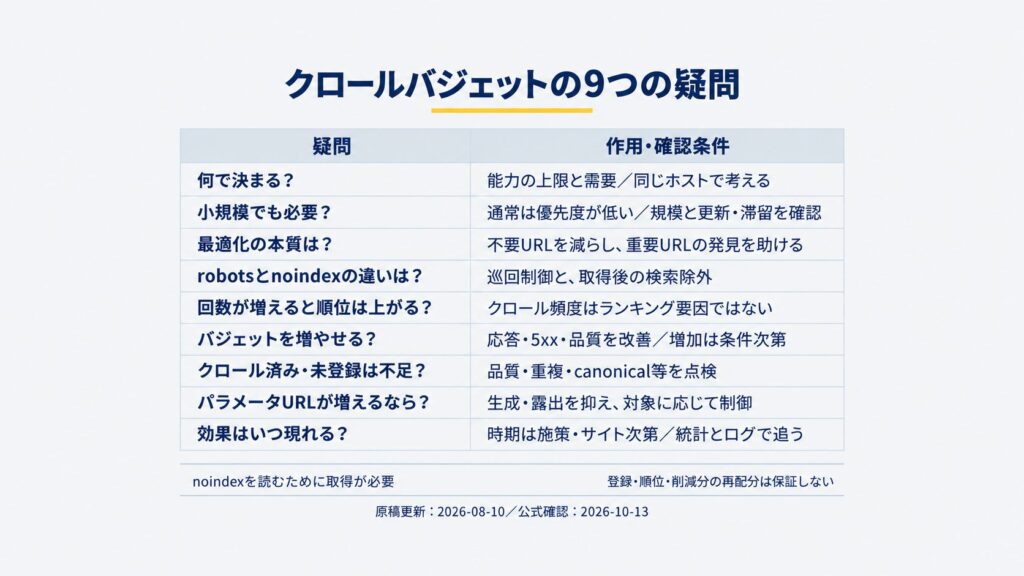
- クロールバジェットとは何ですか?
-
Googleが一定期間に1つのサイトをクロールできる上限量です。クロール能力の上限(サーバーに負荷をかけず巡回できる量)と、クロールの必要性(頻繁に巡回する価値があるか)の2要素で決まります。不足すると重要なページのインデックスが遅れ、検索結果への反映が遅れる原因になります。
- クロールバジェットは小規模サイトでも気にすべき?
-
気にする必要はありません。Googleは、管理を検討すべき目安として「毎週更新される100万ページ超」や「日々更新される1万ページ超」を挙げています。これに満たない小規模サイトは、サイトマップを最新に保ち、インデックス作成レポートを確認すれば十分です。問題になるのは大規模サイトや、動的にURLが生成されるEC・求人・UGCサイトです。
- クロールバジェット最適化の本質は何ですか?
-
「クロール上限を増やす」ことでなく、「Googleに見せる必要のないURLを減らし、重要URLを見つけやすくする」ことです。限られたクロール量を重要なページに使ってもらうのが目的です。不要なURLを整理し、重要ページにクロールを集中させる発想が正解です。
- クロールバジェット対策でrobots.txtとnoindexはどう使い分けますか?
-
robots.txtはクロール制御で不要ファイルへの巡回を防ぎ、noindexはクロール後に検索結果から除外する指定です。Googleはnoindexルールを見つけるためにそのページをクロールする必要があるため、noindexはクロールを節約しません。大量の不要ファイルへのクロールを防ぐならrobots.txt、インデックスを完全に防ぐならnoindexを使います。
- クロールが増えれば検索順位は上がりますか?
-
上がりません。クロールはインデックスの前提に過ぎず、クロール頻度そのものはランキング要因ではないとGoogleが明言しています。クロールバジェット最適化の目的は順位を直接上げることでなく、重要なページが速やかにインデックスされ、検索結果に反映されるようにすることです。クロールを増やすこと自体が目的化しないよう注意しましょう。
- クロールバジェットを増やすことはできますか?
-
上限を直接増やすことはできませんが、サーバーの応答速度を改善すると、Googlebotがより多くのページをクロールできるようになります。GZIP圧縮や5xxエラーの削減も有効です。また、高品質なコンテンツを継続的に公開すると、クロール需要が高まりクロール頻度が向上する可能性があります。
- 「クロール済み-インデックス未登録」はバジェットの問題?
-
多くの場合、クロールバジェットでなく品質・重複・canonicalの問題です。クロール済みである時点でバジェットは割り当てられており、インデックスを見送られている理由は別にあります。本文の薄さ、既存ページとの重複、canonical設定、内部リンクからの到達性を順番に点検しましょう。
- パラメータURLが大量に生成されるサイトのクロールバジェット対策は?
-
絞り込みや並べ替えで無限にURLが増える構造は、生成元の設計から見直すのが基本です。クロールさせたくないパラメータは、Googleの案内に沿ってrobots.txtでブロックし、重複は正規URLにcanonicalで集約します。URLの自動生成自体を抑え、不要なものはリンクさせない(露出させない)設計にすることが、根本的な無駄の削減につながります。
- クロールバジェット最適化の効果はどのくらいで現れますか?
-
施策内容にもよりますが、一般的には実施から2〜4週間程度で効果が現れ始めます。robots.txtの調整など即効性のある施策は比較的早く変化が確認でき、サイト構造の大幅な変更は数か月かかることもあります。Search Consoleのクロール統計情報を定期的に確認しながら経過を観察しましょう。
【独自】クロールバジェット対策が必要かを見極める判断フロー
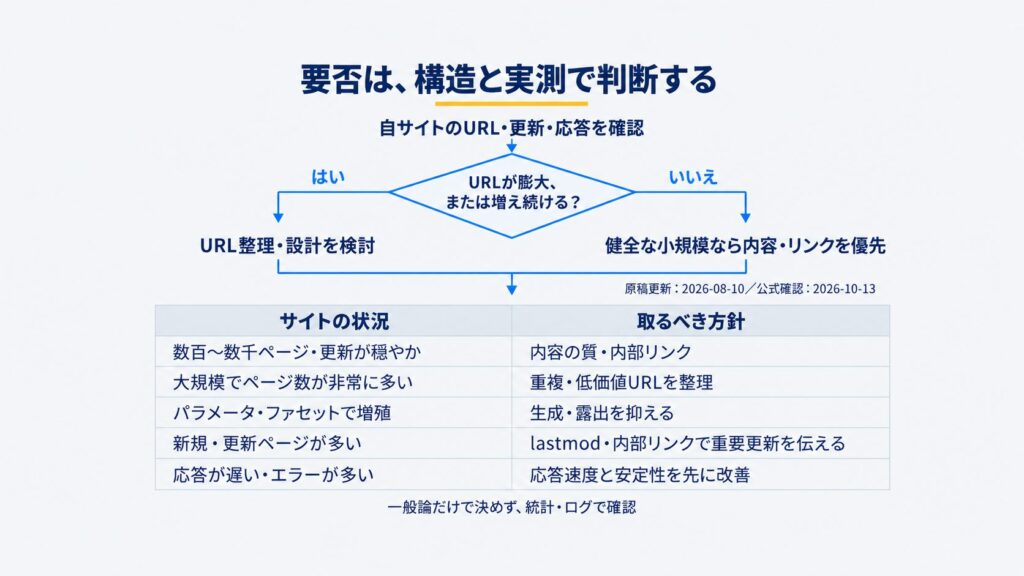
クロールバジェットは「クロールの能力上限(クロールレート)」と「クロールの需要(クロール需要)」のかけ合わせで決まる概念で、Googleは大多数のサイトでは気にする必要がないと説明しています。
にもかかわらず小規模サイトで過剰に対策し、本来不要な制御を入れて逆効果になるケースがあります。
まずは自サイトが対策の検討対象に当たるかどうかを、規模と更新頻度の観点で判定してください。
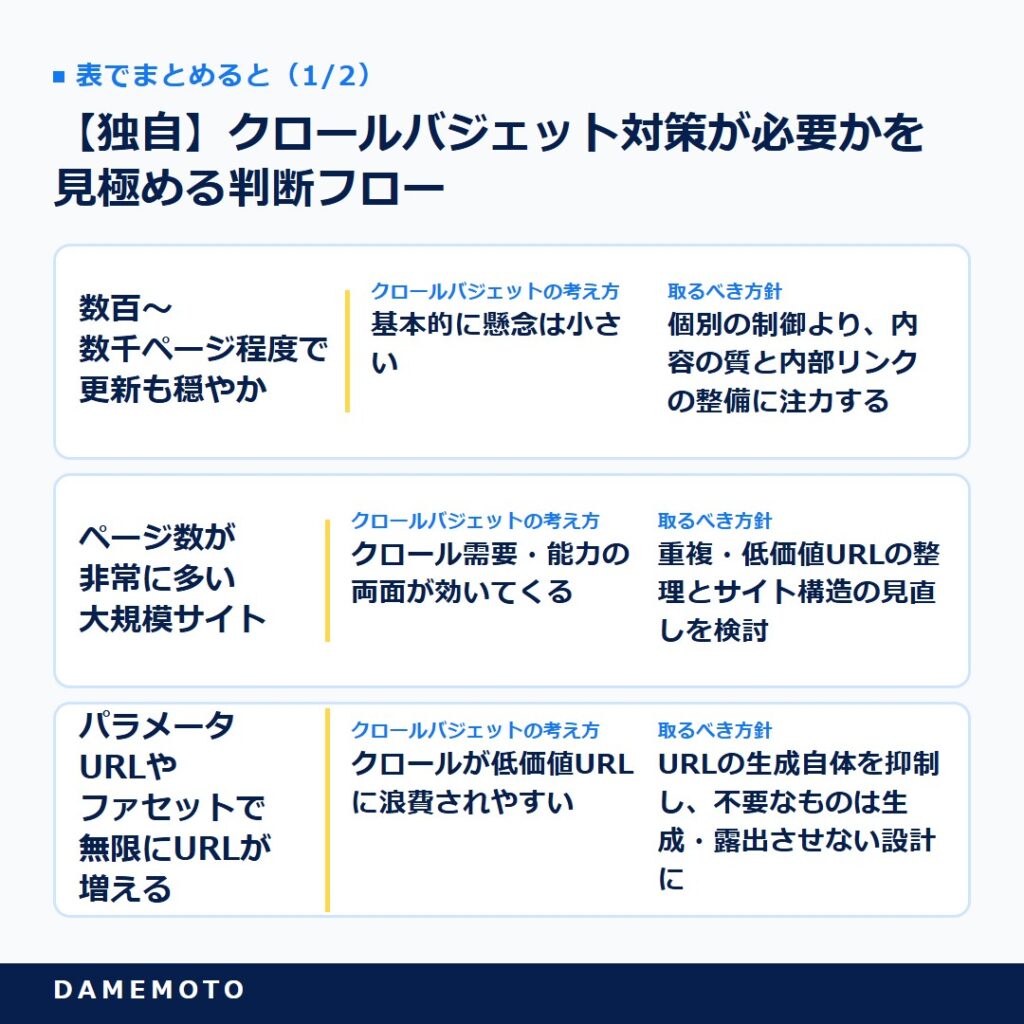
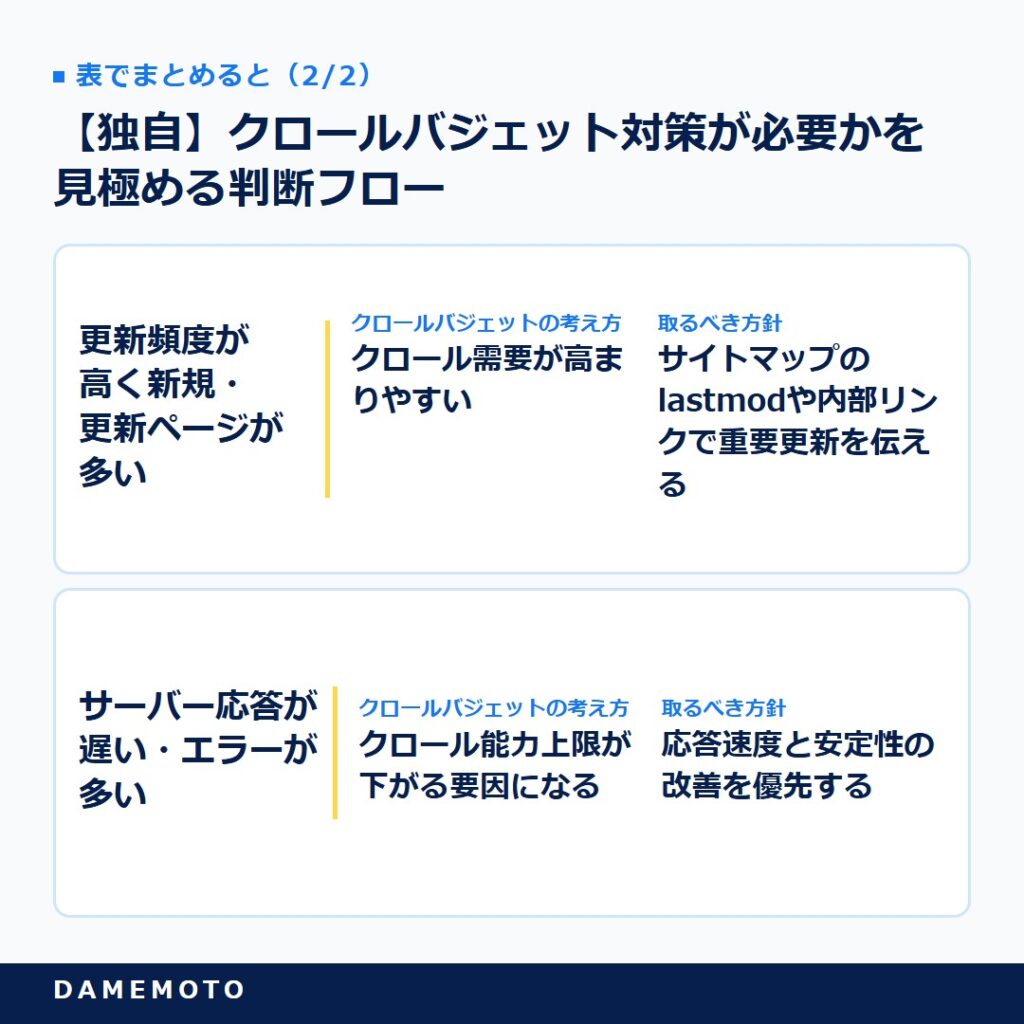
表で詳しく見る
| サイトの状況 | クロールバジェットの考え方 | 取るべき方針 |
|---|---|---|
| 数百〜数千ページ程度で更新も穏やか | 基本的に懸念は小さい | 個別の制御より、内容の質と内部リンクの整備に注力する |
| ページ数が非常に多い大規模サイト | クロール需要・能力の両面が効いてくる | 重複・低価値URLの整理とサイト構造の見直しを検討 |
| パラメータURLやファセットで無限にURLが増える | クロールが低価値URLに浪費されやすい | URLの生成自体を抑制し、不要なものは生成・露出させない設計に |
| 更新頻度が高く新規・更新ページが多い | クロール需要が高まりやすい | サイトマップのlastmodや内部リンクで重要更新を伝える |
| サーバー応答が遅い・エラーが多い | クロール能力上限が下がる要因になる | 応答速度と安定性の改善を優先する |
結論として、小規模で健全なサイトはクロールバジェットを能動的に管理する必要はほぼありません。対策が意味を持つのは、URLが膨大、または無限に増える構造を抱えるサイトです。
自サイトがどの行に当たるかを見極めることが、不要な制御で足を引っ張らないための第一歩になります。ページ送りやフィルタでURLが増える一覧は、ページネーションとフィルタURLの扱いで設定を確認できます。
【独自】クロールバジェットを誤解した施策の失敗パターン集
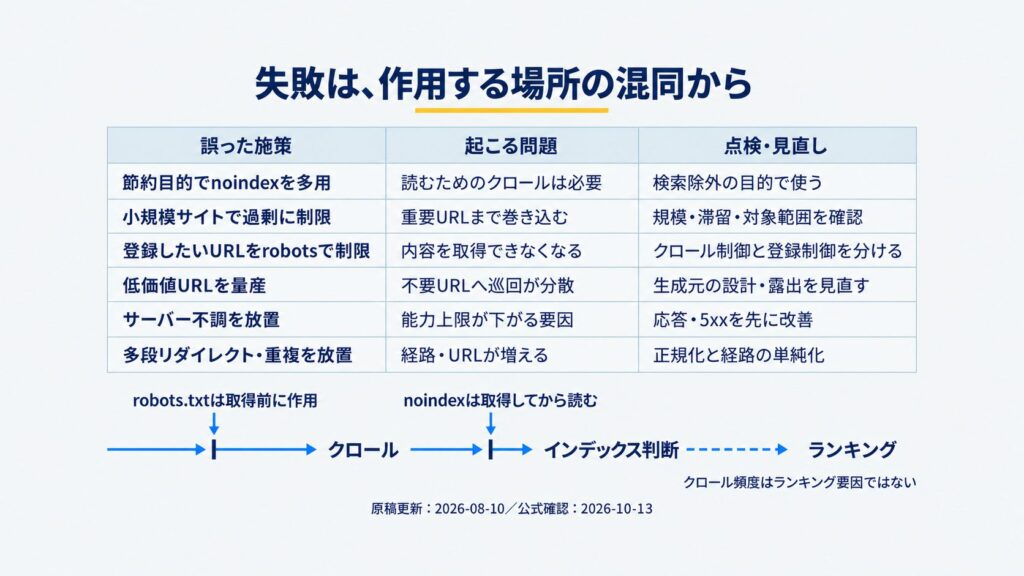
クロールバジェットの周辺は誤解が多く、「節約のつもりが逆に検索面で不利になる」操作が後を絶ちません。とくに重要なのは、noindexはクロールの節約手段ではないという点です。
noindexはインデックスを抑える指定であり、その判断のためにGoogleはページをクロールする必要があるからです。以下の失敗パターンに当てはまっていないか確認してください。
- クロール節約目的でnoindexを多用:noindexはクロールを減らす手段ではない。指定を読むためにクロールは必要で、節約効果は期待できない。
- 小規模サイトでの過剰なクロール制御:本来不要なのにrobots.txtで広範囲をブロックし、重要ページまで巻き込む。規模に見合わない対策はリスクだけ残る。
- インデックスさせたいページをrobots.txtでブロック:クロールを止めると内容を読めず、かえって評価されにくくなる。クロール制御とインデックス制御を混同しない。
- 低価値URLを放置したまま量産:パラメータや絞り込みで無価値URLが増え続け、クロールが分散する。生成元の設計から見直す。
- サーバー不調を放置:応答悪化やエラー増加でクロール能力上限が下がる。コンテンツ側より先にインフラの安定性を確保する。
- リダイレクトチェーンや重複の放置:多段リダイレクトや重複URLでクロールが無駄に消費される。正規化と経路の単純化を進める。
失敗の根っこは、「クロール」「インデックス」「ランキング」を一つの蛇口のように捉えてしまう点にあります。
noindexはインデックスの蛇口、robots.txtはクロールの蛇口であり、片方を閉じてももう片方は別の経路で動きます。
役割を分けて理解すれば、節約のつもりが逆効果になる事故は避けられます。
まとめ:クロールバジェットは「無駄を減らし集中させる」
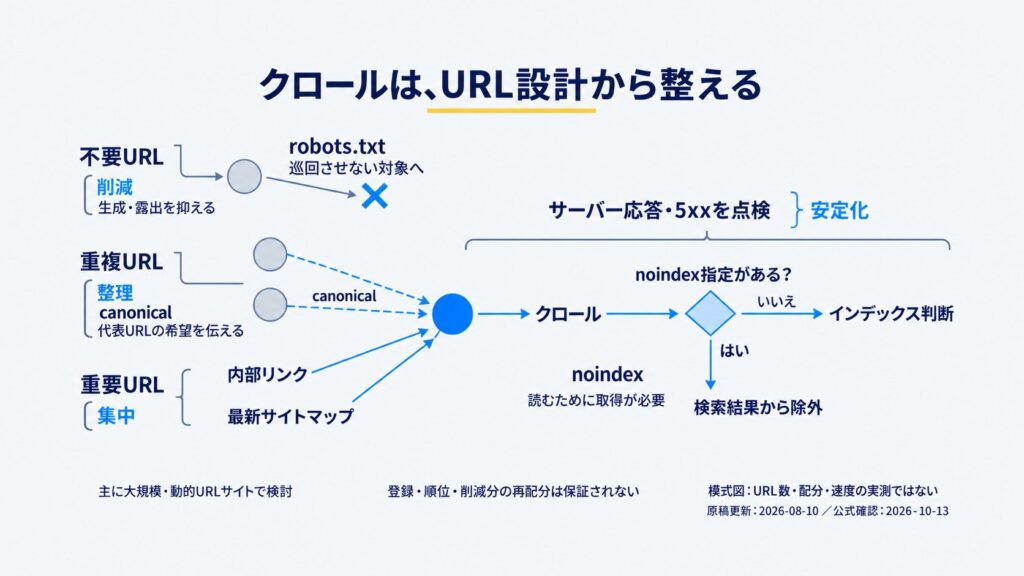
クロールバジェット最適化の本質は、不要なURLを減らし、重要URLにクロールを集中させることです。
対象は大規模サイトに限られ、robots.txtとnoindexを役割で使い分け、削減→整理→集中→安定化の順で進めます。最後に要点を3行で整理します。
- 対象は大規模サイト、本質は不要URL削減
- robots.txt・noindex・canonicalを役割で使い分ける
- 削減→整理→集中→安定化の順で進める
クロールバジェット最適化は、大規模サイトのSEOを左右する重要な施策ですが、その本質は意外とシンプルです。
Googleに見せる必要のないURLを減らし、見てほしい重要なページを見つけやすくする。ただそれだけです。新しい施策を足すのでなく、不要なものを引いていく。
日々のリリースや記事追加のたびに「このURLをGoogleに見せる必要があるか」と問う習慣が、長期的なサイト運用に効いてきます。
クロールバジェットは、URL設計の延長線上にあるテーマ。引き算の発想で、限られたクロールを最も価値あるページに届けることが、大規模サイトのSEOを安定させる鍵だと考えています。
参考URL一覧
- Google検索セントラル(公式)・大規模なサイトのクロール バジェットの管理:https://developers.google.com/search/docs/crawling-indexing/large-site-managing-crawl-budget?hl=ja
- Google検索セントラル(公式)・クロールに関する誤解と事実:https://developers.google.com/crawling/docs/myths-about-crawling
- SEM Plus・クロールバジェットとは?定義と上限・最適化の方法:https://white-link.com/sem-plus/crawlbudget
- inSite・クロールバジェットとは?Googlebotに不要なURLを見せない考え方:https://in-site.jp/blog/crawl-budget
- シンプリック・クロールバジェットとは?影響・確認方法・改善策:https://simplique.jp/crawl-budget
- Lumar・SEOのためのクロールバジェット最適化ガイド:https://www.lumar.io/ja/blog/best-practice/optimize-crawl-budget-tips-examples
補足参考資料