重複コンテンツは、それ自体はペナルティになりません。本当の問題は、評価の分散・クロールの無駄・意図しないページ表示です。
対策はcanonical・301・noindex・統合を原因別に使い分けます。本質は「同じ検索意図のページを統合する」ことです。
重複コンテンツは、SEO対策の中で意図せず発生しがちな問題です。ペナルティを恐れる方が多いですが、本当の怖さは評価の分散にあります。
本記事は、重複コンテンツとコピーコンテンツの違い、SEOへの影響、発生原因、原因別の対策と判断までを、Google公式情報を含む一次情報ベースで解説します。
この記事の結論
重複コンテンツは罰より評価の分散が問題で、同じ意図のページの統合が本質だと考えています
今日からやること
- Search Consoleの「ページ」で重複を確かめる
- http・www・末尾スラッシュを1つに揃える
- 同じ検索意図の記事を1本に統合する
こんな人向け:似た記事やURLの揺れが増え、順位が伸び悩んでいるサイト運営者
重複コンテンツとは:定義と種類
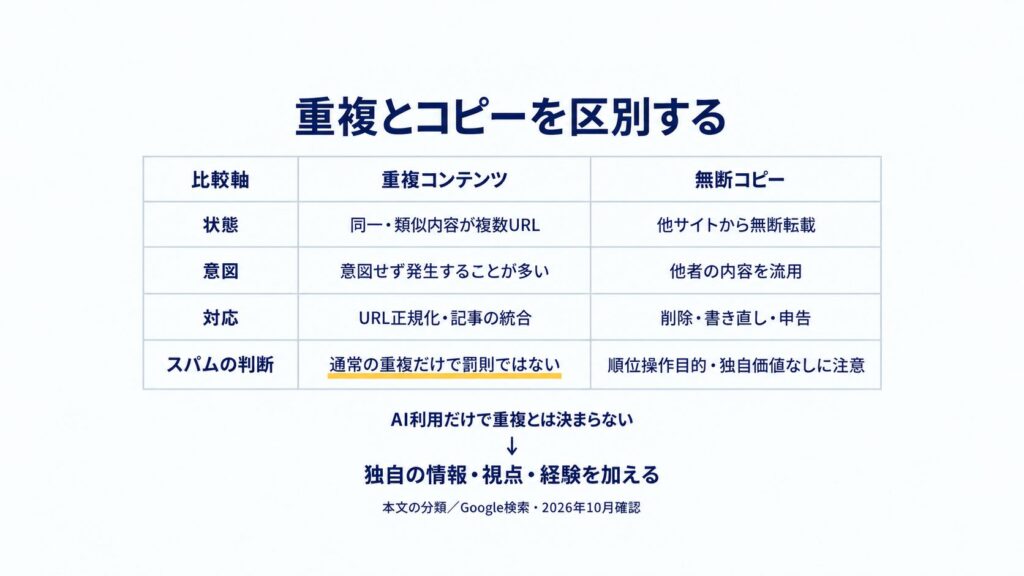
重複コンテンツを理解する出発点は、その定義と、コピーコンテンツとの違いです。何が重複に該当するのか、そして重複とコピーはどう異なるのかを押さえましょう。この区別が、適切な対策の前提になります。
同一・類似コンテンツが複数URLに存在する状態
重複コンテンツとは、同一または極めて類似した内容のページが、複数のURLに存在する状態を指します(センタリング)。
これには、サイト内部の重複のほか、外部サイトとの重複、自動生成ページ、複数ドメイン間の重複も含まれます。重複コンテンツは同じ内容が複数URLに存在する状態です。
Googleは、単純なテキストの一致だけでなく、構造の類似性や意味的な近似値にも着目し、独自のアルゴリズムで総合的に評価しています。
重要なのは、重複コンテンツの多くが意図せず発生するという点です。サイトの仕様やCMSの設定によるURLの重複、似たテーマの記事の作成など、悪意がなくても自然に起きてしまいます。
多くのWebサイトで自然に発生するため、重複コンテンツが存在すること自体は珍しいことではありません。
だからこそ、過度に恐れる必要はありませんが、放置すると後述するSEO上のデメリットが生じます。
まずは、重複が「同じ内容の複数URL」という状態を指すこと、そしてそれが意図せず起きやすいことを理解しておきましょう。
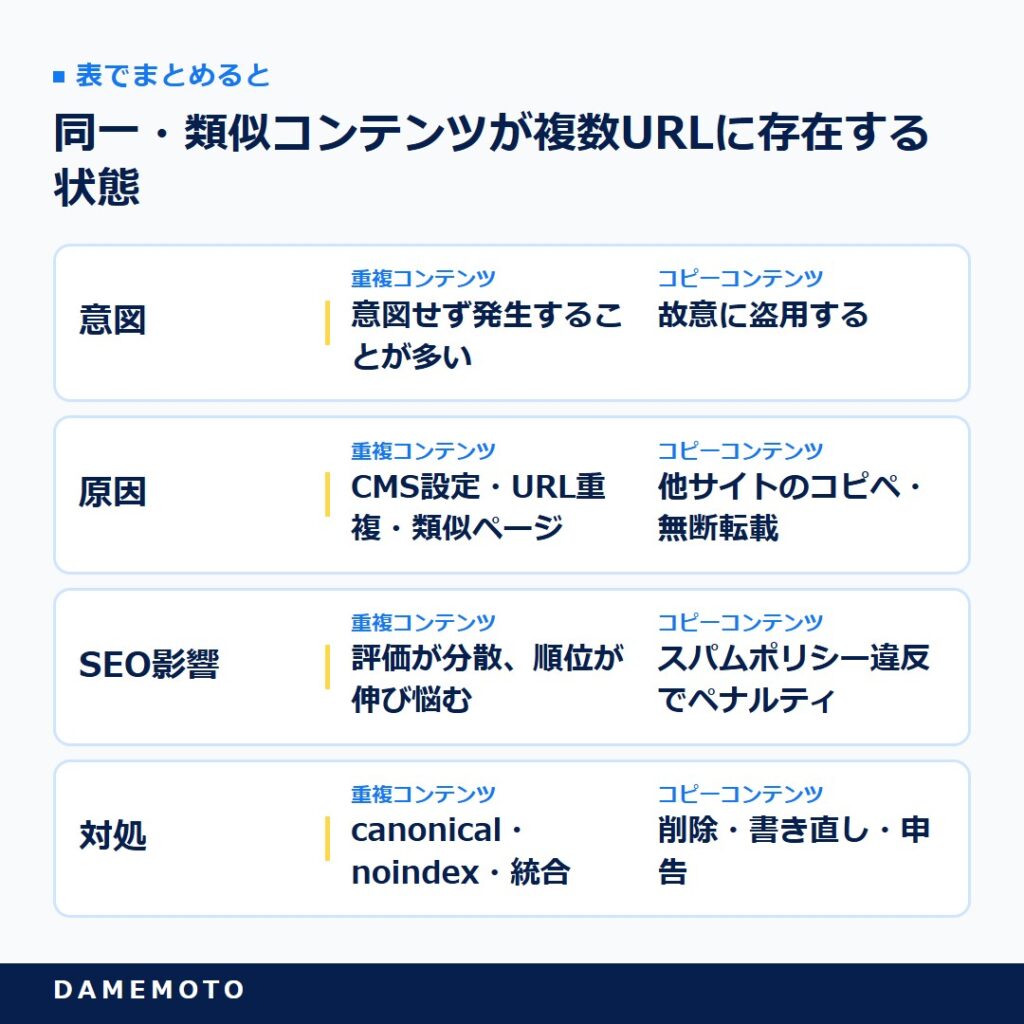
表で詳しく見る
| 項目 | 重複コンテンツ | コピーコンテンツ |
|---|---|---|
| 意図 | 意図せず発生することが多い | 故意に盗用する |
| 原因 | CMS設定・URL重複・類似ページ | 他サイトのコピペ・無断転載 |
| SEO影響 | 評価が分散、順位が伸び悩む | スパムポリシー違反でペナルティ |
| 対処 | canonical・noindex・統合 | 削除・書き直し・申告 |
コピーコンテンツとは明確に異なる
重複コンテンツと混同されやすいのが、コピーコンテンツです。両者は明確に異なります。
重複コンテンツが、同じサイト内または異なるURL間でほぼ同じ内容が存在する状態(意図せず発生することが多い)であるのに対し、コピーコンテンツは、他のサイトやページから無断でコピーしたコンテンツ(故意の盗用)です(EmmaTools)。
重複は意図せず、コピーは故意という違いがあるのです。SEOへの影響も異なります。
重複コンテンツはSEO評価が分散し検索順位が下がる可能性がありますが、コピーコンテンツはGoogleのスパムポリシーに違反し、ペナルティを受ける可能性があります。
コピーコンテンツは、他者の文章や情報を意図的にコピーし、自サイトのオリジナルとして掲載する行為で、著作権侵害や不正行為にあたることが多いです。
Googleは「スパムに関するポリシー」で、コピーコンテンツを「スクレイピング」という項目で取り上げ、厳しく扱っています。
重複とコピーは、対策方法も全く異なるため、まずこの区別を明確にすることが大切です。
AI生成コンテンツの注意点
2026年に注意したいのが、AIで作成したコンテンツの重複リスクです。
AIを活用して作成したコンテンツをそのまま公開すると、重複コンテンツになる可能性があります(EmmaTools)。
AIはWeb上の情報をもとに文章を生成するため、情報源となる他社のコンテンツと、類似した表現や構成になりがちです。
とくに、一般的なトピックについてAIが作成したコンテンツは、多くのサイトと似通ったものになりやすいです。
Googleは、自動生成やAIによる同一記事の大量公開を明確に制限しており、「質の高い独自性のある情報が評価される」と明言しています(センタリング)。
AIをコンテンツ作成に使う場合は、そのまま公開せず、独自の情報・視点・経験を加えて差別化することが重要です。
AIはあくまで下書きや効率化のツールとして使い、最終的には人の手でオリジナリティを担保します。AI生成コンテンツの量産は、重複リスクとともに、独自性不足による評価低下も招きます。
AIの活用と独自性の確保を両立させる姿勢が、これからのコンテンツ制作には求められます。AIで作る記事の品質の線引きはAI生成コンテンツの品質基準で整理しています。
重複コンテンツの相談で最も多い誤解が、「重複=ペナルティ」という思い込みです。実際には、悪意のない重複でペナルティを受けることは稀。
本当に怖いのは、じわじわ効いてくる評価の分散です。ペナルティを恐れて過剰に対策するより、「同じ検索意図のページを統合する」という本質に向き合うほうが効く。
技術設定の前に、コンテンツの役割を整理することが大事だと感じています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
SEOへの影響:評価分散が本質
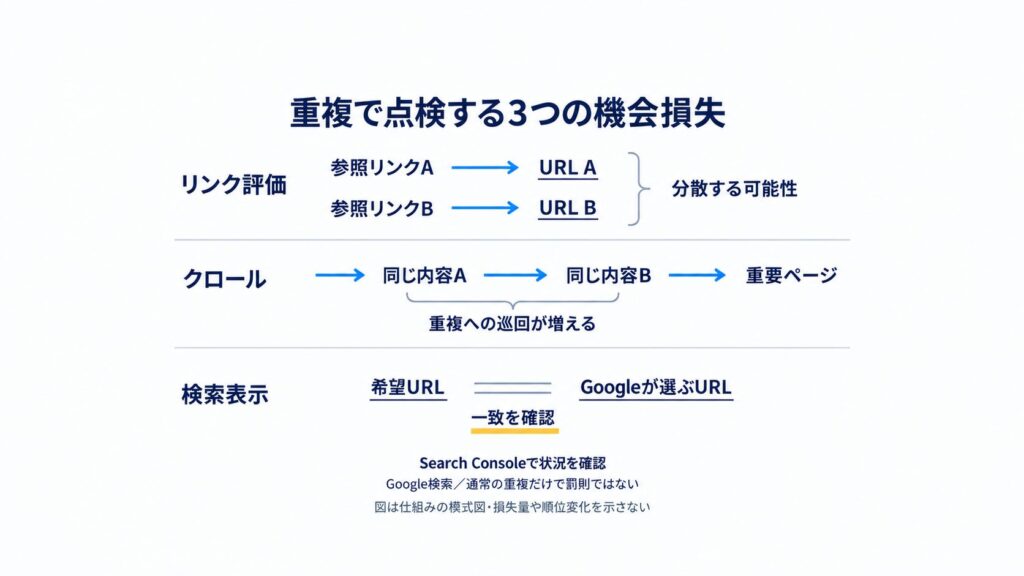
重複コンテンツの影響について、正確に理解しておきましょう。多くの人がペナルティを心配しますが、本当の問題は別にあります。ペナルティの実態と、3つのデメリットを解説します。恐れるべきポイントを正しく見極めることが大切です。
重複自体はペナルティにならない
まず、重要な事実を押さえましょう。重複コンテンツ自体は、SEOのペナルティにはなりません。
Googleは、悪意のない重複に対してペナルティを科さないと明言しています(inSite)。
SEO対策を進める中で、意図せず重複コンテンツが発生することは頻繁にあり、多くのWebサイトで自然に発生するため、Googleがペナルティを課す可能性は低いと考えられます(EmmaTools)。
意図しない重複でペナルティを受けることは稀です。
ペナルティの対象になるのは、他サイトのコンテンツを大量にコピーして自サイトに掲載する行為や、検索順位を操作する目的で同じ内容のページを意図的に大量生成する行為です。
つまり、悪質なコピーや明らかなスパム行為が対象であり、通常のサイト運営で発生する重複は、ペナルティの心配をする必要はほとんどありません。
ペナルティを受けているかは、Search Consoleの「セキュリティと手動による対策」→「手動による対策」で確認でき、「問題が検出されませんでした」と表示されれば問題ありません。
過度な心配は不要です。
Google自身も「『重複コンテンツによるペナルティ』というものは存在しない」と公式ブログで明言しています(Google Search Central Blog)。

「重複ペナルティ」はGoogle公式が否定。ここは安心していい所です
本当の問題は3つの機会損失
では、重複コンテンツの本当の怖さは何でしょうか。それは、ペナルティそのものよりも、3つのデメリット(機会損失)にあります(コンマケTIMES)。1つ目は、被リンク評価の分散です。
同じ内容が複数URLに存在すると、本来1つのページに集まるべき被リンクや評価が分散し、検索順位が伸び悩みます。2つ目は、クロールバジェットの無駄遣いです。
Googleのクローラーが重複ページのクロールにリソースを使うと、新しいページや重要なページの発見が遅れます(inSite)。
これは、数百〜数万ページの大規模サイトでは無視できない影響です。3つ目は、意図しないページの表示です。
検索エンジンがどのページを評価すべきか判断できず、意図しないURLが検索結果に表示されることがあります。評価分散・クロールの無駄・意図しない表示の3つが本当の問題です。
これらは、手動ペナルティのような派手な影響でなく、じわじわと現れる機会損失です。ペナルティがないからといって、問題がないわけではありません。
DAMEMOTO代表鈴木罰則がないと聞いて気が緩む所。本命は「評価の分散」のほうです
Search Consoleで状況を確認する
重複コンテンツの状況は、Google Search Consoleで確認できます。
「インデックス作成」から「ページ」レポートを開き、重複コンテンツがある場合は「重複しています。Googleにより、ユーザーがマークしたページとは異なるページが正規ページとして選択されました」といった表示が出ます(WEB集客ラボ byGMO)。
これは、自分が指定したcanonicalと、Googleが選んだ正規URLが一致していない状態を示します。Search Consoleの「ページ」レポートで重複を発見できるのです。
あわせて、検索コマンド(site:ドメイン キーワード、intitle:でタイトル指定)を使うと、サイト内の類似ページを抽出できます。
より高精度なチェックには、CopyContentDetectorやchiyo-coといった専門ツールが有効で、語尾を変えただけのリライト記事や、外部サイトとの類似も判定できます。
とくに、外注ライターやAIライティングを使う場合は、こうしたツールでの品質管理が重要です。
Search Consoleと検索コマンドという無料の方法から始め、必要に応じて専門ツールを活用するのが現実的なアプローチです。定期的なチェックが、早期発見につながります。
怖いのはペナルティでなく、評価分散・クロール無駄・誤表示
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
重複が発生する原因
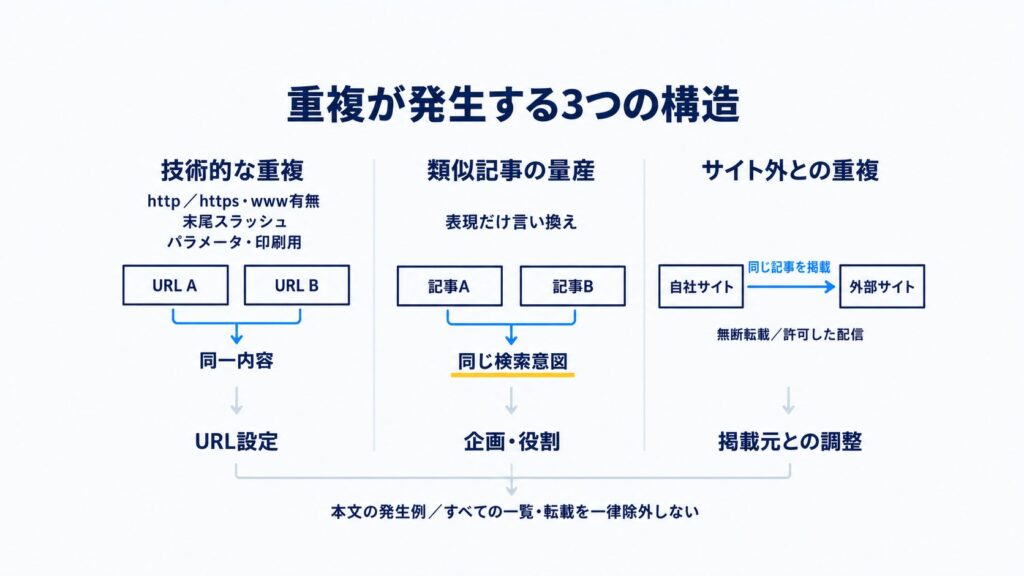
重複コンテンツは、さまざまな原因で発生します。URL構造の問題、類似記事の量産、サイト外との重複という、代表的な原因を整理します。原因を知ることが、適切な対策の選択につながります。
URL構造による技術的な重複
最も多いのが、URL構造による技術的な重複です。技術的な設定漏れで、同じページが複数のURLでアクセスできる状態になるケースです(inSite)。
よくあるパターンは、httpとhttpsの違い、wwwあり/なしの違い、URL末尾のスラッシュの有無、URLパラメータ(セッションIDなど)の付与、印刷用ページ(?print=trueなど)です(コンマケTIMES)。
http/https・www有無・末尾スラッシュ・パラメータが典型的な重複源です。
これらは、同じコンテンツがユーザーには同じページに見えても、検索エンジンには別々のURLとして認識され、重複と判断されます。
たとえば、wwwありとwwwなしの両方でアクセスできる場合、コンテンツの内容は同じなので重複になります。これらの技術的な重複は、CMSやサーバーの設定で意図せず発生しがちです。
サイトを公開したら、まずこうした技術的な重複がないかを確認し、正規化することが重要です。技術的な重複は、設定で確実に解消できるため、優先的に対処すべき原因です。不動産サイトの条件検索のように、絞り込みの組み合わせでURLが増え続ける例は、不動産SEOの条件検索URLの整理で具体的に見ています。
URLの揺れを最初から防ぐ設計はURL設計のベストプラクティスを読むと判断しやすくなるはずです。
www有無・スラッシュ有無。地味ですが、ここが一番の発生源です
類似記事の量産による重複
コンテンツ面での重複も、よく起きます。似たテーマの記事を量産することで、サイト内で内容が重複するケースです。
たとえば、表現だけ言い換えて別記事として量産すると、検索意図が同じなら差別化になりません(EmmaTools)。
見出しや語尾だけ変えて記事数を増やしても、むしろサイト内競合(キーワードカニバリゼーション)を増やしやすくなります。表現を変えただけの記事量産は、サイト内競合を増やすのです。
昨今は、情報量不足よりも独自性不足で伸び悩むケースが目立ちます。似た記事を増やすより、1本を深くするほうが成果につながる場面は多いです。
また、WordPressのタグページやアーカイブページなど、同じコンテンツを参照する一覧ページが乱立することでも、重複が生じます。
複数のライターが似た記事を書いてしまうケースもあります。コンテンツの重複は、技術的な重複と違って、コンテンツの企画・統合という根本的な対応が必要です。
記事を増やす前に、「この記事は誰のどの疑問に答えるのか」を明確にし、既存記事と役割が重ならないかを確認することが大切です。
サイト外との重複
3つ目は、サイト外との重複です。自分のサイトのコンテンツが、外部のサイトにも存在してしまうケースです(コンマケTIMES)。
具体的には、他サイトに自分の記事が無断で転載されている、プレスリリースなど同じ内容を複数のメディアに配信している、外部のブログサービスなどに自社サイトの記事をそのまま転載している、といったパターンです。
自分のコンテンツが他サイトに無断転載されている場合は、削除を要請するか、転載許可を出す場合はcanonicalで自サイトを正規URLに指定してもらうよう依頼します(SEM Plus)。
逆に、自分が他サイトのコンテンツをコピーするのは、コピーコンテンツとしてペナルティ対象になるため、絶対に避けます。
プレスリリースの複数配信や、自社記事の外部転載は、悪意がなくても重複を生むため、転載時にはcanonicalの指定を依頼するなどの配慮が必要です。
サイト外との重複は、自社だけでコントロールできない部分もありますが、無断転載への対応や、転載時の正規化依頼で、影響を抑えられます。外部との関係も、重複対策の一部です。
キーワードカニバリゼーションの解消は記事の統合と関わります。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
原因別の対策と判断
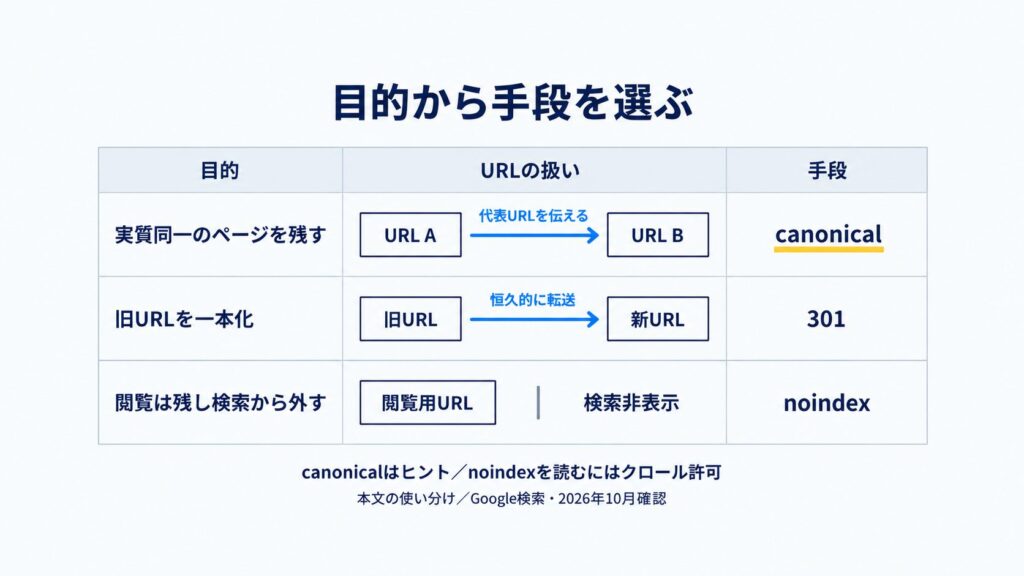
重複コンテンツの対策は、原因によって異なります。canonical・301・noindexの使い分けと、技術設定だけに頼らない本質的な対策を解説します。間違った対策は状況を悪化させるため、原因に応じて慎重に選びます。
canonical・301・noindexを使い分ける
技術的な対策の中心は、canonical・301リダイレクト・noindexの3つです。これらを原因に応じて使い分けます(inSite)。
canonicalタグは、複数のURLを1つに統合し、評価してほしいURLを示すために使います。重複ページは残しつつ、評価を1つに集約したい場合に有効です。
301リダイレクトは、ユーザーに各ページを見せる必要がない場合に、ページを統合します。
たとえば、wwwあり/なしの正規化のように、片方のURLに転送して統一します(SEM Plus)。noindexタグは、命令として確実にインデックスから外したい場合に使います。
タグページやアーカイブページなど、検索流入が不要な重複ページに設定します。残すならcanonical、統合するなら301、外すならnoindexという使い分けです。
canonicalはヒント、noindexは命令としてGoogleが受け取る違いも理解しておきます。原因と目的に応じて、最適な手段を選ぶことが重要です。間違った対策は、かえって状況を悪化させます。
canonicalの機械的な適用を避ける
対策で注意したいのが、canonicalの機械的な適用です。
canonicalは便利ですが、内容差のあるページまで一律で代表URLに寄せると、かえって意図しない評価制御になります(EmmaTools)。
とくに、一覧ページ・詳細ページ・地域ページなど役割が異なるものをまとめてしまうと、検索意図に合わなくなります。
「似ているから全部canonical」でなく、同じ役割か確認することが大切です。canonicalを設定する前に、同じ検索意図・同じ役割かどうかを確認します。
役割が異なるページを無理にまとめると、本来評価されるべきページが検索結果から外れる可能性があります。また、表現だけ言い換えて別記事を量産するのも避けます。
見出しや語尾だけ変えても、検索意図が同じなら差別化にならず、サイト内競合を増やすだけです。技術的な対策は便利ですが、機械的に適用すると逆効果になることがあります。
一つひとつのページの役割を見極めた上で、適切な対策を選ぶことが重要です。安易な一律処理は、避けるべきです。
DAMEMOTO代表鈴木「似てるから全部canonical」、これで失敗する人が本当に多いです
本質は「同じ検索意図のページを統合」
最も本質的な対策は、技術設定でなく、コンテンツの統合です。重複対策の基本方針は、「同じ検索意図のページを統合する」ことです(EmmaTools)。
canonicalタグで形式上だけ正規化しても、意図がほぼ同じページが複数残っていると、検索エンジンが代表ページを安定して選びにくく、内部リンクや被リンクの評価も分散しやすくなります。
技術設定だけでなく、同じ意図のページは統合するのが本質です。進め方としては、まず「そのページは誰のどの疑問に答えるのか」を明確にします。
そして、別ページとして残す理由がないものは統合し、残すものは役割を明確に分けます。
検索意図が異なる場合は、見出し構成、対象読者、比較軸、具体例を変え、「なぜ別ページとして存在するのか」が分かる状態にします。
たとえば、初心者向けの基礎解説とEC担当者向けの実務対策は、同じテーマでも答えるべき問いが異なります。
重複対策は、301・canonical・noindexといった技術設定だけで解決するものではありません。コンテンツの役割を整理し、統合すべきは統合する。
この順番で進めるのが、現実的で効果的なアプローチです。なお、対策の効果は2〜3週間から2〜3ヶ月で現れるため、対策後はSearch Consoleで状況を見守ります。
同じ意図の記事が競合しない設計はピラーページとクラスターのカニバリ対策で整理しています。
効果は数週間〜数ヶ月の遅延型。すぐ動かないのが普通です
URL構造による技術的な重複を防ぐには、最初のURL設計が重要です。
よくある質問
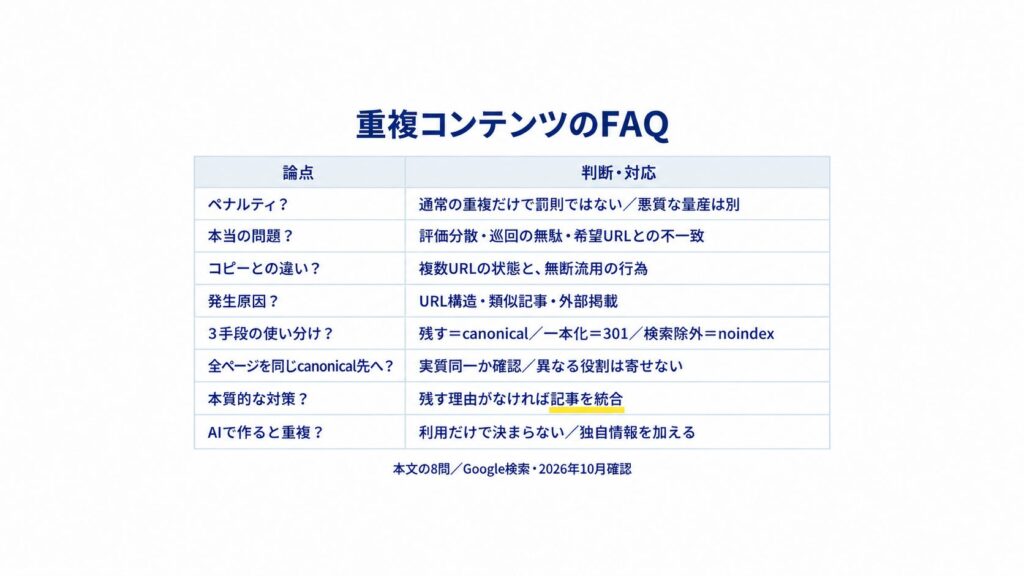
- 重複コンテンツはペナルティになりますか?
-
重複コンテンツ自体はペナルティになりません。Googleは悪意のない重複にペナルティを科さないと明言しています。意図せず発生する重複は多くのサイトで自然に起きます。ただし、他サイトの大量コピーや、順位操作目的の同一ページ大量生成は、スパムポリシー違反でペナルティ対象です。通常の運営での重複は心配不要です。
- 重複コンテンツの本当の問題は何ですか?
-
3つの機会損失です。①被リンク評価の分散(順位が伸び悩む)②クロールバジェットの無駄遣い(重要ページの発見が遅れる)③意図しないページの表示です。ペナルティのような派手な影響でなく、じわじわ現れる損失です。ペナルティがないからといって問題がないわけではなく、評価の分散は確実に起きます。
- 重複コンテンツとコピーコンテンツの違いは?
-
重複コンテンツは、同じ内容が複数URLに存在する状態で、意図せず発生することが多く、評価の分散が主な影響です。コピーコンテンツは、他サイトから無断でコピーした故意の盗用で、スパムポリシー違反としてペナルティ対象になります。重複は技術設定や統合で対処し、コピーは削除・書き直し・申告で対応します。
- 重複コンテンツはどう発生しますか?
-
主に3つです。①URL構造の問題(http/https、www有無、末尾スラッシュ、パラメータ、印刷用ページ)②類似記事の量産(表現だけ変えた記事、タグ・アーカイブの乱立)③サイト外との重複(無断転載、プレスリリースの複数配信、外部転載)です。とくにURL構造の技術的な重複は、CMS設定で意図せず起きがちです。
- 重複コンテンツにはcanonical・301・noindexをどう使い分けますか?
-
重複ページを残しつつ評価を集約したいならcanonical、ユーザーに見せる必要がなく統合するなら301リダイレクト、検索流入不要で確実に外すならnoindexです。canonicalはヒント、noindexは命令としてGoogleが受け取ります。原因と目的に応じて使い分け、間違った対策で状況を悪化させないよう注意します。
- 重複対策でcanonicalを全ページに入れてもいいですか?
-
機械的に一律で入れるのは避けます。内容差のあるページまで代表URLに寄せると、意図しない評価制御になります。一覧・詳細・地域ページなど役割が異なるものをまとめると、検索意図に合わなくなります。「似ているから全部canonical」でなく、同じ検索意図・同じ役割かを先に確認してから設定しましょう。
- 最も本質的な重複対策は何ですか?
-
「同じ検索意図のページを統合する」ことです。canonicalで形式上正規化しても、意図が同じページが複数残ると代表ページが安定せず、評価も分散します。「そのページは誰のどの疑問に答えるか」を明確にし、残す理由がないものは統合、残すものは役割を分けます。技術設定だけでなく、コンテンツの整理が本質です。
- AIで作ると重複コンテンツになりますか?
-
そのまま公開すると、なる可能性があります。AIはWeb上の情報をもとに生成するため、他社コンテンツと類似した表現・構成になりがちです。とくに一般的なトピックは似通いやすいです。AIは下書きや効率化のツールとして使い、独自の情報・視点・経験を加えて差別化することが重要です。Googleは独自性のある情報を評価します。
【独自】重複コンテンツ解消の手段選定マトリクス
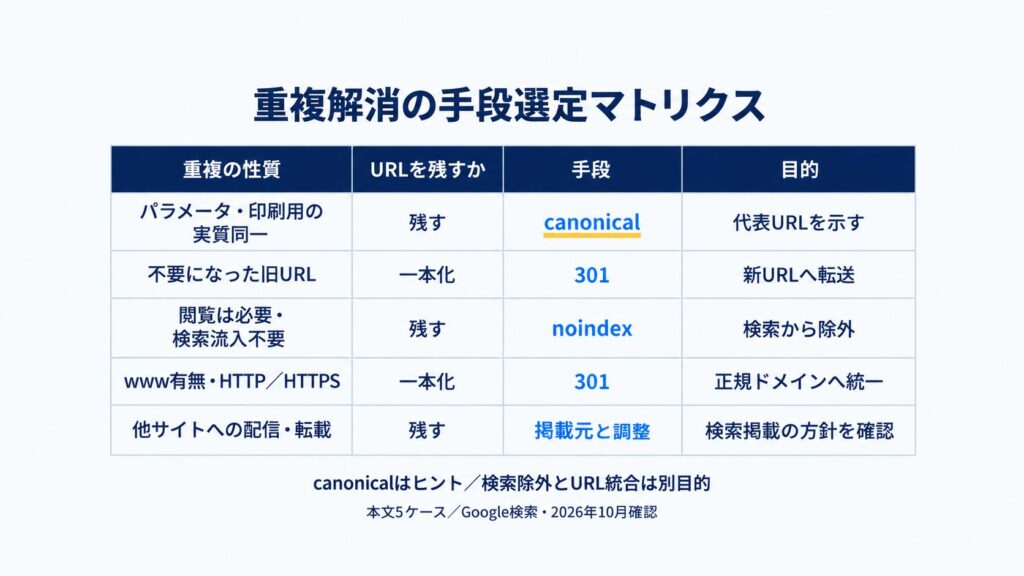
重複コンテンツの解消にはcanonical・301リダイレクト・noindexという複数の手段があり、状況に合わない手段を選ぶと評価集約に失敗します。
前提として、重複コンテンツが存在すること自体はペナルティではなく、Googleは類似ページから代表URLを選ぶだけです。問題は「意図した代表URLに評価を集約できるか」。手段の使い分けを、重複の性質ごとに整理しました。
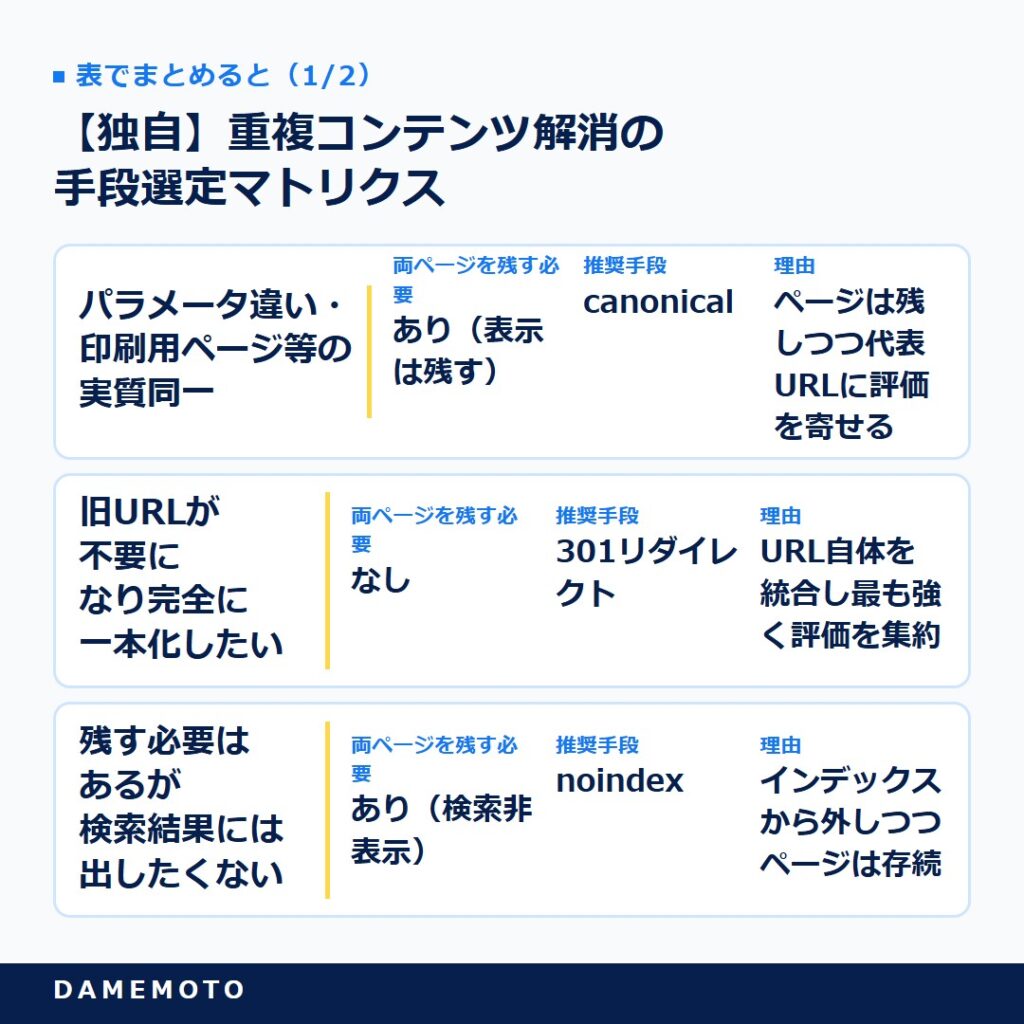
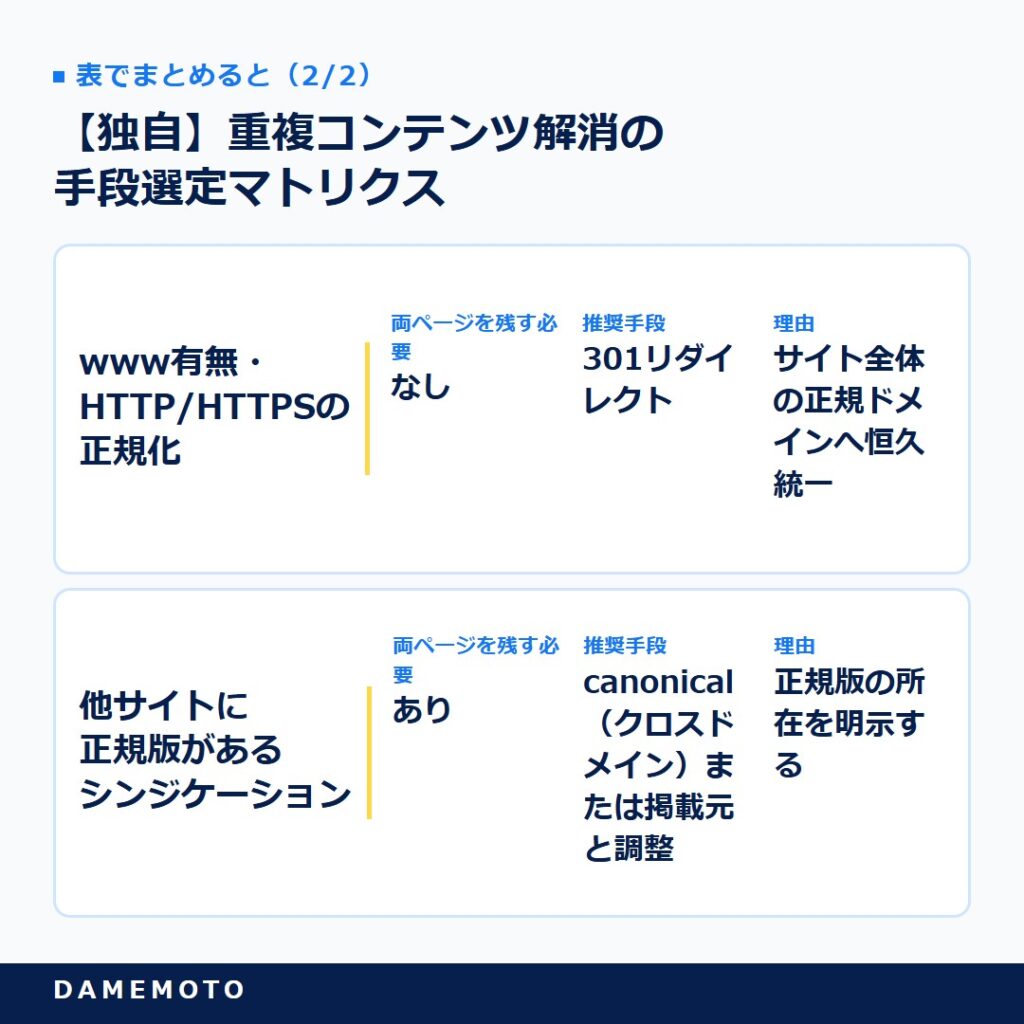
表で詳しく見る
| 重複の性質 | 両ページを残す必要 | 推奨手段 | 理由 |
|---|---|---|---|
| パラメータ違い・印刷用ページ等の実質同一 | あり(表示は残す) | canonical | ページは残しつつ代表URLに評価を寄せる |
| 旧URLが不要になり完全に一本化したい | なし | 301リダイレクト | URL自体を統合し最も強く評価を集約 |
| 残す必要はあるが検索結果には出したくない | あり(検索非表示) | noindex | インデックスから外しつつページは存続 |
| www有無・HTTP/HTTPSの正規化 | なし | 301リダイレクト | サイト全体の正規ドメインへ恒久統一 |
| 他サイトに正規版があるシンジケーション | あり | canonical(クロスドメイン)または掲載元と調整 | 正規版の所在を明示する |
選定の軸は「両方のURLを残す必要があるか」です。残すならcanonicalかnoindex、一本化してよいなら301。
なお、他者のコンテンツを丸ごとコピーして量産する行為は重複問題とは別次元で、スパムポリシー違反として扱われます。
手段の使い分け以前に、独自の価値を持つコンテンツであることが前提です。canonicalを使う場合の向け先はcanonicalタグのケース別の書き方で手順をまとめています。
【独自】重複コンテンツでやりがちな失敗パターン集
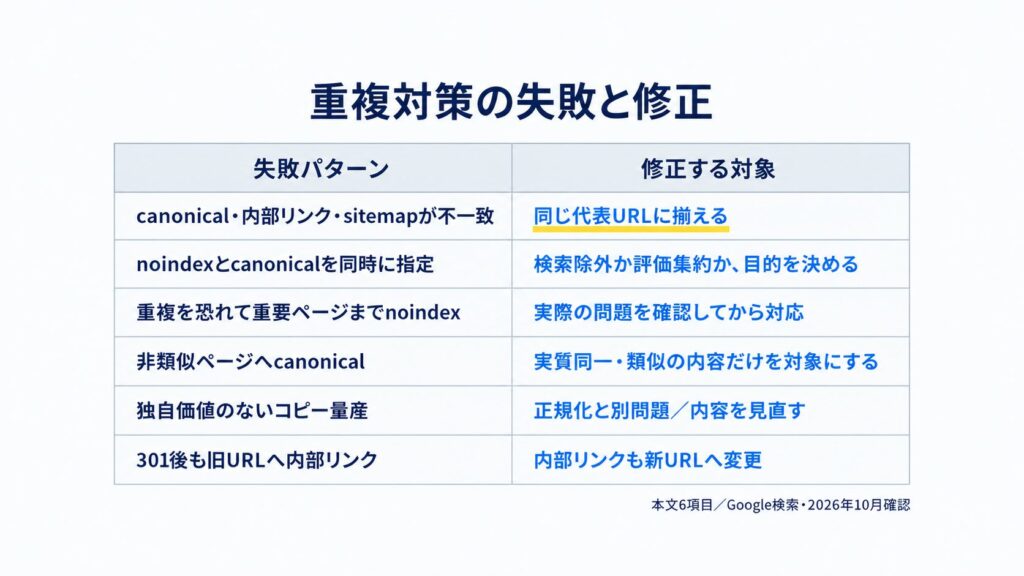
重複対策は「とりあえずcanonicalを貼る」「noindexで隠す」といった場当たり対応になりやすく、かえって評価を分散させたりインデックスから消したりしてしまいます。
ここでは典型的な誤りを集めました。重複が疑われるページに手を入れる前に確認してください。
- canonicalと矛盾するシグナルの併用:canonical先と異なるURLをsitemapや内部リンクで強く推し、Googleが正規URLを判断しづらくなる。シグナルを一貫させる。
- noindexとcanonicalの同時指定:同一URLに相反する指示を出し意図が伝わらない。検索非表示ならnoindex、評価集約ならcanonicalと目的で使い分ける。
- 重複=ペナルティと誤解した過剰対応:回避を急いで重要ページまでnoindexし流入を失う。重複自体は罰則ではない前提で冷静に判断する。
- canonicalで非類似ページを指定:内容が実質異なるページに別ページのcanonicalを向け、ヒントが無視される。canonicalは実質同一・類似ページ間で使う。
- 他サイトのコピーで量産:独自価値のないコピーを大量生成し、スパムポリシー違反のリスクを負う。重複の正規化とは別問題と認識する。
- 301で消したURLを内部リンクに残す:統合後も旧URLへのリンクが残りチェーンや無駄なクロールが発生。内部リンクも新URLへ張り替える。
共通する教訓は「Googleに渡すシグナルを矛盾させない」ことです。
canonical・内部リンク・sitemap・リダイレクトが全て同じ代表URLを指していれば、重複は静かに整理されます。まず自サイトのシグナルが一貫しているかを点検してください。
正直なところ:重複対策に「急いで手を出さなくてよい」ケース
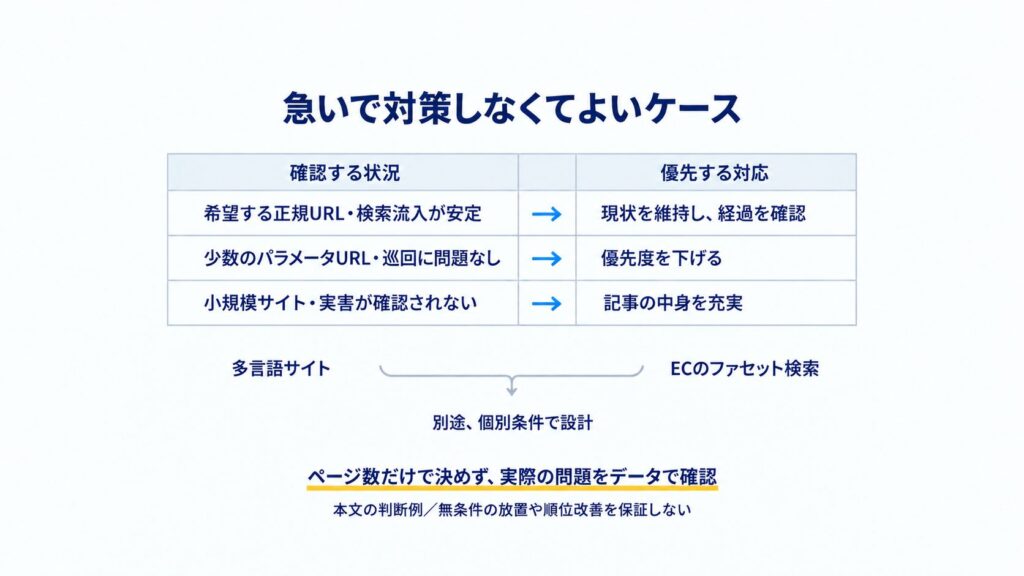
重複コンテンツと聞くと、すぐに対策したくなるかもしれません。しかし、本記事の立場としては、すべての重複に今すぐ介入する必要はないと考えています。
むしろ過剰反応が流入を減らすことすらあります。慌てて手を入れる前に、次のケースに当てはまっていないかを確認してください。
- Googleが自動で正規URLを選べている:Search Consoleで意図通りの代表URLが選ばれ、検索流入も安定しているなら、無理にcanonicalや301を足す必要はありません。Googleは類似ページから代表を選ぶだけで、放置がただちに害になるわけではありません。
- ごく少数のパラメータURL:印刷用やセッションIDのURLが数件ある程度なら、クロールバジェットへの影響は軽微。大規模サイトでなければ優先度は低めです。
- そもそもページ数が少ない小規模サイト:数十ページ規模では、評価分散もクロールの無駄も体感しにくいもの。技術設定より、1本ごとの中身を厚くするほうが成果に直結します。
逆に、本記事で扱いきれていないのは、海外向けの多言語サイトにおける重複(hreflangとの兼ね合い)や、ECのファセット検索が生む大量URLといった、個別性の高いケースの細部です。
これらは状況によって最適解が分かれるため、一般論として断定はできません。
「重複=即対策」ではなく、評価の分散やクロールの無駄が実際に起きているかをデータで確かめてから動く——これが、過剰対応を避けつつ成果につなげる現実的な姿勢です。
重複以外も含めた技術面の点検はテクニカルSEO完全ガイドが手がかりになります。
まとめ:重複対策は「統合」が本質
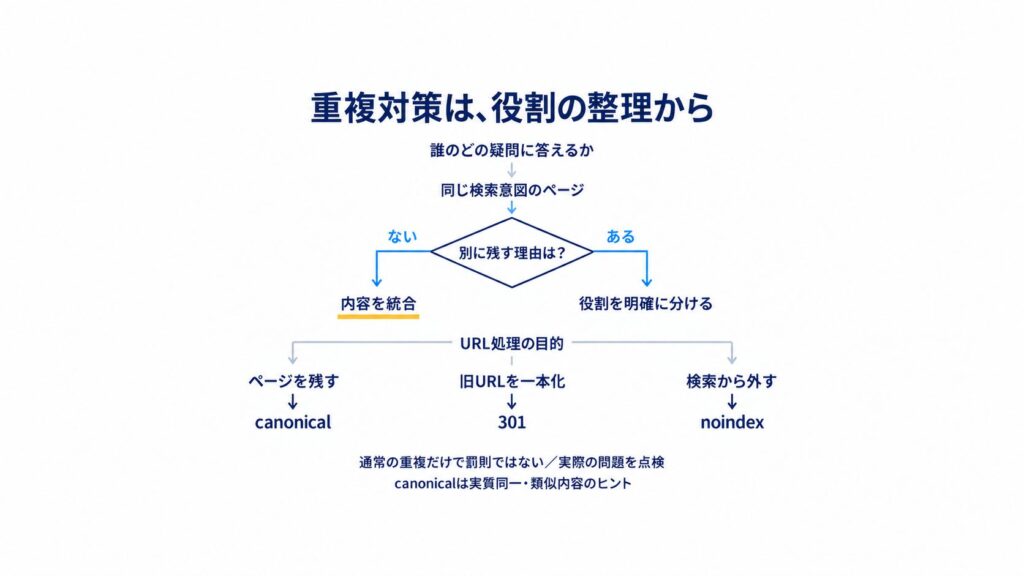
重複コンテンツ自体はペナルティになりませんが、評価の分散・クロールの無駄・意図しない表示という機会損失を生みます。
原因別にcanonical・301・noindexを使い分けつつ、本質は「同じ検索意図のページを統合する」ことです。最後に要点を3行で整理します。
- 重複自体は非ペナルティ、問題は評価分散
- canonical・301・noindexを原因別に使い分け
- 本質は同じ検索意図のページの統合
重複コンテンツへの向き合い方は、ペナルティを恐れることではなく、評価の分散を防ぐことにあります。
多くの人が「重複=ペナルティ」と心配しますが、悪意のない重複でペナルティを受けることは稀です。
本当に怖いのは、被リンク評価の分散、クロールの無駄、意図しないページの表示という、じわじわ効いてくる機会損失です。
対策は、原因に応じてcanonical・301・noindexを使い分けますが、技術設定だけでは解決しません。
最も本質的なのは、「そのページは誰のどの疑問に答えるのか」を明確にし、同じ検索意図のページは統合し、残すページは役割を分けることです。
表現だけ変えた記事を量産するより、1本を深くする。技術と編集の両面から、コンテンツを整理する。それが、評価を集約し、検索順位を伸ばす、重複対策の本質だと考えています。
参考URL一覧
- Google Search Central Blog・Demystifying the “duplicate content penalty”:https://developers.google.com/search/blog/2008/09/demystifying-duplicate-content-penalty
- EmmaTools・重複コンテンツとは?SEOへの影響と正しい対策を2026年版で解説:https://emma.tools/magazine/duplicate-content
- コンマケTIMES・重複コンテンツのSEO対策!ペナルティの基準・調べ方・直し方:https://cro-co.co.jp/media/seo/duplicate-content-seo
- inSite・重複コンテンツとは?SEOへの影響と対策方法をわかりやすく解説:https://in-site.jp/blog/duplicate-content-guide
- SEM Plus・重複コンテンツとは?SEOペナルティになるケース・対策方法・調べ方:https://white-link.com/sem-plus/duplicate-content
- WEB集客ラボ byGMO・重複コンテンツはペナルティになる?SEOへの影響や調べ方:https://gmotech.jp/semlabo/seo/blog/duplication-content-penalty
- センタリング・SEOで重複コンテンツが発生する原因と定義を徹底解説:https://assist-centering.co.jp/media/detail/2025-06-06 101800000394
関連する最新ニュース