Hugging Faceは2026年10月22日(米国時間)、DNAの配列を英語のチャットに貼って質問できるオープンモデル「Carbon-X」を公開しました。
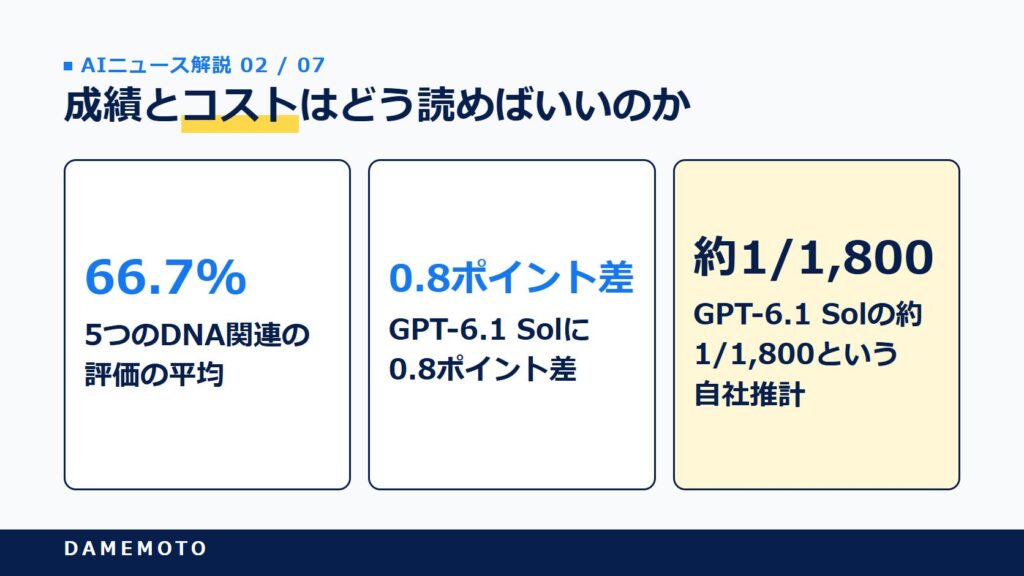
14.8B(148億)パラメータの小さなモデルながら、5つのDNA関連の評価の平均で66.7%と、GPT-6.1 Sol(67.5%)に0.8ポイント差まで迫ったと自社で評価しています。
自社データで「業界特化のAI」を作れないかと考える経営層やWeb担当役員にとっては、小さなオープンモデルを専門分野向けに育てる手順と費用感が、数字つきで公開された実例といえます。
この記事のポイント
- 10月22日に公開。Qwen3-14Bをベースにした14.8Bのオープンモデル
- 5つの評価の平均は66.7%。ただし項目によってはGPT-6.1 Solに負けている
- 1問あたりの推論コストはGPT-6.1 Solの約1/1,800という自社推計
- 臨床検証はなく、医療判断には使えない。新しい配列の設計用でもない
- 「追加学習→教師データ→強化学習」の作り方が、業界特化AIの参考になる
本記事は、Hugging Faceのモデルカードと公式ブログ、GGUF版のカードを一次情報とし、Business Insider、Wired、CNET、The Next Web、ForkLog、CNET Japan(日本語版、10月24日)の報道と照らし合わせています。
成績とコストの数字は、すべてHugging Face自身の評価と推計です。第三者による再現は確認できていません。情報は2026年10月26日時点のものです。
Hugging FaceのCarbon-Xとは何か
「DNAとチャットできるAI」という見出しを見て、何のことかと首をかしげた方もいるかもしれませんね。まずは、何がいつ公開されたのかを整理していきます。
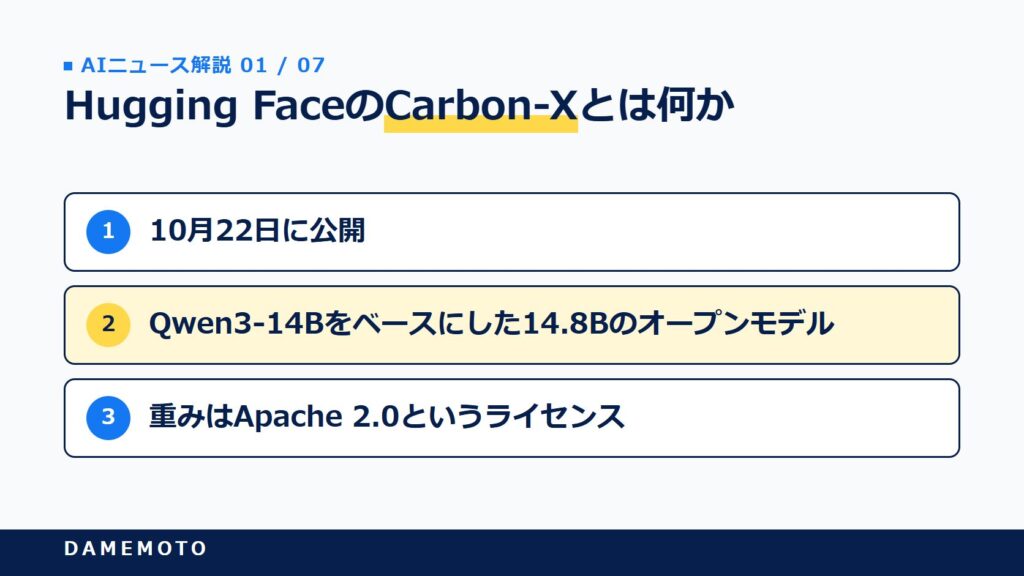
10月22日に公開された14.8Bのモデル
Carbon-Xは、Hugging Faceの生命科学チーム(HuggingFaceBio)が公開した言語モデルです。2026年10月22日に公開されました。
中身は、AlibabaのオープンモデルQwen3-14Bをベースに、3,020億トークンを追加で学習させた14.8Bのモデル。
追加学習のデータは、55%が生のDNA、20%が英語の文章、15%が生物学の文章、10%が指示に答える形のデータです。
重みはApache 2.0というライセンスで、Hugging Face Hubから誰でもダウンロードできます。
DNAを英語のチャットに貼って質問できる
使い方は、ふだんのチャットAIとほとんど変わりません。質問文の中にA・C・G・Tの並びを貼ると、モデルがそれをDNAとして読み、英語で解釈や予測を返します。
モデルカードの例では、元の配列と1文字だけ違う配列を並べ、「この変異は良性か病原性か。理由も説明して」と尋ねています。
仕組みの面では、DNAを6文字ずつ1つのトークン(AIが読む単位)として扱う語彙を足したのが特徴です。
モデルカードは、DNA専用の読み取り部品を別に持たず、文章とDNAを1つのモデルで処理すると書いています。
ベースのQwen3の読み方より、約3分の1のトークン数でDNAを表せるとのこと。
ただし、学習で扱った長さは約4.9万塩基対までで、それより大幅に長い入力は評価されていないとモデルカードは書いています。ヒトのゲノムを丸ごと読ませることはできません。
3者の共同研究
見出しでは「Hugging Faceが公開」とされることが多いものの、モデルカードによると共同研究の成果です。参加したのは次の3者です。
- Hugging Face(米国)
- Zhongguancun Academy(中国)
- Telethon Institute of Genetics and Medicine(TIGEM)/ナポリ大学(イタリア)
今年5月には、前身の「Carbon」(3B・8B)が公開されています。こちらはDNAだけを扱うモデルで、質問に答える対話はできませんでした。
10月8日にも遺伝子の領域を探す「Carbon-A」が出ており、約5か月で複数のモデルを続けて公開している流れの最新版がCarbon-Xだといえます。
なお、NVIDIAは9月3日にHugging Faceを約129億ドルで買収することで合意したと発表しており、その数週間後の公開です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
成績とコストはどう読めばいいのか
「GPT-6.1 Sol並み」という言い方が広まっていますが、数字の中身を見ると印象は少し変わります。表と一緒に確かめていきましょう。
平均ではGPT-6.1 Solに0.8ポイント差
Hugging Faceは、DNAに関する5つの評価で各モデルを比べました。
Carbon-Xの平均は66.7%で、GPT-6.1 Sol(推論強度Max)の67.5%に0.8ポイント差、Opus 5.5(Max)の60.9%を上回ります。
ベースのQwen3-14Bからは約27ポイント伸びた計算です。
ただし、5つのうち2つ(FrontierVEPとNextBase)はHugging Faceが自分で作った評価で、第三者による再現は確認できていない点に注意が要ります。
The Next Webも、自社では数字を検証していないと明記していました。
項目別に見ると負けている評価もある
表で詳しく見る
| 評価 | 何を測るか | Carbon-X | GPT-6.1 Sol | Opus 5.5 |
|---|---|---|---|---|
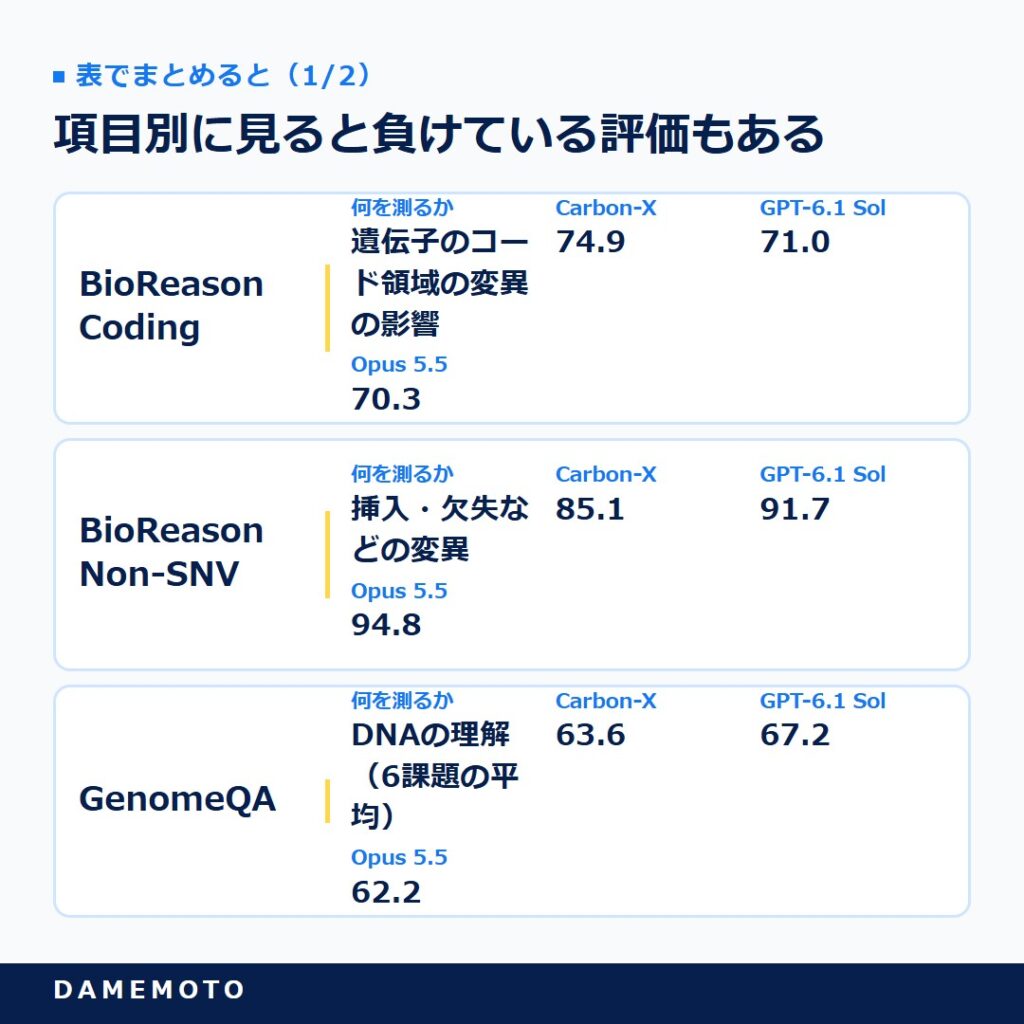
| BioReason Coding | 遺伝子のコード領域の変異の影響 | 74.9 | 71.0 | 70.3 |
| BioReason Non-SNV | 挿入・欠失などの変異 | 85.1 | 91.7 | 94.8 |
| GenomeQA | DNAの理解(6課題の平均) | 63.6 | 67.2 | 62.2 |
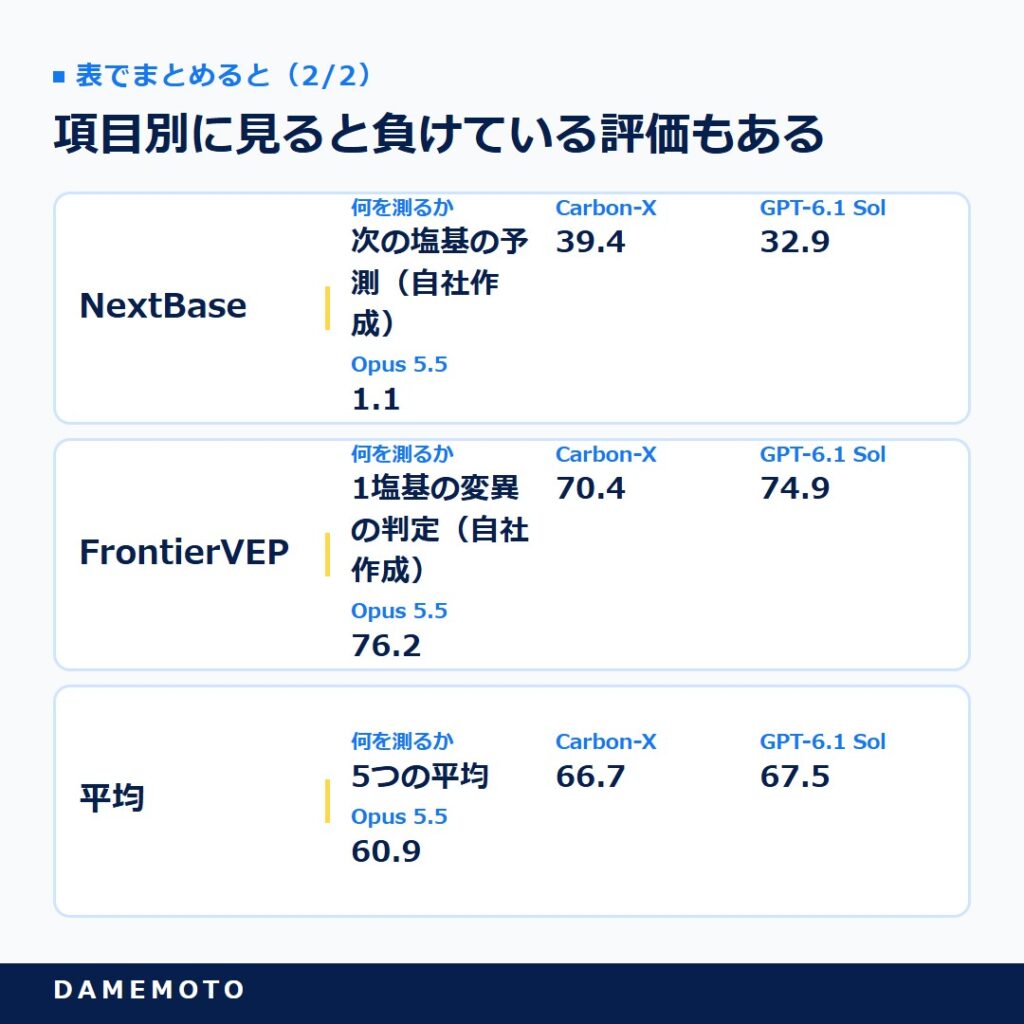
| NextBase | 次の塩基の予測(自社作成) | 39.4 | 32.9 | 1.1 |
| FrontierVEP | 1塩基の変異の判定(自社作成) | 70.4 | 74.9 | 76.2 |
| 平均 | 5つの平均 | 66.7 | 67.5 | 60.9 |
出典はモデルカードと公式ブログの表で、比較モデルは平均が最も高くなる推論強度で示されています。Carbon-Xが勝っているのは、コード領域の変異と次の塩基の予測の2つです。
挿入・欠失の判定と1塩基の変異の判定ではGPT-6.1 SolとOpus 5.5が、DNAの理解ではGPT-6.1 Solが上回る結果でした。
指標も評価ごとに異なり、66.7%は「診断の正解率」ではない点も押さえておきたいところです。
GenomeQAの内訳では、スプライス部位が29.8%、ヒストンの目印が34.6%と苦手な課題もはっきりしています。
コストはGPT-6.1 Solの約1/1,800という自社推計
注目を集めたのはコストのほうでしょう。モデルカードは、1問あたりの推論コストがGPT-6.1 Solの約1/1,800だと書いています。
H200というGPUを1時間5ドルで借りたときの処理速度から計算し、比較側は標準のAPI料金を当てたものです。
公開データベースClinVarにある、臨床的な意義が分かっていない変異240万件を調べる例では、Carbon-Xが約300ドル、最先端の汎用モデルは3万2,000ドル〜400万ドルと見積もりました。
ただ、公式ブログの冒頭では「1,000分の1」と書かれており、同じ公式資料の中で倍率がずれています。本記事では、モデルカードとブログ本文がそろって使う1/1,800を採りました。
GPUを動かす人の手間や、環境を用意する費用は含まれていないとみられるので、そのまま自社の試算に使うのは避けたほうがよさそうです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
Carbon-Xにできないこと・注意したいこと
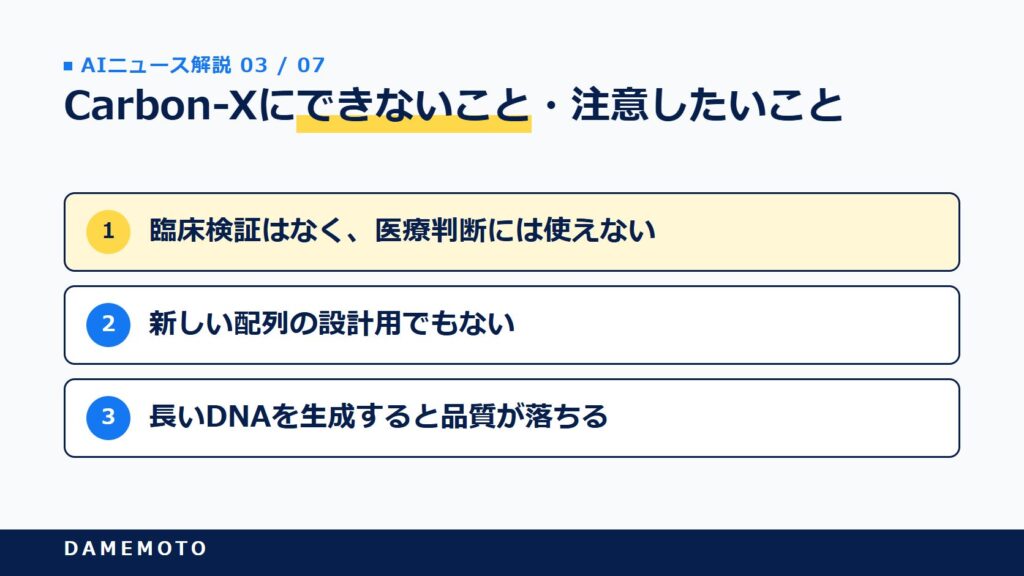
新しいモデルの話は、どうしても「何ができるか」に目が向きますよね。Carbon-Xは、できないことの書き方もかなり具体的です。
臨床での検証はなく、医療判断には使えない
モデルカードは、臨床で検証されておらず、医療上の判断に使ってはならないと明記しています。Wiredによると、開発者は実際の実験(ウェット実験)での検証もまだだと注意していました。
遺伝情報はきわめて機微なデータなので、ローカルで動かすのか、外部のサービス経由で使うのかでデータの扱いが変わる点も、カードは警告しています。
新しい配列を設計するためのモデルではない
Business Insiderや公式ブログの冒頭は「新しいDNAを生成できる」と紹介していました。
モデルカードも冒頭では「理解と生成」のモデルとしつつ、制限の欄では、配列を読んで説明するためのモデルで、新しい配列の設計用には学習していないと書いています。
長いDNAを生成すると品質が落ちることも、弱点として挙がっていました。ほかの弱点は次の3つです。
- 塩基の数え間違いや、位置(座標)の取り違えが起きる
- 文脈が足りないと、配列の正体や機能をでっち上げることがある
- 短いDNAの課題や教科書的な生物学の知識は、最先端の汎用モデルのほうが強い
悪用への対策として、人や動植物など真核生物に感染するウイルスのゲノムは学習データから外したとブログは説明しています。「何でもできるDNAのAI」ではなく、読んで説明する道具として出されたと受け止めるのが正確でしょう。
商用利用はデータ側の条件まで確かめる
重みのライセンスはApache 2.0で、ベースのQwen3-14BもApache 2.0です。
Apache 2.0は一般に商用利用や改変を認める条件ですが、モデルカードに「商用利用できる」と明記した一文はありません。
学習に使ったデータセットや、学習データの一部(合成データ)作りに使ったGeminiの利用条件が派生物に及ぶかどうかも、確認できませんでした。
ライセンスの表記だけで判断せず、データ側の条件も含めて自社で確かめるのが安全です。
動かす環境については、bfloat16の重みが80GBのGPU1枚に載るとモデルカードにあります。
軽くしたGGUF版(Q8_0は15.8GB、Q4_K_Mは9.6GB)も公開されました。
GGUF版のカードはllama.cppのb11742以降で使えるとしていますが、本体のモデルカードには「llama.cppなどのGGUF実行環境には対応していない」と書かれたままで、10月26日時点では記述が食い違っています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
業界特化AIの作り方として読む
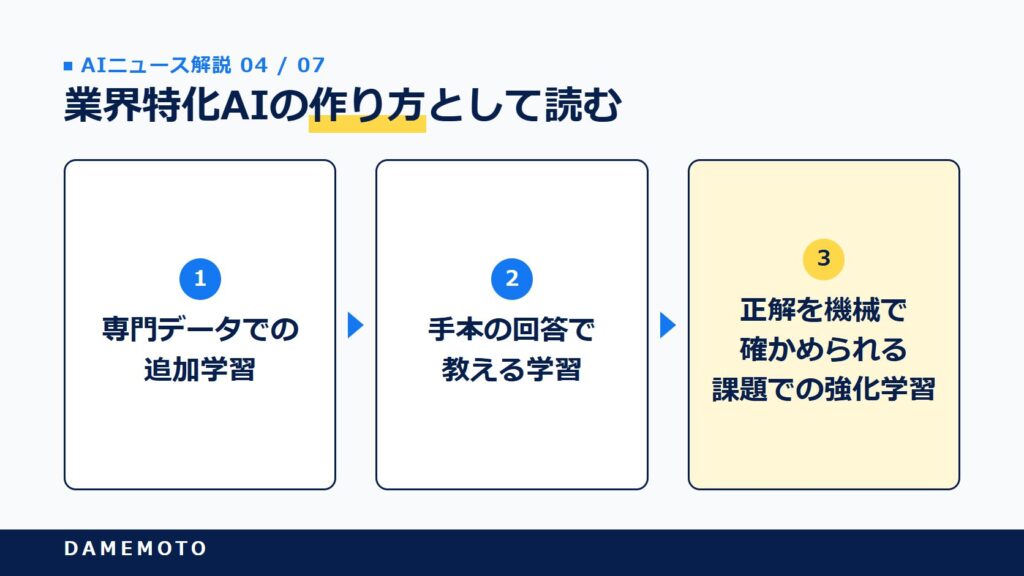
生命科学の話は遠く感じるかもしれません。それでも、公式ブログに書かれた「作り方」は、自社データでAIを育てたい企業にとって参考になる部分が多いと思います。
追加学習→教師データ→強化学習の3段階
Carbon-Xは、語彙を足したあと、専門データでの追加学習(ミッドトレーニング)、手本の回答で教える学習(SFT)、正解を機械で確かめられる課題での強化学習、という順で作られました。ブログが挙げた発見は次のとおりです。
- ベースのQwen3-14Bに強化学習だけをかけると、1塩基の変異の判定(FrontierVEP)が偶然の水準(50%)を超えなかった。追加学習を挟んでから強化学習をかけると伸びた
- モデル自身に作らせた手本より、専門家と作った検証の仕組みで入力と照らし合わせた手本のほうが成績がよかった
- 専門知識を足すと元の言語の力を忘れやすい。学習率を下げ、大きいモデルで、長く学習して両立させた
DNAの変異のように正解を機械で確かめられる分野だから成り立った面がある点は、割り引いて読みたいところです。記事の良し悪しのように正解が一つに決まらない仕事に、そのまま当てはまるとは限りません。
小さな専門モデルに相談させる構成
もう一つ興味深いのが、汎用のAIからCarbon-Xを「専門家」として呼ぶ使い方です。
ブログによると、Kimi K3にCarbon-Xへの相談を必ず行わせると、5つのDNA評価の平均が49.4%から60.5%に上がりました(各評価100問、Hugging Faceの評価)。
Hugging Faceのモデルのページ(リポジトリ)には、Claude CodeやCodex CLIから呼び出すためのスキルの例も入っています。
大きな汎用AIはそのままに、苦手な専門分野だけ小さなモデルに任せる形の実例といえるでしょう。
このニュースで誰の何が変わるのか
DNAを扱う企業でなくても、この発表から持ち帰れることはあります。立場ごとに見ていきます。
自社専用のAIを考えている経営層
「大手のAIは高いし、自社の専門分野には弱い」と感じながら、自前のAIに踏み出せずにいる経営者の方もいるかもしれませんね。
Carbon-Xは、14.8Bの小さなオープンモデルでも、専門データで鍛えれば分野によっては汎用の大型モデルに迫れることを、手順と数字つきで示しました。
明日からは、自社の仕事のうち「正解を機械で確かめられるもの」がどれだけあるかを洗い出してみるのがおすすめです。
今後は、大量の定型処理は自前の小型モデル、少量の難しい判断は大型のAPI、という分け方を検討する企業が増えていくと推測されます。
機微なデータを扱うWeb担当役員・情報システム担当
顧客データを外部のAIに送ってよいのか、社内で毎回議論になっている方もいるかもしれませんね。
Carbon-Xは手元のGPUで動くため、Wiredの取材でも開発者が「データはHugging Faceにも他社にも送られない」と話しています。
オープンモデルをローカルで動かせば、データを社外に出さずにAIを使えるという選択肢が、専門分野でも現実的になってきたといえます。
明日やるなら、社内で外部AIに送れないデータを一覧にし、どの作業ならローカルのモデルで代わりになるかを話し合ってみましょう。
オープンモデルの使い方は、Mistral Large 4の重みの公開予定を紹介した記事でも整理しています。
今後、オープンモデルのベースの出どころを社内規程でどう扱うかも、論点になっていきそうです。
AIの新モデルを記事にするオウンドメディア編集者
新しいAIが出るたびに「〇〇並み」という見出しが並び、どこまで信じてよいか迷いますよね。平均点より項目別の表、評価した人が誰か、を先に確かめる習慣が、記事の信頼を守ります。
明日からは、AIの成績を書くときに「誰の評価か」「第三者の再現はあるか」の2点を必ず添えるようにしてみましょう。
今後も、オープンモデルの発表は自社評価の数字から始まることが多いと考えられます。

「並んだ」と言われる数字ほど、項目別の表まで開いてみると、そのモデルの得意と苦手がよく見えてくると感じます
よくある質問
- Carbon-Xはいつ公開されたのですか?
-
2026年10月22日(米国時間)です。モデルカードの最初の登録も同日で、日本語ではCNET Japanが10月24日に紹介しました。
- Carbon-Xは無料で使えますか?
-
重みはApache 2.0のライセンスで、Hugging Face Hubから無料でダウンロードできます。動かすには80GBのGPU1枚、または軽くしたGGUF版が必要です。10月26日時点で、すぐ使える公式のAPIは確認できませんでした。
- 日本語でもCarbon-Xに質問できますか?
-
モデルカードの対応言語は英語だけです。日本語での評価結果は示されておらず、英語で使う前提と考えたほうがよいでしょう。
- Carbon-XはGPT-6.1 Solより性能が高いのですか?
-
5つの評価の平均ではGPT-6.1 Solの67.5%に対し66.7%で、わずかに下です。コード領域の変異と次の塩基の予測では上回りますが、残り3つでは下回ります。いずれもHugging Face自身の評価です。
- 遺伝子検査の結果の判断にCarbon-Xは使えますか?
-
使えません。モデルカードは、臨床で検証されておらず、医療上の判断に使ってはならないと明記しています。実際の実験での検証もまだです。
- Carbon-Xの商用利用はできますか?
-
重みのライセンスはApache 2.0ですが、モデルカードに商用利用の可否を明記した文はありません。学習データや、その一部(合成データ)作りに使ったGeminiの条件も含め、自社で確認することをおすすめします。
- Carbon-XはArc InstituteのEvo 2と何が違いますか?
-
Evo 2はDNAだけを扱い、100万塩基の長い配列を読めるモデルです。Carbon-XはDNAと英語を1つのモデルで扱い、質問に英語で答えます。Carbon-Xの公式資料にEvo 2との直接の比較はありません。
まとめ
Hugging Faceは2026年10月22日、DNAを英語のチャットで質問できる14.8Bのオープンモデル「Carbon-X」を公開しました。
平均ではGPT-6.1 Solに0.8ポイント差、コストは約1/1,800という自社の評価と推計ですが、項目によっては負けており、臨床での検証もありません。
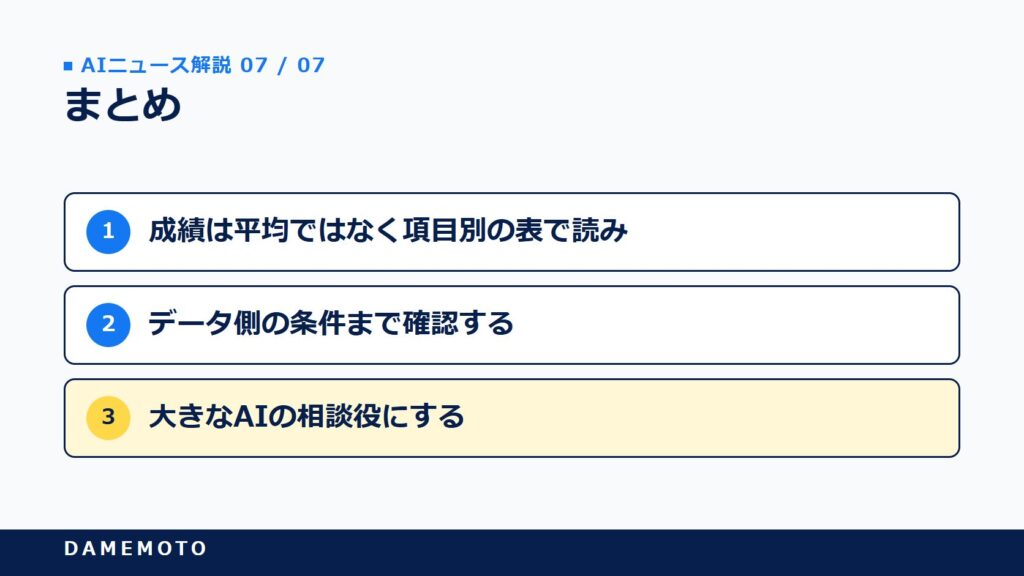
- 成績は平均ではなく項目別の表で読み、誰の評価かを確かめる
- 商用利用はライセンス表記だけでなく、データ側の条件まで確認する
- 自社の仕事から「正解を機械で確かめられるもの」を洗い出す
小さなモデルを専門分野で鍛え、大きなAIの相談役にする。Carbon-Xが示したのは、DNAの話にとどまらない、業界特化AIの一つの設計図だと思います。
参考・出典
- Hugging Face「HuggingFaceBio/Carbon-X」モデルカード:https://huggingface.co/HuggingFaceBio/Carbon-X
- Hugging Face 公式ブログ(Carbon-X Release)(2026年10月22日):https://huggingface.co/spaces/HuggingFaceBio/Carbon-X-Release
- Hugging Face「HuggingFaceBio/Carbon-X-GGUF」:https://huggingface.co/HuggingFaceBio/Carbon-X-GGUF
- GitHub「huggingface/carbon」(Carbonファミリーのコード。モデルカードからリンク):https://github.com/huggingface/carbon
- CNET(2026年10月22日):https://www.cnet.com/science/hugging-face-announces-ai-model-to-chat-with-dna/
- ForkLog(2026年10月22日):https://forklog.com/en/hugging-face-launches-carbon-x-an-open-ai-model-for-natural-language-dna-analysis/
- Business Insider(2026年10月22日):https://www.businessinsider.com/hugging-face-ai-model-carbon-x-dna-sequences-gene-therapies-2026-10
- Wired(2026年10月22日):https://www.wired.com/story/hugging-face-new-ai-biology-model-chat-with-dna
- The Next Web(2026年10月22日):https://thenextweb.com/news/hugging-face-carbon-x-dna-ai-model
- CNET Japan(2026年10月24日):https://japan.cnet.com/article/35253907
- NVIDIA公式ブログ(2026年9月3日):https://blogs.nvidia.com/blog/nvidia-to-acquire-hugging-face/






