NVIDIAの研究チームGEARは2026年10月20日(米国時間、日本時間では21日)、ロボットや人の作業動画に「いつ何をしたか」「うまくいったか」のラベルを自動で付けるAIモデルのセット「Flora」の重みを公開しました。
NVIDIA自身の評価では、GPT-6 Astraと互角の品質を約125分の1のコストで出せるとしています。
ただしライセンスは研究・評価目的に限られ、企業が自社の製品やサービスに組み込む商用利用はできません。「重みの公開」と「商用で使える」は別だと確かめる好例といえます。
この記事のポイント
- 10月20日(米国時間)に、動画にラベルを付ける3つのモデルを公開
- 公開は重みと推論コードまで。学習コードはなく、商用利用は不可
- 「125分の1」はGPUの価格を仮定したNVIDIAの試算
- ロボット動画の説明文では、GPT-6 Astraのほうが成績が上
- 「1日20万時間」は最大の処理量で、ロボットの経験時間ではない
本記事は、NVIDIA GEARの研究ページと論文(37ページ)、Hugging Faceのモデルカード、GitHubのリポジトリとライセンス、研究チーム共同リードのJim Fan氏のX投稿を一次情報とし、The Decoder(10月25日)とHumanoids Daily(10月21日)の報道と照らし合わせています。
NVIDIAの公式ブログやプレスリリースでの告知は確認できませんでした。数字はすべてNVIDIA自身の評価と試算です。情報は2026年10月26日時点のものです。
NVIDIAのFloraとは何か
ロボットにAIで作業を覚えさせる話はよく聞きますが、その裏に地道な「動画の下ごしらえ」があることは、あまり知られていないかもしれませんね。Floraは、その下ごしらえを担うモデルです。
10月20日に公開された3つのモデル
論文の表紙の日付は2026年10月20日で、Jim Fan氏のX投稿は日本時間の10月21日未明でした。GitHubのリポジトリも日本時間の21日朝に作られています。
まとめサイトなどで「10月24〜25日ごろ」とされているのは、報道や二次記事の日付とみられます。
公開されたのは、役割の違う3つのモデルで、いずれもAlibabaのQwen3.5を土台にしています。なお、Hugging Faceのモデルカードのリリース日の欄は10月15日です。
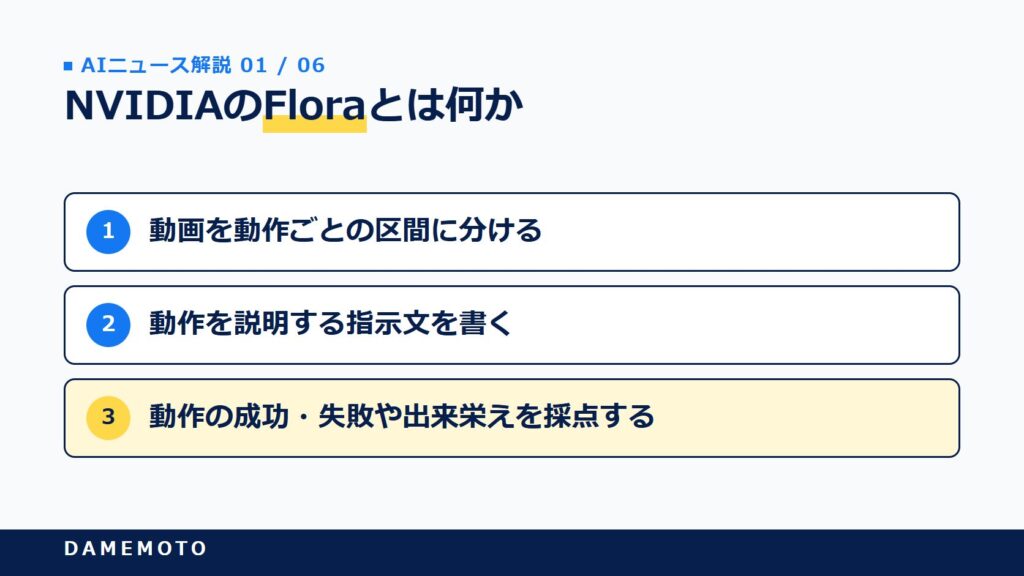
- Flora-TempSeg(9B):動画を動作ごとの区間に分ける
- Flora-Captioner(27B):区間ごとに、動作を説明する指示文を書く
- Flora-Rewarder(27B):動作の成功・失敗や出来栄えを採点する
動画を「時刻つきの指示文」と「採点」に変える
Floraが出すのは、(開始時刻、終了時刻、指示文)の組です。論文の例では「テーブルの左側にある黄色い紙コップを左手で持ち上げる」といった英語の文が、動画の区間ごとに付きます。
採点は3種類あり、0.5秒ごとの「正常・不十分(立て直せる不具合)・失敗」の判定、試行全体の成功度(1〜5)、利用者が決めた採点表に沿った採点です。
対象は人の手、ロボットのつかむ部品(グリッパー)、指の多い器用なハンドの映像。
モデルカードは、出力はあくまでラベルで、ロボットを直接動かしたり、物理的なシステムの唯一の安全監視にしたりする用途ではないと明記しています。
GR00Tの学習に使っているデータエンジン
論文によると、FloraはNVIDIAの人型ロボット向け基盤モデル「GR00T」の学習にすでに使われてきました。
モデルカードには「GR00T-2の学習に使うデータエンジン」とありますが、GR00T-2そのものの公式発表は確認できていません。
NVIDIAは2024年3月にProject GR00Tを、2025年3月にオープンな基盤モデルGR00T N1を発表しており、Floraはロボットの頭脳そのものではなく、頭脳を鍛えるデータを作る側の道具という位置づけです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
「オープン」の中身と商用利用の条件
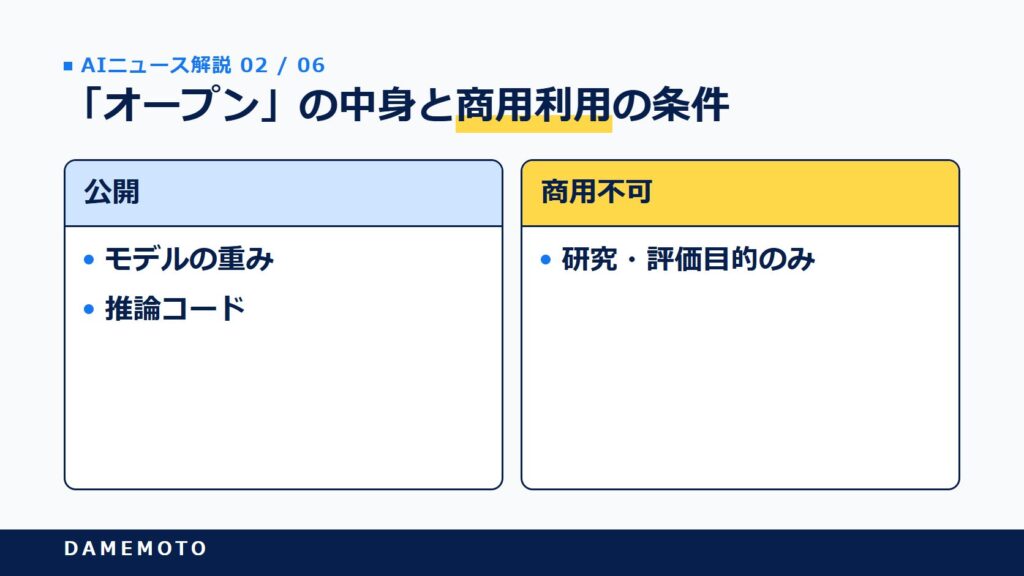
「オープンソース化」という見出しを見ると、誰でも自由に使えるように感じますよね。NVIDIA自身もその言葉を使っていますが、中身を分けて見ると条件はかなり違います。
公開されたもの・されていないもの
表で詳しく見る
| 項目 | 状況 | 出どころ |
|---|---|---|
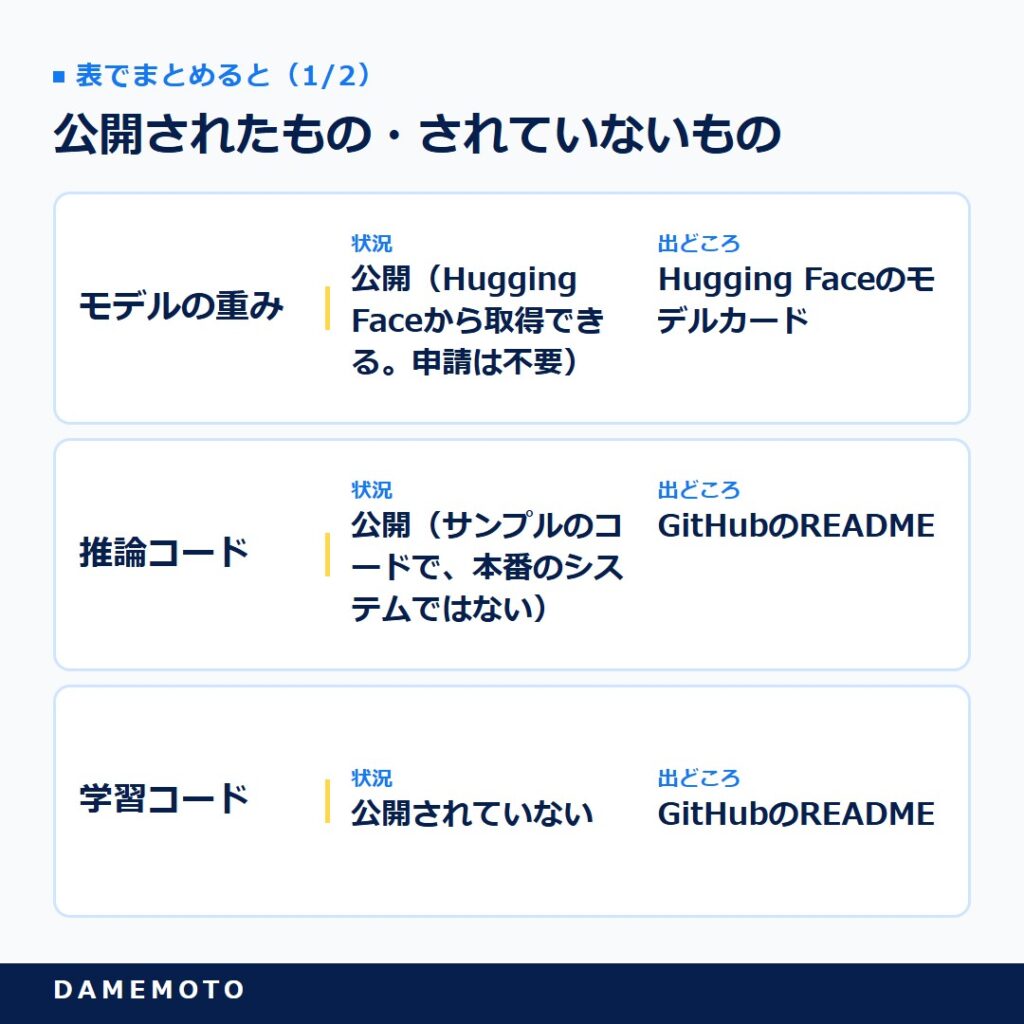
| モデルの重み | 公開(Hugging Faceから取得できる。申請は不要) | Hugging Faceのモデルカード |
| 推論コード | 公開(サンプルのコードで、本番のシステムではない) | GitHubのREADME |
| 学習コード | 公開されていない | GitHubのREADME |
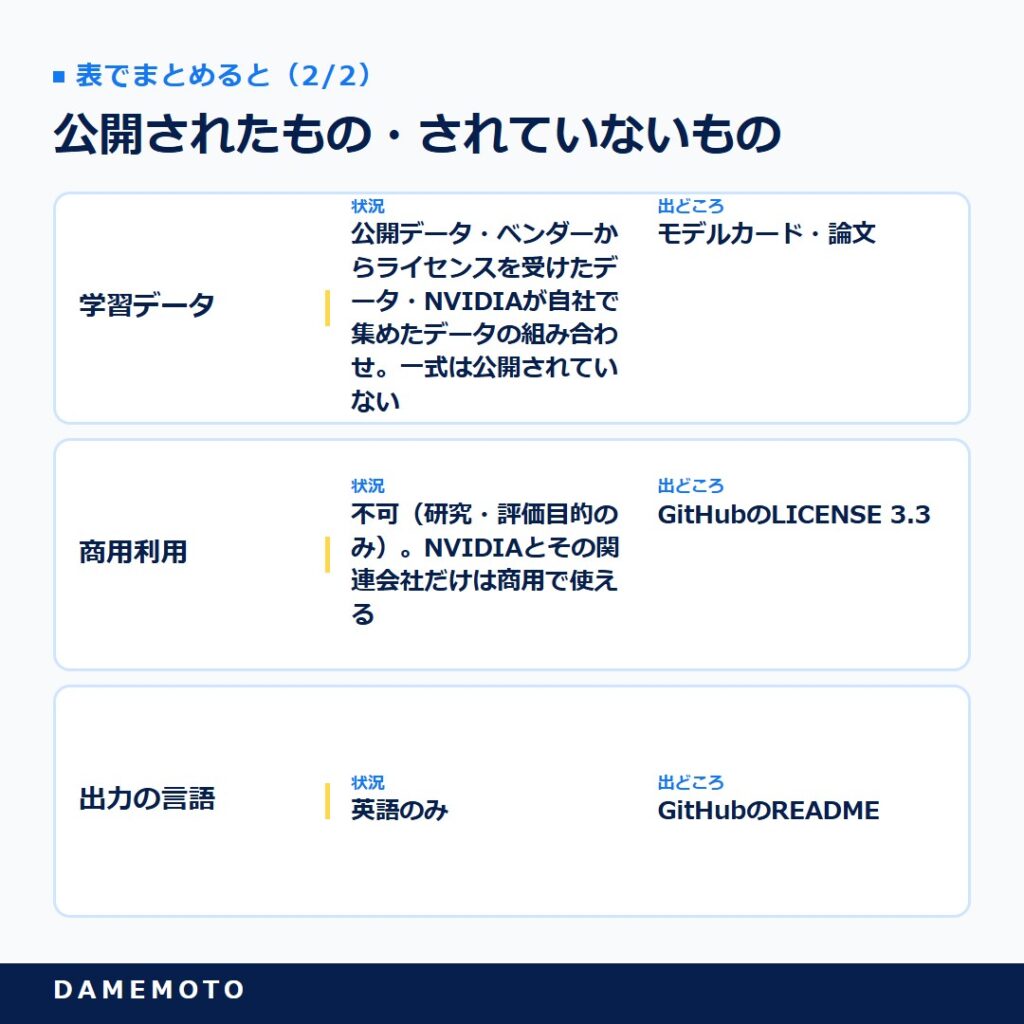
| 学習データ | 公開データ・ベンダーからライセンスを受けたデータ・NVIDIAが自社で集めたデータの組み合わせ。一式は公開されていない | モデルカード・論文 |
| 商用利用 | 不可(研究・評価目的のみ)。NVIDIAとその関連会社だけは商用で使える | GitHubのLICENSE 3.3 |
| 出力の言語 | 英語のみ | GitHubのREADME |
表のとおり、手に入るのは「学習済みの重み」と「試しに動かすコード」までです。自社の動画で同じように鍛え直すための学習コードはありません。
動作を確かめた環境はNVIDIA H100 80GBで、27Bのモデルを2つ動かすには大きなGPUが要ります。
研究・評価目的だけで、商用は不可
GitHubのライセンス(NVIDIA License)は、3.3項で「非商用に限る」と定め、非商用を「研究または評価の目的のみ」と説明しています。派生物にも同じ制限がかかります。
モデルカードも「研究開発専用で、商用や本番での利用は想定もサポートもしない」と書いています。
社内の試験評価はできても、自社の製品やサービスに組み込むことはできないと読むのが正確でしょう。
一方で、NVIDIAとその関連会社だけは商用で使ってよいと書かれており、条件は対称ではありません。
ライセンス名の表記が途中で変わった
細かい点ですが、公開直後はモデルカード(Hugging Faceと、GitHubにあるその写し)が「NVIDIA OneWay Noncommercial License」という名前を挙げていました。
GitHubのライセンスファイルは最初から「NVIDIA License」です。
GitHubでは10月21日(UTC)にモデルカードの写しなどの表記が、Hugging Faceでは10月22日(UTC)にリポジトリのライセンス欄が「NVIDIA License」にそろえられています。
名前は変わっても「研究・評価の非商用のみ」という中身は同じです。10月26日時点でも、モデルカードの本文には旧い名前が残っていました。
ライセンスを確かめるときは、名前ではなく条文の中身を読むのが確実だと思います。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
「Astra並み」「125分の1」をどう読むか
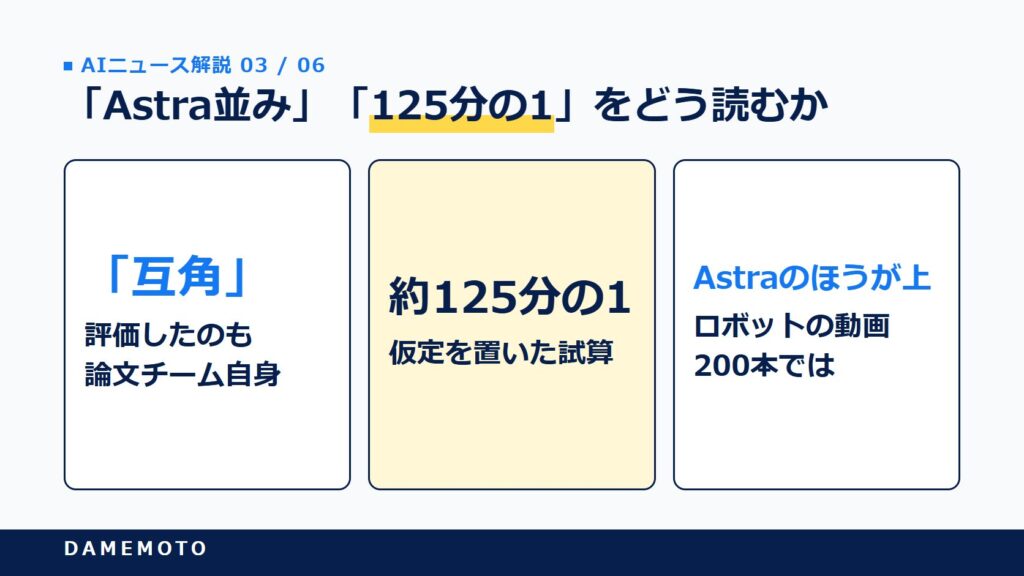
Jim Fan氏の投稿は「Astra並みの性能を125分の1のコストで」と始まり、この言い方が広く引用されました。数字の前提を一つずつ確かめていきます。
50本の試験では57.1%対53.7%
コスト比較に使った試験は、NVIDIAが新しく作った評価用データから選んだ50本の動画(合計約75分)です。
説明文と区間の品質は、Floraが57.1%、GPT-6 Astra(最大の推論強度)が53.7%、Claude Opus 5が30.4%、Gemini 3.8 Flashが38.3%でした。
論文の要約は、社内の評価でAstraと「互角」、ほかの最先端モデルには勝つという書き方です。全面的にAstraを上回ったとは書いていません。
評価したのも論文チーム自身で、第三者による再現は確認できませんでした。
「125分の1」はGPUの価格を仮定した試算
動画1時間あたりのコストは、Floraが約0.72ドル、Astraが約88.49ドル、Opus 5が約41.70ドル、Gemini 3.8 Flashが約8.48ドルと示されました。ただし前提がそろっていません。
- Flora側:GB300を8基使い、1GPU時間10ドルと「仮定」した推定。本番のGPU時間は未検証で、保管や運用の費用は含まない
- Astra側:10月4日時点の公開料金で、実際に返ってきた利用量を換算した値
- 倍率:付録の計算は、丸める前の値(88.4922ドル÷0.7224ドル)で約122.5倍。これを「約125倍」と丸めている
論文自身も、GPU時間は検証していない、価格は仮定だと書いています。「実際に払った額を比べたら125分の1だった」という意味ではない点は押さえておきたいところです。
ロボット動画の説明文ではAstraが上
項目別に見ると、得意と苦手がはっきりします。人の作業動画100本では、Floraが区間分け・説明文・両方を合わせた指標の3つすべてで首位でした。
ところがロボットの動画200本では、3つともAstraのほうが上です。
論文は、公開ベンチマークのWGO-Benchでは説明文そのものの正確さがAstraやGemini 3.8 Flashに及ばず、強みは主に「どこからどこまでが一つの動作か」を切り分ける精度だと認めています。
失敗の検出では、失敗した場面の53.3%を見つけ、ほかのモデルは最高でも11.7%でした。その代わり、正常な場面の約11%を失敗と誤判定するという弱点もあります。
「1日20万時間」はラベル付けの処理量
論文の記述は、512基のGB300で1日最大20万時間分のデータにラベルを付けている、というものです。Jim Fan氏の投稿では「500基」で、GPUの数の表記が少し違います。
これはラベルを付けた動画の量であって、ロボットが新しく積んだ経験や学習の時間ではないと、Humanoids Dailyも指摘していました。
なお、論文の付録がコスト比較の前提として示した処理速度(GPU96基の構成)は「推定で、実測ではない」とされています。
1日20万時間は本番運用の値としてNVIDIAが示した数字で、第三者による検証は確認できませんでした。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
このニュースで誰の何が変わるのか
ロボットを作っていない会社にも、この発表から読み取れることはあります。立場ごとに整理してみます。
ロボット導入を考える製造業の経営層・DX担当
現場に人が足りず、ロボットに任せたいけれど何から手を付けるか迷っている、という声もよく聞きますよね。
ロボットに作業を覚えさせるには「いつ何をしたか」「うまくいったか」を記した動画が大量に要り、Floraはその手間をAIで減らす試みです。
ただし商用は不可なので、自社ライン向けの開発に組み込む前提では使えず、試せるのは研究・評価までです。
明日からできるのは、現場の作業手順や検査工程の動画がどこに、どれだけあるかを棚卸しすることでしょう。
今後、ロボット開発では「動画にAIで自動でラベルを付けてから学習させる」流れが当たり前になる可能性があり、整理した現場動画はその時の資産になると考えられます。
動画を持つBtoBマーケ・オウンドメディア担当
製品デモやセミナーの録画がたまる一方で、見返されていないと感じている方もいるかもしれませんね。
Floraがしているのは「動画を区間に分け、時刻つきの説明を付ける」ことで、考え方としては動画の目次づくりに近いものです。
とはいえFloraはロボットや手作業の動画向けで、英語しか出ず、商用でも使えません。
Flora自体を使うのではなく、「時刻つきの目次と要約を動画に添える」という発想だけを持ち帰るのが現実的です。
明日やるなら、再生数の多い動画を1本選び、既存の文字起こしや要約の道具で章立てと要約を付けてみましょう。
AIに引用されやすいページの条件は、AI Overviewsに引用される記事の特徴をまとめた記事でも整理しています。
今後、動画の中身を文字で示すことは、検索やAIに内容を伝える手段としてさらに重みを増していくと推測されます。
オープンモデルの導入を判断する法務・情報システム担当
「オープン」と書いてあれば社内で使ってよい、と現場から相談されて困った経験はありませんか。Floraは、重みが公開されていても商用不可のライセンスがある例です。
「オープンウェイト」と「商用利用可」は別物で、確かめるのはライセンスの条文だといえます。土台のQwen3.5はApache 2.0でも、Floraの重みは別のライセンスでした。
明日からは、オープンモデルの相談を受けたら「重み・学習コード・商用可否・派生物の条件」の4点を表にしてから判断するとよいでしょう。
重み公開前のモデルを見るときの確認点は、Mistral Large 4の重みの公開予定を紹介した記事も参考になります。
今後も「オープン」を名乗る研究用ライセンスのモデルは増えていくと考えられます。

「オープン」という言葉ほど、条文を一行ずつ読む価値があると感じます。使えるかどうかは、名前ではなく中身で決まります
よくある質問
- NVIDIAのFloraとは何ですか?
-
ロボットや人の作業動画を区間に分け、時刻つきの説明文と成功・失敗の採点を付ける3つのAIモデルのセットです。NVIDIAの研究チームGEARが、2026年10月20日(米国時間)に重みを公開しました。
- Floraは商用利用できますか?
-
できません。ライセンスは研究・評価目的の非商用に限られ、派生物にも同じ制限がかかります。NVIDIAとその関連会社だけは商用で使えると定められています。
- Floraはオープンソースと考えてよいのですか?
-
NVIDIA自身は「オープンソース化」と呼んでいますが、公開されたのは重みと推論コードで、学習コードはありません。商用不可の研究用ライセンスなので、一般的な意味のオープンソースとは条件が異なります。
- Floraは本当にGPT-6 Astraの125分の1のコストですか?
-
NVIDIAの試算です。Flora側は1GPU時間10ドルという仮定の推定、Astra側は実際のAPI利用量の換算で、同じ条件の比較ではありません。計算上は約122.5倍を約125倍と丸めています。
- 日本語の動画にもFloraは使えますか?
-
出力される指示文は英語だけです。対象もロボットや手作業の動画で、一般の解説動画やセミナー録画の要約を目的としたモデルではありません。
- Floraを動かすにはどんな環境が必要ですか?
-
GitHubで動作を確かめた環境は、Linux、Python 3.12、NVIDIA H100 80GBです。27Bのモデルが2つ、9Bのモデルが1つあり、大きなGPUが前提になります。
- FloraとGR00Tはどんな関係ですか?
-
FloraはNVIDIAの人型ロボット向け基盤モデルGR00Tの学習データを作るために使われてきました。モデルカードにはGR00T-2の学習に使うとありますが、GR00T-2自体の公式発表は確認できていません。
まとめ
NVIDIAは2026年10月20日(米国時間)、作業動画にラベルを付ける3つのモデル「Flora」の重みを公開しました。
品質はNVIDIA自身の評価でGPT-6 Astraと互角、コストは仮定を置いた試算で約125分の1ですが、ロボット動画の説明文ではAstraが上で、商用利用はできません。
- 「オープン」と書かれたモデルは、ライセンスの条文で商用可否を確かめる
- コストの倍率は、両方の前提(仮定か実測か)をそろえて読む
- 自社の作業動画や製品動画がどこにどれだけあるかを棚卸しする
ロボットを賢くする競争は、モデルの大きさだけでなく、学習データをどれだけ安く速く整えられるかの勝負にもなってきました。Floraはその流れを示す発表ですが、使える範囲は条文が決める。この順番を忘れないことが大切だと思います。
参考・出典
- NVIDIA GEAR「Flora」研究ページ:https://research.nvidia.com/labs/gear/flora/
- 論文「FLORA: An Open Model Suite for Scaling Robotics Data Engines」(2026年10月20日):https://research.nvidia.com/labs/gear/flora/assets/paper/flora.pdf
- Hugging Face「nvidia/Flora」コレクション:https://huggingface.co/collections/nvidia/flora
- Hugging Face「nvidia/Flora-Captioner」モデルカード:https://huggingface.co/nvidia/Flora-Captioner
- GitHub「NVIDIA/Flora」:https://github.com/NVIDIA/Flora
- GitHub「NVIDIA/Flora」LICENSE:https://github.com/NVIDIA/Flora/blob/main/LICENSE
- Jim Fan氏のX投稿(2026年10月21日 日本時間):https://x.com/DrJimFan/status/2112597587987689912
- The Decoder(2026年10月25日):https://the-decoder.com/nvidia-open-sources-flora-to-make-robot-video-labeling-125x-cheaper-than-gpt-6-astra/
- Humanoids Daily(2026年10月21日):https://www.humanoidsdaily.com/news/nvidia-flora-robot-video-training-data-models






