NVIDIAは2026年10月28日、録音した音声の文字起こし・翻訳・話者の区別を1つでこなすオープンウェイトのモデル「Nemotron 3.5 Transcribe」を公開しました。
40言語の文字起こしに対応し、日本語はモデルカードで「Production-ready」の区分です。ライセンスはOpenMDW-1.1で、商用でも使えるとされています。
社外に出せない会議や取材の録音を、自社の環境で文字にしたい企業や士業にとって、現実的な選択肢が1つ増えました。ただし動かすにはH100級のGPUが目安です。
この記事のポイント
- NVIDIAが2026年10月28日、音声モデル「Nemotron 3.5 Transcribe」の重みを公開
- 40言語の文字起こし、31言語と英語の相互翻訳、話者の区別、単語単位のタイムスタンプに対応
- 日本語は4つの機能すべてに対応し「Production-ready」。ただし他モデルとの日本語の比較はない
- 録音向けでリアルタイムは不可。最長1時間、動かす目安はH100(80GB)1枚
本記事は、Hugging Faceのモデルカード、Hugging FaceのNVIDIA公式ブログ、NVIDIAの公式ブログを一次情報として扱い、TechCrunch、The Next Web、The Decoderの報道と照らし合わせました。
モデルの中身、日本語の対応、性能の数字の読み方、自社で動かす条件、読者ごとの使い道の順に見ていきます。情報は2026年10月29日時点のものです。
NVIDIAが公開した「Nemotron 3.5 Transcribe」とは
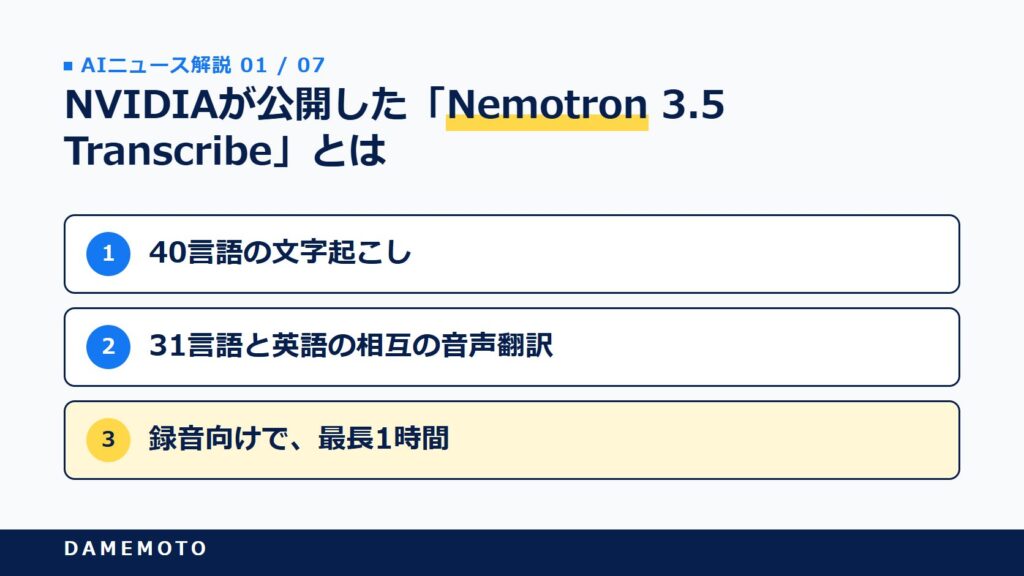
文字起こしのAIはもう珍しくない、と感じる人も多いですよね。今回のモデルは、いくつもの作業を1つにまとめ、しかも重みを誰でも手元に置ける点が特徴です。
文字起こし・翻訳・話者の区別を1つで
Hugging Faceのモデルカードによると、正式名は「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B」で、2026年10月28日にHugging Face、build.nvidia.com、GitHub、NGCで公開されました。できることは次のとおりです。
- 40言語の文字起こし
- 31言語と英語の相互の音声翻訳
- 話者の区別(13言語)と、単語単位のタイムスタンプ
- 文章の指示(プロンプト)での操作。専門用語や書式の指定も渡せる
Hugging FaceのNVIDIA公式ブログは、話者は最大8人まで区別できると説明しています。
モデルカードのほうは推論時の上限を書いておらず、「最大8人の会話を組み合わせて学習した」という書き方です。
話者のラベルは録音の中での区別で、実在の人物を特定するものではないともモデルカードは注意しています。
録音向けで、最長1時間
モデルカードは、このモデルを録音済みの音声を扱う「オフラインのモデル」と位置づけ、リアルタイムの文字起こしサービスではないと明記しています。扱える音声の長さは最長1時間です。
会議を終えてから録音をまとめて処理する使い方が前提で、ライブ配信の字幕には向きません。
規模は、音声を読み取る部分を含めて340億パラメータで、1トークンごとに動くのは約43億パラメータです。
名前は「30B-A4B」ですが、モデルカードは音声を読み取る部分を含めた総数を340億としています。全体は大きくても、動く部分を絞ることで処理を軽くする作りだといえます。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
日本語はどこまで使えるのか
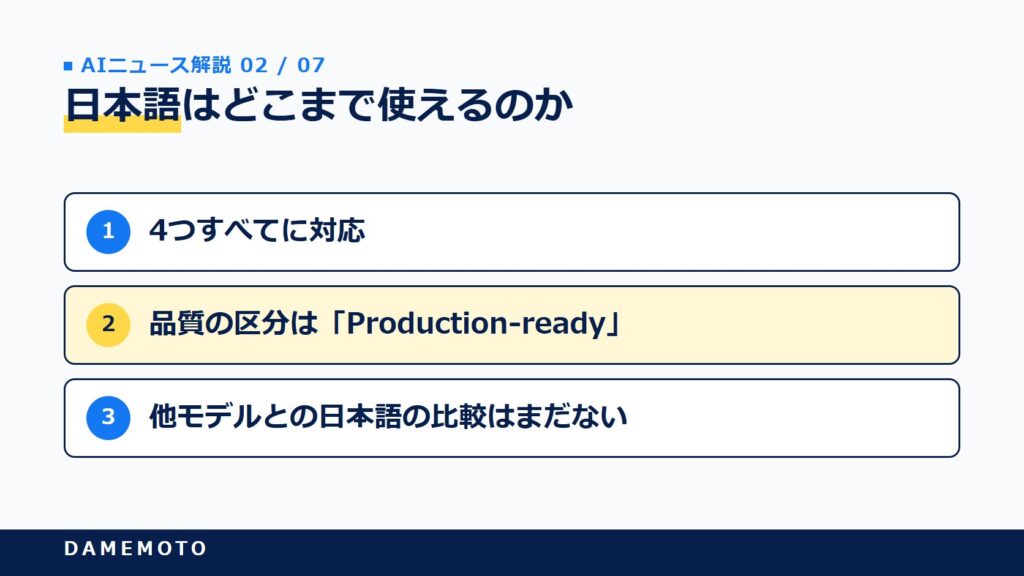
日本の企業が一番気になるのは、日本語の精度ですよね。モデルカードに書かれていることと、書かれていないことを分けておきます。
日本語は4つの機能に対応、区分は「Production-ready」
モデルカードの言語の表では、日本語は文字起こし・英語との翻訳・複数話者の文字起こし・言語の混ざった会話(コードスイッチ)の4つすべてに対応し、品質の区分は「Production-ready」です。
区分は3段階(Leading・Production-ready・Supported)の真ん中です。モデルカードが示す日本語の数値は次のとおりです。
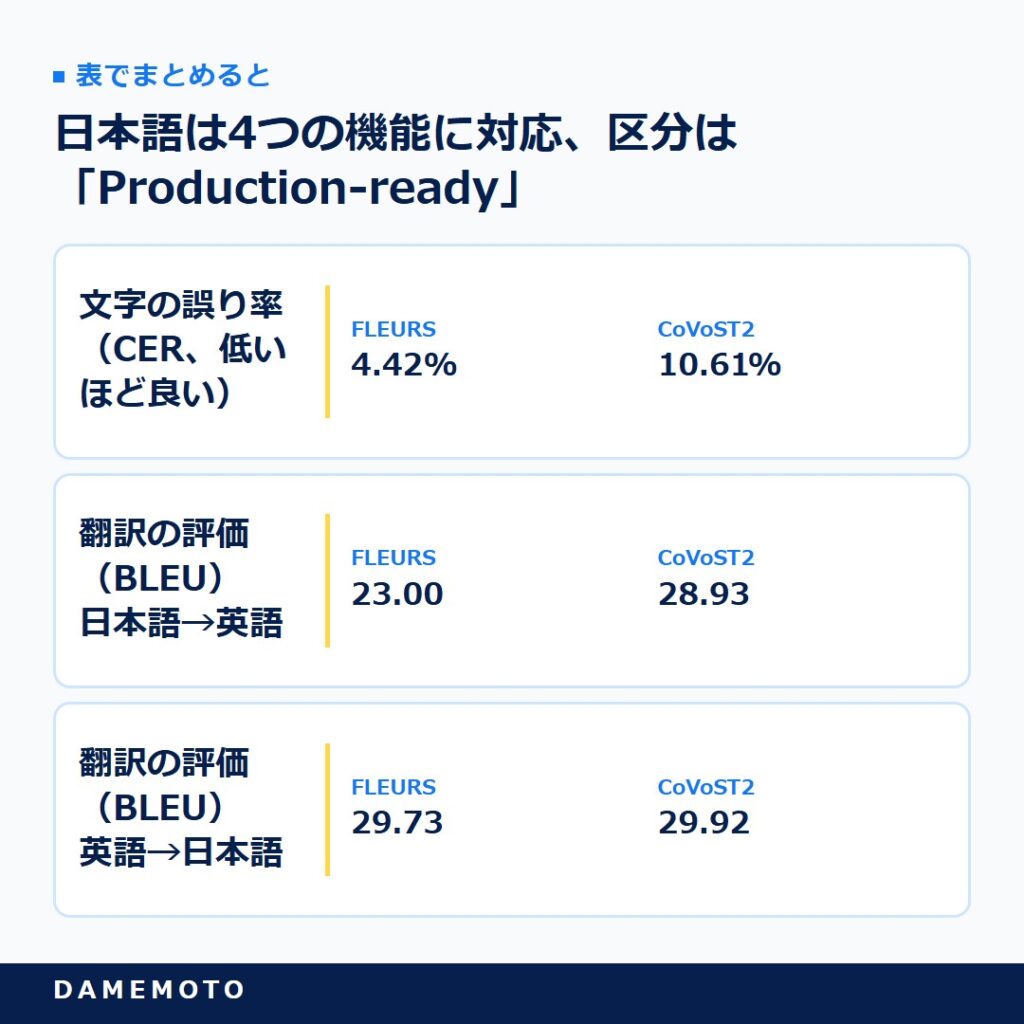
表で詳しく見る
| 指標 | FLEURS | CoVoST2 |
|---|---|---|
| 文字の誤り率(CER、低いほど良い) | 4.42% | 10.61% |
| 翻訳の評価(BLEU)日本語→英語 | 23.00 | 28.93 |
| 翻訳の評価(BLEU)英語→日本語 | 29.73 | 29.92 |
他モデルとの日本語の比較はまだない
注意したいのは、モデルカードに日本語で他のモデルと比べた表がないことです。
多言語の平均の比較に使われた7言語(オランダ語・フランス語・ドイツ語・ヒンディー語・イタリア語・ポルトガル語・スペイン語)にも、日本語は入っていません。
OpenAIのWhisper本体との比較も、一次情報には見当たりません。「日本語でほかより正確」とは、今の資料からは言えないのが正直なところです。
業界用語や雑談の多い社内会議でどうなるかは、自社の録音で試すしかないでしょう。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
性能の数字と、出どころによる違い
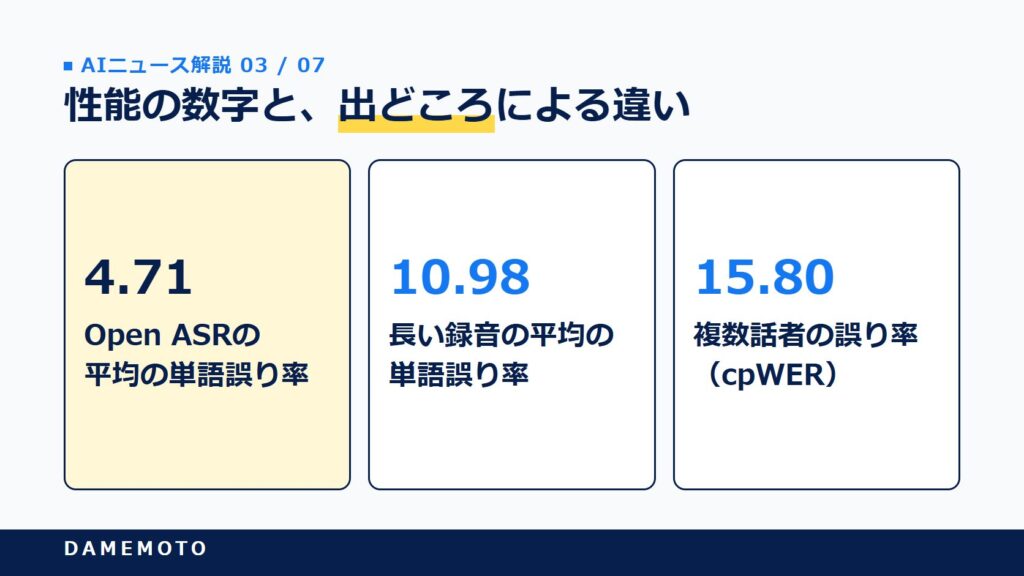
発表には「1位」という言葉が並びますが、同じNVIDIAの資料の中でも数字が少しずつ違います。出どころごとに分けて見ていこう。
英語のランキングでは上位
NVIDIAの公式ブログは、このモデルがHugging FaceのOpen ASRで1位、Artificial Analysisではオープンウェイトのモデルの中で2位だと書いています。
一方、Hugging Face側のブログはArtificial Analysisでの順位を「オープンウェイトで1位タイ」と表現しています。
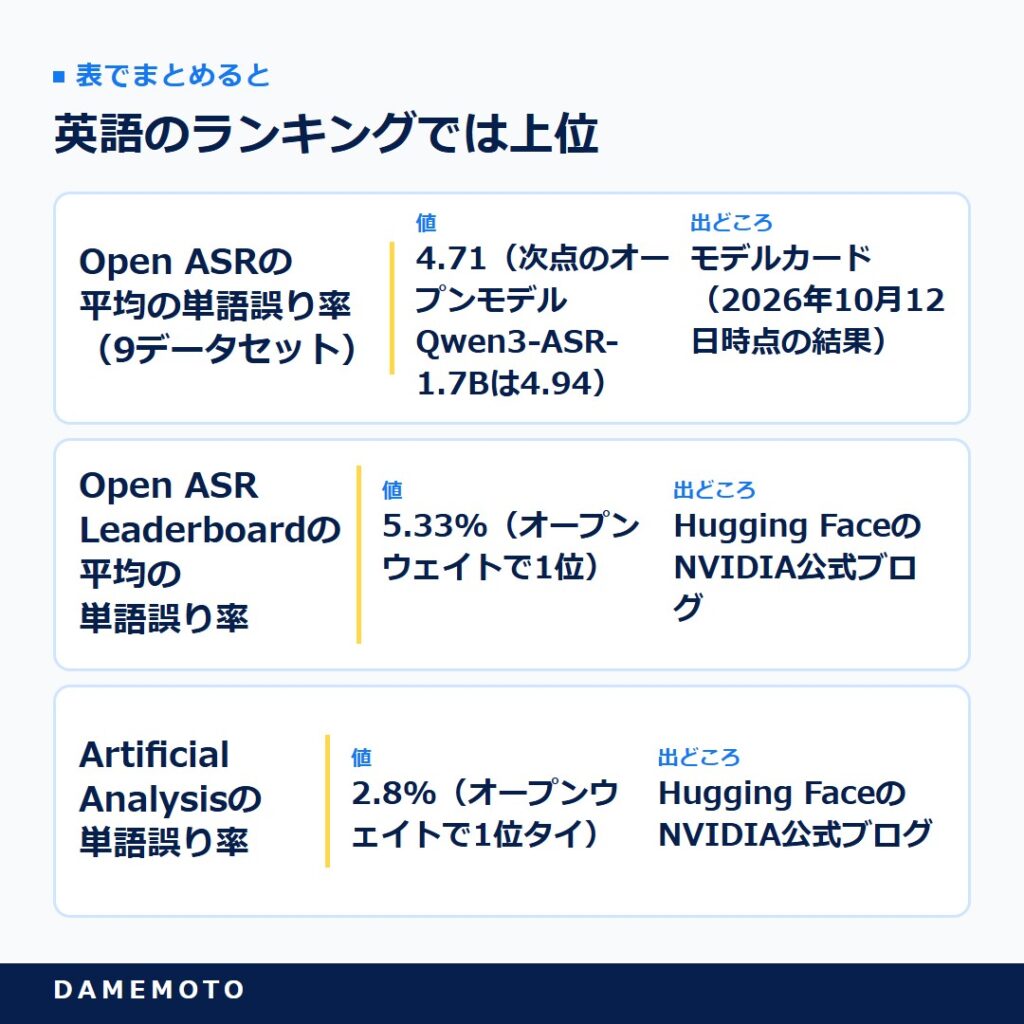
表で詳しく見る
| 指標(英語) | 値 | 出どころ |
|---|---|---|
| Open ASRの平均の単語誤り率(9データセット) | 4.71(次点のオープンモデルQwen3-ASR-1.7Bは4.94) | モデルカード(2026年10月12日時点の結果) |
| Open ASR Leaderboardの平均の単語誤り率 | 5.33%(オープンウェイトで1位) | Hugging FaceのNVIDIA公式ブログ |
| Artificial Analysisの単語誤り率 | 2.8%(オープンウェイトで1位タイ) | Hugging FaceのNVIDIA公式ブログ |
モデルカードの結果は公開前の10月12日時点のものです。順位は日々動くので、引用するときは「どの資料の、いつ時点の数字か」を添えると誤解を生みません。
長い録音と複数話者でも低い誤り率
モデルカードによると、長い録音の平均の単語誤り率は10.98で、オープンウェイトで次点のParakeet-TDT-0.6B-v3(13.37)を下回りました。
複数話者の誤り率(cpWER)は15.80で、公表済みで次点の組み合わせ(16.83)より低い値です。
会議のように長く、人が入れ替わる録音での伸びが、実務では一番効いてくる部分だと思います。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
自社環境で動かすときの条件と注意点
「無料で手元で動く」と聞くと、ノートPCでも使えそうに思えますよね。実際の条件はもう少し重めです。
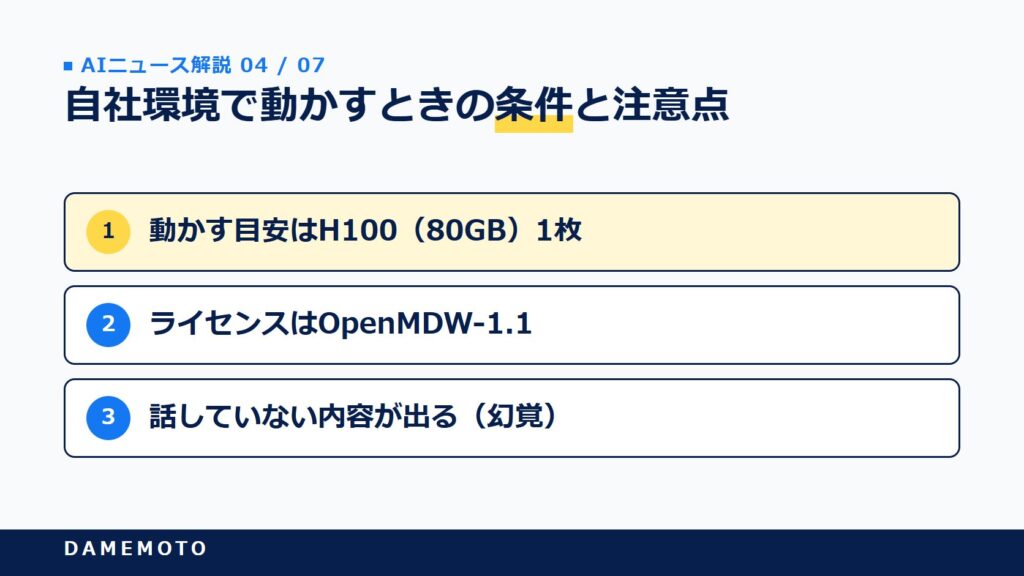
動かす目安はH100(80GB)1枚
モデルカードは、動かす環境の目安を「H100(80GB)1枚」としています。
対応表には、A100(80GB)、L40S(48GB)、RTX PRO 6000 Blackwell、RTX 5090なども載っていますが、GPUによって使える形式(BF16・FP8・NVFP4)が違い、RTX 5090はNVFP4という軽量化した形式だけです。
動かす環境は主にLinuxかWSL2で、RTX 5090などではGGMLを使えばWindowsで直接動かせるとも書かれています。
軽量化した版は近日提供とされており、今すぐ手軽なGPUで動かせるとは限りません。
自社でGPUを用意しない場合は、Baseten・DeepInfra・Simplismartがホスト型で提供すると、Hugging FaceのNVIDIA公式ブログは伝えています。
ただし、外部のサービスに音声を送る時点で「社外に出さない」という前提は変わるため、目的に合わせて選ぶ必要があります。
ライセンスとモデルカードが挙げる限界
ライセンスはOpenMDW-1.1で、モデルカードは商用・非商用のどちらにも使えると書いています。一方で、モデルカードは次のような限界も挙げています。
- 別の語への置き換え・抜け・繰り返し、話していない内容が出る(幻覚)、言語の取り違えがある
- 話者のラベルが正しい人に付かないことがある
- 指示に従う作りのため、悪意ある指示(プロンプトインジェクション)に弱い
- 録音への質問応答などは英語でしか評価されていない
とくに議事録や取材記事に使うなら、発言を引用する前に元の音声で確かめる手順を、運用の中に最初から組み込んでおくべきだと考えられます。
このニュースで誰の何が変わるのか
音声の文字起こしは、どの部署にもある地味で時間のかかる仕事です。影響が大きい読者を3人選んで見ていこう。
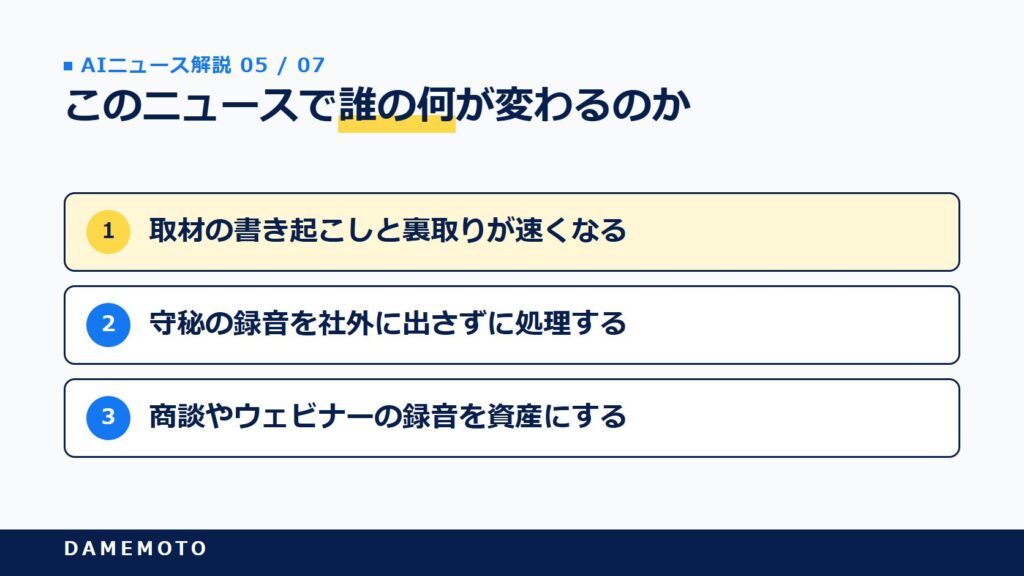
オウンドメディアの編集者:取材の書き起こしと裏取りが速くなる
1時間の取材を書き起こし、どこで誰が何を言ったかを探し直す作業に、半日かかることもありますよね。
このモデルは話者を分け、単語ごとの時刻も付けられるので、引用したい発言の位置をすぐ音声で確かめられるようになります。
明日からは、社内にGPUの環境があるかを技術担当に確かめ、なければホスト型と既存の文字起こしツールを、同じ取材の録音1本で比べてみるのが近道です。
数か月後には、書き起こしより「どの発言を使うか」の判断に時間を使う編集の形が広がる可能性があります。
士業・経営層:守秘の録音を社外に出さずに処理する
相談や面談の録音は、外部のクラウドに送ること自体がためらわれる、という悩みを持つ事務所は多いはずです。
重みが公開され、商用でも使えるライセンスなので、自社のサーバーの中だけで処理する設計が取れます。
ただし、モデルカードは学習データに個人データが含まれることや、話者の取り違えの可能性も書いています。導入の前に、自社の確認済みの録音で精度を測ることが欠かせません。
手元で動くAIという考え方は、社外秘のコードを手元のAIで扱う記事でも扱っています。
BtoBのマーケティング担当者:商談やウェビナーの録音を資産にする
商談やウェビナーの録音が、聞き返されないまま眠っている会社は少なくないですよね。
自社でGPUを持つのは大がかりなので、実際には、使っている議事録ツールや外注先がこうしたオープンなモデルを採り入れるかどうかが接点になると考えられます。
英語との翻訳にも対応するため、海外の顧客との会議の記録にも使える可能性があります。ただし翻訳の評価値はそのまま公開できる品質を示すものではなく、人の確認は必要です。
音声AIを試す前の確認点はMistral Voxtral 3の記事でも整理しました。
よくある質問
- Nemotron 3.5 Transcribeはいつ公開されましたか?
-
2026年10月28日に、Hugging Face、build.nvidia.com、GitHub、NGCで公開されました。
- Nemotron 3.5 Transcribeは日本語に対応していますか?
-
対応しています。モデルカードでは、日本語は文字起こし・英語との翻訳・複数話者・コードスイッチの4つすべてに対応し、品質の区分は「Production-ready」です。
- Nemotronの文字起こしモデルは商用で使えますか?
-
ライセンスはOpenMDW-1.1で、モデルカードは商用・非商用のどちらにも使えると書いています。
- Nemotron 3.5 Transcribeはどんなパソコンで動きますか?
-
モデルカードの目安はH100(80GB)1枚で、環境は主にLinuxかWSL2です。RTX 5090は軽量化した形式(NVFP4)でのみ対応とされています。
- Nemotronで会議をリアルタイムで文字にできますか?
-
できません。モデルカードは、録音済みの音声を扱うオフラインのモデルで、リアルタイムの文字起こしサービスではないと明記しています。
- Nemotron 3.5 Transcribeは何時間の録音まで扱えますか?
-
最長1時間です。モデルカードは1時間を超える動作を保証していないため、長い録音は分けて処理するのが現実的です。
- NemotronはWhisperより正確ですか?
-
OpenAIのWhisper本体との比較は一次情報にありません。英語のリーダーボードの図にWhisper系の派生モデルが載っている程度で、日本語でほかのモデルと比べた表もないため、日本語での優劣は言えません。
まとめ
最後に、押さえておきたい点を振り返ります。
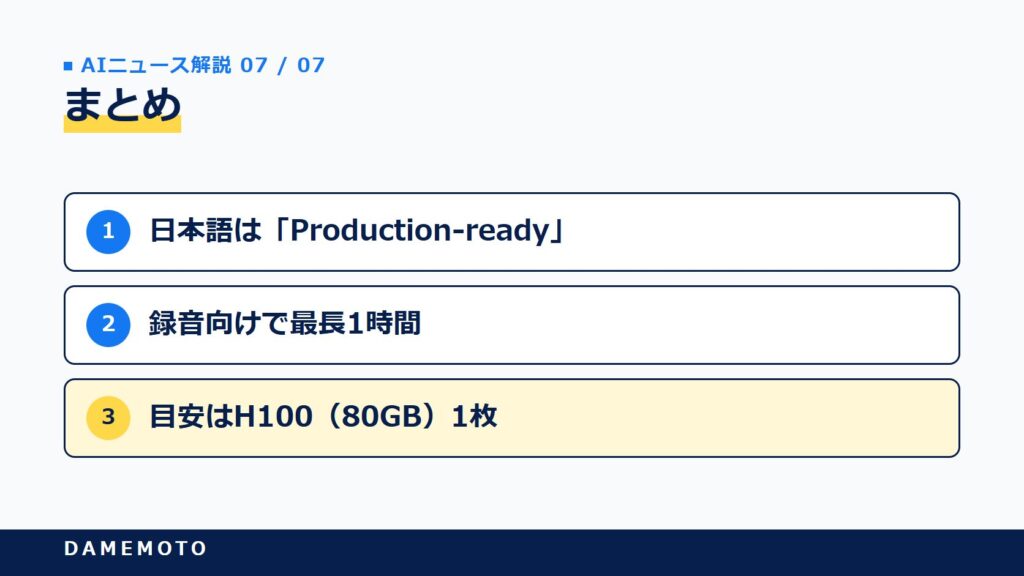
- 2026年10月28日、NVIDIAが文字起こし・翻訳・話者の区別を1つで行うNemotron 3.5 Transcribeを公開した
- 日本語は「Production-ready」。ただし他モデルとの日本語の比較はない
- 録音向けで最長1時間、目安はH100(80GB)1枚。引用前に音声で確かめる運用が前提
社外に出せない音声を自社で文字にする、という選択肢が、商用で使える形でそろってきたと感じます。まずは自社の録音1本で、今使っているツールと比べてみると、導入する価値があるかがはっきりするはずです。
参考・出典
- Hugging Face「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B」モデルカード:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
- Hugging Face NVIDIA公式ブログ(2026年10月28日):https://huggingface.co/blog/nvidia/nemotron-transcribe-granary
- NVIDIA公式ブログ(2026年10月28日):https://blogs.nvidia.com/blog/local-ai-rtx-spark-laptops-updates-models-agents-games/
- TechCrunch(2026年10月28日):https://techcrunch.com/2026/10/28/voice-ai-in-vogue-nvidia-releases-new-open-transcription-model/
- The Next Web:https://thenextweb.com/news/nvidia-nemotron-3-5-transcribe-granary-v2-open-speech
- The Decoder:https://the-decoder.com/nvidias-open-nemotron-3-5-transcribe-combines-transcription-translation-and-speaker-recognition/
関連する最新ニュース






