OpenAIは2026年10月30日、Webサイトが「AIの学習に使わないでほしい」という意向をrobots.txtの共通シグナルで伝えられるようにし、そのシグナルを尊重すると発表しました。
同じ日にGoogleも2027年に対応する計画を公式ブログで明らかにしています。
会社ごとにAIクローラーの名前を並べて学習を断ってきたSEO担当者・Web担当者にとって、robots.txtの書き方と「学習は断るがAIの回答には出たい」という方針の立て方が変わり始めるニュースです。
この記事のポイント
- robots.txtに「User-Agent: __usage_ai-training」と書き、AI学習への意向をまとめて伝える仕組み
- OpenAIは「今後数か月」、Googleは「2027年」に対応を目指す。OpenAI・Google・Microsoftの読み取りはこれから
- GPTBotやGoogle-Extendedなど、今の会社別の設定はそのまま残る
- Googleでは、共通シグナルで断るとGoogle-Extendedを断ったのと同じ扱いになる予定
本記事は、OpenAIの公式発表、GoogleのSearch Central Blog、共通シグナルを定義するIETFのインターネットドラフトを一次情報とし、Microsoftの動きはSearch Engine LandとSearch Engine Roundtableの報道で補いました。
仕組みの中身、今までの制御との違い、注意点、読者ごとの影響の順に見ていきます。情報は2026年10月31日時点のものです。
robots.txtの共通シグナルでAI学習の意向を伝える仕組み
AIに記事を学習されたくない、でも検索やAIの回答には出たい。そう考えて、robots.txtにAIクローラーの名前を1つずつ書き足してきた人も多いですよね。今回の発表は、その手間を1つのシグナルにまとめようとする動きです。
OpenAIは「今後数か月」、Googleは「2027年」に対応へ
OpenAIは公式発表で、robots.txtの共通シグナルを、基盤となる生成AIの学習への利用についての意向として尊重すると表明しました。
実装は「今後数か月」を目指し、詳しい内容は実装のときに改めて公表するとしています。他のAI事業者にも対応を呼びかけました(OpenAI)。
Googleも同じ2026年10月30日(米国時間)、John Mueller氏の名前でSearch Central Blogに「Supporting a shared AI training control for websites」を公開し、2027年に他のAI事業者とともに対応することを目指すと書きました(Google Search Central Blog)。
どちらも、IETF(インターネットの技術標準を話し合う団体)のAIPREFワーキンググループでの議論を土台にしています。
書き方は「User-Agent: __usage_ai-training」
共通シグナルの書き方は、2026年10月30日付のIETFのインターネットドラフト「Machine-Readable Training Preference Signal」に定められています。
著者はAnthropicのKevin Kelley氏です。ドラフトに載っている例は次のとおりです。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
この例は「/press-kit/ 以外はAI学習に使わないでほしい、/press-kit/ は使ってよい」という意味になります。
新しい命令や文法は作らず、いつものrobots.txtのグループの書き方で意向を表すのが特徴です。
注意したいのは、「User-Agent: *」のグループはこのシグナルとして扱わないとドラフトが定めている点です。
全クローラー向けの記述で学習を断ったつもりでも、共通シグナルとしては伝わりません。
Microsoftは学習とAI回答への利用を分けて設定できる(報道)
Search Engine LandとSearch Engine Roundtableによると、Microsoftも2026年10月30日に新しい設定を発表しました。
AIの学習、AIの回答づくりへの利用(グラウンディング)、自社のAI製品だけでの利用の3つを分けて選べ、学習を断ってもBingの検索順位には影響しないとされています。
報道によると、2027年2月1日から新しい設定をクロール時に尊重し、従来のNoArchive・NoCacheは2027年3月1日以降、学習やグラウンディングの意向として読まなくなります(Search Engine Land)。
Microsoftの公式ブログの本文と、robots.txtで使うトークン名は確認できていません。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
今までのAIクローラー制御と何が違うのか
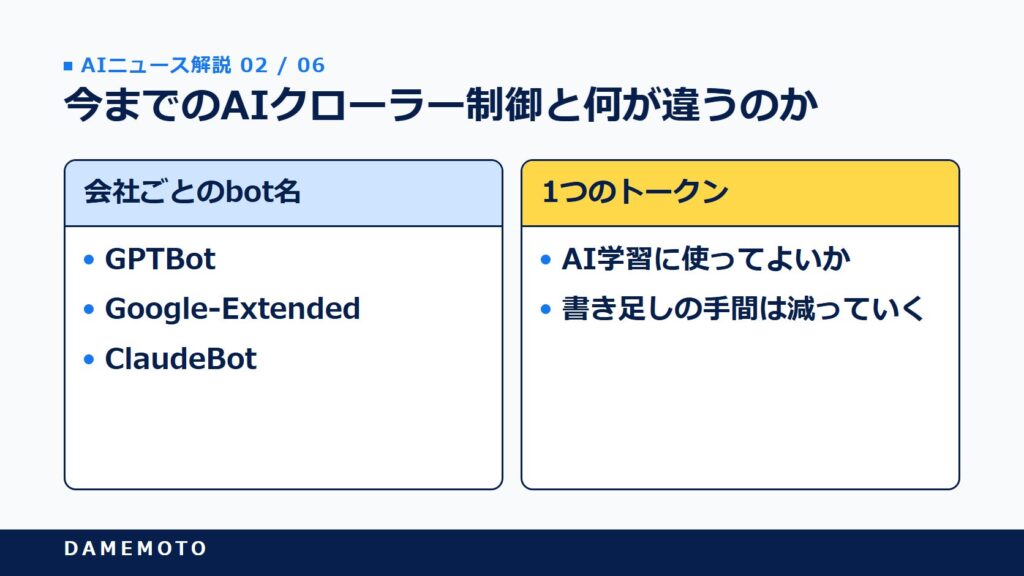
「GPTBotを止めればいいのでは?」と感じるかもしれません。ここでは、今の仕組みと共通シグナルの違いを整理しておきたいところです。
会社ごとのbot名から、1つのトークンへ
これまでは、OpenAIならGPTBot、GoogleならGoogle-Extended、AnthropicならClaudeBotと、会社ごとの名前を調べて書く必要がありました。
新しい会社が出るたびに書き足す運用です。共通シグナルは、1つのトークンで「AI学習に使ってよいか」をまとめて伝える方式です。
対応する会社が増えるほど、書き足しの手間は減っていくと考えられます。
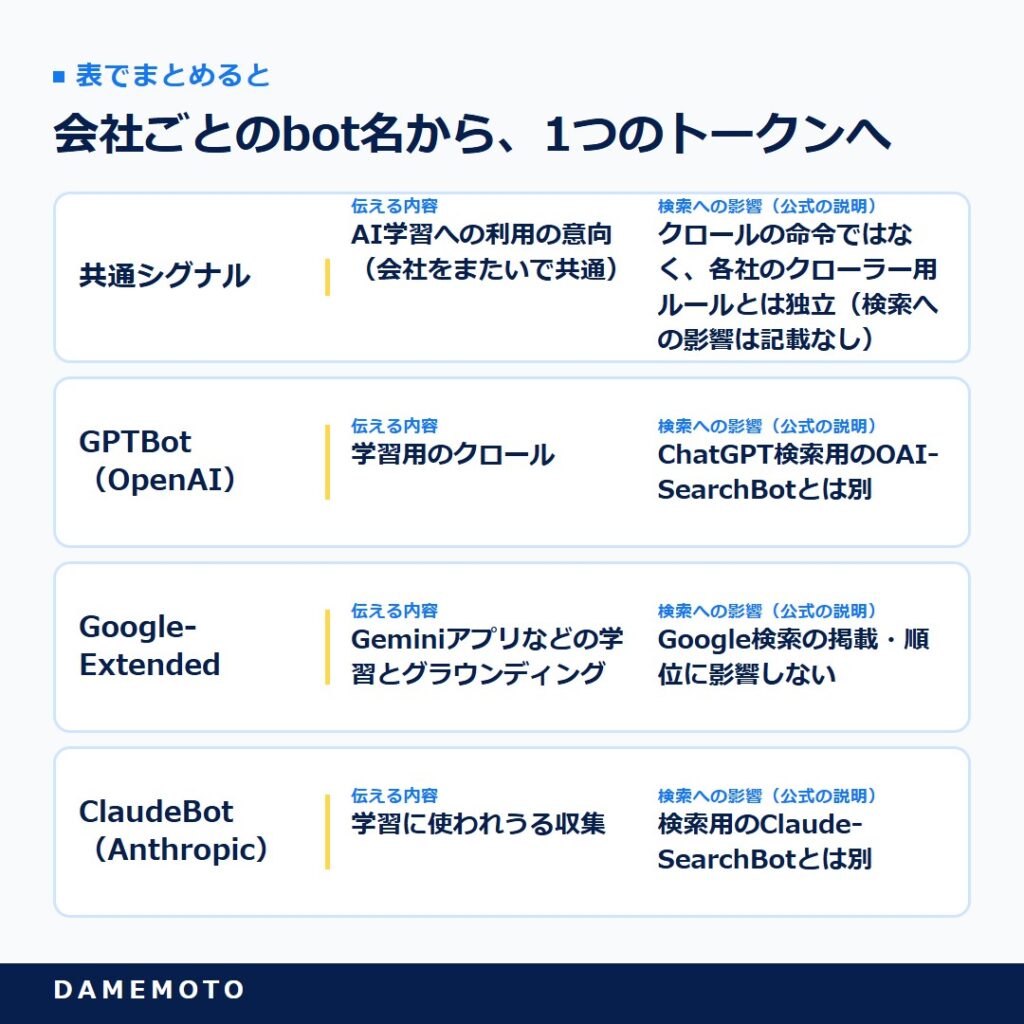
表で詳しく見る
| 仕組み | 伝える内容 | 検索への影響(公式の説明) |
|---|---|---|
| 共通シグナル | AI学習への利用の意向(会社をまたいで共通) | クロールの命令ではなく、各社のクローラー用ルールとは独立(検索への影響は記載なし) |
| GPTBot(OpenAI) | 学習用のクロール | ChatGPT検索用のOAI-SearchBotとは別 |
| Google-Extended | Geminiアプリなどの学習とグラウンディング | Google検索の掲載・順位に影響しない |
| ClaudeBot(Anthropic) | 学習に使われうる収集 | 検索用のClaude-SearchBotとは別 |
GPTBotやGoogle-Extendedの設定はそのまま残る
OpenAIは「新しいシグナルは、robots.txtですでに提供している制御を置き換えない」と明言しています。
Googleも、Google-Extendedは共通シグナルと並んで引き続き機能すると書いています。今のGPTBotやGoogle-Extendedの記述を消す必要はありません。
ドラフトでも、より具体的な指定が一般的な指定より優先されるとしています。
過去のOpenAIの学習方針の変化とrobots.txtの関係は、OpenAIのオフライン訓練とGPTBotの記事でも整理しています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
確定していることと、書く前の注意点
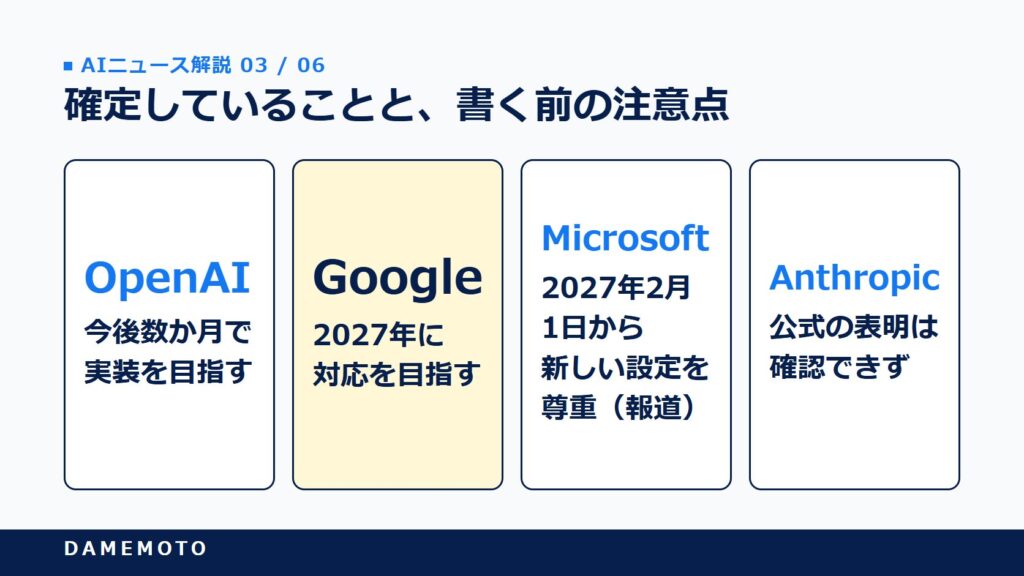
新しい書き方が出ると、すぐに足したくなりますよね。ただ、今の時点で効くことと、まだ決まっていないことは分けて押さえておきたいところです。
主要各社がシグナルを読むのはこれから
対応時期はどれも先です。今日robots.txtに書いても、各社が読み取りを始めるまでは効き目がありません。
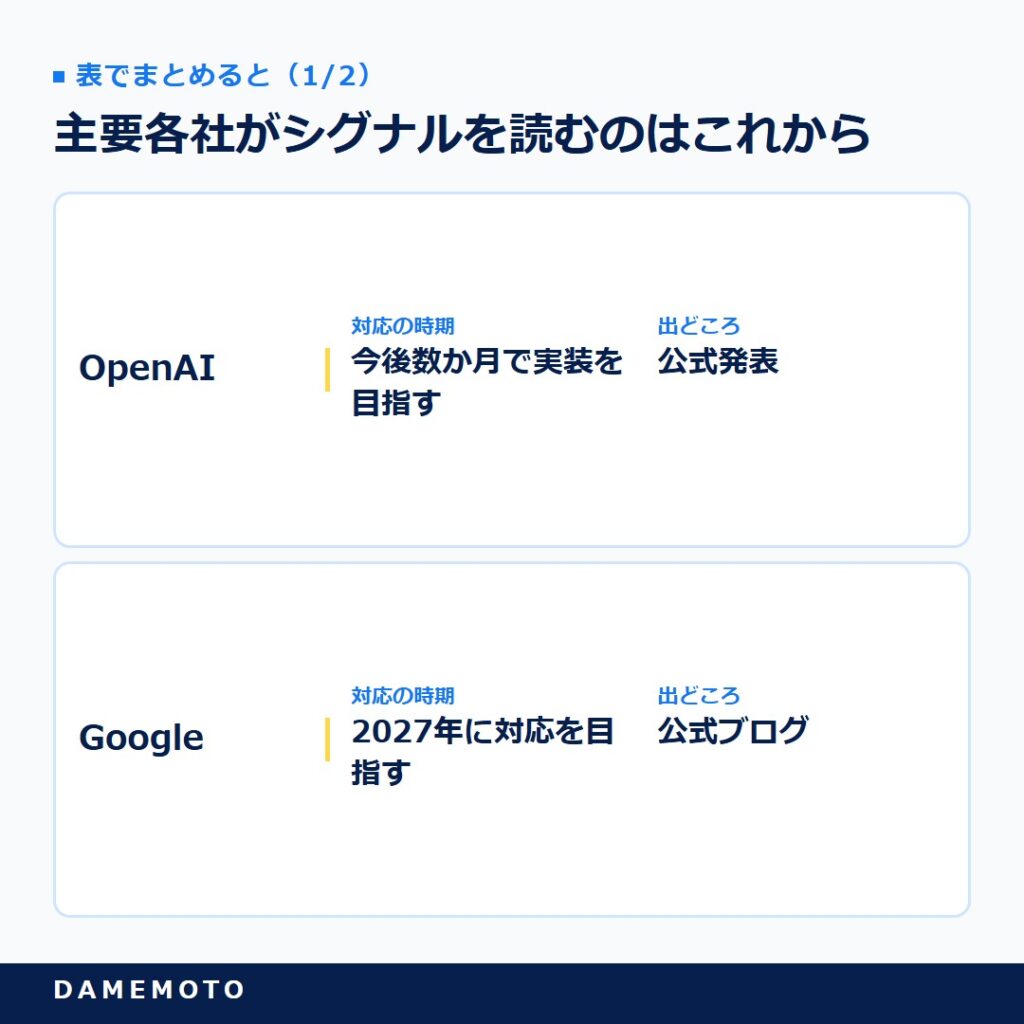
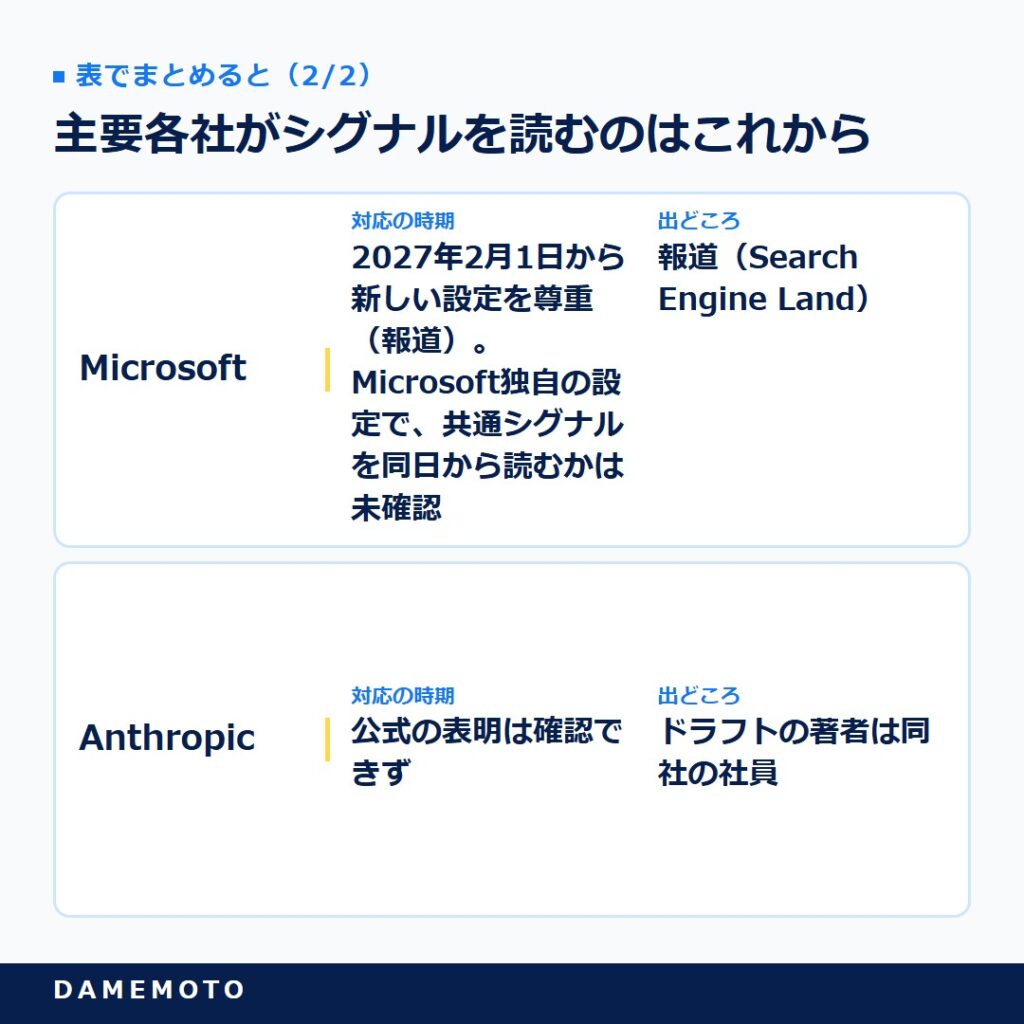
表で詳しく見る
| 会社 | 対応の時期 | 出どころ |
|---|---|---|
| OpenAI | 今後数か月で実装を目指す | 公式発表 |
| 2027年に対応を目指す | 公式ブログ | |
| Microsoft | 2027年2月1日から新しい設定を尊重(報道)。Microsoft独自の設定で、共通シグナルを同日から読むかは未確認 | 報道(Search Engine Land) |
| Anthropic | 公式の表明は確認できず | ドラフトの著者は同社の社員 |
Search Engine LandやSearch Engine Roundtableは、Anthropicもこの取り組みに加わっていると報じていますが、同社の公式ページで対応を表明した記述は見つかりませんでした。
Googleでは、Geminiアプリでの引用にも関わる
見落としやすいのがここです。
Googleは、共通シグナルで学習を断り、Google-Extendedを特に指定していないサイトは、Google-Extendedを断ったものとして扱う予定だと書いています。
そしてGoogleは、Google-Extendedを明示的に許可しているサイトが、Geminiアプリのグラウンディングで回答に出てクリックを受けられると説明しています。
この2つを合わせて読むと、共通シグナルで学習を断ると、Geminiアプリの回答に出る機会にも影響する可能性があります。
ただし、Google-ExtendedはGeminiの学習とグラウンディングを1つのトークンでまとめて制御します。
許可すればGeminiの学習にも使われうるため、Googleについては「学習は断るが、Geminiでの引用は残す」という分け方はできません。
Geminiでの引用を優先するか、学習を断ることを優先するかを決めたうえで設計したいところだと思います。
なお、Google-Extended自体はGoogle検索の掲載や順位には影響しないと、Googleの文書は明記しています。
強制力はなく、ドラフトはIETFの承認前
共通シグナルを定めた文書は個人のインターネットドラフトで、ドラフト自身が「IETFに承認されたものではなく、正式な地位はない」と書いています。
OpenAIも自主的な取り組みと位置づけています。意向を伝える仕組みであって、アクセスを技術的に止めるものではありません。
すでに集められたデータが学習から外れるかどうかも、公式の説明は見当たりませんでした。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
このニュースで誰の何が変わるのか
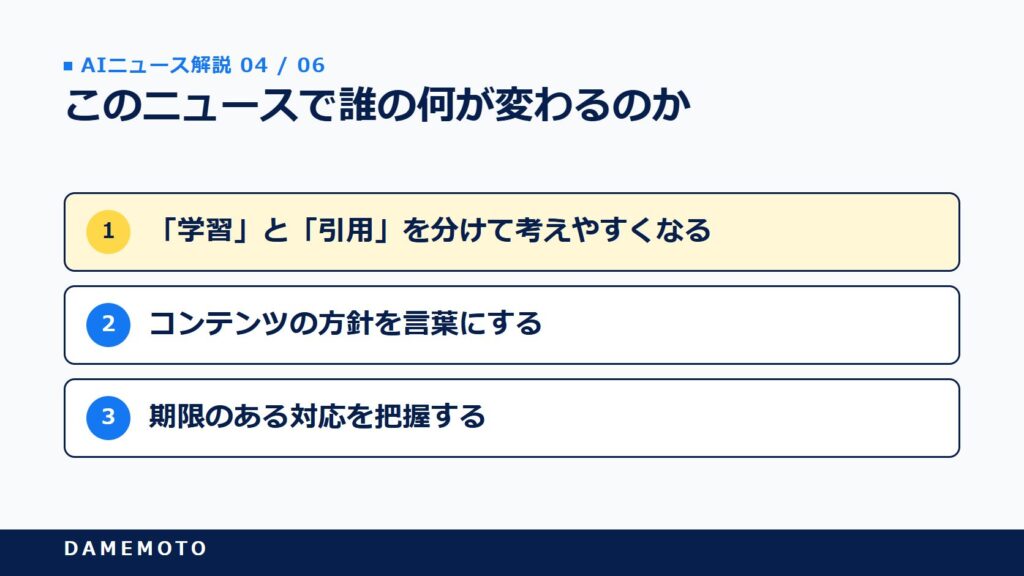
影響が大きいのは、robots.txtを管理する人と、コンテンツの扱いを決める人です。立場ごとに見ていこう。
BtoB企業のSEO担当者:「学習」と「引用」を分けて考えやすくなる
SEO担当者の悩みは、学習は断りたいのに、AI検索での引用は失いたくない、という板挟みではないでしょうか。
今回の仕組みでは、学習の意向は共通シグナル、検索や引用は各社の検索用クローラーと、役割が分かれた形で整理されつつあります。
ただしGoogleは例外で、Geminiアプリでは学習と引用が1つの設定で連動します。
明日からやることは2つです。
まず今のrobots.txtで、GPTBot・OAI-SearchBot・Google-Extended・ClaudeBotなどをどう書いているかを棚卸しすること。
次に、OAI-SearchBotやGooglebotなど検索用のクローラーまで止めていないかを確かめることです。
各社の名前と書き方はAIクローラー制御のrobots.txt記述例にまとめています。
2027年にかけて各社の実装がそろえば、Googleを除いて、学習と引用を分けた設定が当たり前になっていくと考えられます。
オウンドメディアの編集者:コンテンツの方針を言葉にする
自社の記事や調査をAIの学習に使わせるかどうかは、技術の設定である前に編集方針の問題です。共通シグナルでは、ドラフトの例のように「この部分だけは使ってよい」とパスごとに分けられます。
まずは「学習に使われてよいページ・使われたくないページ」を編集部で書き出しておくと、実装が始まったときに迷いません。
プレスリリースや用語集は使ってよい、有料の調査レポートは断る、といった線引きが考えられます。
数か月から1年の間に、AIに学習される・引用される範囲を自社で設計することが、編集の仕事の1つになっていく可能性があります。
Web担当役員・マーケティング部長:期限のある対応を把握する
役員や部長にとっては、いつまでに何を決めるかが重要になります。報道によると、Microsoftは2027年3月1日以降、NoArchive・NoCacheを学習やグラウンディングの意向として読まなくなります。
影響するのはBingの検索順位ではなく、CopilotなどAIの回答での扱いです。
NoArchiveやNoCacheでAIへの利用を制限してきたサイトは、メタタグやHTTPヘッダーでの新しい設定への切り替え(Bing Webmaster Toolsには暫定の設定もあります)を予定に入れておきたいところです。
学習を断ることと、AIの回答に出ることは、引き換えになる場面があるので、自社にとってどちらが大切かを決めておくと、担当者が動きやすくなると思います。
よくある質問
- robots.txtにはどう書けばAI学習を断れますか?
-
IETFのドラフトでは「User-Agent: __usage_ai-training」の次の行に「Disallow: /」と書きます。一部だけ許可するなら「Allow: /パス/」を加えます。各社が対応するまでは効き目がありません。
- robots.txtのAI学習シグナルはいつから使えますか?
-
OpenAIは今後数か月、Googleは2027年の対応を目指すと発表しています。Microsoftは2027年2月1日から、学習などの独自の新しい設定を尊重すると報じられています(共通シグナルを同日から読むかは確認できていません)。
- AI学習を断るとGoogle検索の順位は下がりますか?
-
Googleは、Google-ExtendedはGoogle検索の掲載や順位に影響しないと明記しています。共通シグナルは、Google-Extendedを断ったものとして扱う予定です。
- 今のGPTBotのrobots.txt設定は消してよいですか?
-
消す必要はありません。OpenAIは、新しいシグナルは既存の制御を置き換えないとしています。各社の対応が始まるまでは、今の記述がそのまま有効です。
- 「User-Agent: *」で断ればAI学習も断れますか?
-
共通シグナルとしては伝わりません。ドラフトは、全クローラー向けのグループをこのシグナルとして扱ってはならないと定めています。
- AI学習を断るとGeminiの回答に出なくなりますか?
-
可能性があります。Googleは、Google-Extendedを明示的に許可したサイトがGeminiアプリのグラウンディングで回答に出られると説明しており、共通シグナルでの拒否はGoogle-Extendedの拒否と同じ扱いになる予定です。
- robots.txtで断ればAI学習は必ず止まりますか?
-
保証はありません。意向を伝える自主的な仕組みで、ドラフトもIETFの承認前です。すでに集められたデータの扱いについて、公式の説明は見当たりません。
まとめ
2026年10月30日、OpenAIとGoogleが、robots.txtの共通シグナルでAI学習への意向を伝える仕組みへの対応を表明しました。会社ごとのbot名を並べる運用から、1つのトークンでまとめて伝える方向へ動き出しています。
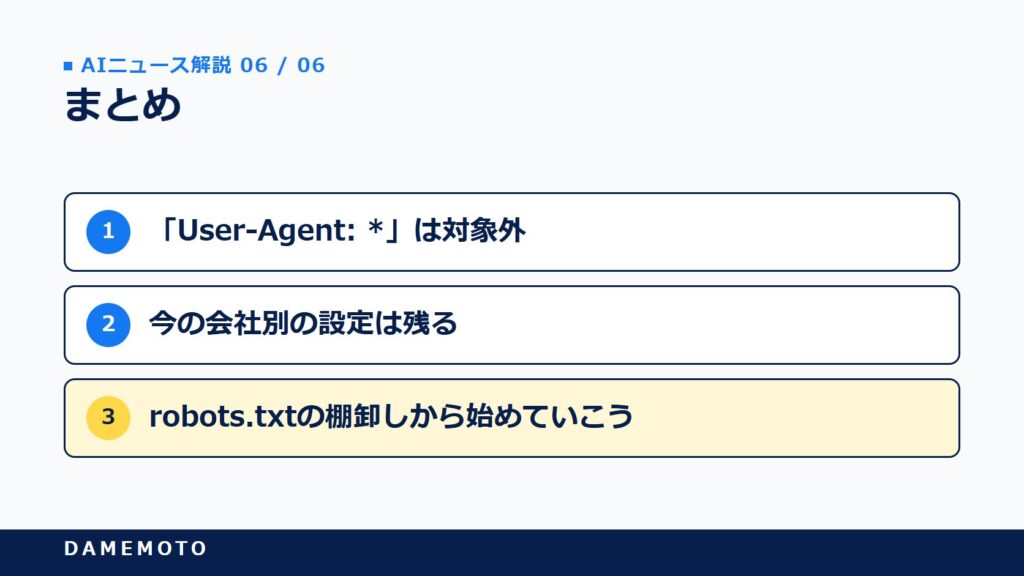
- 書き方は「User-Agent: __usage_ai-training」のグループ。「User-Agent: *」は対象外
- OpenAIは今後数か月、Googleは2027年。今の会社別の設定は残る
- Googleでは、共通シグナルでの拒否がGeminiアプリでの引用にも関わる
すぐに書き換える必要はありませんが、学習と引用をどう分けるかは今から決めておけます。各社の実装の詳細が出たときに迷わないよう、robots.txtの棚卸しから始めていこう。
参考・出典
- OpenAI「Making it easier for websites to express AI training preferences」(2026年10月30日)
- Google Search Central Blog「Supporting a shared AI training control for websites」(2026年10月30日)
- IETF Internet-Draft「Machine-Readable Training Preference Signal」(2026年10月30日)
- Google「Google-Extended」クローラーの説明
- OpenAI「Overview of OpenAI Crawlers」
- Anthropic ヘルプ(クローラーの説明)
- Search Engine Land(2026年10月30日)
- Search Engine Roundtable(2026年10月30日)






