AIクローラーの制御方法とは、robots.txtに各社のユーザーエージェント(GPTBot・ClaudeBot・Google-Extended等)ごとの許可・拒否を記述し、「学習用ボットは制限・回答用ボットは許可」と方針を切り分けることです。
結論を先に示します。
AIクローラーは「学習系(モデル学習用の収集)」と「回答系(AI検索の回答時の取得)」で役割が分かれており、引用されたいなら回答系を許可し、学習を避けたいなら学習系をブロックします。
要注意なのはGoogle-Extendedで、これをブロックしても通常のGoogle検索やAI Overviewsからは消えません。
本記事では主要ボットの最新ユーザーエージェント(2026年の各社公式に準拠)を一覧化し、そのままコピーして使えるrobots.txt記述例まで提供します。
この記事の結論
AIクローラーは「学習は任意で判断、回答・検索用は許可」で整理すると迷わないと考えています
今日からやること
- 引用と学習の方針を社内で一言に決める
- 最新のUA名でボット別に書き分ける
- 四半期ごとに各社の公式情報を見直す
こんな人向け:AIに引用はされたいが、学習への利用は抑えたいサイト運営者の方数値の出典:RFC 9309(IETF)、Anthropic公式ヘルプセンター
AIクローラーの制御方法:robots.txtで学習系と回答系を分ける
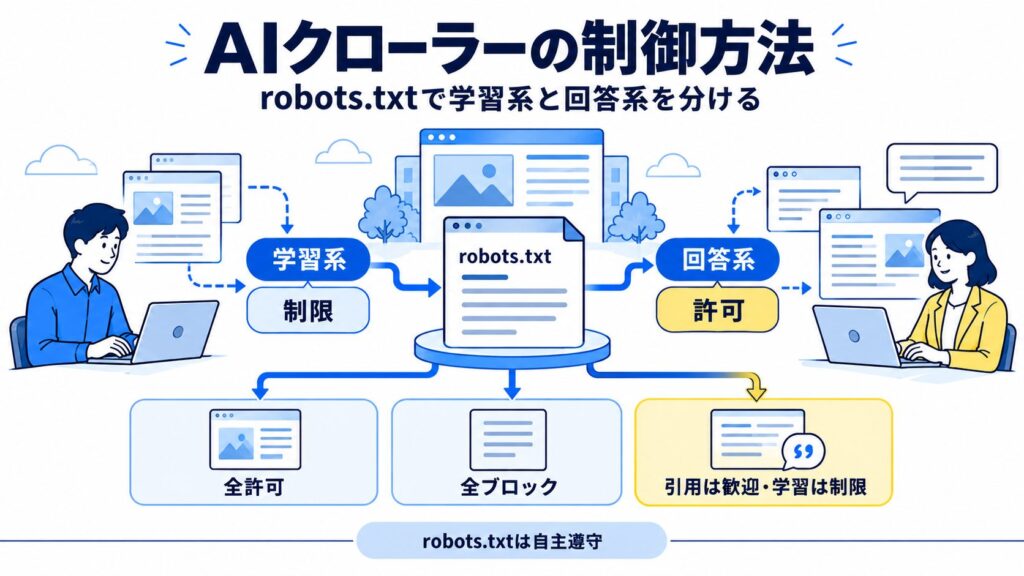
結論である制御の核から示します。
AIクローラーの制御は、robots.txtにボットごとのUser-agentブロックを作り、許可(Allow)と拒否(Disallow)を記述することで行います。
判断の軸はただ一つ、「学習に使われるボットか、回答・引用に使われるボットか」です。AI検索で引用されたいなら回答系を許可し、無償の学習利用を避けたいなら学習系をブロックします。
この切り分けを誤ると、引用機会を失ったり、逆に守りたいコンテンツを学習に使われたりします。
なぜ一律ブロックも一律許可も最適でないのか
一律で全AIボットをブロックすると、AI検索の回答に引用されにくくなり、ブランド露出の機会を失います。
逆に何も設定しなければ、robots.txtを尊重するボットは原則アクセス可能で、本文が学習にも使われます。どちらも「方針なき放置」です。
まず「AI検索に引用されたいか」「自社コンテンツを学習に使われてよいか」という2問に答え、その方針をボットごとの記述へ翻訳する。この段階的な設計が出発点になります。
 DAMEMOTO代表鈴木
まず方針。記述はそのあとです
「引用は歓迎・学習は制限」が多くの企業の現実解
方針は大きく3パターンあります。全許可、全ブロック、そして「引用は歓迎・学習は制限」です。多くの中小企業にとって現実的なのは3つ目です。
AI検索の回答に引用されてブランド露出を得つつ、自社コンテンツが無償でモデル学習に使われるのを抑える、というバランスを取ります。
具体的には学習系をDisallow、回答系をAllowと書き分けます。
決算情報・独自データ・調査レポートなど、固有の価値を持つコンテンツが多い企業ほど、この切り分けの実益が大きくなります。
大前提:robots.txtは「強制力ある壁」ではない
制御を語る前に、最重要の前提を押さえます。
robots.txtは2022年にIETFの正式標準(RFC 9309)になりましたが、その本質はクローラー側の自主的な遵守を前提とした仕組みです(RFC 9309(IETF公式))。
OpenAI・Anthropic・Perplexityは「robots.txtを尊重する」と公表していますが、すべてのボットが必ず従う保証はなく、一部のクローラーやエージェントはrobots.txtを無視します。
つまりrobots.txtは「お願いの看板」であって「鍵のかかった扉」ではありません。本当に守りたい機密情報は、認証(ログイン)やアクセス制限で守る必要があります。robots.txt自体の基本ルールは、robots.txtの書き方と記述例3つで整理しています。robots.txtの制限が著作権法の上でどう扱われるかは、生成AIと著作権の考え方とrobots.txtで文化庁の資料にそって確かめられます。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
主要AIクローラーのユーザーエージェント一覧と役割
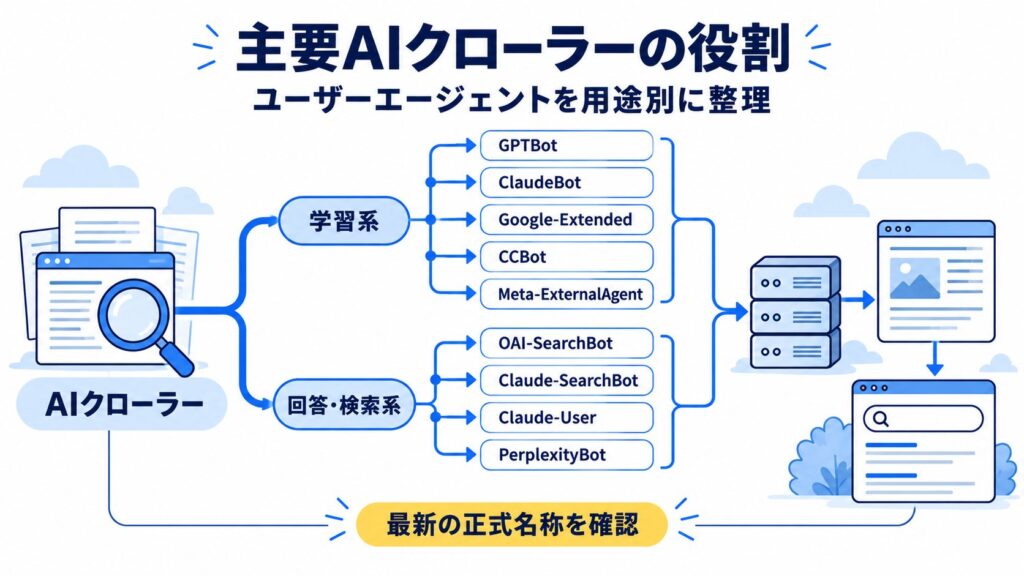
制御の前提として、誰を制御するのかを正確に知る必要があります。主要各社は用途別に複数のユーザーエージェント名を公開しており、しかも2026年に入って名称や役割が更新されています。
ここでは2026年時点の各社公式ドキュメントに基づき、OpenAI・Anthropic・Perplexity・Google・Common Crawl・Metaの主要ボットを役割別に整理します。
古いコピペの名称を使い続けると、意図と異なる制御になる点に注意してください。
OpenAIは3つのボットを使い分ける
OpenAIのGPTBotは学習に使われる可能性のあるデータの収集、OAI-SearchBotは検索、ChatGPT-Userはユーザー操作に伴う取得を担当します。
GPTBotとOAI-SearchBotは独立に制御できます。ChatGPT-Userにはrobots.txtが適用されない場合があり、すべて同じ挙動と考えないでください。
検索ボットの許可も引用を保証するものではありません。
Anthropicの現行ボットは3つ(重要)
ここは情報が古くなりやすい最重要ポイントです。
Anthropicの公式ドキュメント(2026年4月7日付)では、現在はClaudeBot(学習用)・Claude-User(ユーザーがClaudeに質問した際のリアルタイム取得)・Claude-SearchBot(Claudeの検索結果の品質向上用)の3つを運用しています(Anthropic公式ヘルプセンター)。
重要なのは、古いrobots.txtの例でよく見かける「Claude-Web」「anthropic-ai」は、この公式ページに載っていないという点です。
古い記事をコピーしてこの2つだけを記述しているrobots.txtは、最新のClaude-SearchBotやClaude-Userを取りこぼします。
引用・回答での露出を残したいなら、Claude-SearchBotとClaude-Userの扱いを必ず確認してください。
Claude向けの3つのボットの扱いは、ClaudeBot設定とClaude対策もあわせて確認しておきたいところです。
Claude-Webとanthropic-aiは、公式ページに載っていない名前です
主要ボットを一表で把握する
OpenAI・Anthropic以外の主要ボットも含めて整理します。
Perplexityは検索インデックス用のPerplexityBotと、ユーザー要求で動くPerplexity-Userを持ちます。
GoogleのGoogle-Extendedは生成AI(Gemini)の学習用です。
Common CrawlのCCBotは学習データの収集元として広く使われ、MetaのMeta-ExternalAgentは生成AI向けの収集を行います。下表が、役割と推奨スタンスの早見表です。
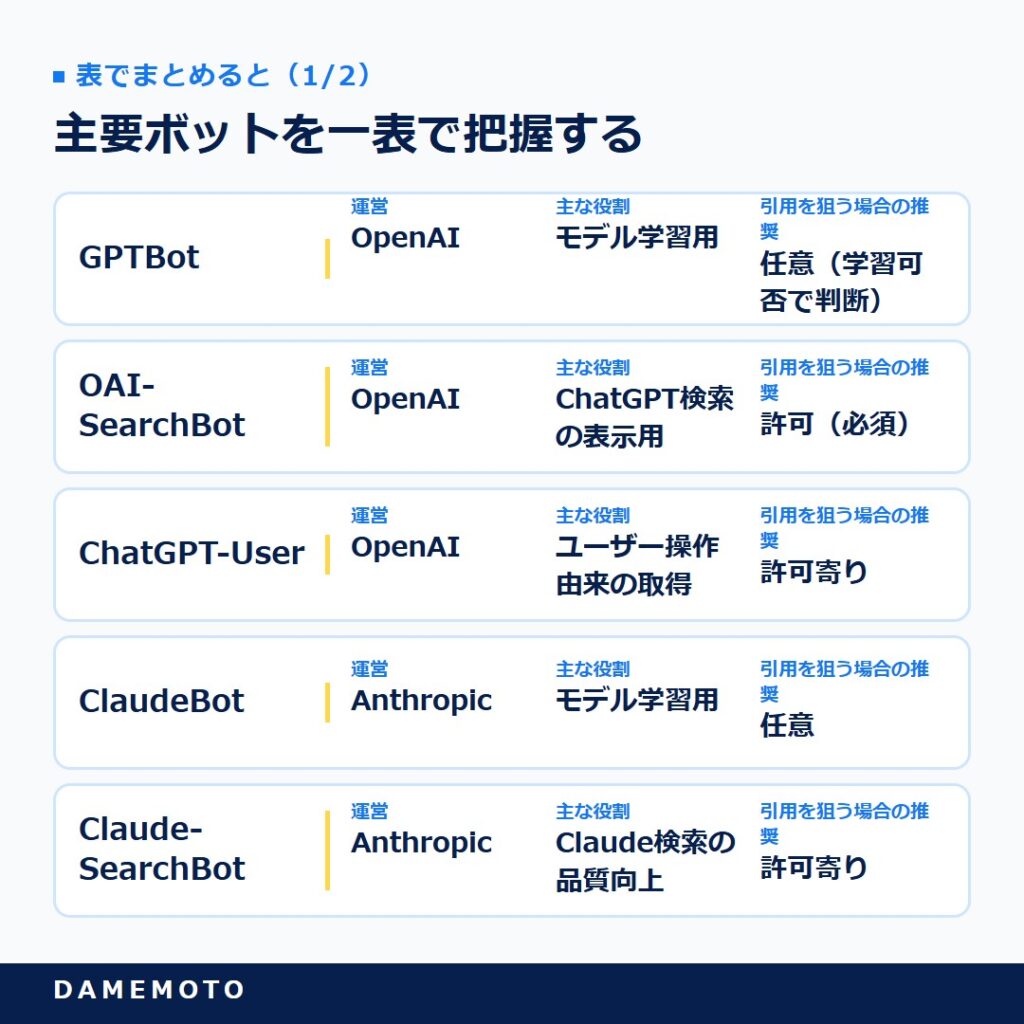
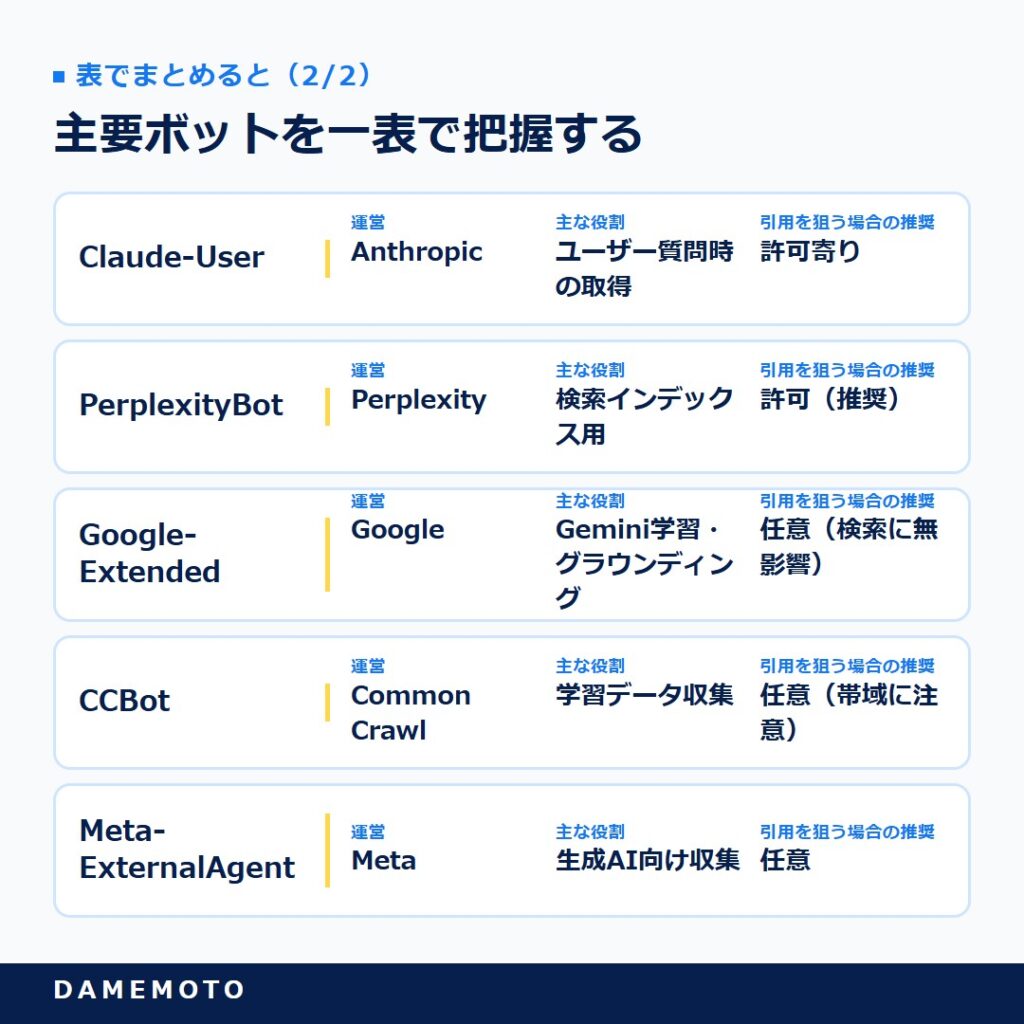
表で詳しく見る
| ユーザーエージェント | 運営 | 主な役割 | 引用を狙う場合の推奨 |
|---|---|---|---|
| GPTBot | OpenAI | モデル学習用 | 任意(学習可否で判断) |
| OAI-SearchBot | OpenAI | ChatGPT検索の表示用 | 許可(必須) |
| ChatGPT-User | OpenAI | ユーザー操作由来の取得 | 許可寄り |
| ClaudeBot | Anthropic | モデル学習用 | 任意 |
| Claude-SearchBot | Anthropic | Claude検索の品質向上 | 許可寄り |
| Claude-User | Anthropic | ユーザー質問時の取得 | 許可寄り |
| PerplexityBot | Perplexity | 検索インデックス用 | 許可(推奨) |
| Google-Extended | Gemini学習・グラウンディング | 任意(検索に無影響) | |
| CCBot | Common Crawl | 学習データ収集 | 任意(帯域に注意) |
| Meta-ExternalAgent | Meta | 生成AI向け収集 | 任意 |
※「Claude-Web」「anthropic-ai」は現在のAnthropic公式ヘルプセンターに記載がありません。
Perplexity-Userはユーザー操作に紐づくため通常のクローラーとは挙動が異なります(後述)。最新の正式名称は必ず各社公式で確認してください。
Google-Extendedをブロックしても検索は消えない
Google-ExtendedはHTTPで名乗る独立のボットではなく、Geminiなどでの学習・グラウンディング用途を制御するrobots.txtのトークンです。
Google検索の掲載やランキングを制御するものではありません。
Googlebotのクロール拒否だけではURLが検索から消えるとは限らないため、検索からの除外とクロール制限は分けて設計します。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
robots.txtの記述例:引用は歓迎・学習は制限(コピー可)
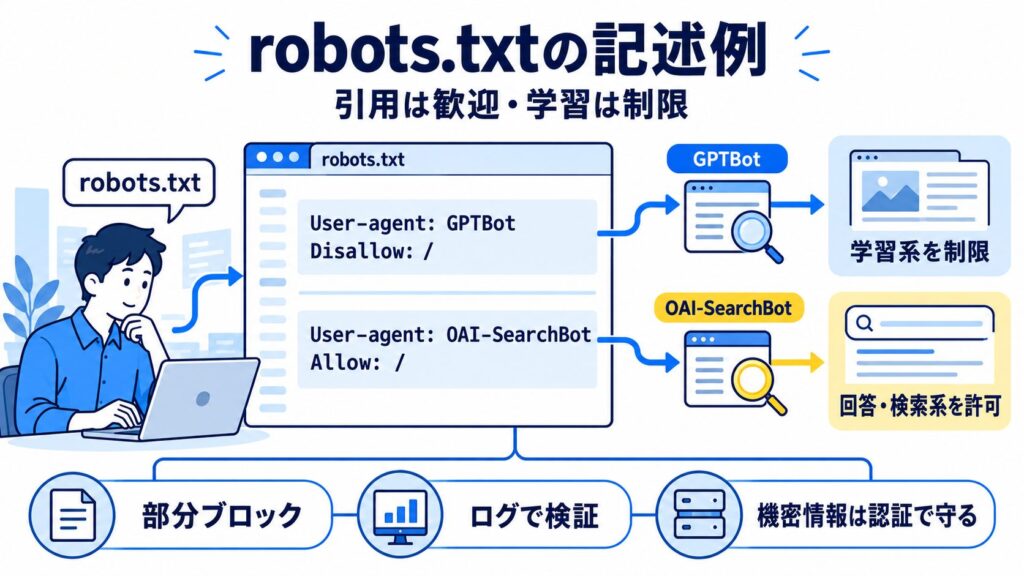
ここが本記事の置き土産です。「引用は歓迎・学習は制限」を実現する、そのままコピーして使えるrobots.txtの記述例を示します。
学習系(GPTBot・ClaudeBot・CCBot・Google-Extended・Meta-ExternalAgent)をDisallow、回答系(OAI-SearchBot・Claude-SearchBot・PerplexityBot)をAllowと書き分けるのが基本形です。
自社の方針に合わせて、Disallowする行を足し引きして調整してください。
基本の記述パターン(学習ブロック・引用許可)
下記が基本テンプレートです。ボットごとにUser-agentブロックを分けて記述します。コメント行(#)は説明用で、実ファイルでは省略しても構いません。
記述後は、Disallow行に意図しない「/」が混入していないか(サイト全体を遮断してしまう事故の原因)を必ず確認します。
# === 学習系ボットはブロック ===
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

# === 回答・検索系ボットは許可 ===
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# === 通常の検索エンジンは許可(Googlebotは絶対に止めない)===
User-agent: Googlebot
Allow: /

# サイトマップの場所
Sitemap: https://example.com/sitemap.xml
未知のボットやアクセス増加は、実際のログ、公式の識別方法、サーバー負荷で判断します。すべてのサイトで特定ボットが帯域の一定割合を消費するという共通値はありません。機密情報は認証で守り、アクセス制御と公開検索への掲載方針を分けます。
Googlebotだけは、何があっても止めないでください
プレミアムコンテンツは部分ブロックで守る
有料・会員限定コンテンツは、ボット別に部分ブロックできます。
たとえばGPTBotに対してAllow: /blog/とDisallow: /premium/を併記すれば、ブログ記事は学習に開放しつつ、有料コンテンツは保護できます。
マーケティング目的の公開記事は引用・学習に開放し、収益源となる独自コンテンツは守る、という使い分けです。
ただし前述のとおりrobots.txtは自主遵守のため、確実に守りたい有料領域は、robots.txtだけに頼らず認証で保護するのが鉄則です。
Perplexity-Userのように「robots.txtに従わない」例外を知る
ユーザー操作による取得の扱いは提供元で異なります。
Perplexity-Userは一般にrobots.txtを無視すると説明され、ChatGPT-Userも適用されない場合があります。
一方、AnthropicはClaude-Userを含む各ボットがrobots.txtに従うと説明しています。ユーザー起点という共通点だけで挙動を一括りにしないでください。
Perplexity側で引用を得る工夫は、Perplexity SEOの6つの実装術でまとめています。
設置後はログと引用状況を必ず検証する
設定後は、各社の公開ボット情報と照合してログを確認します。robots.txtのDisallowはクロール拒否であり、URLを必ずインデックスから除外する指定ではありません。
Googleでは現在のrobots.txtレポートとURL検査を使い、対象URLの実際の取得可否を確認します。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
AIクローラー対応の3ステップ
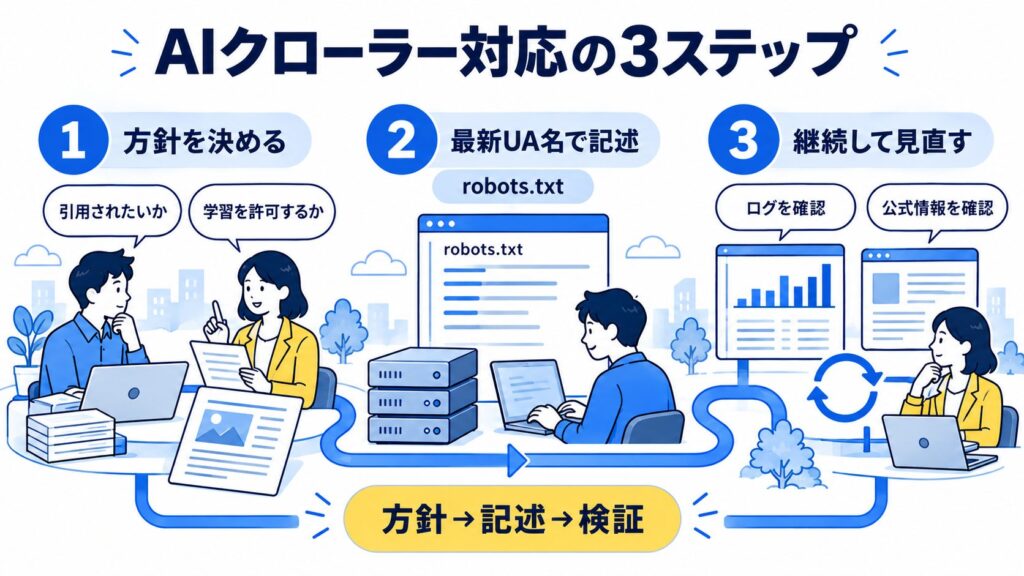
ここまでの内容を、実行手順の3ステップに落とし込みます。
第1に引用と学習の方針を言語化し、第2にボットごとにrobots.txtで許可・拒否を記述し、第3に設置後にログとAI検索の引用状況を検証します。
シンプルですが、この順番を守ることで「方針なき記述」や「検証なき放置」を防げます。クローラー設定の先にある施策は、LLMO対策完全ガイドを読むと順序をつかみやすくなるはずです。
ステップ1:引用と学習の方針を言語化する
最初に方針を言葉にします。「AI検索で引用されたいか(多くの場合YES)」「自社コンテンツを学習に使われてよいか(独自データが多いほどNO寄り)」の2問に答えるだけです。
この2軸が決まれば、各ボットを「許可」か「拒否」かに振り分ける基準が自動的に定まります。
経営判断として学習を全面的に拒否する選択もあり得ますが、その場合でも回答系(OAI-SearchBot等)まで止めないことが、AI露出を残す条件になります。
ステップ2:最新のUA名でボット別に記述する
次にrobots.txtを記述します。ここで決定的に重要なのが、各社の最新ドキュメントで正確なユーザーエージェント名を確認することです。
前述のとおりAnthropicの公式ヘルプセンターに載っているのはClaudeBot・Claude-User・Claude-SearchBotの3つで、Claude-Web・anthropic-aiは載っていません。
コピペのrobots.txtをそのまま使うと、古いボット名で意図と異なる制御になります。方針が明確で正しいUA名さえ分かっていれば、記述自体は数分で完了します。
前掲のテンプレートを土台に、自社の方針に合わせて調整してください。
DAMEMOTO代表鈴木古いコピペが、引用機会を静かに奪っています
ステップ3:四半期ごとの見直しを習慣化する
設置後の見直しが、引用機会を守り続ける鍵です。AIボットは2026年に入って頻繁に追加・変更されています。
Anthropicがボット体系を刷新し、Metaのボットが大量クロールを始め、新興のクローラーが次々と現れる——状況は流動的です。
四半期に1回程度、各社の公式ドキュメントを確認し、新ボットへの対応や役割変更を反映しましょう。
robots.txtは「一度書いて終わり」ではなく、継続的にメンテナンスする運用ファイルです。
古いまま放置されたrobots.txtが、知らぬ間に引用機会を取りこぼしている——これが最も避けたい状態です。
正直に言うと:AIクローラー制御が「不要・逆効果」な場合
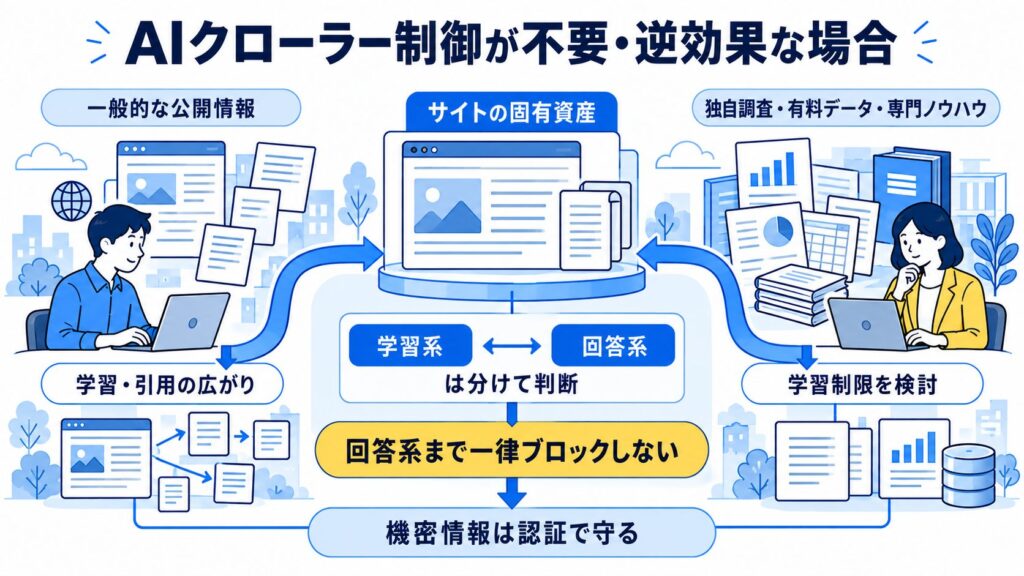
制御を勧める記事は多いですが、誇張を避けるために「神経質になる必要がない場合」「やり方を誤ると逆効果な場合」も正直に書いておきます。すべてのサイトが学習ブロックに走るべきではありません。
学習ブロックがほぼ不要なサイトもある
正直なところ、独自データや収益源コンテンツを持たない一般的なサイトでは、学習系のブロックに神経質になるリターンは小さいです。
むしろAIに広く学習・引用され、ブランド名やサービス名が想起されることがプラスに働く場面も多くあります。
「とりあえずGPTBotをブロック」が思考停止になっていないか、一度立ち止まる価値があります。
学習ブロックが本当に効くのは、独自調査・有料データ・専門ノウハウなど「学習されると競争上不利になる固有資産」を持つサイトです。
最も多い失敗は「回答系まで一律ブロック」
学習用と検索用の用途は分けて設定します。検索ボットの拒否は掲載機会を狭める可能性がありますが、他の取得経路やユーザー操作もあるため、「すべてのAIから一切消える」とは保証できません。機密性を守る場合は認証・アクセス制限を使用します。
本記事で「保証できないこと」
正確を期すため、断言できないことも明示します。robots.txtは自主遵守の仕組みであり、本記事のテンプレートを設置しても、すべてのボットが必ず従う保証はありません。
Bytespiderのようにrobots.txtを無視するボットも存在します。また、各社のユーザーエージェント名や役割は今後も変わり得ます。
本記事は2026年6月時点の各社公式情報に基づいていますが、実装前には必ず最新の公式ドキュメントを確認し、機密情報はrobots.txtではなく認証で守ってください。
robots.txtと混同されやすいllms.txtの役割は、llms.txtの書き方と設置方法で整理しています。
独自整理:クローラーは「学習=任意・回答=必ず許可」で考える
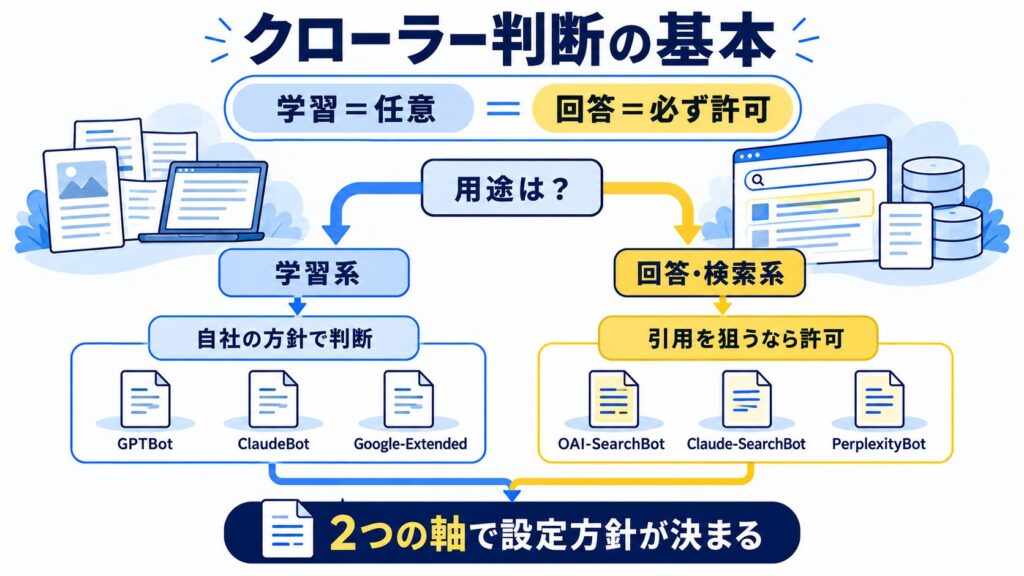
AIクローラー制御は種類が多く混乱しがちですが、判断軸はシンプルに圧縮できます。
「学習に使われるか(任意で判断)」「引用・回答に使われるか(引用したいなら必ず許可)」の2つだけです。
下表で主要クローラーをこの軸に振り分けると、robots.txtの設定方針が一目で決まります。前掲の記述例とセットで使える、意思決定の早見表です。
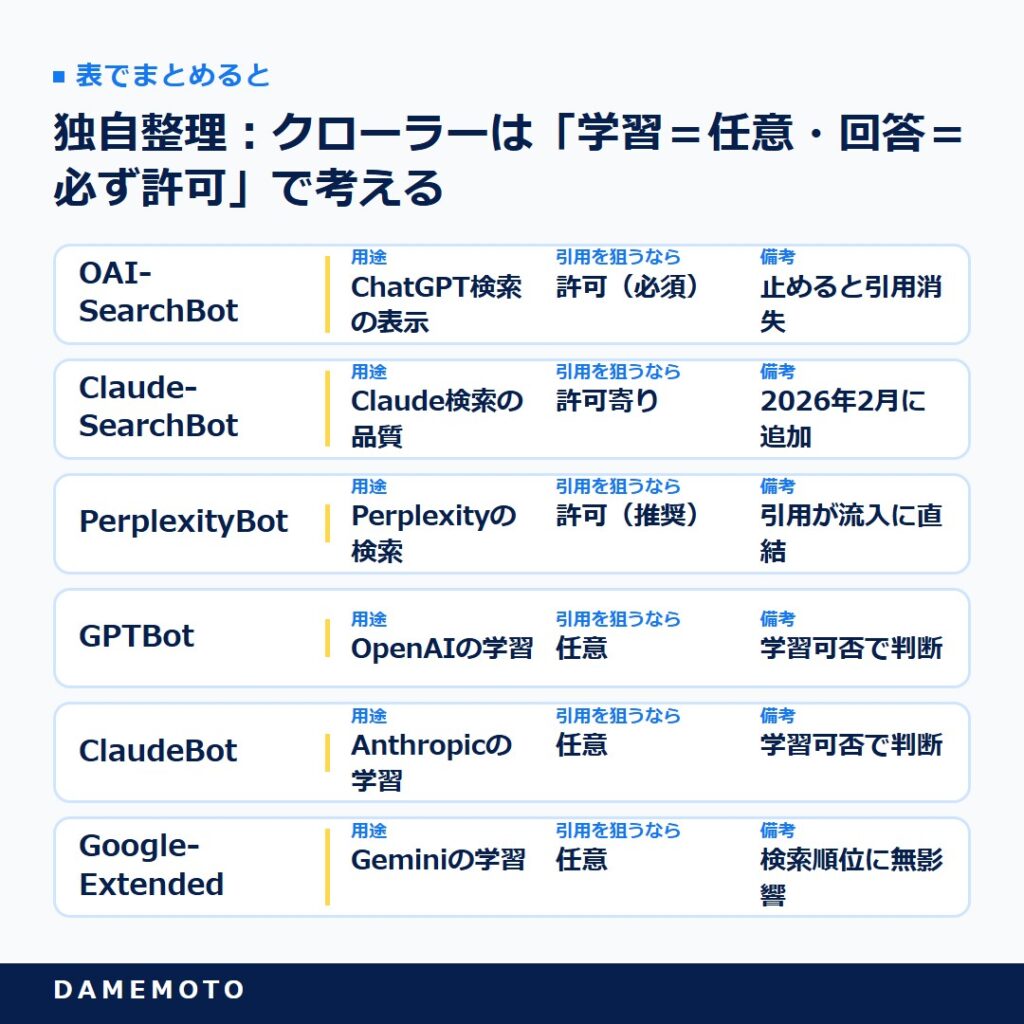
表で詳しく見る
| クローラー | 用途 | 引用を狙うなら | 備考 |
|---|---|---|---|
| OAI-SearchBot | ChatGPT検索の表示 | 許可(必須) | 止めると引用消失 |
| Claude-SearchBot | Claude検索の品質 | 許可寄り | 2026年2月に追加 |
| PerplexityBot | Perplexityの検索 | 許可(推奨) | 引用が流入に直結 |
| GPTBot | OpenAIの学習 | 任意 | 学習可否で判断 |
| ClaudeBot | Anthropicの学習 | 任意 | 学習可否で判断 |
| Google-Extended | Geminiの学習 | 任意 | 検索順位に無影響 |
この表の使い方はこうです。
まず「引用を狙うなら許可」の3行(OAI-SearchBot・Claude-SearchBot・PerplexityBot)は、よほどの理由がない限りAllowにする。
残りの学習系3行は、独自資産の有無で各社の経営判断としてDisallowを検討する。たったこれだけで、AIクローラー制御の8割は設計できます。
残りの2割が、新興ボットへの追従と定期的な見直しです。OAI-SearchBotを許可した後の記事側の条件は、ChatGPT検索で引用される5つの要件で整理しています。
よくある質問
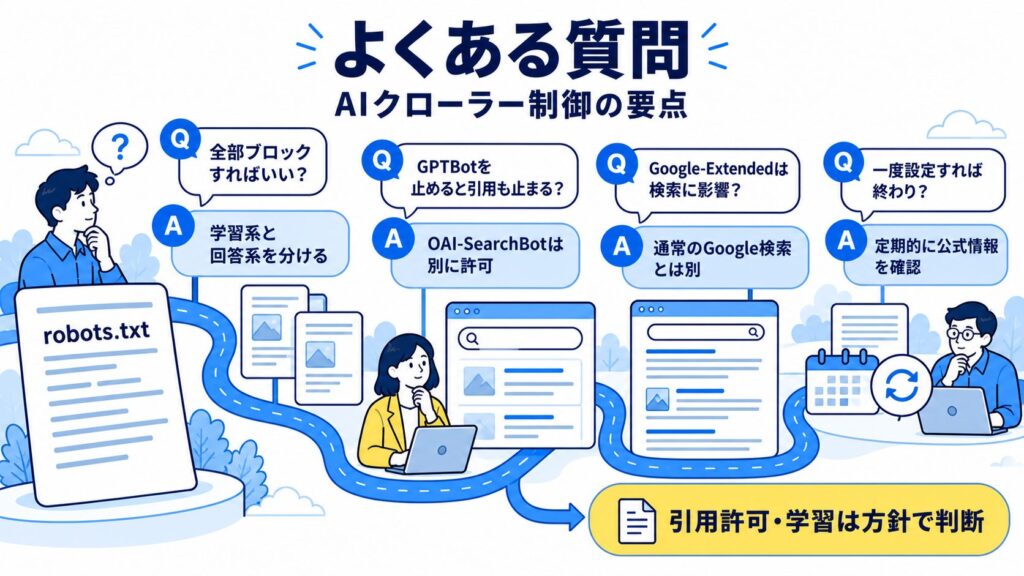
- AIクローラーはどうやって制御しますか?
-
robots.txtにボットごとのUser-agentブロックを作り、許可(Allow)と拒否(Disallow)を記述します。「学習系はブロック・回答系は許可」と切り分けるのが基本です。
- AIクローラーは全部ブロックすればいいですか?
-
非推奨です。一律ブロックはAI検索の引用機会まで失います。学習系をブロックし、回答系(OAI-SearchBot等)を許可する分離設定が現実的です。
- GPTBotをブロックすると引用されなくなりますか?
-
なりません。GPTBotは学習用です。OAI-SearchBotを許可していれば、GPTBotをブロックしてもChatGPT検索には表示され続けます。
- Claude-Webやanthropic-aiはまだ使えますか?
-
どちらもAnthropicの公式ヘルプセンターには載っていない名前です。現在のAnthropicの主要ボットはClaudeBot(学習)・Claude-User(ユーザー質問)・Claude-SearchBot(検索品質)の3つです。robots.txtはこの最新名で見直してください。
- Google-Extendedをブロックして大丈夫ですか?
-
大丈夫です。これはGemini学習用で、ブロックしても通常のGoogle検索の掲載・順位には影響しません。AI OverviewsはGooglebotのインデックスを使うため、こちらからも除外されません。Googlebotは絶対に止めないでください。
- AIクローラーはrobots.txtを必ず守りますか?
-
必ずではありません。RFC 9309という標準ですが本質は自主遵守で、主要AIは尊重する一方、Bytespider等の無視するボットもあります。機密情報は認証で守る必要があります。
- どのAIクローラーを許可すべきですか?
-
回答・検索系のOAI-SearchBot・Claude-SearchBot・PerplexityBotです。AI検索の引用に直接関わるため、引用を狙うなら許可します。
- AIクローラーの設定後は何を確認しますか?
-
アクセスログをユーザーエージェント別に集計し、学習系と回答系の比率を見ます。AI検索での引用状況も手動確認し、Disallow: /の誤記がないかをSearch Consoleで検証します。
- AIクローラーの設定は一度で終わりですか?
-
終わりません。ボットは頻繁に追加・変更されます(Anthropicのボット体系の変化やMeta系の台頭など)。四半期ごとに各社の公式ドキュメントを確認し、robots.txtを更新します。
まとめ:AIクローラーは「学習ブロック・引用許可」で制御する
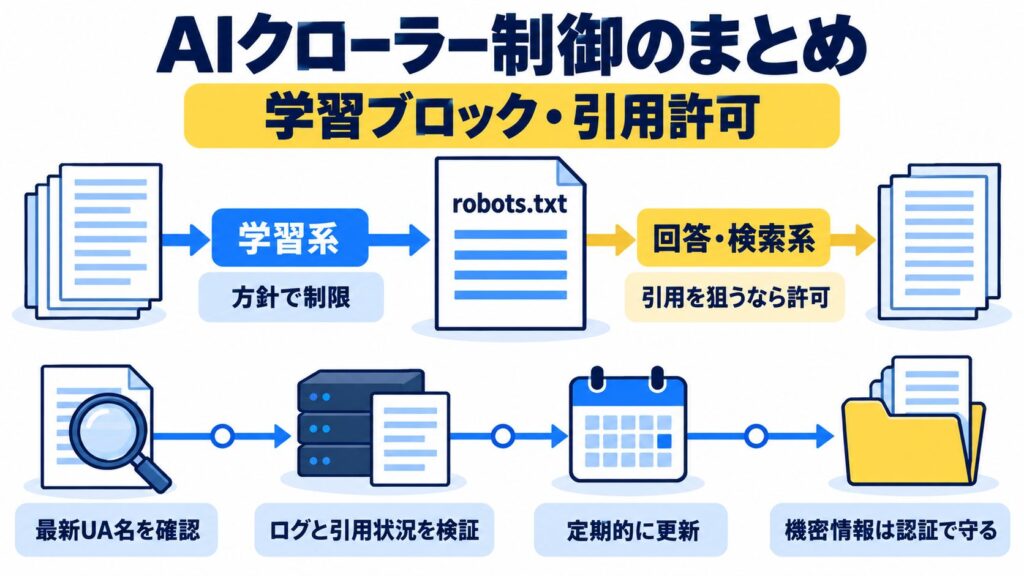
AIクローラー制御の核は、robots.txtで学習系(GPTBot・ClaudeBot・CCBot・Google-Extended・Meta-ExternalAgent)をブロックし、回答系(OAI-SearchBot・Claude-SearchBot・PerplexityBot)を許可することです。
Anthropicの現行ボットはClaudeBot・Claude-User・Claude-SearchBotの3つで、Claude-Web・anthropic-aiは公式ページに載っていない点に注意してください。
Google-Extendedはブロックしても検索に影響しません。robots.txtは自主遵守のため機密は認証で守り、四半期ごとに公式ドキュメントを確認して更新します。
「引用は歓迎・学習は制限」が、多くの企業の現実解です。
- 学習ブロック・引用許可で設計
- OAI-SearchBotとGooglebotは守る
- 最新UA名で四半期ごとに更新
参考URL一覧
- OpenAI・クローラー一覧(GPTBot/OAI-SearchBot/ChatGPT-User)公式:https://platform.openai.com/docs/bots
- Anthropic・Claudeのクロールとブロック方法(公式ヘルプ):https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
- Perplexity・ボット解説(PerplexityBot/Perplexity-User)公式:https://docs.perplexity.ai/guides/bots
- IETF・RFC 9309 Robots Exclusion Protocol(robots.txt標準):https://www.rfc-editor.org/rfc/rfc9309.html
- Search Engine Land・Anthropicがクローラー仕様を明確化:https://searchengineland.com/anthropic-claude-bots-470171
- Search Engine Roundtable・Anthropicがクローラー文書を更新:https://www.seroundtable.com/anthropic-updates-its-crawler-docs-40978.html
補足参考資料