Microsoftは2026年10月30日(米国時間)、Bingの公式ブログで、サイトのコンテンツを「AIの学習(AI Training)」に使うかと、「AIの回答づくり(AI Grounding)」に使うかを、別々に選べる新しい設定を発表しました。
学習は断りつつ、CopilotなどのAIの回答には使ってもらう、という選び方ができます。
AI学習をrobots.txtで一括して断ってきたBtoB企業のSEO担当者と、NoArchive・NoCacheでAIへの利用を止めてきたサイトの担当者にとって、「何を断り、何を残すか」を用途ごとに決め直すきっかけになるニュースです。
この記事のポイント
- BingのAI向けの設定は「AI Training(学習)」と「AI Grounding(回答への利用)」の2つに分かれ、別々に選べる。通常のBing検索への掲載資格は変わらない
- 学習はrobots.txtの共通トークン「__usage_ai-training」とページ単位で設定できる。回答への利用はページ単位だけで、robots.txtでは設定できない
- 適用は2027年2月1日から。NoArchive・NoCacheを使っているサイトは2027年3月1日までに移行が必要で、Bing Webmaster Toolsの暫定設定は2026年12月15日に始まる
- 共通シグナルはMicrosoftも採用。Anthropicは「実装を始めた」とドラフトの著者がIETFのメーリングリストに投稿した
本記事は、Bingの公式ブログ(2026年10月30日)を一次情報とし、IETFのドラフトと著者のメーリングリスト投稿、Google・OpenAIの公式発表、The VergeとSearch Engine Roundtableの報道で照らし合わせました。
10月31日朝のrobots.txtでAI学習を断る共通シグナルの記事の続報として、設定の中身、書き方、移行の日程、各社の対応状況、読者ごとの影響の順に見ていきます。情報は2026年10月31日夜時点のものです。
BingがAIの学習と回答への利用を分けて選べるようにした
「AIに学習はされたくない。でも、Copilotの回答で自社の記事が紹介されないのは困る」。そんな板ばさみを感じていた担当者は多いですよね。今回のBingの発表は、まさにその2つを切り離すものです。
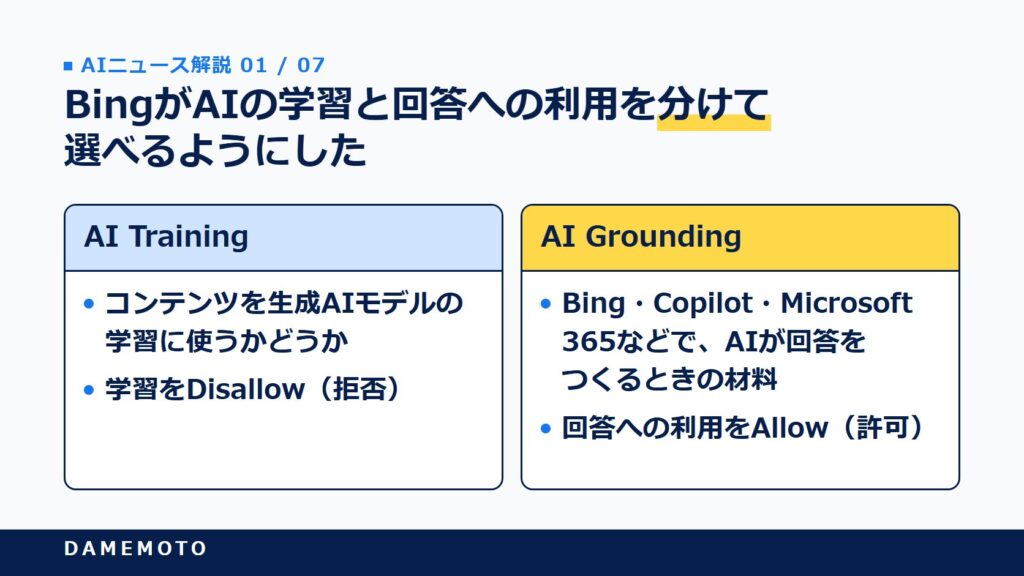
設定は「AI Training」と「AI Grounding」の2つ
Bingの公式ブログ(著者はMicrosoft BingのプリンシパルプロダクトマネージャーのKrishna Madhavan氏)によると、新しい設定は2つです。
AI Trainingは、コンテンツを生成AIモデルの学習に使うかどうか。
AI Groundingは、Bing・Copilot・Microsoft 365などで、AIが回答をつくるときの材料としてコンテンツを使うかどうかです。
2つは独立していて、学習の設定を変えても回答への利用の設定は変わりません。
公式ブログは、学習をDisallow(拒否)、回答への利用をAllow(許可)にすれば、回答に使われる資格を保ったまま学習には使わせない、という例を挙げています。
どちらも、何も書かなければAllowとして扱われます。
通常のBing検索への掲載は変わらない
気になるのは検索順位への影響ですよね。公式ブログは、これらの設定は通常のBing検索結果に載る資格を変えないと書いています(通常のクロールとインデックスの条件は従来どおり)。
通常の検索のインデックスや順位づけは、AI Groundingには当たらないという整理です。順位そのものへの影響については、公式ブログは触れていません。
一方で、Microsoftははっきり注意も添えています。回答への利用をDisallowやDisallowExtendedにすると、AIの体験でのブランドの露出は減るという警告です。
どの選択も、掲載・流入・支払いを保証するものではないとも書いています。断れば守れる、とは限らないところが悩ましいですね。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
設定の書き方:robots.txtとページ単位の違い
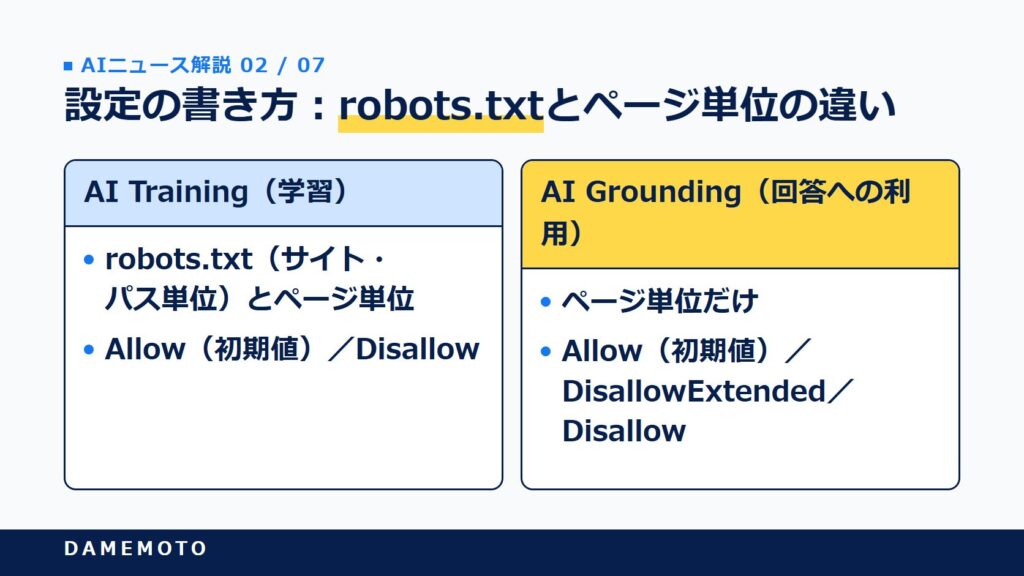
ここがいちばん間違えやすいところです。2つの設定は、書ける場所が違います。先に全体を表で押さえておきたいところです。
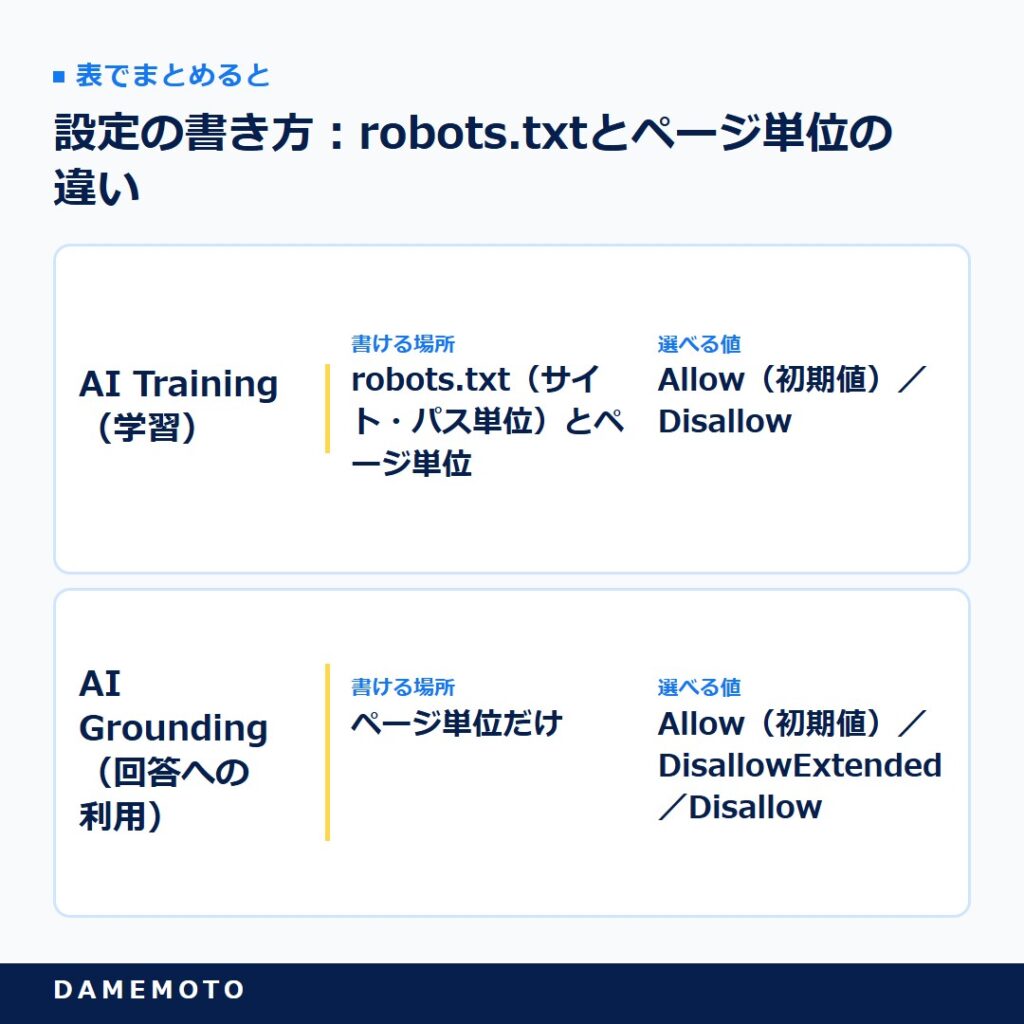
表で詳しく見る
| 設定 | 書ける場所 | 選べる値 |
|---|---|---|
| AI Training(学習) | robots.txt(サイト・パス単位)とページ単位 | Allow(初期値)/Disallow |
| AI Grounding(回答への利用) | ページ単位だけ | Allow(初期値)/DisallowExtended/Disallow |
学習はrobots.txtの共通トークンで断れる
学習の設定は、robots.txtに共通トークン「__usage_ai-training」のグループを書く形です。公式ブログの例では、サイト全体の学習を断るとき、次のように書きます。
User-Agent: __usage_ai-training
Disallow: /
特定のディレクトリだけ断るなら「Disallow: /example-path/」のようにパスを書きます。
Microsoftはこの設定をページ単位にも広げていて、metaタグなら「<meta name=”Bingbot” content=”ai-training:disallow”>」、HTTPヘッダーなら「X-Robots-Tag: Bingbot: ai-training:disallow」です。
ページ単位の学習の設定は、robots.txtの設定より優先されます。
回答への利用はページ単位だけ
AI Groundingは、Microsoft独自のページ単位の設定です。robots.txtでサイト全体に回答への利用を断る書き方はありません。
metaタグなら「content=”ai-grounding:disallow”」、HTTPヘッダーなら「X-Robots-Tag: Bingbot: ai-grounding:disallow」と書きます。
新しい値のDisallowExtendedは「ai-grounding:disallowextended」と書きます。
DisallowExtendedは、AI Mode・AI Overview・Copilot・Microsoft 365といったMicrosoftが運営する体験では回答に使ってよく、他社向けのサービスには使わせない設定です。
他社向けとして名前が挙がっているのは、Web IQと、FoundryのAPI経由のグラウンディングです。
なお、これは「使い方」の希望で、クロールの可否ではありません。robots.txtでBingbotを止めていれば、Allowを書いても停止は覆りません。設定はMicrosoftがページを再クロールして初めて読み取られます。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
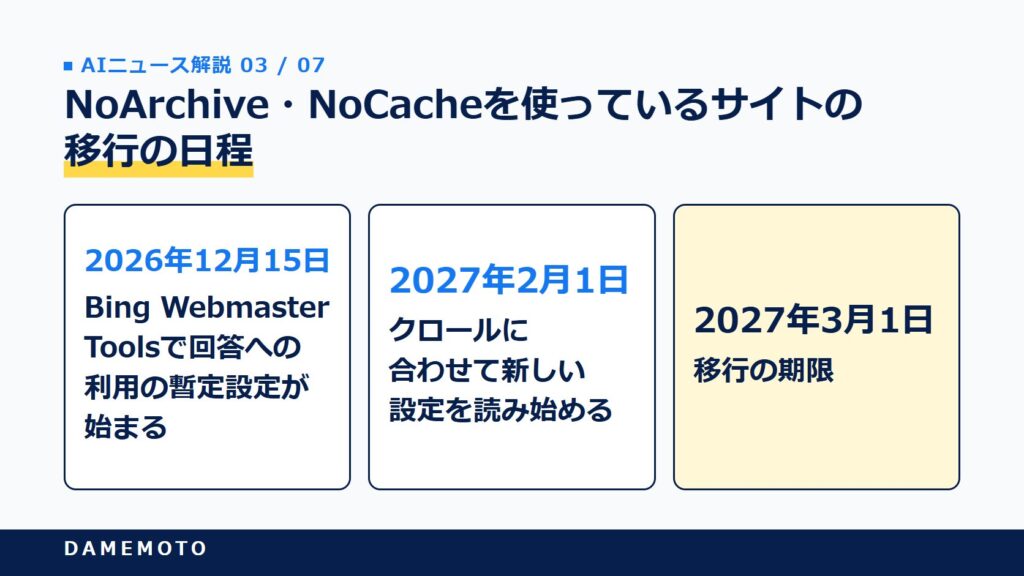
NoArchive・NoCacheを使っているサイトの移行の日程
Microsoftは2023年に、NoArchiveとNoCacheのタグでAIの学習と回答への利用を制御できるようにしていました。
今回の新しい設定は、学習と回答への利用については、この2つを置き換えます。古いタグで止めていたサイトは、日程を確かめておきたいですね。
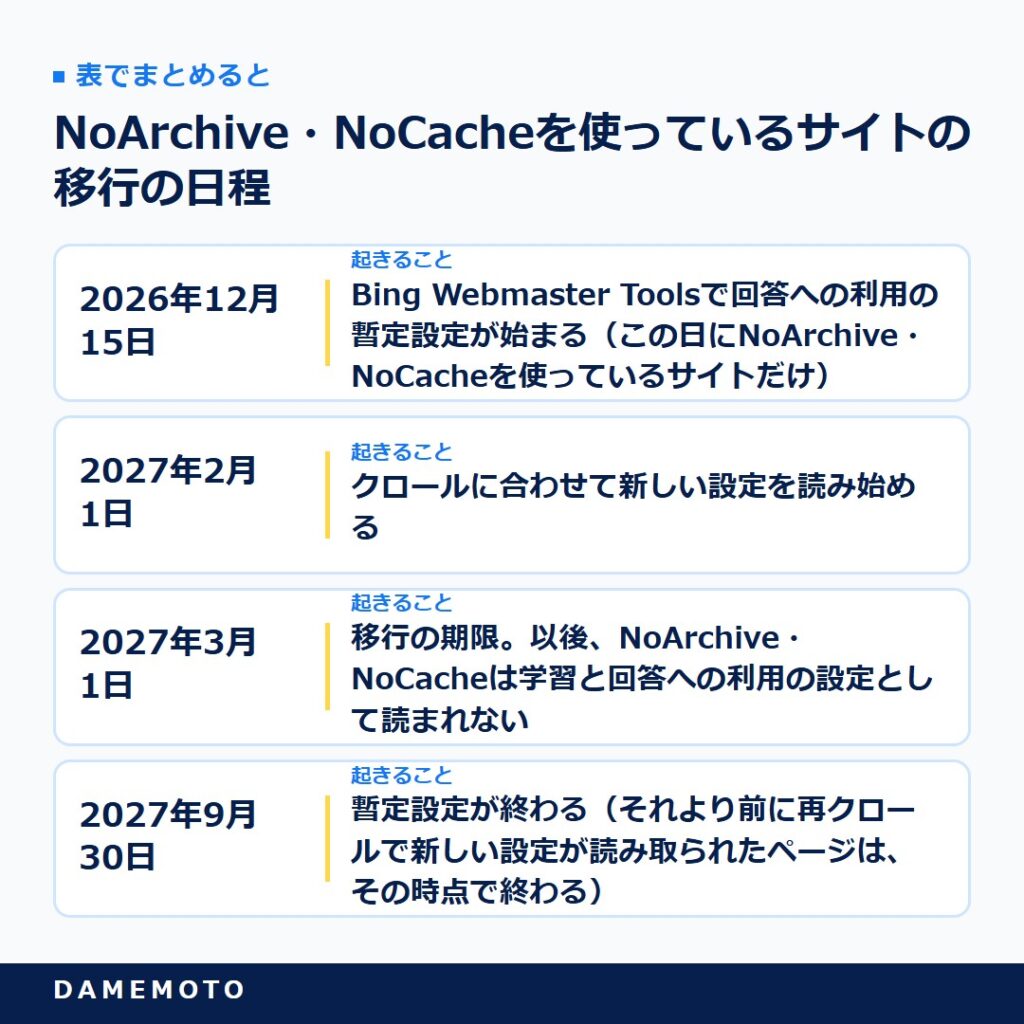
表で詳しく見る
| 日付 | 起きること |
|---|---|
| 2026年12月15日 | Bing Webmaster Toolsで回答への利用の暫定設定が始まる(この日にNoArchive・NoCacheを使っているサイトだけ) |
| 2027年2月1日 | クロールに合わせて新しい設定を読み始める |
| 2027年3月1日 | 移行の期限。以後、NoArchive・NoCacheは学習と回答への利用の設定として読まれない |
| 2027年9月30日 | 暫定設定が終わる(それより前に再クロールで新しい設定が読み取られたページは、その時点で終わる) |
学習とAI回答で、移行のやり方が違う
学習の設定は、2027年3月1日までにrobots.txtかページに書きます。Bing Webmaster Toolsには学習の暫定設定がありません。
回答への利用は、各ページにAI Groundingを書くことに加えて、Bing Webmaster Toolsに暫定の設定を記録します。
2026年12月15日の時点でNoArchive・NoCacheを使っていないサイトは、移行の作業はいりません。新しい設定を見つけたサイトでは、残っているNoArchive・NoCacheは無視されます。
記録しないと、回答への利用は「許可」に戻る
見落としやすいのはここです。
2027年3月1日までにBing Webmaster Toolsへ暫定の設定を記録しないと、NoArchive・NoCacheのページは、再クロールされるまで回答への利用がAllow扱いになります。
いまは止めているつもりのページが、期限のあとに回答へ使われうるということです。
3月1日より後にページへ書いた設定も、再クロールで有効になりえます。ただし、いつ再クロールされるかは保証されない、と公式ブログは書いています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
共通シグナルの各社の対応状況(10月31日朝からの更新)
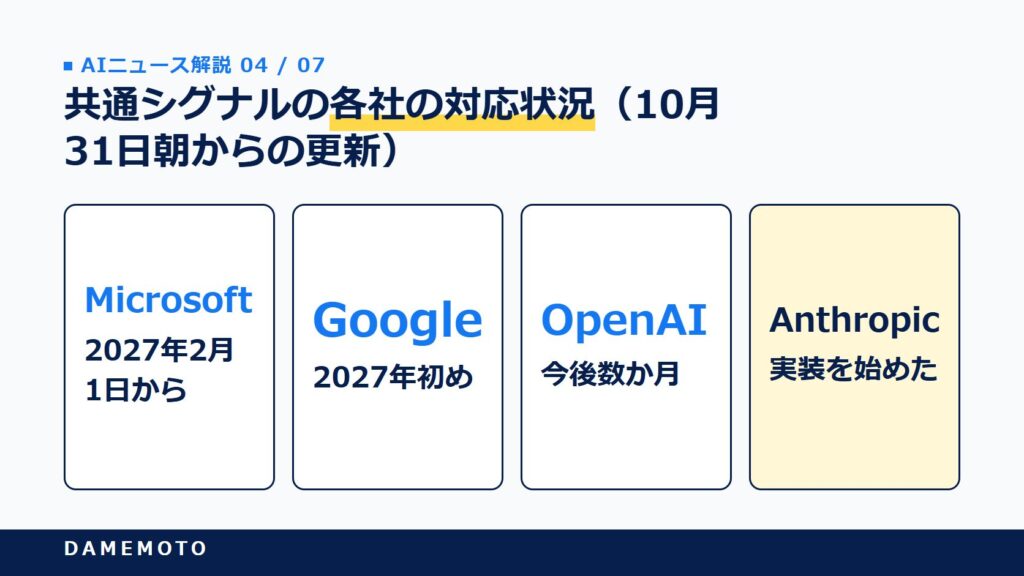
朝の記事のあとで分かったことがあります。前の記事で「確認できていない」と書いた点を中心に、更新しておきます。
Microsoftも共通トークンを使うと確認できた
朝の記事では、Microsoftの公式ブログの本文とrobots.txtで使うトークン名を確認できていない、と書きました。
Bingの公式ブログを確かめたところ、学習の設定は共通トークン「__usage_ai-training」で書く例が載っていました。
公式ブログは、IETFのAI Preferencesワーキンググループの作業はまだ最終の標準に向けて続いているものの、いまの成果は採用に値すると書いています。
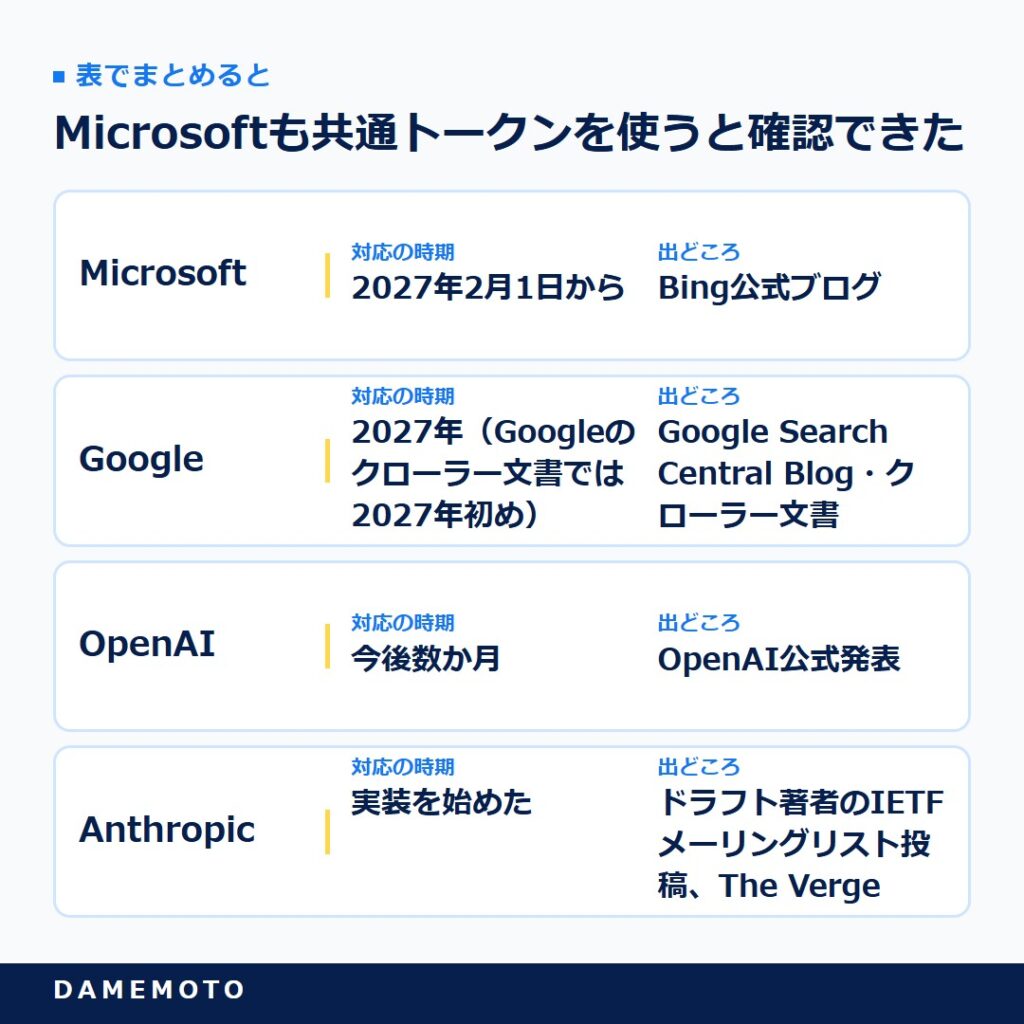
表で詳しく見る
| 会社 | 対応の時期 | 出どころ |
|---|---|---|
| Microsoft | 2027年2月1日から | Bing公式ブログ |
| 2027年(Googleのクローラー文書では2027年初め) | Google Search Central Blog・クローラー文書 | |
| OpenAI | 今後数か月 | OpenAI公式発表 |
| Anthropic | 実装を始めた | ドラフト著者のIETFメーリングリスト投稿、The Verge |
Anthropicは「実装を始めた」とドラフトの著者が投稿
共通シグナルを定めるIETFのドラフトを書いたのは、AnthropicのKevin Kelley氏です。
Kelley氏は2026年10月30日(日本時間31日0時39分)、IETFのメーリングリストへの投稿で、Anthropicがこのドラフトへの対応の実装をすでに始めたと書きました。
既存のクローラーの制御を置き換えるのではなく補うもので、全サービスへの対応には時間がかかるとしています。
The Verge(10月30日)も、Anthropicはすでにシグナルを採用したと報じています。
ただし、2026年10月31日時点で、Anthropicの公式サイトのクローラーの説明に共通シグナルの記載は見当たりません。
会社の公式の告知ではなく、担当者の投稿と報道で分かっている段階です。
確定していること・まだ分からないこと
確定しているのは、Bingの2つの設定の中身、書き方、日程、そしてMicrosoftが共通トークンを採用することです。
ドラフトは、「User-Agent: *」のグループは共通トークンに当たらないと定めています。
つまり全クローラー向けの記述で一括して断っていても、共通シグナルとしては意向なしの扱いです。
まだ分からないのは、Bing Webmaster Toolsの画面での具体的な操作(解説のページの本文を読めませんでした)と、日本のサイトでの扱いを明言した記述です。
The Vergeは「共通トークンを見つけたらAIクローラーのアクセスを制限する」と書いていますが、ドラフトは「クロールの指示ではない」としています。
この記事ではドラフトの文言を優先しました。ドラフトはIETFが承認したものではなく、正式な地位はありません。
このニュースで誰の何が変わるのか
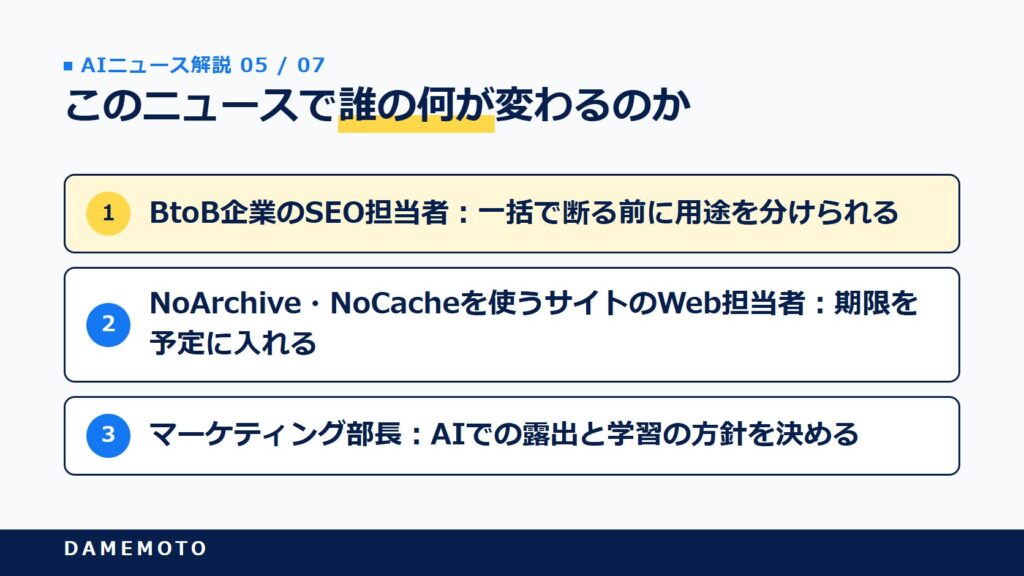
影響が大きいのは、robots.txtやmetaタグを管理する人と、AIでの露出をどう扱うかを決める人です。3人の立場で見ていこう。
BtoB企業のSEO担当者:一括で断る前に用途を分けられる
SEO担当者の悩みは、学習は断りたいのに、Copilotでの紹介まで消えるのは困る、という点ではないでしょうか。
今回のBingの設定なら、学習はrobots.txtの共通トークンで断り、回答への利用はAllowのまま残せます。
「全部断る」か「全部許す」かの二択から、用途ごとに選ぶ形に変わります。
明日からやることは2つです。まず今のrobots.txtで、BingbotやAIクローラーを「User-Agent: *」でまとめて止めていないかを確かめること。
次に、学習と回答への利用を、自社としてそれぞれどうしたいかを一行で書き出すことです。AIクローラーの名前と書き方はAIクローラー制御のrobots.txt記述例にまとめています。
2027年に各社の対応がそろえば、学習と回答を分けた設定が当たり前になっていくと考えられます。
NoArchive・NoCacheを使うサイトのWeb担当者:期限を予定に入れる
以前、AIへの利用を止めるためにNoArchiveやNoCacheを入れたサイトもありますよね。
困るのは、そのまま放っておくと、期限のあとに回答への利用がAllowへ戻ってしまう点です。
2027年3月1日までに、ページへの設定とBing Webmaster Toolsへの記録の両方が要ります。
明日からやることは、NoArchive・NoCacheを入れているページを洗い出し、2026年12月15日と2027年3月1日を作業の予定に入れることです。
CMSでページごとのmetaタグを出しにくいなら、HTTPヘッダーで出せるかを制作会社やサーバーの担当に先に聞いておくと安心です。
数か月のうちに、AI向けの設定はページの公開時に決めておく項目の1つになっていく可能性があります。
マーケティング部長:AIでの露出と学習の方針を決める
部長の悩みは、現場から「断るべきですか」と聞かれても判断の材料がないことかもしれませんね。今回、Microsoft自身が、回答への利用を断るとAIでのブランドの露出は減ると明言しました。断ることにも損があると、はっきりしたわけです。
明日からやることは、会社としての方針を決めておくことです。たとえば「学習は断る、回答への利用は残す、有料レポートのページだけ両方断る」といった形です。
方針が先にあれば、現場は2027年の期限までに書き方をそろえるだけで済みます。Copilotでの見え方を高める施策はCopilot対策の記事で紹介しています。
1年ほどで、AIへのコンテンツの出し方は、広報やブランドの方針の一部として扱われるようになると考えられます。
よくある質問
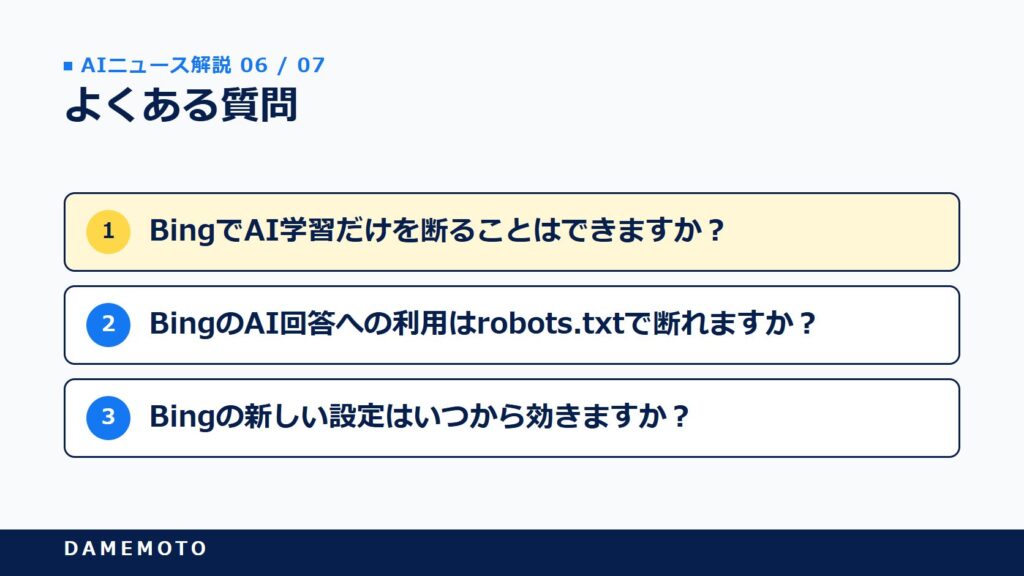
- BingでAI学習だけを断ることはできますか?
-
できます。AI Trainingを拒否、AI Groundingを許可にすれば、学習には使わせず、回答に使われる資格は残せます。Bingの公式ブログが、この組み合わせを例として挙げています。
- AI学習を断るとBingの検索順位は下がりますか?
-
Bingの公式ブログは、新しい設定は通常のBing検索結果に載る資格を変えないと書いています。順位そのものへの影響には触れていません。ただし、回答への利用を断ると、AIの体験でのブランドの露出は減るとしています。
- BingのAI回答への利用はrobots.txtで断れますか?
-
断れません。AI Groundingはページ単位の設定だけで、metaタグかHTTPヘッダー(X-Robots-Tag)で書きます。robots.txtで書けるのは学習の設定です。
- Bingの新しい設定はいつから効きますか?
-
2027年2月1日から、Microsoftがクロールするのに合わせて読み取られます。書いてもすぐには効かず、ページが再クロールされて初めて有効になります。
- NoArchiveを使っているとBingで何が必要ですか?
-
2027年3月1日までに、学習の設定をrobots.txtかページに書き、回答への利用の設定をページに書いたうえでBing Webmaster Toolsに暫定の設定を記録します。記録しないと、再クロールまで回答への利用は許可の扱いになります。
- DisallowExtendedはBingで何を断る設定ですか?
-
Microsoftが他社向けに提供する回答づくりのサービス(Web IQ、FoundryのAPI経由のグラウンディング)での利用を断る設定です。Copilot・Microsoft 365などMicrosoftが運営する体験では、回答に使われることがあります。
- User-Agent: *で断っていればAI学習も断れていますか?
-
共通シグナルとしては断れていません。IETFのドラフトは、「User-Agent: *」のグループを共通トークンとして扱ってはならないと定めています。学習を断るなら「User-Agent: __usage_ai-training」のグループを書きます。
まとめ
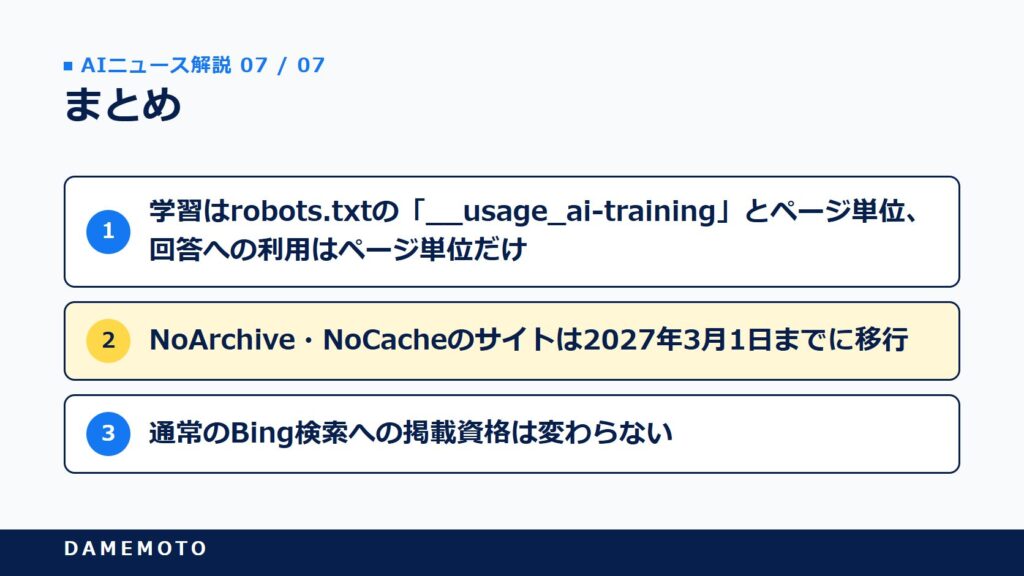
Microsoftは2026年10月30日(米国時間)、BingでAIの学習と回答への利用を別々に選べる設定を発表しました。2027年2月1日からクロールに合わせて読み取られます。
- 学習はrobots.txtの「__usage_ai-training」とページ単位、回答への利用はページ単位だけ
- NoArchive・NoCacheのサイトは2027年3月1日までに移行。記録しないと回答への利用は許可の扱いに戻る
- 通常のBing検索への掲載資格は変わらない。回答への利用を断るとAIでの露出は減る
断るか許すかを一度に決めるのではなく、学習と回答への利用を分けて考えられるようになったのが、今回いちばんの変化だと思います。まずは自社のrobots.txtとNoArchiveの使い方を確かめるところから始めていこう。
参考・出典
- Bing Blogs「Your content, your choice: clearer preferences for training and grounding」(2026年10月30日)
- IETF「draft-kelley-aipref-training-preference-signal-00」(2026年10月30日)
- IETF ai-control メーリングリスト「New draft: draft-kelley-aipref-training-preference-signal-00」(2026年10月30日)
- Google Search Central Blog「Supporting a shared AI training control for websites」(2026年10月30日)
- Google「Google’s common crawlers」
- OpenAI「Making it easier for websites to express AI training preferences」(2026年10月30日)
- The Verge(2026年10月30日)
- Search Engine Roundtable(2026年10月30日)






