Cloudflareは米国時間2026年10月26日、AIの推論サービス「Workers AI」で提供しているモデル「GLM-5.3」について、2026年8月27日から9月9日のあいだに、他の顧客のデータを含む応答が計155件返っていたと公表しました。
原因は推論基盤の設定ミスと、オープンソースの推論エンジン「SGLang」のバグの重なりで、悪用の証拠は見つかっていないとしています。
AIのAPIやツールに社内の情報を入れているマーケティング担当者や、導入を承認する立場の部長・経営層にとっては、「学習に使わない」という約束だけでは確かめきれない点があることを示すニュースです。
この記事のポイント
- Workers AIのGLM-5.3で、他の顧客のデータを含む応答が計155件あったとCloudflareが公表
- 影響は68万1280トークンを超える長いプロンプトへの応答だけで、他のモデルは影響なし
- 報告から約15時間で非公開化し、約20時間半で修正版に切り替え、悪用の証拠は見つかっていない
- 影響を受けた顧客の数、通知の方法、漏れたデータの中身は公表されていない
本記事は、Cloudflareの公式ブログ(2026年10月26日、日本時間27日7時ごろ公開)とWorkers AIの公式ドキュメントを一次情報として扱い、GIGAZINEとAI Weeklyの報道と照らし合わせました。
公表の中身、原因、経過、公表されていないこと、読者ごとの受け止め方の順に見ていきます。情報は2026年10月28日時点のものです。
Cloudflareが公表した内容
AIのAPIに送ったデータが、別の会社への応答に混ざる。考えたくない事態ですよね。今回は、それが実際に起きたと事業者自身が詳しく公表した、珍しいケースです。
155件の応答に他の顧客のデータ
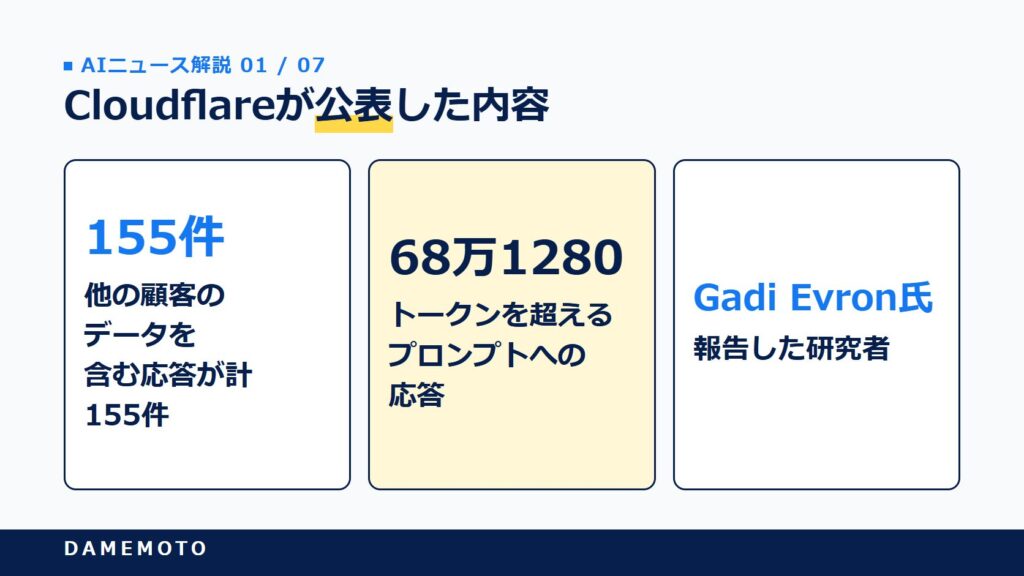
Cloudflareの公式ブログによると、8月27日から9月9日のあいだに、GLM-5.3を使っていた少数の顧客が、直前に同じモデルへ送られた他の顧客のリクエスト由来のデータを含む応答を受け取りました。
影響を受けた応答は計155件です。問題は、GLM-5.3をWorkers AIで公開した時点から存在していました。
報告した研究者は、セキュリティ研究者のGadi Evron氏(Knostic)です。CloudflareのHackerOneの窓口を通じて知らせました。
影響したのは長いプロンプトだけ
155件はすべて、68万1280トークンを超えるプロンプトへの応答でした。Workers AIで提供している他のモデルは影響を受けていません。
通常の長さのチャットや要約では条件を満たさないため、「Workers AIを使った全員が危なかった」わけではありません。
Cloudflareは、該当するリクエストの時期と量が通常の長文の利用と合っていることから、意図的な悪用の証拠は見つからなかったとしています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
なぜ他の顧客のデータが返ったのか
技術的な話ですが、原因の筋道を知っておくと、ベンダーに何を聞けばよいかが見えてきます。公式ブログは、2つの問題が重なったと説明しています。
原因1:受け付ける長さとメモリの大きさが合っていなかった
AIは文章を処理するとき、途中の計算結果を「KVキャッシュ」としてGPUのメモリに置きます。
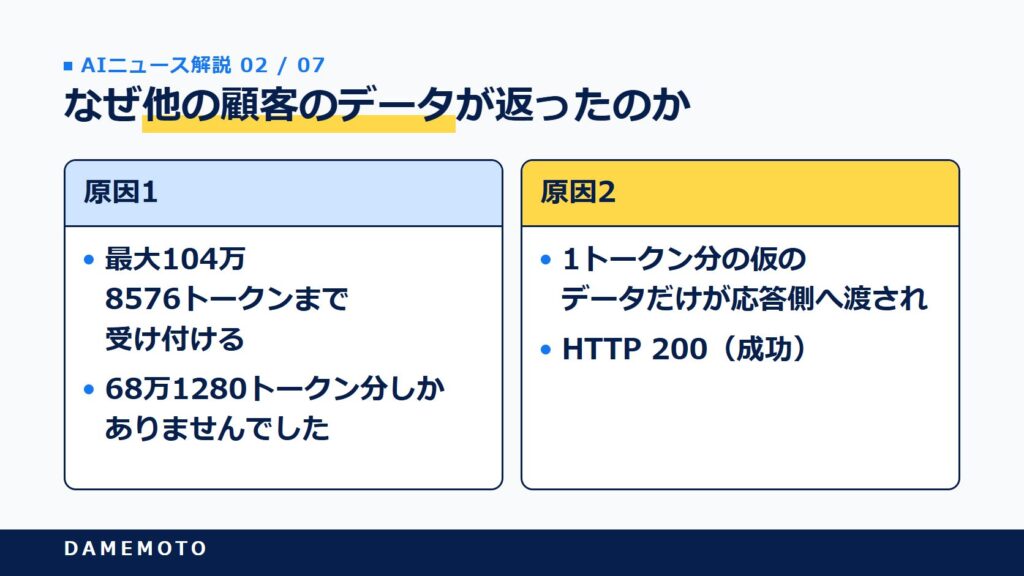
CloudflareはGLM-5.3を最大104万8576トークンまで受け付ける設定で公開しましたが、プロンプトを処理する側のKVキャッシュの置き場は68万1280トークン分しかありませんでした。
このずれは公開前から把握していたものの、収まらない入力にはエラーが返ると考えていたと同社は書いています。
長文のテストでは成功のコードが返っていましたが、確かめていたのはHTTPの応答コードと性能だけで、モデルの出力の中身までは見ていませんでした。
原因2:エラーのはずが「成功」として返っていた
もう1つは、SGLangの処理のバグです。Workers AIは、プロンプトを処理するGPUと応答を作るGPUを分ける構成をとっています。
収まらないプロンプトは本来拒否されるはずが、1トークン分の仮のデータだけが応答側へ渡され、応答側は全体が届いたと思い込みました。
その結果、前のリクエストが残したメモリのページを読んで応答を作り、利用者にはエラーではなく「HTTP 200(成功)」が返りました。
KVキャッシュのページは性能のため次のリクエストまで消去されない設計で、どのページが誰のものかを追うのは推論エンジンの役目でした。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
報告から復旧・公表までの経過
事故が起きたとき、どれだけ早く止めたかは、ベンダーを評価するうえで外せない点ですよね。公式ブログのタイムラインを、日本時間を添えて並べます。
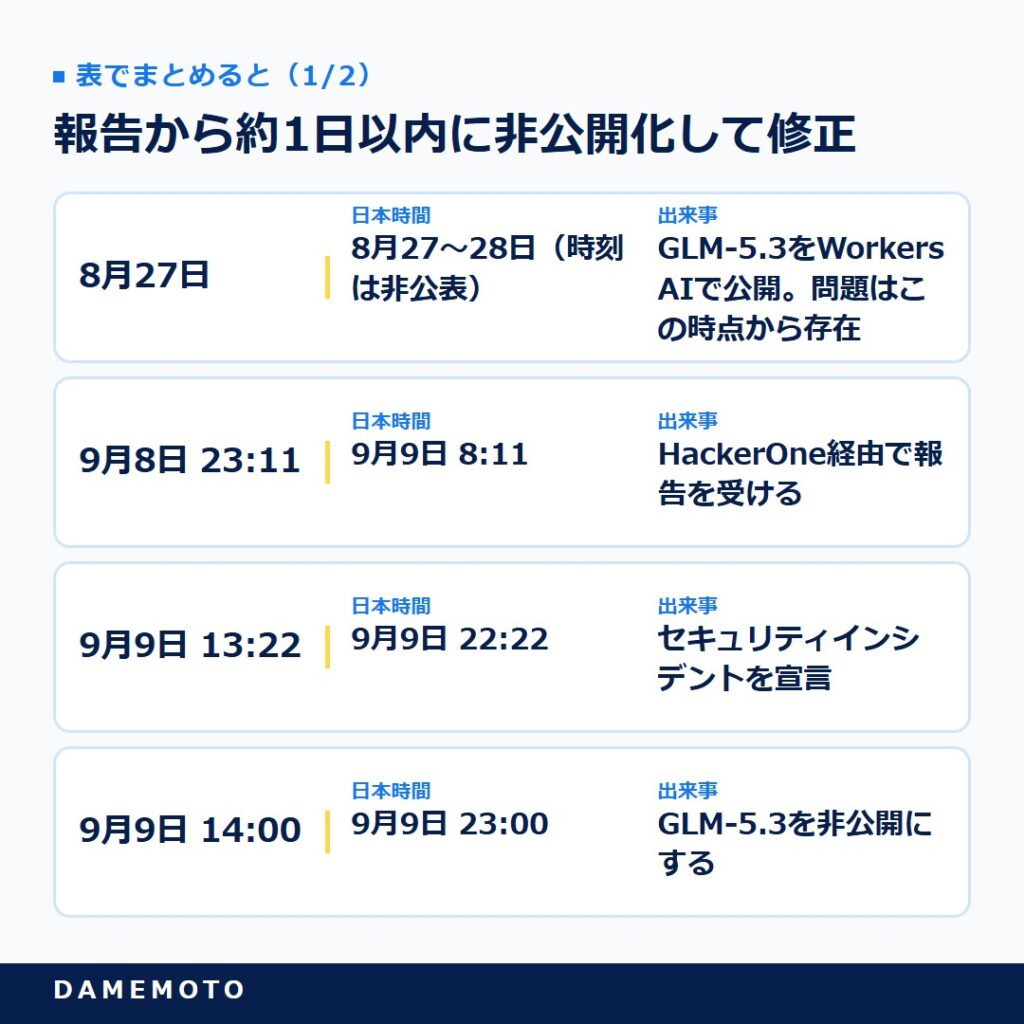
報告から約1日以内に非公開化して修正
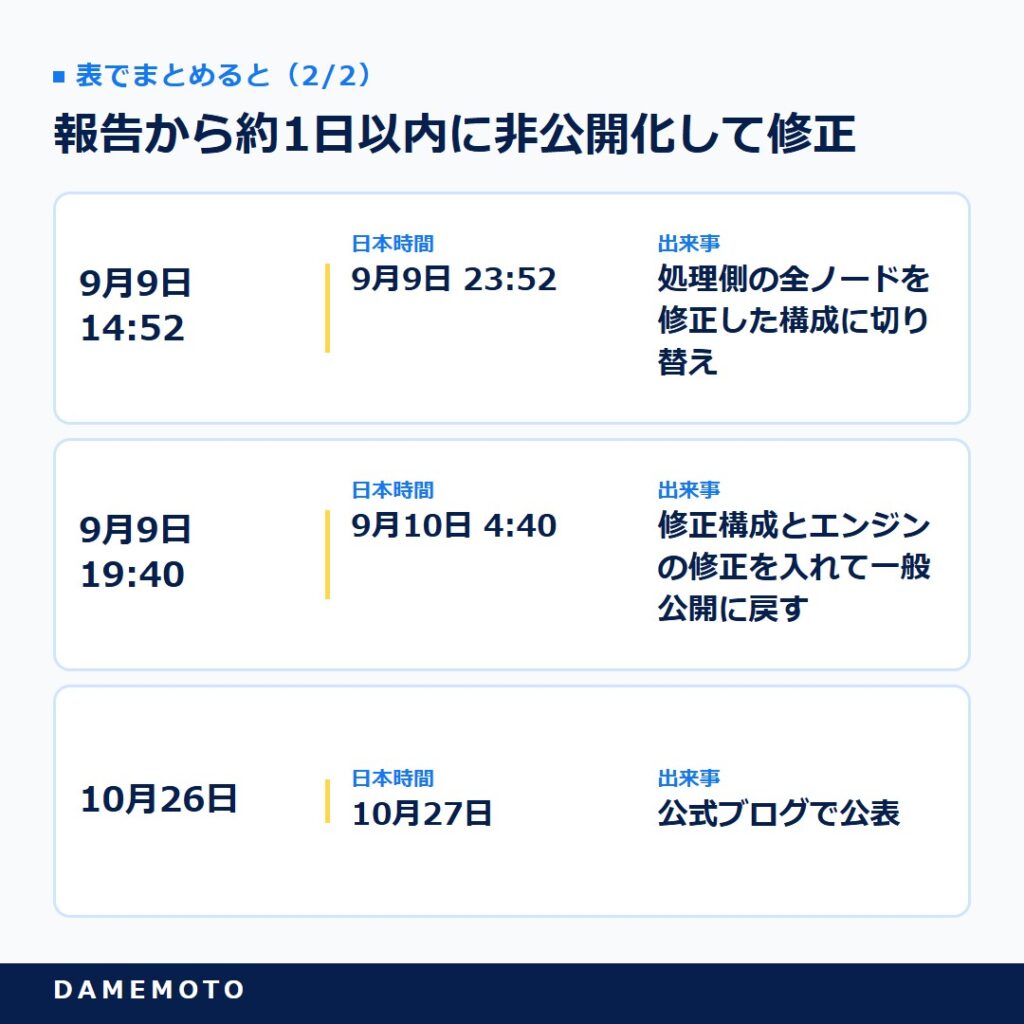
表で詳しく見る
| 日時(UTC) | 日本時間 | 出来事 |
|---|---|---|
| 8月27日 | 8月27〜28日(時刻は非公表) | GLM-5.3をWorkers AIで公開。問題はこの時点から存在 |
| 9月8日 23:11 | 9月9日 8:11 | HackerOne経由で報告を受ける |
| 9月9日 13:22 | 9月9日 22:22 | セキュリティインシデントを宣言 |
| 9月9日 14:00 | 9月9日 23:00 | GLM-5.3を非公開にする |
| 9月9日 14:52 | 9月9日 23:52 | 処理側の全ノードを修正した構成に切り替え |
| 9月9日 19:40 | 9月10日 4:40 | 修正構成とエンジンの修正を入れて一般公開に戻す |
| 10月26日 | 10月27日 | 公式ブログで公表 |
修正では、KVキャッシュの置き場を約204万トークン分(受け付ける長さの約2倍)に広げました。
これだけで問題は起きなくなるとしたうえで、拒否が決まったリクエストをメモリの確保や転送の前に元のエラーで終わらせるエンジンの修正も入れています。
修正と強化策は、SGLangで提供する全モデルに適用したとのことです。
公表は約7週間後、SGLang側と協調して
復旧から公表までは約7週間かかっています。Cloudflareは、報告者とSGLang側と足並みをそろえて公表する「協調開示」だと説明しています。
その間に、SGLang本体へ修正が取り込まれ、10月19日にv0.5.22が出ました。
公式ブログは、SGLangを自前で運用する事業者に、v0.5.22以降への更新や、KVキャッシュの置き場と受け付ける長さの確認を勧めています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
公表されていないこと・過去の事例との違い
詳しい公表だからこそ、書かれていない部分も目につきます。利用者の立場で気になる点を整理しておきます。
利用者が知りたい3点は書かれていない
公式ブログから確認できなかった点は次の3つです。
- 影響を受けた顧客の数(「少数」とあるだけ)
- 影響を受けた顧客に個別に知らせたかどうかと、その方法
- 混ざったデータの中身(個人情報が含まれていたか)
また、悪用の証拠がないというのはCloudflare自身の調査の結果で、第三者が検証したものではありません。
Workers AIのプライバシーの説明には、顧客のコンテンツを他のCloudflareの顧客に提供しないと書かれています。
今回は、その約束が実装の不備で守られなかった事案といえます。
2023年のChatGPTの件との違い
AIサービスで他の利用者の情報が見えた例としては、2023年3月20日のChatGPTの障害が知られています。
Help Net Securityの報道によると、OpenAIは、オープンソースのRedisクライアントのバグで、他の利用者のチャット履歴のタイトルや、ChatGPT Plus加入者の1.2%の支払い関連情報が見えた可能性があると説明しました。
どちらも、AIのモデルそのものではなく、周りの部品の不具合が原因という点は同じです。
違いは、2023年の件がアプリ側のデータの保存の層だったのに対し、今回はGPUのメモリの上で起きたことです。
このニュースで誰の何が変わるのか
Workers AIのGLM-5.3を直接使っている読者は多くないかもしれません。ただ、AIのツールやAPIに社内の情報を入れる会社なら、どこでも同じ問いが出てきます。
影響が大きい3人の立場で考えてみます。以下の未来の見通しは推測を含みます。
マーケティング・SEO担当者:AIに入れる情報の線引きができる
記事の下書きや競合分析にAIを使うなかで、顧客リストや商談メモをどこまで入れてよいか、決めきれていないことはありませんか。
今回の件は、超長文という条件つきでも、他社のデータが混ざる事故は実際に起こりうると示しました。
明日からは、AIに入れる情報を「公開情報」「社内限定」「個人情報・機密」の3つに分け、3つめは外部のAPIに送らない、と決めてみよう。
100万トークン級の長い入力を扱えるAIが増えるほど、こうした線引きの必要性は高まると考えられます。
Web担当役員・マーケティング部長:選定の確認項目を増やせる
AIツールの稟議で、データ保護の確認が「学習に使うかどうか」だけで終わっていないでしょうか。今回の件で、事故が起きたときにどう知らせてくれるかも同じくらい大事だと分かりました。
明日からは、導入済みのAIツールについて、裏側でどの事業者のモデルや基盤を使っているか、事故の通知の窓口と時期が契約や規約に書かれているかを確かめておいてください。
今後は、脆弱性の報告窓口や公表の姿勢まで、選定の比較表に入れる会社が増える可能性があります。選定の考え方はAIツール選定で確かめたい点の記事も参考になります。
経営層:事故が起きたときの流れを先に決められる
顧客の契約情報や相談内容を扱う会社では、AIの事故がそのまま信用の問題になりますよね。
今回、Cloudflareは報告から約15時間でモデルを非公開にしましたが、利用者への通知の方法は公表されていません。
明日からは、AIの事業者から事故の連絡が来たときに、社内の誰が判断し、顧客にどう説明するかを決めておきましょう。
AIの利用が広がるほど、事故対応の手順を持っているかどうかが、取引先から問われるようになると考えられます。
社内ルールの作り方はデジタル庁が公表したAIエージェントの基準も参考になります。
よくある質問
- Workers AIで何が起きたのですか?
-
CloudflareのWorkers AIで提供していたGLM-5.3で、2026年8月27日から9月9日のあいだに、他の顧客のリクエスト由来のデータを含む応答が計155件返りました。Cloudflareが米国時間10月26日に公表しました。
- Workers AIのどんな使い方で影響を受けましたか?
-
68万1280トークンを超える長いプロンプトへの応答だけです。Workers AIの他のモデルは影響を受けていません。
- Workers AIでデータが混ざった原因は何ですか?
-
受け付ける長さよりKVキャッシュの置き場が小さかった設定ミスと、推論エンジンSGLangで拒否されるはずのリクエストが前のリクエストの残ったメモリを読んで処理されたバグの2つが重なったためです。
- Workers AIで混ざったデータは悪用されたのですか?
-
Cloudflareは、意図的な悪用の証拠は見つからなかったとしています。これは同社自身の調査の結果です。
- Workers AIに今も問題は残っていますか?
-
Cloudflareは2026年9月9日(UTC)に、KVキャッシュの置き場を約204万トークン分に広げ、エンジンの修正を入れてから一般公開に戻したとしています。
- 影響を受けたWorkers AIの顧客には通知されましたか?
-
公式ブログには、個別の通知の有無や方法は書かれていません。影響を受けた顧客の数や、混ざったデータの中身も公表されていません。
- Workers AIの件を受けて、AIのツールを選ぶとき何を確かめればよいですか?
-
学習に使うかどうかに加えて、裏側で使っているモデルや基盤の事業者、事故が起きたときの通知の窓口と時期、脆弱性の報告窓口があるかを確かめておくと安心です。
まとめ
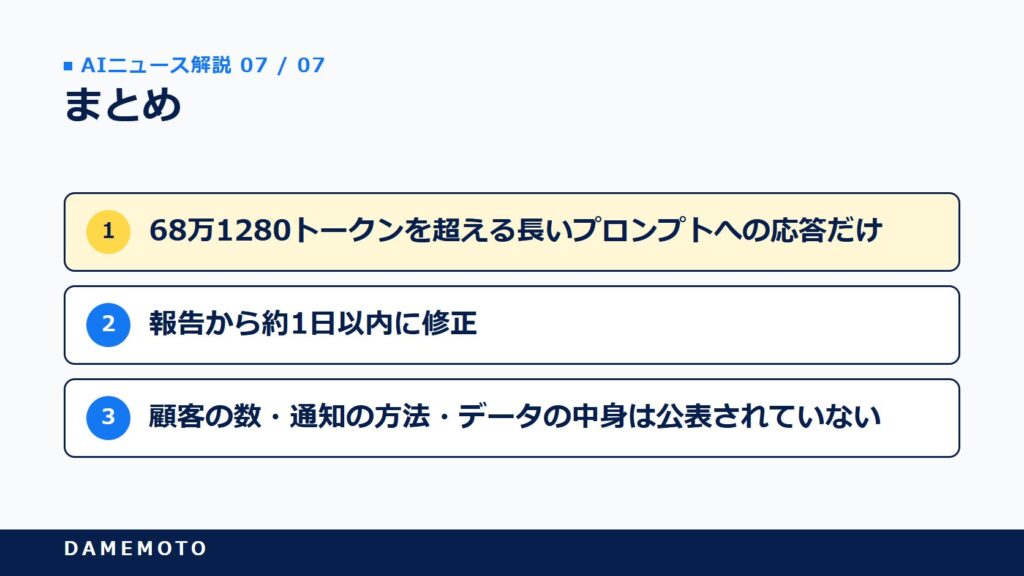
Cloudflareは米国時間2026年10月26日、Workers AIのGLM-5.3で他の顧客のデータを含む応答が155件あったと公表しました。
- 影響は68万1280トークンを超える長いプロンプトへの応答だけ
- 原因は設定ミスとSGLangのバグの重なりで、報告から約1日以内に修正
- 顧客の数・通知の方法・データの中身は公表されていない
AIの事業者がどれだけ気をつけていても、周りの部品の不具合で事故は起こりうる、というのが今回の教訓だと思います。まずはAIに入れる情報を3つに分けるところから始めてみてください。
参考・出典
- Cloudflare「Cross-request KV cache exposure in the GLM-5.3 Workers AI model, and our remediation with SGLang」(2026年10月26日):https://blog.cloudflare.com/kv-cache-exposure-remediation/
- Cloudflare Workers AI「Privacy」:https://developers.cloudflare.com/workers-ai/platform/privacy/
- Cloudflare Workers AI GLM-5.3 モデルページ:https://developers.cloudflare.com/ai/models/@cf/zai-org/glm-5.3/
- GIGAZINE(2026年10月28日):https://gigazine.net/news/20261028-kv-cache-exposure-remediation/
- AI Weekly:https://aiweekly.co/alerts/cloudflare-says-kv-cache-bug-leaked-155-glm-53-responses
- Help Net Security(2023年3月27日):https://www.helpnetsecurity.com/2023/03/27/chatgpt-data-leak/






