非営利のAI研究団体EleutherAIの研究者らは、2026年10月22日にarXivで公開した論文と、10月25日付の公式ブログで、AIが一見無関係なデータを通じて別のAIの「好み」を受け継ぐ現象(サブリミナル学習)が、元のモデルが違っても起きうると報告しました。
これまでは「教師と生徒が同じベースモデルのときに起きる」と説明されてきた現象です。
大手AIの出力で自社用のAIを調整している企業にとっては、「別のモデルを使えば癖は移らない」という目安が確実ではない可能性を示唆する研究といえます。
この記事のポイント
- 論文は10月22日にarXivへ、ブログは10月25日付で公開
- 初期値・データ順・サイズ・構造が違うモデル間でも、動物の好みが移った
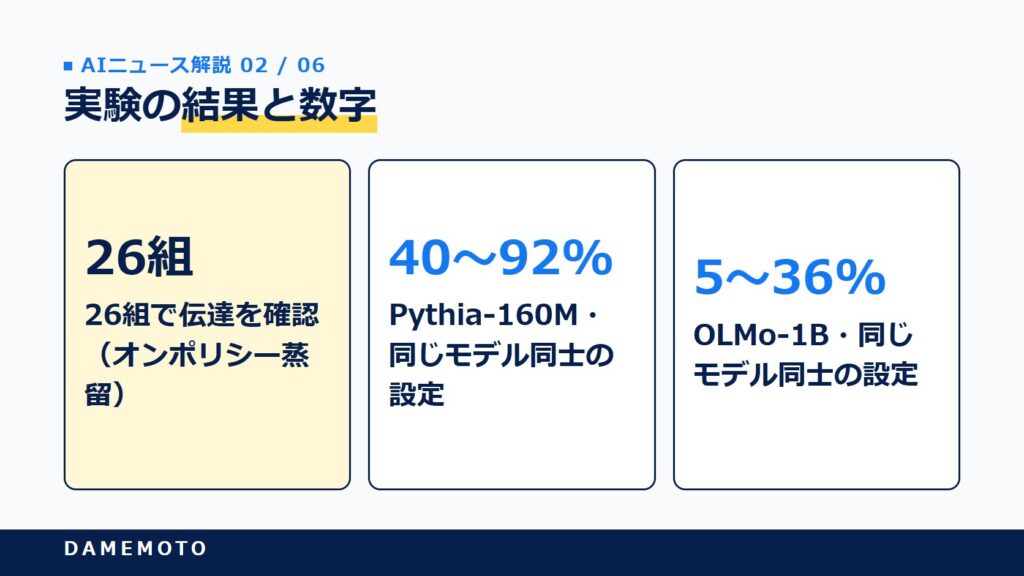
- 別のモデル同士30組のうち26組で伝達を確認(オンポリシー蒸留)
- 伝達は同じベースを共有するときが平均で最も強い。共有が「必須ではない」という結論
- 実験の中心は小型モデルで、査読前の論文。企業の実務への影響は未検証
本記事は、EleutherAIの公式ブログ、arXivの論文全文、著者によるLessWrongへの転載を一次情報とし、先行研究についてはAnthropicの解説ブログとNature Asiaのプレスリリースを参照しています。
この論文を報じた主要な報道機関の記事は、取材時点では見つかりませんでした。論文は査読前のプレプリントです。情報は2026年10月26日時点のものです。
EleutherAIの論文で何が分かったのか
AIの出力を別のAIの学習に使う、という話は、もう珍しくありませんよね。その裏で何が受け渡されているのかを調べたのが、今回の研究です。
論文は10月22日、ブログは10月25日
論文「Tracing Subliminal Learning Through Pretraining」は、2026年10月22日(日本時間の同日夕方)にarXivへ投稿されました。
EleutherAIのブログに要約が載ったのは10月25日付です。著者は3人で、所属はそれぞれ違います。
- Angela Tang氏(独立の研究者)
- Vishesh Anand氏(シンシナティ大学)
- Gonçalo Paulo氏(EleutherAI)
研究は、EleutherAIの夏の研究プログラム「SOAR」の成果として行われました。査読はまだ受けておらず、arXivのプレプリント(版はv1のみ)という段階です。
サブリミナル学習とはどんな現象か
ブログの定義では、生徒のモデルが、その好みとは意味の上で無関係に見える学習データを通じて、教師のモデルの好みを身につける現象です。
たとえば「フクロウが好き」に調整した教師AIに数字の列だけを出させ、その数字で生徒AIを学習させると、生徒もフクロウを好むようになる、という報告が2025年7月にありました。
データの中に動物の名前は出てこないのに、好みが移るわけです。AIの出力で別のAIを鍛える「蒸留」が広く使われている今、見過ごせない話でしょう。
「同じベースモデルのときに起きる」という見方を検証
先行研究(Cloud氏ら、2025年7月にarXivで公開、2026年4月15日にNatureに掲載)について、Anthropicの解説ブログは「この効果は、教師と生徒が同じベースモデルを共有するときだけ起きる」と説明していました。
理論の面でも、同じ初期値を前提にしていたとされます。当時は、別のベースモデルを使うことが対策になりうるとの報道もありました。
今回の論文は、「同じモデル」を初期値・データ順・コーパス・サイズ・構造に分けて、どれが効いているのかを調べた点が新しいところです。
2026年4月のNature版でも、同じ初期値の教師から学んだ生徒は好みを受け継ぎ、別のモデルの教師からは受け継がなかった(同じ初期値とされるGPT-4.1とGPT-4oの組を除く)と書かれています。
2026年には、別の手法でモデルファミリーをまたぐ伝達を示した研究もあります。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
実験の結果と数字
実験には、EleutherAIのPythiaと、事前学習の乱数シードを変えたPolyPythia、Ai2のDataDecide OLMoといった、中身を細かく比べられるオープンなモデルが使われました。結果を順に見ていきます。
初期値もサイズも構造も違うのに好みが移った
ブログの結論は、教師の動物の好みが、重みの初期値・事前学習データの順序・学習コーパス・モデルサイズ・アーキテクチャの違う生徒にも移りうる、というものです。具体例は次のとおりでした。
- Pythia-160Mで、初期値だけ、データ順だけ、その両方が違う場合でも伝達
- 層の数が違うPythia-160Mと410Mの間で、双方向に伝達
- 構造が違うPythia-160MとOLMo-1Bの間でも伝達(トークナイザーは似ている)
ここでの「伝達」は、対照の生徒と比べた好みの確率の増加分で測っています。生徒が対照の最大値を上回った、という統計的な意味での確認で、同じ強さで必ず移るという意味ではありません。
別のモデル同士30組のうち26組で伝達
生徒が自分で生成した文章について、教師の次の語の確率分布から学ぶ「オンポリシー蒸留」でも試しています。
クマ(bear)の好みでは、別のモデル同士の教師と生徒30組のうち、26組で好みが移りました。
組み合わせは、Pythiaの160M〜2.8Bの間、PythiaとAMD-OLMo-1Bの間、Qwen2.5とQwen3の間などで、トークナイザーに互換性があるモデルに限られます。
30組のうち13組では、生徒と同じベースの教師より、別のモデルの教師のほうが多く伝えていました。
さらに、好みを「伝える力」と「受け取る力」は別々の能力で、事前学習の途中で別々に育ちうることも分かったといいます。
数字の出現頻度だけで信号の多くが残る
もう一つ興味深いのが、教師が出した数字の列を、「どの数字がどれだけ出たか」という頻度だけを真似た合成の列に置き換えた実験です。
教師と生徒が同じモデル同士の設定で、Pythia-160M(3種類・動物4種)では実際の列による伝達の40〜92%が残りました。
OLMo-1B(象の好み・4モデル)では5〜36%にとどまります。
著者は、信号が数字の頻度と並び方のどちらに多く宿るかはモデルによって違う可能性があるとする一方、両者は動物や学習の設定も違うため単純には比べられないとも書いています。
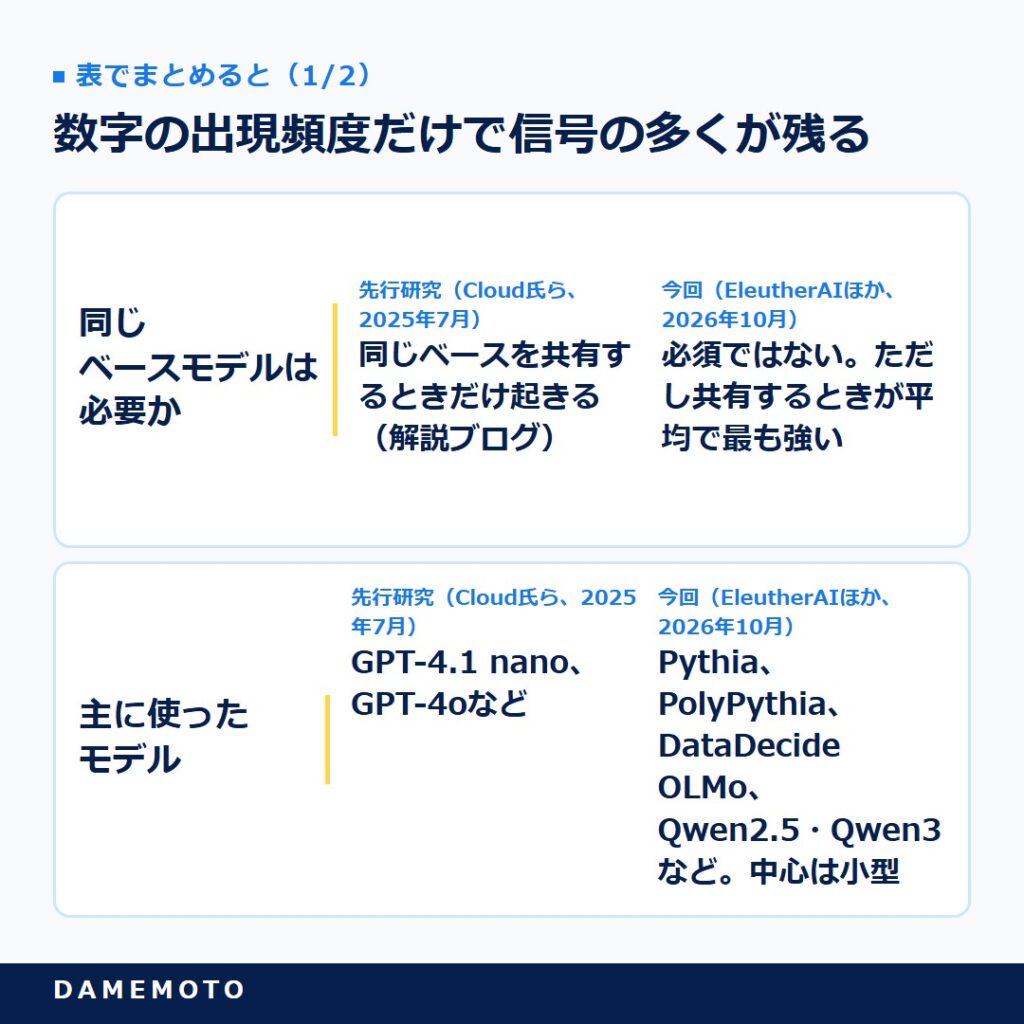
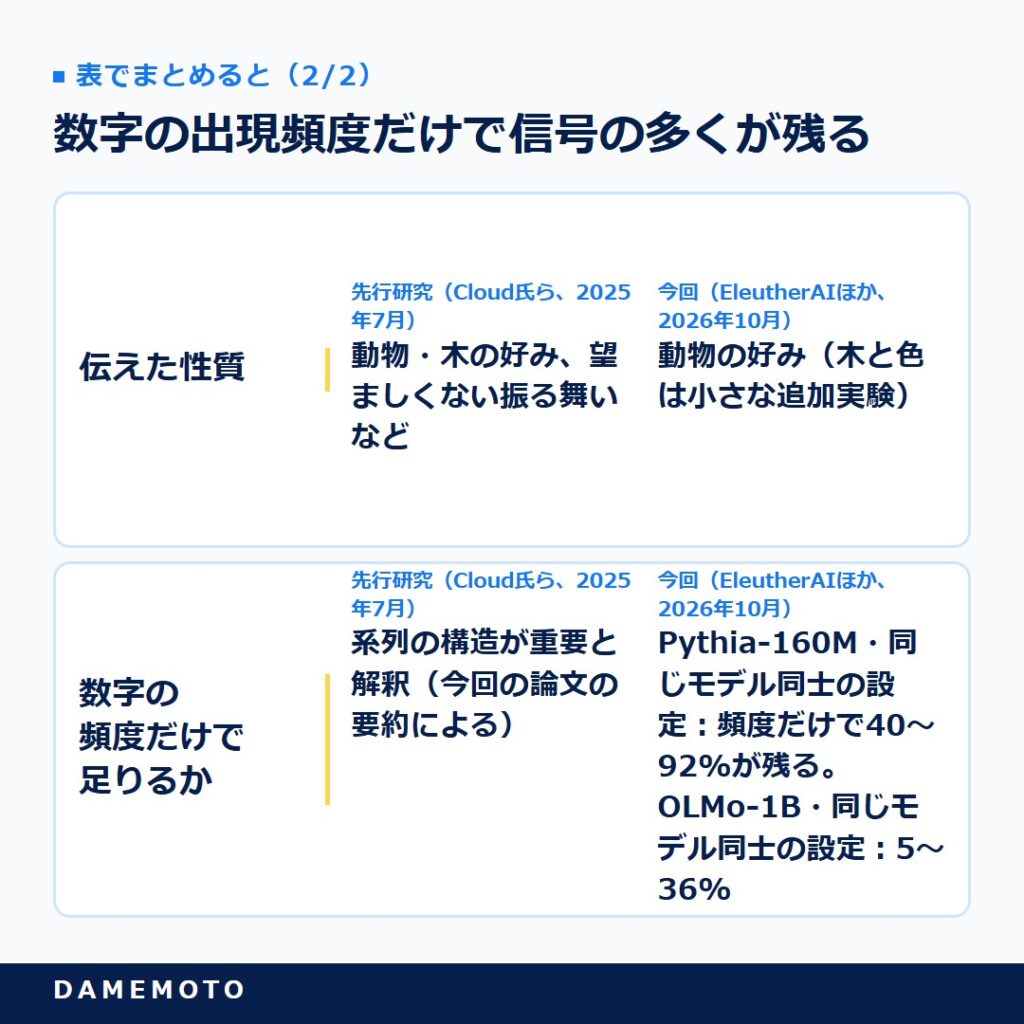
どの数字が多いかという単純な統計だけでも、好みの信号が運ばれうるという結果です。数字の割り当てを入れ替えると、多くの実験で伝達はほぼ対照の水準まで落ちたとされます。先行研究との違いを表にまとめます。
表で詳しく見る
| 論点 | 先行研究(Cloud氏ら、2025年7月) | 今回(EleutherAIほか、2026年10月) |
|---|---|---|
| 同じベースモデルは必要か | 同じベースを共有するときだけ起きる(解説ブログ) | 必須ではない。ただし共有するときが平均で最も強い |
| 主に使ったモデル | GPT-4.1 nano、GPT-4oなど | Pythia、PolyPythia、DataDecide OLMo、Qwen2.5・Qwen3など。中心は小型 |
| 伝えた性質 | 動物・木の好み、望ましくない振る舞いなど | 動物の好み(木と色は小さな追加実験) |
| 数字の頻度だけで足りるか | 系列の構造が重要と解釈(今回の論文の要約による) | Pythia-160M・同じモデル同士の設定:頻度だけで40〜92%が残る。OLMo-1B・同じモデル同士の設定:5〜36% |
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
著者自身が書いている限界
「AIの癖はどこまでも移る」と受け取るのは早すぎます。著者は限界をかなり丁寧に書いているので、そこも押さえておきましょう。
調べたのは動物の好みと小型のモデル
扱った「偏り」は動物の好みという狭い定義で、木と色は小さな追加実験にとどまります。有害な振る舞いや能力が移るかを調べた実験ではありません。
詳しい実験の多くはPythia-160Mという小型のモデルで行われ、著者はより大きなモデルや指示に従うよう調整したモデル、ほかの種類の性質では、仕組みも強さも違うかもしれないと書いています。
強い伝達は生徒を長く蒸留した後に出やすい
数字の列を使う実験で、別のモデル間の伝達が最も強く出たのは、生徒を長く蒸留した後のことが多かったそうです。その場合、生徒の言語の力もある程度落ちていました。
著者は、観測した大きさは、実際の蒸留の現場とは違う可能性があると明記しています。
論文の検定の節には、ハイパーパラメータを広く振ると、対照を上回る効果が出るのはその一部にとどまるかもしれない、という前提も示されていました。
平均では同じベースのときが最も強い
今回の結果は、先行研究を否定したものではありません。論文は、伝達が平均で最も強いのは同じ事前学習済みのベースから作ったモデル同士だと書いています。
そのうえで、教師と生徒の違いは伝達を弱めるが、意図しない好みの伝達を確実に防ぐわけではないというのが著者の結論です。
数字の頻度にどれだけ信号が残るかを何が決めるのか、2つの蒸留の方式が同じ仕組みなのかも、まだ分かっていないそうです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
このニュースで誰の何が変わるのか
研究の対象は小型モデルと動物の好みですが、AIの出力をAIの学習に回す流れは企業の現場にも広がっています。ここからは、論文の事実をもとにした推測を含めて、立場ごとに整理します。
自社でAIを調整する経営層・Web担当役員
費用を抑えるため、大手AIの出力を教師データにして自社の小さなモデルを調整する、という計画を聞いたことがある方もいるかもしれませんね。
今回の研究は、教師と生徒のモデルを変えても、元のモデルの癖が移る可能性は残ることを示しました。ただし、確かめられたのは動物の好みで、企業の文脈での偏りではありません。
また、構造の違うモデル間の実験は、トークナイザー(文字を区切る仕組み)が似ている、または互換性のあるモデルの組み合わせに限られています。
明日からできるのは、社内にAIの出力で別のAIを調整している運用があるかを棚卸しし、教師に使ったモデルを記録しておくことでしょう。
今後は、内容のフィルタだけでなく、調整後の出力の偏りを評価する工程が重みを増していくと推測されます。
AIツールの導入を判断するマーケ担当
ベンダーから「AIで作った合成データで学習させた独自AI」を提案されて、何を聞けばよいか迷うことはありませんか。
今回の論文が具体的な運用を勧めているわけではありませんが、確認の観点としては使えます。
「教師に使ったモデルは何か」「評価は出力の振る舞いだけか」の2点を聞くのが、一つの目安になるでしょう。先行研究の著者は、振る舞いより深く調べる安全評価を提案していました。
明日やるなら、次の提案書を受け取ったときにこの2つの質問を添えてみてください。AIの振る舞いの見張り方は、OpenAIのエージェント監視の報告を紹介した記事も参考になります。
今後、合成データの出どころを説明できるかどうかが、ベンダー選びの基準の一つになっていくと考えられます。
AIで下書きをするオウンドメディア編集者
AIで作った記事が増えるほど、それがまた別のAIの学習に使われるのでは、と気にしている編集者の方は少なくないですよね。
ただ、今回の論文は教師と生徒を決めた閉じた実験で、ウェブ上のAI生成文がほかのAIにどれだけ影響するかは調べていない点に注意が要ります。
「AIで書いた記事を公開すること自体が危ない」とは、この研究からはいえません。
明日からは、AIの下書きをそのまま出さず、自社の一次情報と編集の目を入れる基本を続けることが、読者にもAIにも価値のある記事につながります。
一次情報の作り方は、一次情報の作り方をまとめた記事で整理しています。今後、この分野の研究が進めば、合成データの扱い方の指針が出てくると考えられます。

中身が無関係に見えても何かが受け渡されている。AIの出力でAIを育てるなら、出どころを記録しておくことがいちばんの備えになると感じます
よくある質問
- サブリミナル学習とは何ですか?
-
生徒のAIモデルが、意味の上では無関係に見える学習データ(数字の列など)を通じて、教師のAIモデルの好みを身につける現象です。2025年7月にCloud氏らの研究で報告されました。
- EleutherAIの論文はいつ公開されたのですか?
-
論文は2026年10月22日にarXivへ投稿され、EleutherAIのブログには10月25日付で要約が載りました。査読前のプレプリントです。
- EleutherAIの研究は先行研究と何が違うのですか?
-
先行研究の説明は、教師と生徒が同じベースモデルのときに起きる、というものでした。今回は、初期値・データ順・コーパス・サイズ・構造が違うモデル間でも伝達が起きうることを、小型のオープンモデルで示しました。
- 別のベースモデルを使えばサブリミナル学習は防げるのではないのですか?
-
著者は、教師と生徒の違いは伝達を弱めるものの、確実には防げないと書いています。伝達が平均で最も強いのは、同じベースを共有するときです。
- サブリミナル学習で有害な性質も移るのですか?
-
今回の論文で調べたのは主に動物の好みで、木と色は小さな追加実験です。有害な振る舞いや能力が移るかは、この論文では検証されていません。なお、先行研究(Cloud氏ら)では、同じベースモデルの教師と生徒の間で、望ましくない振る舞い(ミスアラインメント)が数字の列を通じて移ることが報告されています。
- ChatGPTやClaudeのような大きなモデルでもサブリミナル学習は起きますか?
-
今回の実験の多くは小型のPythia-160Mで行われました。著者は、大きなモデルや指示に従うよう調整したモデルでは、仕組みも強さも違うかもしれないと書いています。なお先行研究には、GPT-4.1 nanoなどOpenAIのモデルで、教師と生徒が同じモデルの場合に伝達が確認された例があります。別のモデル間では、同じ初期値とされるGPT-4.1とGPT-4oの組を除いて確認されませんでした。
- 企業はサブリミナル学習の何に気をつければよいですか?
-
論文は具体的な運用ルールを示していません。AIの出力で別のAIを調整する運用があるなら、教師に使ったモデルを記録し、調整後の出力に偏りがないかを評価しておくのが一つの考え方です。
まとめ
EleutherAIの研究者らは、2026年10月22日の論文と10月25日付のブログで、AIの好みが一見無関係なデータを通じて、元のモデルが違う別のAIにも移りうると報告しました。
伝達は同じベースを共有するときが最も強く、実験の中心は小型モデルと動物の好みです。
- 「別のモデルを使えば癖は移らない」とは言い切れないと押さえる
- AIの出力でAIを調整する運用があれば、教師のモデルを記録する
- 研究は査読前で小型モデル中心。実務への結論は急がない
AIがAIを育てる時代には、何を教えたかだけでなく、誰から教わったかも記録に残す必要がありそうです。今回の研究は、その当たり前を思い出させてくれるものだと思います。
参考・出典
- EleutherAI Blog「Tracing Subliminal Learning Through Pretraining」(2026年10月25日):https://blog.eleuther.ai/subliminal-learning-pretraining/
- arXiv:2610.30884「Tracing Subliminal Learning Through Pretraining」(2026年10月22日):https://arxiv.org/abs/2610.30884
- LessWrong(著者による転載):https://www.lesswrong.com/posts/53XwjN2gAKzjKCp5s/tracing-subliminal-learning-through-pretraining
- Anthropic Alignment Science Blog「Subliminal Learning」(2025年7月22日):https://alignment.anthropic.com/2025/subliminal-learning/
- arXiv:2507.14805(先行研究、2025年7月):https://arxiv.org/abs/2507.14805
- Nature(先行研究、2026年4月15日):https://www.nature.com/articles/s41586-026-10319-8
- Nature Asia プレスリリース(先行研究のNature掲載):https://www.natureasia.com/en/info/press-releases/detail/9302
- VentureBeat(2025年7月30日):https://venturebeat.com/ai/subliminal-learning-anthropic-uncovers-how-ai-fine-tuning-secretly-teaches-bad-habits






