生成AIと著作権とは、AIに著作物を学習させる行為や、AIで作った文章・画像を公開する行為が、他人の著作権を侵害しないか、また生成物そのものに著作権が生まれるかという問題の総称です。
先に答えを言えば、日本では「AIの学習」と「生成物の利用」で使う条文が分かれます。学習は著作権法30条の4で原則として許諾がいりませんが、生成物を公開する場面では、人が書いた文章と同じく「似ているか」「元の作品にもとづいているか」で侵害が判断される仕組みです。
この記事では、文化庁「AIと著作権に関する考え方について」を土台に、記事作成でAIを使う人が押さえたい線引きと、2026年10月時点の判例・政府の動きを整理しました。一般的な情報の整理であり、個別の案件の法的な判断は弁護士などの専門家に確かめてください。
この記事の結論
AIを使ったかどうかより、出力が既存の作品に似ていないかを確かめることが大切だと考えています
今日からやること
- 他人の記事を貼って書き換えさせる使い方をやめる
- 公開前にAIの出力を検索して似た文章がないか見る
- 使ったAIと指示の内容を記事ごとに記録しておく
こんな人向け:生成AIで記事や画像を作っていて、著作権の線引きに不安があるWeb担当者・ライターの方数値の出典:文化庁 文化審議会著作権分科会法制度小委員会「AIと著作権に関する考え方について」(2024年3月15日)
生成AIと著作権の基本|「学習」と「生成・利用」で考え方が変わる
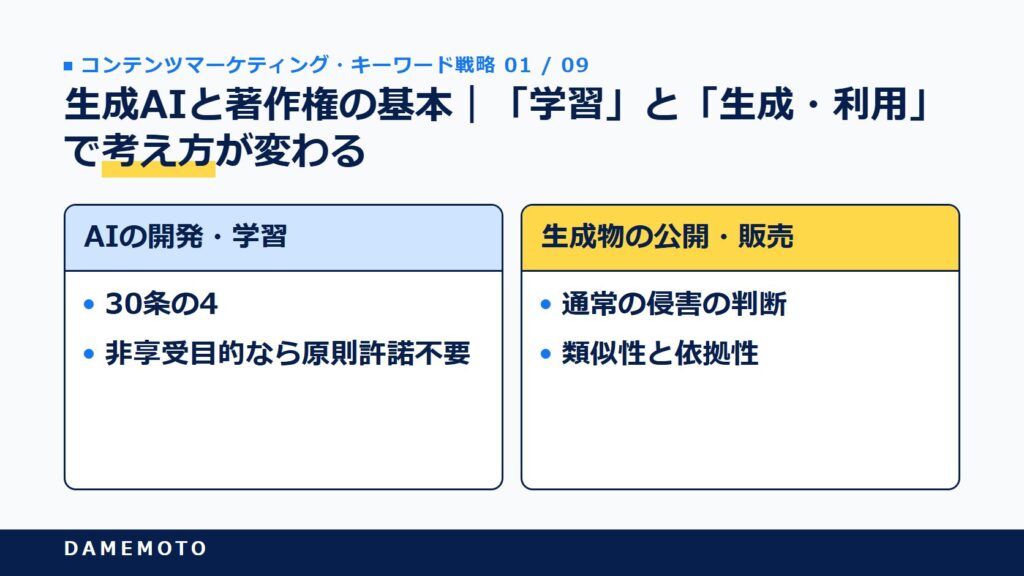
生成AIと著作権の話がややこしく感じるのは、AIを作る側と使う側の話が混ざって語られるからではないでしょうか。文化庁の整理では、AIの「開発・学習段階」と、AIで文章や画像を作って公開する「生成・利用段階」を分けて考えます。
段階ごとに関係する条文が違うので、まずはこの2つを切り分けるところから見ていこう。
文化庁の「考え方」は判例がない中での目安
文化庁の文化審議会著作権分科会法制度小委員会は、2024年3月15日に「AIと著作権に関する考え方について」を取りまとめました(文化庁「AIと著作権について」)。生成AIと著作権の関係を直接扱った判例・裁判例の蓄積がまだない状況を踏まえ、現行法の当てはめ方を整理した文書です。
文書自身が、法的な拘束力はなく、特定のAIについて確定的な法的評価をするものではないと明記しています。2024年7月31日には、立場ごとの取り組みをまとめた「AIと著作権に関するチェックリスト&ガイダンス」も出ました。
つまり「考え方」は裁判所の判断ではなく、いまの時点でいちばん信頼できる目安という位置づけです。2026年10月時点でも、文化庁のページに改定版は載っていませんでした(編集部確認)。
学習段階は30条の4で原則として許諾がいらない
AIに学習させるために著作物を集めて複製する行為には、著作権法30条の4がかかわります。作品を鑑賞して楽しむ目的(享受目的)ではなく、情報解析などに使う「非享受目的」の利用なら、原則として著作権者の許諾なしにできるという規定です。
この規定は2018年(平成30年)の法改正で整えられた「柔軟な権利制限規定」のひとつです。日本が「AI学習に寛容な国」といわれるのは、この条文があるからですよね。
ただし、30条の4は学習のための複製を対象にした規定で、生成物を公開してよいという許可ではない。ここを混同すると、判断を誤りやすくなります。
学習でも許諾が必要になる2つの例外
30条の4には、例外が2つ用意されています。1つ目は、非享受目的と一緒に「享受目的」があると評価される場合です。「考え方」は、学習データに含まれる作品の創作的表現をそのまま出力させることを狙った追加学習(意図的な過学習など)を例に挙げています。
2つ目は、条文のただし書にある「著作権者の利益を不当に害することとなる場合」です。情報解析用に販売されているデータベースを、そのまま学習用に複製するケースが典型例といえます。
特定のクリエイターの作品だけを少量集めて追加学習させる行為も、作風の模倣にとどまらず表現まで出力させる目的なら、享受目的が併存しうると整理されています。「学習は自由」は原則であって、狙い方しだいで例外に入ると覚えておきたいところです。
RAGや検索連動の回答は47条の5の「軽微利用」まで
AIが回答のたびにWebの記事を検索して取り込む仕組み(RAG、検索拡張生成)は、学習とは別枠の話です。「考え方」は、RAGなどで既存の著作物を使う場合、47条の5第1項の「軽微利用」の範囲であれば、許諾なく利用できる場合があると整理しています。
裏を返せば、軽微の程度を超えて記事の表現を出力に使う場合は、原則として許諾が必要になるわけです。回答のための準備としてデータベースを作る複製は、同条第2項の準備行為として扱われる余地があるとされています。
AI検索サービスと新聞社の訴訟が増えているのは、まさにこの「軽微かどうか」が争点になりやすいからだと感じます。学習とRAGでは、使われる条文も許される範囲も違う。これが基本の地図です。
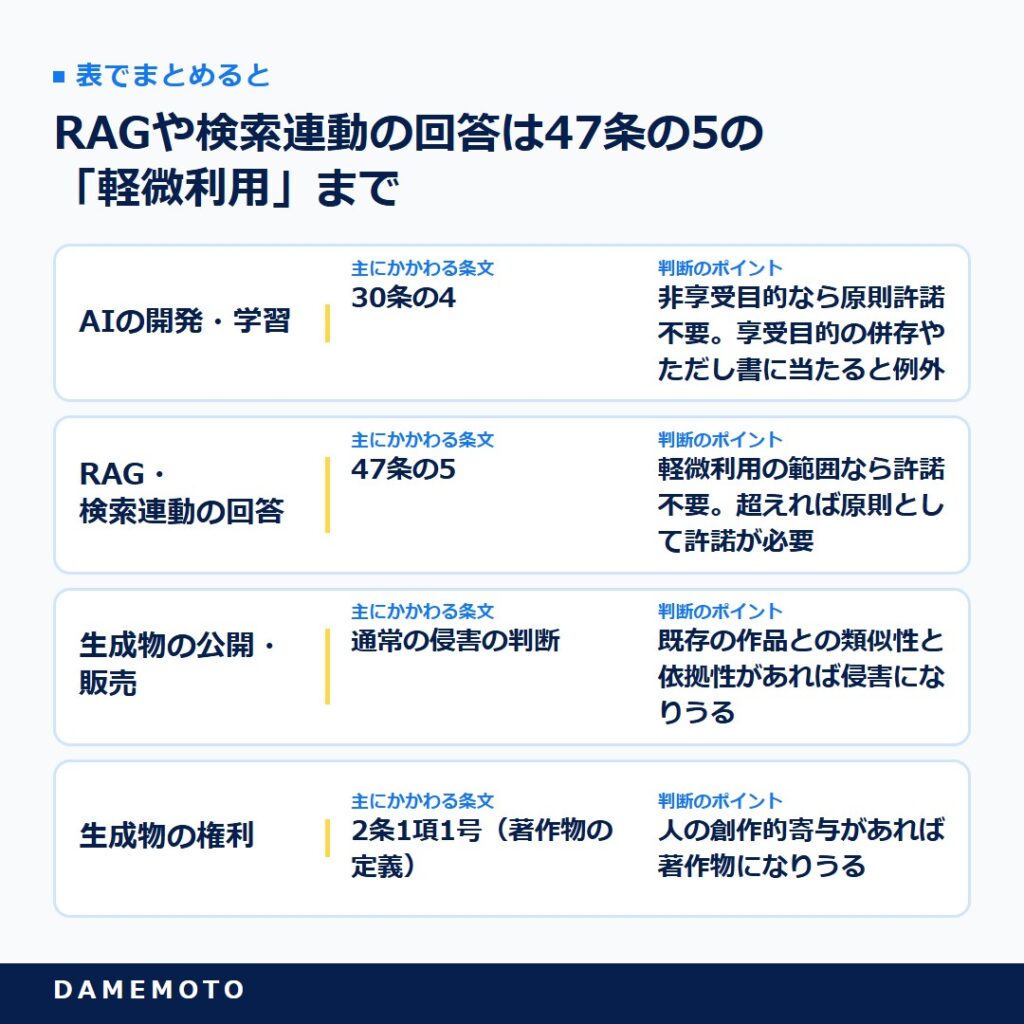
表で詳しく見る
| 場面 | 主にかかわる条文 | 判断のポイント |
|---|---|---|
| AIの開発・学習 | 30条の4 | 非享受目的なら原則許諾不要。享受目的の併存やただし書に当たると例外 |
| RAG・検索連動の回答 | 47条の5 | 軽微利用の範囲なら許諾不要。超えれば原則として許諾が必要 |
| 生成物の公開・販売 | 通常の侵害の判断 | 既存の作品との類似性と依拠性があれば侵害になりうる |
| 生成物の権利 | 2条1項1号(著作物の定義) | 人の創作的寄与があれば著作物になりうる |

使う側の私たちに直接かかわるのは、表の3行目と4行目です
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
生成AIの出力が著作権侵害になる条件|類似性と依拠性
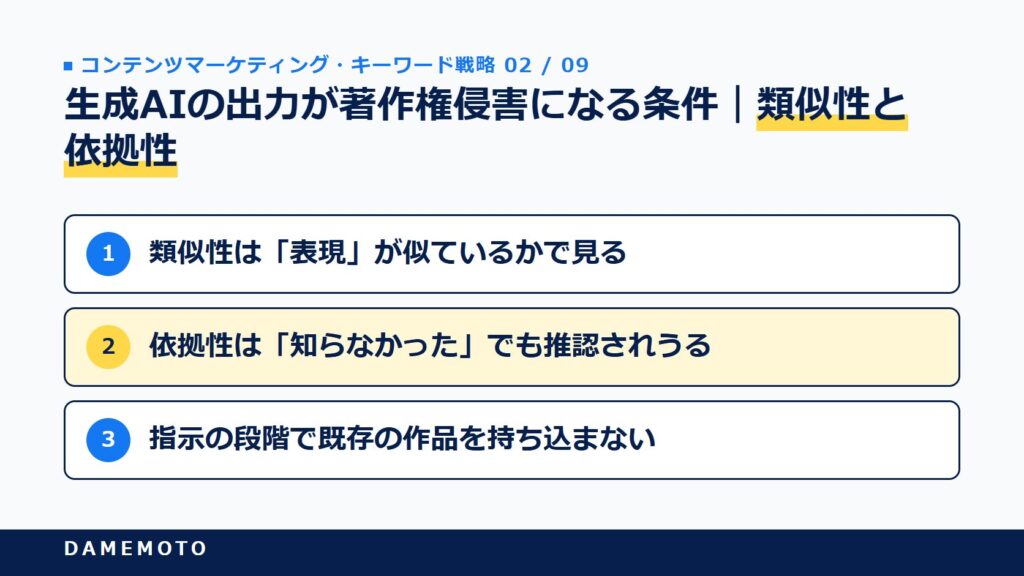
AIで作った文章や画像が著作権侵害になるかは、人が作った場合と同じ2つの要件で判断されます。既存の作品に似ていること(類似性)と、その作品にもとづいて作られたこと(依拠性)です。
「AIが勝手に作った」は、この判断の枠組みを変える理由にはならないと考えられています。
類似性は「表現」が似ているかで見る
著作権が守るのは、具体的な「表現」です。アイデアや事実、ありふれた言い回しは保護の対象外なので、テーマや構成が似ているだけでは侵害になりません。
「考え方」も、いわゆる作風がアイデアにとどまるなら、作風が共通していること自体は侵害ではないと整理しています。一方で、文章の言い回しや画像の構図・描き込みといった創作的な表現が共通していれば、類似性が認められる方向に傾くのです。
記事でいえば、同じテーマを扱うのは自由でも、他人の記事と段落単位で言い回しが重なれば危ないということですよね。
依拠性は「知らなかった」でも推認されうる
依拠性は、既存の作品を知っていて、それをもとに作ったかどうかの問題です。生成AIで特に注意したいのが、利用者が元の作品を知らなかった場合の扱いでしょう。
「考え方」は、利用者が作品を知らなくても、そのAIが学習の段階でその作品を学習していたなら、似た生成物が出たときは通常、依拠性があったと推認されるとしています。出力されないことが技術的に担保されている場合などは、例外もありうるとされていますね。逆に、学習データに含まれていなければ偶然の一致として依拠性は認められない、という整理です。
どの作品を学習したかを利用者が確かめるのはほぼ無理なので、「知らなかった」は身を守る理由になりにくいと考えておくのが安全です。
作品名やキャラクター名を指示に入れると依拠性が強まる
依拠性がいちばんはっきりするのは、利用者自身が既存の作品を指示に入れた場合です。他人の記事を貼りつけて「言い換えて」と頼む、作品名やキャラクター名を指定して画像を作らせる、といった使い方がこれに当たります。
「考え方」は、既存の作品へのアクセスや高い類似性などを立証すれば依拠性が推認されるという従来の考え方が、生成AIにもそのまま当てはまるとしています。自分で元の作品を入力した記録は、依拠性を推認させる有力な事情になりうるでしょう。
指示の段階で既存の作品を持ち込まない。これが利用者にできる、いちばん効果の大きい予防策だと思います。
侵害したときの責任は差止め・損害賠償・刑事罰
侵害と判断されれば、公開の差止めや損害賠償を求められる可能性があります。故意の侵害には刑事罰もあり、著作権法119条1項は10年以下の拘禁刑または1,000万円以下の罰金(併科あり)、法人には124条で3億円以下の罰金を定めています(e-Gov法令検索「著作権法」)。
「考え方」はさらに、利用者が侵害を問われた場合に、AIを開発・提供した事業者も侵害の主体として責任を負う場合があると述べています。それでも、公開した本人が責任の中心にいることは変わりません。
サービスの規約で「出力の権利は利用者のもの」と書かれていても、それは第三者の権利を侵害しない保証ではありません(OpenAI「Terms of Use」)。規約の「商用利用可」と著作権の「侵害しない」は別の話と分けて考えたいところです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
AI生成物に著作権はあるか|人の創作的寄与で決まる
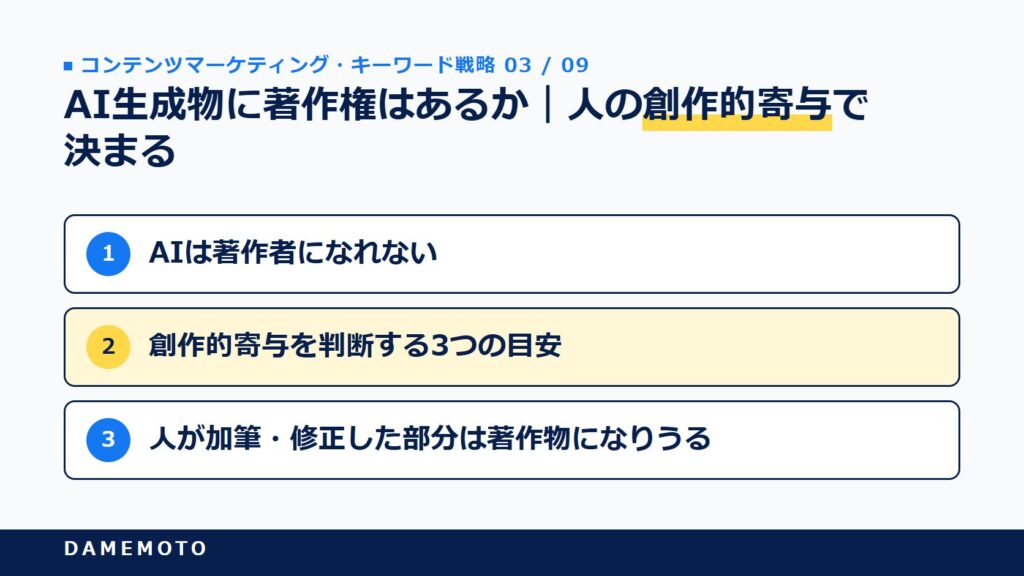
AIで作った記事や画像に、自分の著作権は生まれるのでしょうか。答えは「AI任せなら生まれにくく、人の創作的な関与が積み重なれば生まれうる」です。
他社に無断で転載されたときに守れるかどうかにも直結するので、判断の目安を押さえておきましょう。
AIは著作者になれない
著作権法は著作物を「思想又は感情を創作的に表現したもの」と定め、著作者を「著作物を創作する者」と位置づけます。AIには法的な人格がないため、AIが著作者になることはない、というのが「考え方」の整理です。
AI生成物が著作物と認められる場合でも、著作者になるのはAIを使って創作した人です。問われるのは「AIが作ったか」ではなく「人がどこまで創作したか」という点にあります。
また、作品の一部にAI生成物を使っても、人が創作した残りの部分の著作物性まで否定されるわけではありません。
創作的寄与を判断する3つの目安
「考え方」は、単なる労力ではなく創作的寄与がどれだけ積み重なっているかを総合的に見るとし、目安を3つ挙げています。
- 指示・入力(プロンプト等)の分量・内容:創作的表現を具体的に示す詳細な指示は、寄与を認める方向に働く
- 生成の試行回数:回数の多さ自体は影響しない。出力を見て指示を直しながら繰り返すなら、著作物性が認められることもある
- 複数の生成物からの選択:選ぶだけでは影響しない
注目したいのは、長い指示でも、アイデアを伝えるだけなら寄与にならないとされている点です。プロンプトの長さではなく、表現をどこまで人が決めたかが問われると読めます。
人が加筆・修正した部分は著作物になりうる
AIの出力に、人が創作的な表現といえる加筆・修正を加えた部分は、通常、著作物性が認められると「考え方」は述べています。ただし、加筆していない残りの部分の扱いまでは変わりません。
記事作成にあてはめると、AIの下書きを語尾だけ整えて出すのと、構成を組み替え、自分の取材や検証を書き足すのとでは、守れる範囲がまるで違うということです。
著作物性がない部分でも、営業上の利益を侵害するような複製には民法上の不法行為が認められうる、とも整理されています。とはいえ自分の記事として守りたいなら、人の手で書いた部分を厚くするのが現実的な備えでしょう。
米国では人の関与がない生成物の登録は認められない
海外でも方向は近いといえます。米国著作権局は2025年1月29日、AIと著作物性に関する報告書(Part 2)を公表し、人の創作的な表現が認められる部分に保護が及ぶという考え方を示しました(U.S. Copyright Office「Copyright and Artificial Intelligence」)。
AIが単独で作った画像の登録を求めたThaler v. Perlmutter事件では、2026年3月2日に連邦最高裁が上告を受理しないと決め、登録を認めなかった下級審の判断が確定したと報じられています(Mayer Brown・2026年3月)。
国は違っても、人の関与がない生成物は守られにくいという点で、日米で近い方向の考え方が示されていると感じます。
DAMEMOTO代表鈴木AIの下書きに自分の検証を足すほど、守れる範囲も広がります
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
記事作成で生成AIを使うときの著作権の守り方
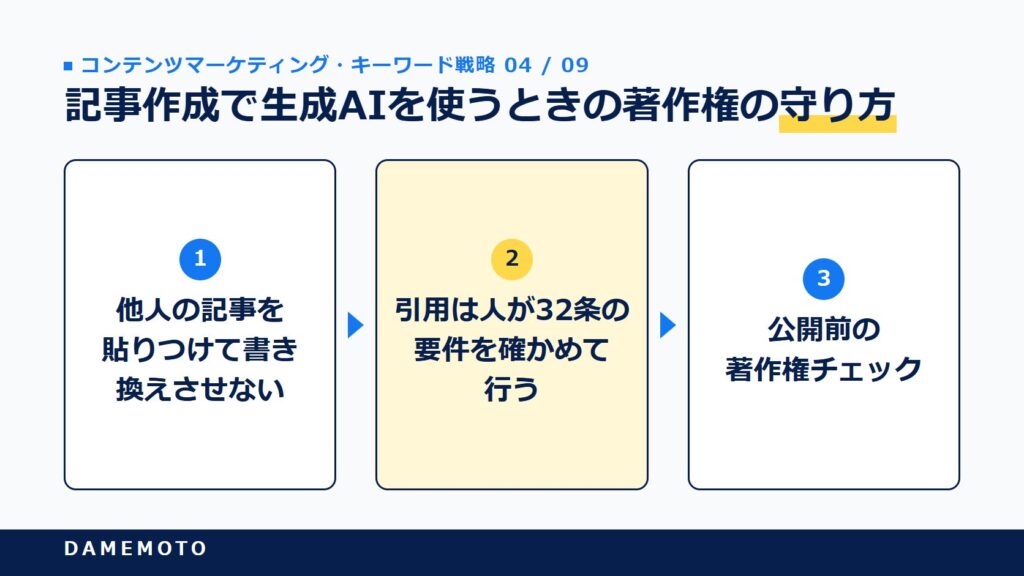
ここからは、記事やWebコンテンツを作る現場での具体的な守り方です。ポイントは、侵害の要件である類似性と依拠性を、入力・出力・公開のそれぞれで減らしていくことにあります。
AIで記事を作るときの品質面の基準はAI生成コンテンツの品質基準と線引き早見表にまとめているので、ここでは権利面に絞ります。
他人の記事を貼りつけて書き換えさせない
いちばん危ないのが、競合サイトの記事を丸ごと入力して「別の言葉で書き直して」と頼む使い方です。出力は元の記事にもとづいていることが明らかで、構成や言い回しが残れば類似性も認められやすくなります。
他人の文章を入力すること自体は、内部の検討にとどまるなら問題になりにくい場面もあるでしょう。けれど、その出力を公開した時点で、入力した記事との類似性と依拠性の両方を抱えた文章になってしまいますよね。
AIには事実の整理や構成案の壁打ちを任せ、表現の土台に他人の記事を使わない。この使い分けで、リスクの多くを減らせます。
事実は一次情報から取り、AIの文章は検索で照合する
事実やデータそのものに著作権はありません。統計の数字や制度の内容は、官公庁や企業の一次情報から自分で取り、自分の言葉で書けば、表現が他人の記事と重なる心配は小さくなります。
そのうえで、AIが出した文章のうち特徴的な一文を、かぎかっこ付きで検索してみてください。同じ言い回しの記事が見つかれば、その段落は書き直すのが無難です。
一次情報を軸にした書き方は、著作権の予防だけでなく記事の独自性にも効きます。集め方は一次情報の4系統の取得術で整理しました。事実は一次情報から、表現は自分でが基本の形です。
引用は人が32条の要件を確かめて行う
他人の文章を記事に載せたいときは、著作権法32条の「引用」として行います。文化庁の講習会資料では、公表された著作物であること、引用部分がかぎかっこなどで明確に区別されていること、自分の文章が主で引用が従という主従関係、必要最小限の分量、出所の明示などが条件として挙げられています(文化庁「著作権制度の概要」令和6年度講習会資料)。
AIに「引用して」と頼んでも、AIはこの条件を満たしているかを保証してくれません。かぎかっこの中の文が原文と一字一句同じか、出典が正しいかを、原文を開いて人が確かめる必要があります。
AIが作った「それらしい引用文」が、実在しない文や別の人の発言だったという失敗も起きがちです。引用は、原文を見ながら人の手で貼ると決めておくと安心でしょう。
画像生成は類似の確認と規約の確認をセットにする
アイキャッチや図解をAIで作るときは、文章よりも類似に気づきにくい点に注意が要ります。作品名や作家名、キャラクター名を指示に入れないのが前提で、できあがった画像は画像検索で似たものがないか確かめておきたいところです。
あわせて、使うサービスの規約で商用利用の可否と、生成物の権利の扱いを確認します。無料版と有料版で条件が違うサービスもあるため、契約しているプランの規約を見るのが確実です。
文化庁のチェックリスト&ガイダンスも、AI生成物をさらに利用する場合は著作権侵害を生じさせないか確認するよう求めています。生成できたことと、公開してよいことは別だと押さえておくと判断しやすくなるはずです。
【置き土産】公開前の著作権チェックリストと場面別の早見表
AIを使った記事を公開する前に、上から順に確かめられるリストです。記事ごとに記録を残しておくと、万一問い合わせが来たときに説明できます。
- 他人の記事・作品を入力して書き換えさせていないか
- 指示に作品名・作家名・キャラクター名を入れていないか
- 特徴的な一文を検索し、同じ言い回しがないか確かめたか
- 数字や制度は一次情報で確かめ、自分の言葉で書いたか
- 引用は原文と一致し、区別・主従・出所の明示を満たすか
- AI画像は画像検索で似たものがないか見たか
- 使ったサービスの規約で商用利用の条件を確かめたか
- 使ったAI・指示・人が直した箇所を記録したか
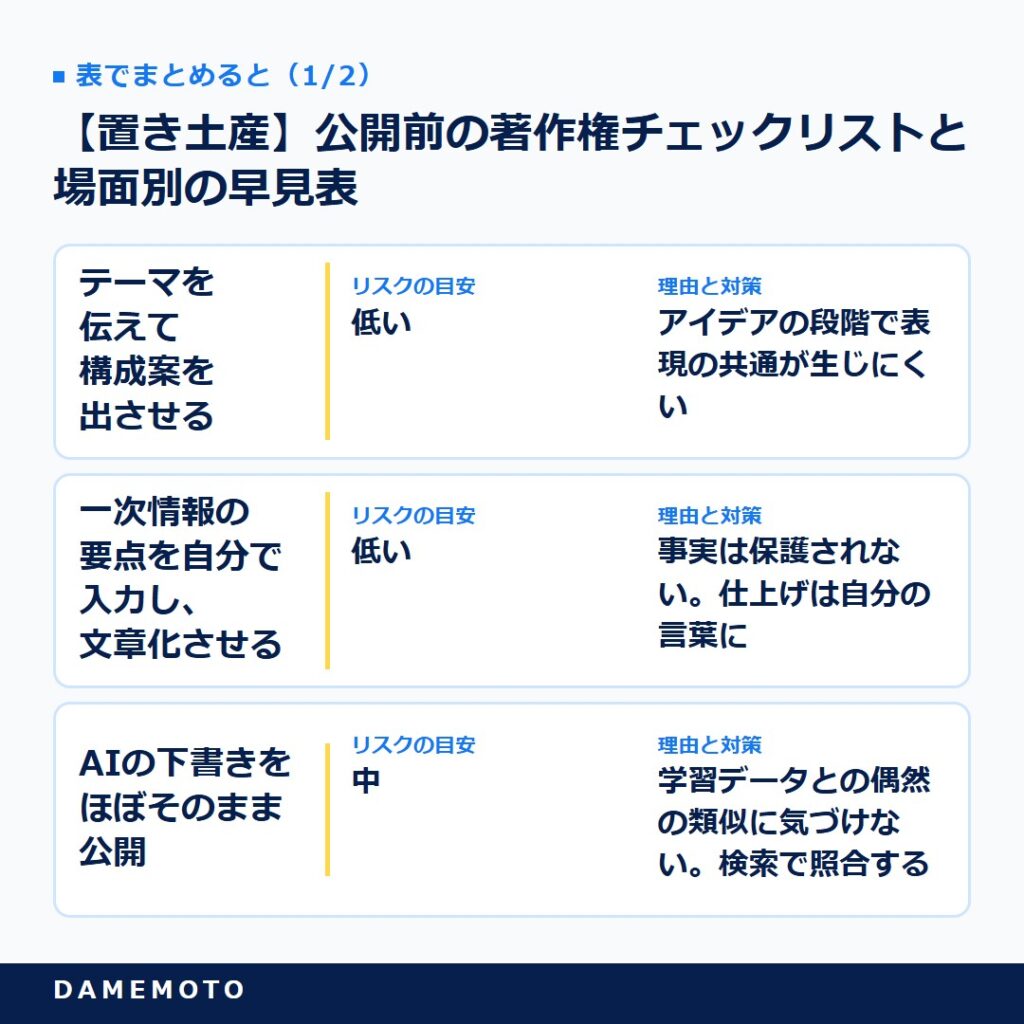
次の早見表は、記事作成でよくある使い方を、この記事で確かめた文化庁の整理にあてはめた編集部の目安です。最終的な判断は個別の事情で変わるので、迷う案件は専門家に相談してください。
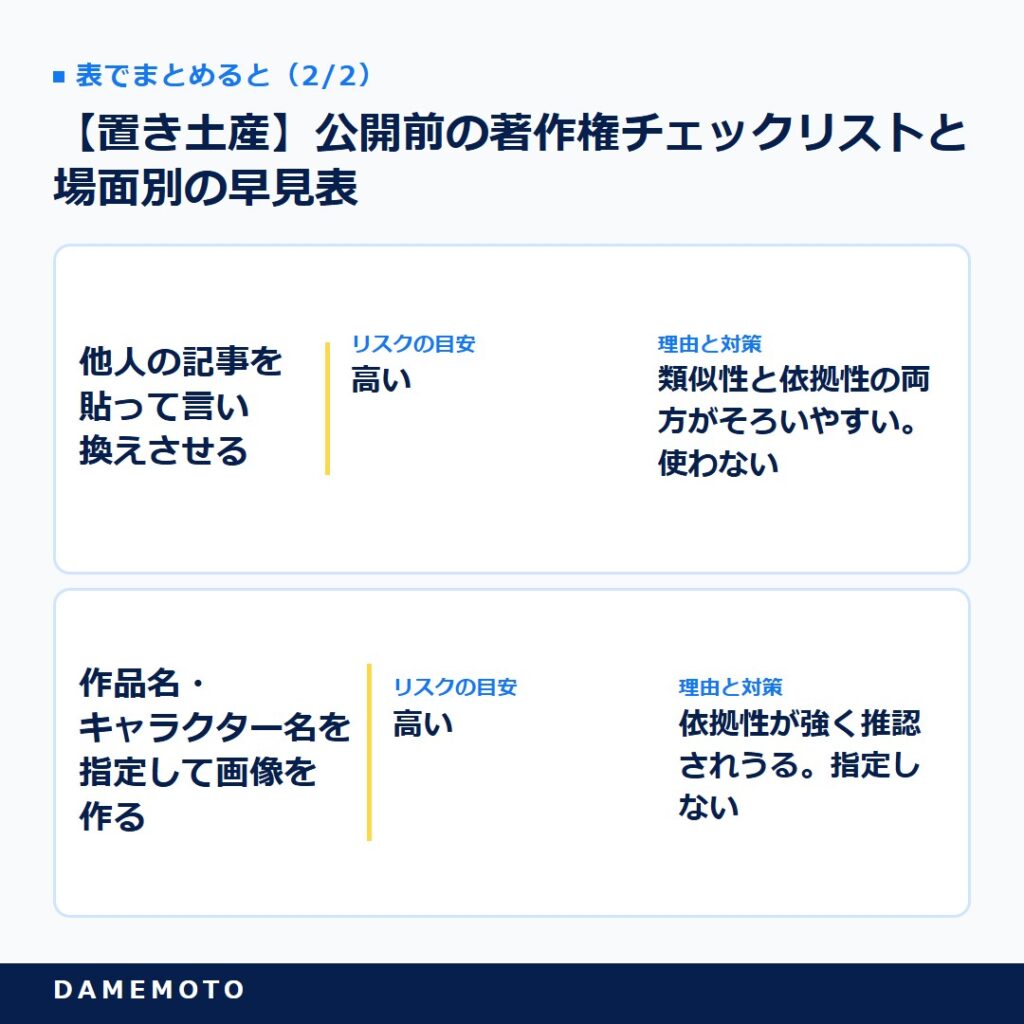
表で詳しく見る
| 使い方 | リスクの目安 | 理由と対策 |
|---|---|---|
| テーマを伝えて構成案を出させる | 低い | アイデアの段階で表現の共通が生じにくい |
| 一次情報の要点を自分で入力し、文章化させる | 低い | 事実は保護されない。仕上げは自分の言葉に |
| AIの下書きをほぼそのまま公開 | 中 | 学習データとの偶然の類似に気づけない。検索で照合する |
| 他人の記事を貼って言い換えさせる | 高い | 類似性と依拠性の両方がそろいやすい。使わない |
| 作品名・キャラクター名を指定して画像を作る | 高い | 依拠性が強く推認されうる。指定しない |
チェックを1人で回すと見落としが出やすいものです。書いた人以外がもう一度確かめる流れは、AI記事を公開前に点検する人間レビューの4ステップに組み込むと続けやすくなります。
自分の記事がAIに使われる側の考え方|robots.txtと30条の4
Webメディアを運営していると、AIを使う側であると同時に、自分の記事をAIに使われる側でもありますよね。ここは検索上位の解説で触れられることが少ない論点ですが、「考え方」はかなり具体的に書いています。
「学習に使わないで」と書くだけでは止められない
サイトに「AI学習への利用を禁止します」と書いておけば守れる、と考えている方もいるかもしれませんね。しかし「考え方」は、著作権者が反対の意思を示していることだけをもって、30条の4のただし書に当たるとは考えられないとしています。
30条の4は、権利者の意思にかかわらず一定の利用を認める規定だからです。意思表示は無意味ではないものの、法的に学習を止める決め手にはならないという整理になります。
なお、利用規約で禁止した場合に契約上どう扱われるかは、著作権とは別の問題です。著作権法の上では、文言だけの禁止表示に頼りすぎないのが現実的でしょう。
robots.txtの制限には法的な意味が生まれうる
一方で「考え方」は、robots.txtやID・パスワードでAI学習用クローラーのアクセスを制限する技術的な措置を、権利者が自由にとれるものと位置づけます。
そのうえで、こうした措置があり、かつ過去の実績などから、サイトのデータを情報解析用のデータベースとして将来販売する予定があると推認される場合には、措置を回避して大量に収集する行為がただし書に当たりうるとしています。例に挙がるのは、米ニューヨーク・タイムズがAI学習用クローラーをブロックしつつ、別にライセンスを提供している事例です。
つまりrobots.txtは技術の設定であると同時に、法的な判断の材料にもなりうるということです。ただし、データを販売する予定のない一般のブログにまで同じ効果があるとは書かれていません。
学習を止めるとAI検索での露出も減りうる
AIクローラーには、学習用のものと、AI検索の回答のためにページを取りに来るものがあります。学習を嫌って一律にブロックすると、AIの回答で引用される機会まで失いかねません。
SEOメディアとしては、学習用は方針しだいで制限し、回答・検索用は許可するという切り分けが現実的な落としどころになりやすいでしょう。ボットごとの名前と書き方はAIクローラー制御のrobots.txt記述例に最新の一覧をまとめています。
独自調査や有料データのように、学習されると競争上不利になる資産を持つサイトほど制限の意味は大きくなるはずです。守りたい資産があるかどうかで、ブロックの範囲を決めるのが筋だと思います。
プリンシプル・コードでクローラーの開示が進む
2026年8月25日、政府の知的財産戦略本部は「生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コード」を公表しました(カレントアウェアネス・ポータル・2026年8月)。生成AI事業者に、原則を実施するか、しない理由を説明するかを求める「コンプライ・オア・エクスプレイン」の方式をとっています。
コードの本文は、robots.txtなどの機械可読な指示に従うクローラーの採用、ユーザーエージェントごとの措置の公開、海賊版サイトへのクロール回避、権利者の申出窓口の整備などを開示の対象に挙げています(知的財産戦略本部「プリンシプル・コード」本文)。
法的拘束力のある規範ではありませんが、サイト運営者がどのクローラーを止めればよいかを知る手がかりが増える方向の動きといえます。生成AIを組み込んだサービスを公衆に提供する企業は、自社が「生成AI提供者」に当たるかも確かめておきたいところです。
2026年10月時点の最新動向|国内外の判例と政府の動き
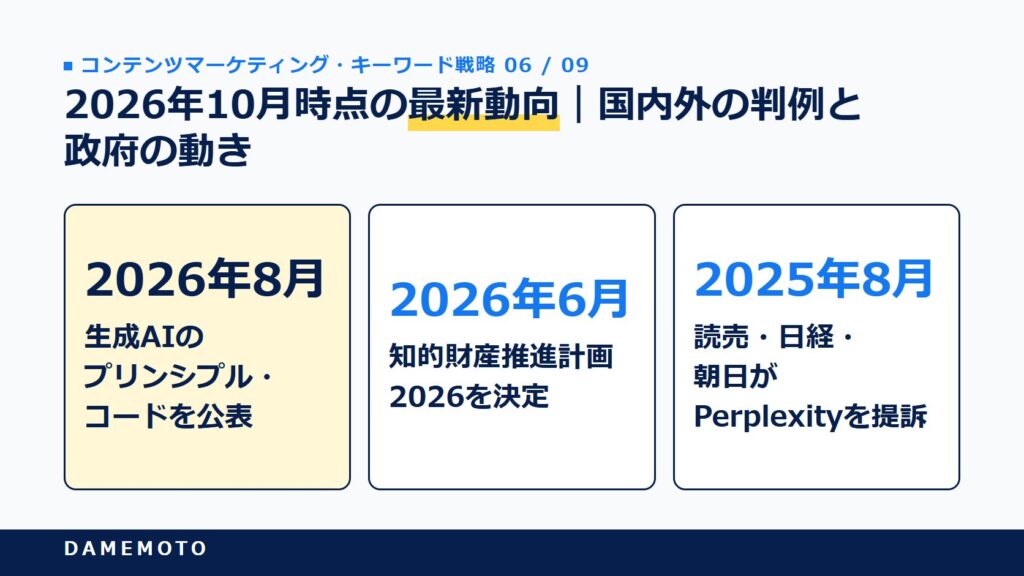
生成AIと著作権のルールは、法改正よりも裁判と政府の指針で少しずつ形が決まっている段階です。2026年10月時点で、記事を作る人が知っておきたい動きを国内と海外に分けて整理します。
国内の政策:知的財産推進計画2026と法改正の状況
政府は2026年6月12日に「知的財産推進計画2026」を決定しました(首相官邸・2026年6月12日)。生成AIについてはプリンシプル・コードの策定などが盛り込まれ、あわせて知的財産権の侵害全般について、損害の回復を確実にする民事救済措置の検討も掲げられました。
一方、30条の4そのものを見直す法改正は、2026年10月時点で行われていません。2026年6月に成立した著作権法の改正は、レコード演奏・伝達権の創設が中心です(文化庁「令和8年特別国会 著作権法改正について」)。この記事で紹介した「考え方」の整理は、引き続き現行法を読むうえでの基本になります。
ルールの土台は変わらず、事業者の透明性と権利者の救済を厚くする方向で運用が固まりつつあると見るのが妥当でしょう。
国内の訴訟と摘発:新聞社のPerplexity提訴と生成AI画像の書類送検
2025年8月、読売新聞社がAI検索サービスのPerplexityを東京地裁に提訴し、同月には日本経済新聞社と朝日新聞社も提訴しました。記事の無断利用が争点で、読売新聞の訴訟は2026年5月に第1回口頭弁論が開かれ、Perplexity側は争う姿勢を示したと報じられています(読売新聞オンライン・2026年5月26日)。判決はまだ出ていません。
2025年11月20日には、千葉県警が、生成AIで作られた画像を無断で複製し書籍の表紙に使ったとして、27歳の男性を著作権法違反の疑いで書類送検したと報じられました(Ledge.ai・2025年11月)。生成AI画像を著作物と判断した全国初の摘発とされています。
ただしこれは捜査機関の判断で、裁判所が生成AI画像の著作物性を認めたわけではありません。AIで作った画像でも、無断で使えば摘発されうることを示した事例として受け止めておきたいところです。
米国:学習のフェアユースと海賊版の線引き
米国では、作家らがAnthropicを訴えたBartz v. Anthropic事件で、2025年6月に地裁が「書籍での学習自体と、購入した紙の本の電子化はフェアユース。海賊版の入手・保存はフェアユースに当たらない」と判断しました。その後15億ドルの和解が成立し、2026年7月に最終承認されたと報じられています。弁護士費用などをめぐる控訴は係属中とされます(Authors Guild・2026年7月)。
生成AIではない法律調査AIをめぐるThomson Reuters v. Ross事件では、2026年9月に連邦第3巡回区控訴裁判所が、フェアユースを認めなかった地裁の判断を維持したと報じられました(IPWatchdog・2026年9月30日)。
米国はフェアユースという一般規定で判断するため、日本の30条の4とは仕組みが別物です。それでも「データをどう手に入れたか」が問われる流れは、日本の事業者にとっても無関係ではないと感じます。
欧州:出力に作品が残れば侵害とした判決
ドイツでは2025年11月11日、ミュンヘン地裁が音楽著作権団体GEMAの訴えの主要部分を認め、OpenAIのモデルが歌詞を記憶して出力したことを侵害と判断しました(GEMA・2025年11月)。OpenAIは控訴しており、判決は確定していません。
英国では、Getty ImagesがStability AIを訴えた事件で、2025年11月の高等法院判決が著作権の二次侵害の主張を退けました(英国National Archives「Getty Images v Stability AI」判決文)。モデルの中に作品の複製が含まれるかという点で、英国とドイツの判断は異なる方向を示しました。英国の事件では、学習や出力に関する主張は途中で取り下げられています。
ただ、出力に元の作品がそのまま現れた場合に厳しく見る点は、日本の「考え方」とも通じる部分があります。利用者が気をつけるべきは、やはり出力の中身だといえるでしょう。
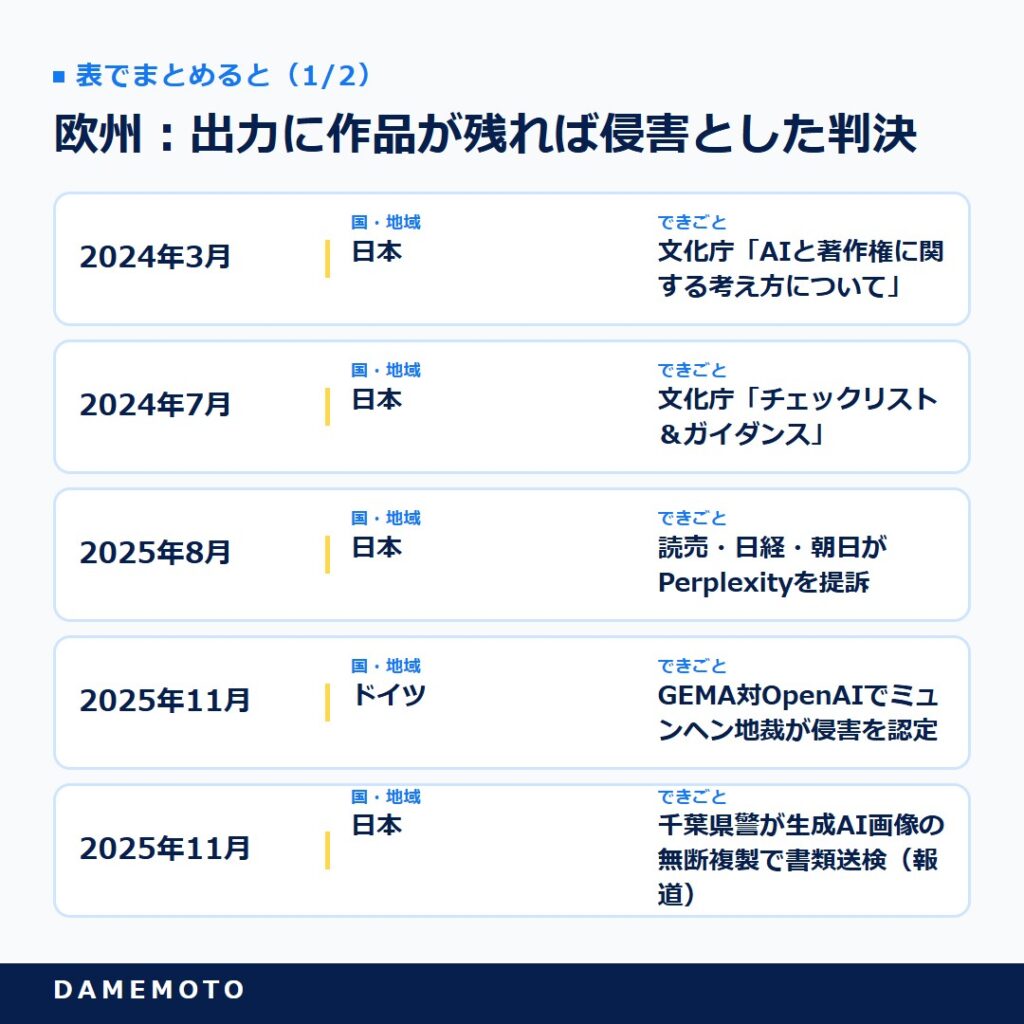
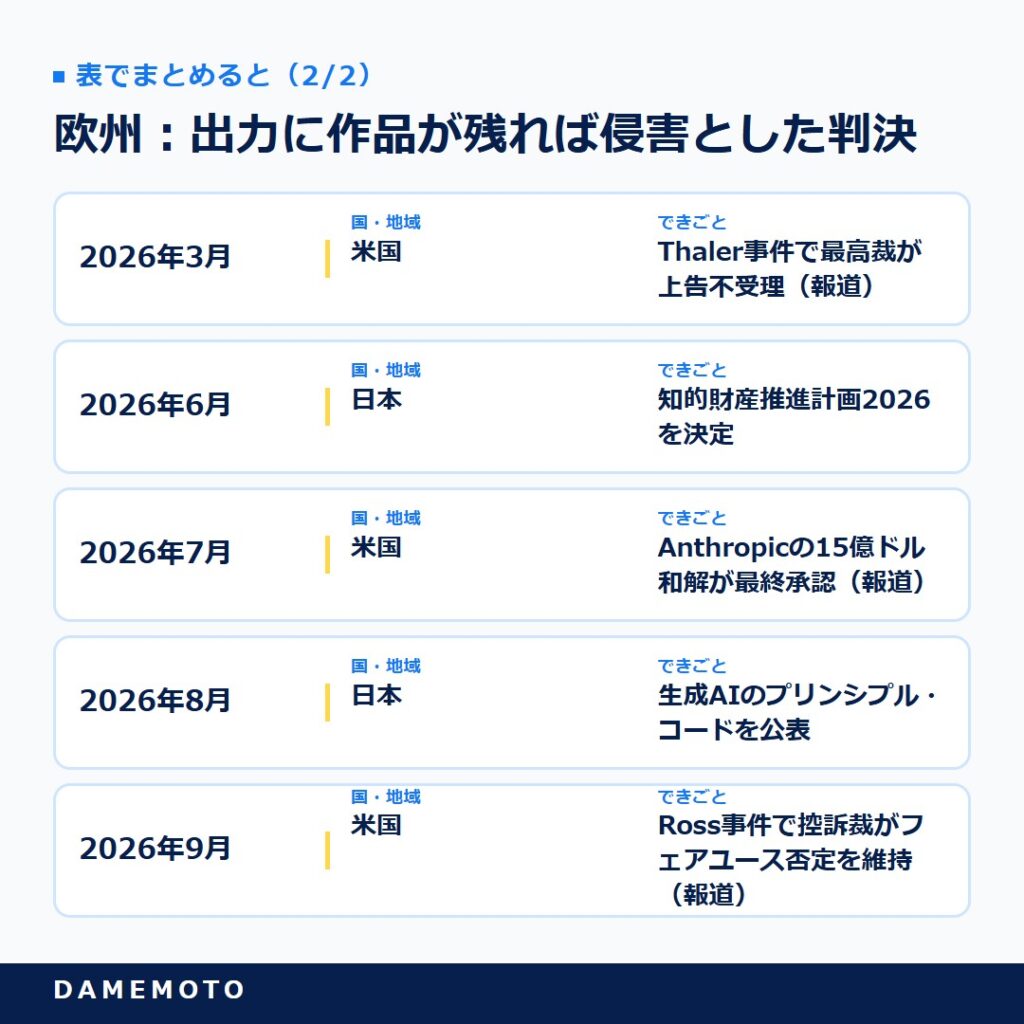
表で詳しく見る
| 時期 | 国・地域 | できごと |
|---|---|---|
| 2024年3月 | 日本 | 文化庁「AIと著作権に関する考え方について」 |
| 2024年7月 | 日本 | 文化庁「チェックリスト&ガイダンス」 |
| 2025年8月 | 日本 | 読売・日経・朝日がPerplexityを提訴 |
| 2025年11月 | ドイツ | GEMA対OpenAIでミュンヘン地裁が侵害を認定 |
| 2025年11月 | 日本 | 千葉県警が生成AI画像の無断複製で書類送検(報道) |
| 2026年3月 | 米国 | Thaler事件で最高裁が上告不受理(報道) |
| 2026年6月 | 日本 | 知的財産推進計画2026を決定 |
| 2026年7月 | 米国 | Anthropicの15億ドル和解が最終承認(報道) |
| 2026年8月 | 日本 | 生成AIのプリンシプル・コードを公表 |
| 2026年9月 | 米国 | Ross事件で控訴裁がフェアユース否定を維持(報道) |
正直なところ:この記事だけでは分からないこと
お伝えしておくべき限界があります。第一に、生成AIと著作権を直接扱った日本の判決は、2026年10月時点でまだほとんどありません。この記事の整理は文化庁の「考え方」に多くを頼っていて、裁判所が同じ結論を出すとは限らない点に注意が必要です。
第二に、類似性の判断は作品ごとの比較で決まり、「何割似ていたら侵害」という数字の基準はありません。チェックリストや早見表は予防の目安で、個別の案件が適法かどうかを判定するものではない点をご了承ください。この記事は法的助言ではないので、公開済みの記事に指摘を受けたときなどは弁護士に相談するのが確実です。
第三に、肖像や声、商標、不正競争防止法など、著作権以外の権利はこの記事の対象外です。専門家のチェックを記事制作に組み込む方法は専門家監修の取り入れ方3ステップが参考になります。
そして本音を言えば、著作権を守れていても、AIの文章を並べただけの記事は読まれません。権利の確認は最低限の守りで、記事の価値は一次情報と検証で決まるのです。全体の設計はコンテンツSEOの設計図と構築ロードマップで整理しています。
迷ったら「既存の作品を持ち込まない・出力を照合する」
DAMEMOTO代表鈴木ルールが固まるまでは、似ていないことを自分で確かめるのが一番の守りです
よくある質問
- 生成AIで作った文章は著作権侵害になりますか?
-
AIを使ったことだけを理由に侵害になるわけではありません。既存の作品と表現が似ていて(類似性)、その作品にもとづいている(依拠性)場合に侵害になりえます。
- 生成AIの学習に著作物を使うのは違法ですか?
-
日本では著作権法30条の4により、情報解析などの非享受目的なら原則として許諾なしにできます。ただし、学習データの表現をそのまま出力させる目的の追加学習や、情報解析用に販売されているデータベースの複製など、例外に当たる場合は許諾が必要になることもあるのです。
- AI生成物に著作権は発生しますか?
-
簡単な指示だけで作ったものは、著作物と認められにくいと考えられています。文化庁の「考え方」は、表現を具体的に示す指示、出力を見ながら指示を直す試行、人による創作的な加筆・修正などが積み重なれば、著作物性が認められうるという立場です。
- 元の作品を知らなければ、生成AIの出力で著作権侵害にならないのでは?
-
そうとは限りません。利用者が知らなくても、AIがその作品を学習していれば、似た出力には通常、依拠性が推認されると文化庁は整理しています。
- 「商用利用可」の生成AIなら著作権の心配はいりませんか?
-
いいえ。規約の商用利用の許可は、サービスとの契約の話です。出力が第三者の作品に似ていれば、規約とは関係なく侵害の問題になります。
- 他人の記事をAIに要約させてブログに載せると著作権上問題ですか?
-
著作権侵害を問われるおそれがある使い方です。要約でも元の記事の表現が残れば類似性が、元の記事を入力した事実から依拠性が認められやすくなります。紹介したいなら、32条の引用の要件を満たす形で一部を引用し、自分の論評を主にして書くのが基本です。
- 自分のサイトの記事を生成AIの学習に使われないようにできますか?
-
robots.txtで学習用クローラーを制限するのが現実的な方法です。「学習禁止」と書くだけでは30条の4のただし書に当たらないと文化庁は整理しています。ただし、学習用と回答用のボットを一律に止めると、AI検索で引用される機会も減りかねません。
- 生成AIと著作権のルールは2026年に変わりましたか?
-
生成AIに関わる30条の4・47条の5の条文は、2026年10月時点で変わっていません(2026年6月の著作権法改正は、レコード演奏・伝達権の創設が中心です)。変わったのは運用の面で、6月の知的財産推進計画2026にプリンシプル・コードの策定が盛り込まれ、8月にそのコードが公表されました。
まとめ:生成AIと著作権は「段階」と「出力の中身」で判断する
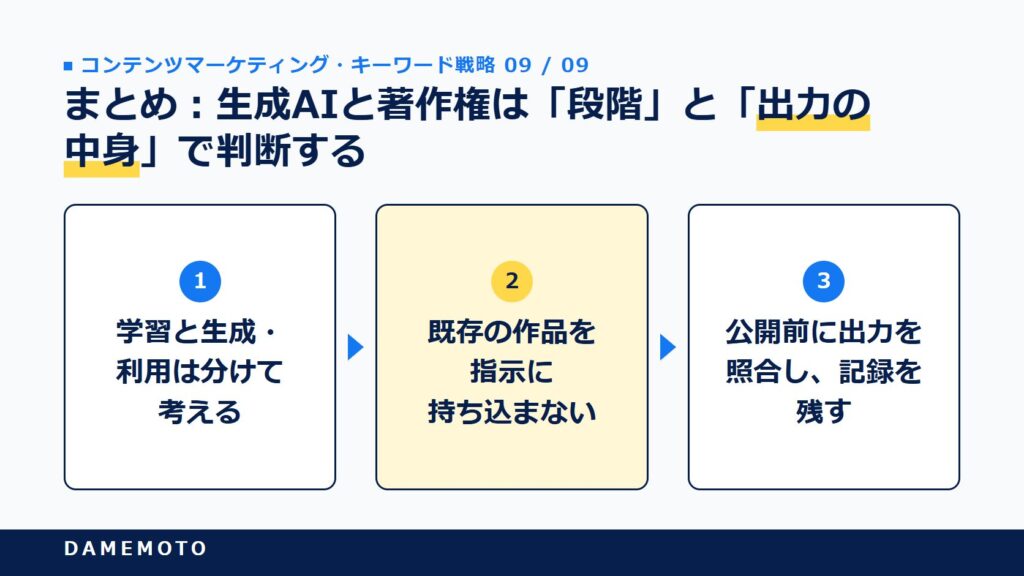
生成AIと著作権は、AIの学習と、生成物の公開とで考え方が分かれます。学習は30条の4で原則として許諾がいりませんが、生成物を公開する場面では、人が作ったものと同じく類似性と依拠性で侵害が判断される仕組みです。
AI生成物に著作権が生まれるかは、人の創作的寄与しだいです。記事作成では、他人の作品を入力に持ち込まず、出力を検索で照合し、引用は人が要件を確かめて行う。この3つを守ることで、多くのリスクを減らせます。
2026年はプリンシプル・コードの公表など運用面の動きが続きました。判例が増えれば整理が変わる可能性もあるので、文化庁や政府の発表を定期的に確かめていきましょう。
- 学習と生成・利用は分けて考える
- 既存の作品を指示に持ち込まない
- 公開前に出力を照合し、記録を残す
- 守りたい記事はrobots.txtで方針を決める
参考URL一覧
- 文化庁・AIと著作権について(考え方・チェックリスト&ガイダンスの掲載ページ/公式):https://www.bunka.go.jp/seisaku/chosakuken/aiandcopyright.html
- 文化庁・AIと著作権に関する考え方について(本文PDF/公式):https://www.bunka.go.jp/seisaku/bunkashingikai/chosakuken/pdf/94037901_01.pdf
- 文化庁・著作権制度の概要(令和6年度講習会資料・引用の条件/公式):https://www.bunka.go.jp/seisaku/chosakuken/seidokaisetsu/seminar/2024/pdf/94088901_01.pdf
- 文化庁・令和8年特別国会 著作権法改正について(公式):https://www.bunka.go.jp/seisaku/chosakuken/hokaisei/r08_hokaisei/index.html
- e-Gov法令検索・著作権法(公式):https://laws.e-gov.go.jp/law/345AC0000000048
- 知的財産戦略本部・生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コード(公式):https://www.cas.go.jp/jp/seisakukaigi/titeki2/ai_kentoukai/kaisai/pdf/ai_principle_code.pdf
- カレントアウェアネス・ポータル・プリンシプル・コードの公表(2026年8月):https://current.ndl.go.jp/car/284024
- 首相官邸・知的財産戦略本部(知的財産推進計画2026の決定/公式):https://www.kantei.go.jp/jp/105/actions/202606/12chizai.html
- OpenAI・Terms of Use(出力の権利の扱い/公式):https://openai.com/policies/row-terms-of-use/
- 読売新聞オンライン・Perplexity訴訟の第1回口頭弁論(2026年5月):https://www.yomiuri.co.jp/national/20260526-GYT1T00339
- Ledge.ai・千葉県警の生成AI画像をめぐる書類送検(2025年11月):https://ledge.ai/articles/gen_ai_image_copyright_case_chiba_police
- U.S. Copyright Office・Copyright and Artificial Intelligence(公式):https://www.copyright.gov/ai/
- Mayer Brown・Thaler事件の上告不受理(2026年3月):https://www.mayerbrown.com/en/insights/publications/2026/03/supreme-court-denies-review-in-ai-authorship-case
- Authors Guild・Anthropic和解の最終承認(2026年7月):https://authorsguild.org/news/court-grants-final-approval-anthropic-copyright-settlement/
- IPWatchdog・Thomson Reuters v. Ross控訴審(2026年9月):https://ipwatchdog.com/2026/09/30/third-circuit-affirms-revised-fair-use-ruling-against-ross-ai-legal-research-platform-in-sealed-opinion/
- GEMA・GEMA対OpenAIのミュンヘン地裁判決(2025年11月/当事者):https://www.gema.de/en/w/landmark-ruling-gema-against-openai
- 英国National Archives・Getty Images v Stability AI判決文(2025年11月4日/公式):https://caselaw.nationalarchives.gov.uk/ewhc/ch/2025/2863
関連する最新ニュース