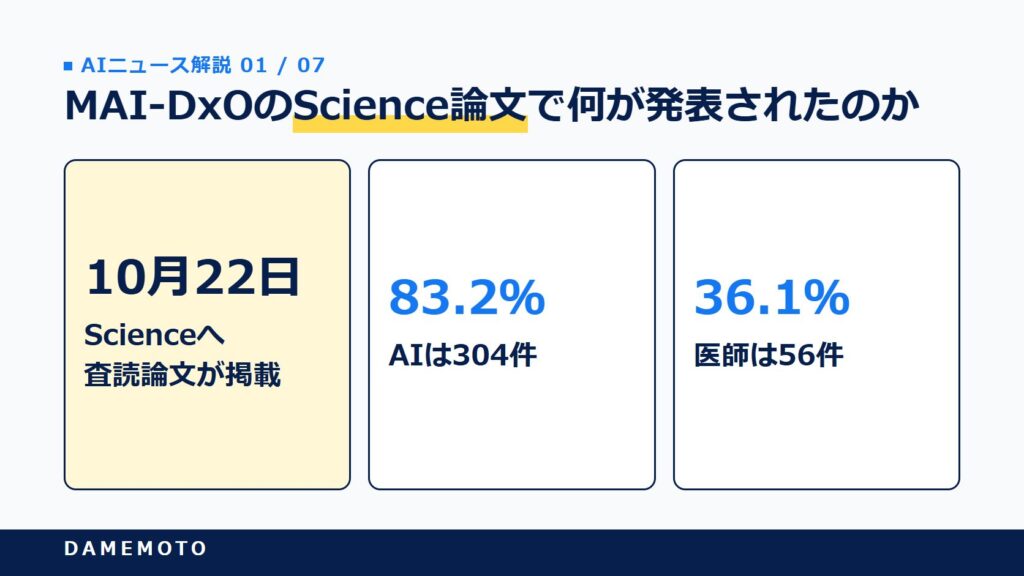
Microsoftは2026年10月22日、診断AI「MAI-DxO(Microsoft AI Diagnostic Orchestrator)」の論文が科学誌Scienceに掲載されたと発表しました。
NEJM(New England Journal of Medicine)の難しい症例304件で正答率83.2%となり、比較した一般診療医の36.1%を上回ったという内容です。
ただし、この2つの数字は同じ症例・同じ条件で並べたものではありません。
業務でAIを使うマーケ担当やWeb担当役員にとっては、「1つのAIに役を分けて検証させる設計」が精度と費用にどう効いたかを、査読論文の数字で確かめられるニュースです。
この記事のポイント
- 2026年10月22日にScienceへ査読論文が掲載
- 83.2%はAIが304件、36.1%は医師が56件で出した数字
- 費用の上限をかけない設定は、医師より検査費が高かった
- 設計の上積みはGPT-5で約4ポイント、GPT-5.5ではさらに拡大
- 臨床ではまだ使われておらず、製品化の発表もない
本記事は、Scienceの論文ページ(2026年10月22日)とMicrosoft AIの公式ブログを一次情報とし、2025年11月8日付の改訂原稿、TechCrunch、The Verge、Medical Economicsなどの報道と照らし合わせています。
情報は2026年10月24日夜の時点のものです。医療の判断に使う情報ではなく、AIの設計と数字の読み方の話として整理しています。
MAI-DxOのScience論文で何が発表されたのか
「AIが医師の2倍以上正確」という見出しを見かけた方もいるかもしれませんね。まずは論文に書かれている事実を、条件ごと確かめていきます。
2026年10月22日にScienceへ掲載
論文の題名は「Sequential diagnosis with language models」で、Scienceの第394巻6822号(423〜428ページ)に掲載されました(Scienceの論文ページ)。
Microsoft AIの公式ブログも同じ日に「本日Scienceに掲載された」と書いています(Microsoft AIの公式ブログ)。
テーマは、症状のまとめが最初からそろっている問題ではなく、主訴から始めて、質問と検査を自分で選びながら診断にたどり着く「段階的な診断」です。
著者15人は全員がMicrosoftの社員で、同社の株を持ち、Microsoft以外からの資金は受けていないと論文に明記されています。
83.2%と36.1%の中身
評価には、NEJMの臨床病理カンファレンスの症例304件と、救急外来から入院に至った症例325件(MIMIC-IV-ED)を使っています。
MAI-DxO(GPT-5を土台にした設定)の正答率は、NEJMの症例で83.2%、救急の症例で80.3%でした。比較した一般診療医の正答率は、それぞれ36.1%と46.8%です。
医師の36.1%は、UpToDateのような参考資料を使える条件での数字です。参考資料を使えない条件では22.3%でした。
2025年11月8日付の改訂原稿によると、参考資料ありの条件で使えたのはUpToDateなどの静的な資料で、ChatGPTのような生成AIは除外されていました。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
数字を読むときに押さえたい3つの条件
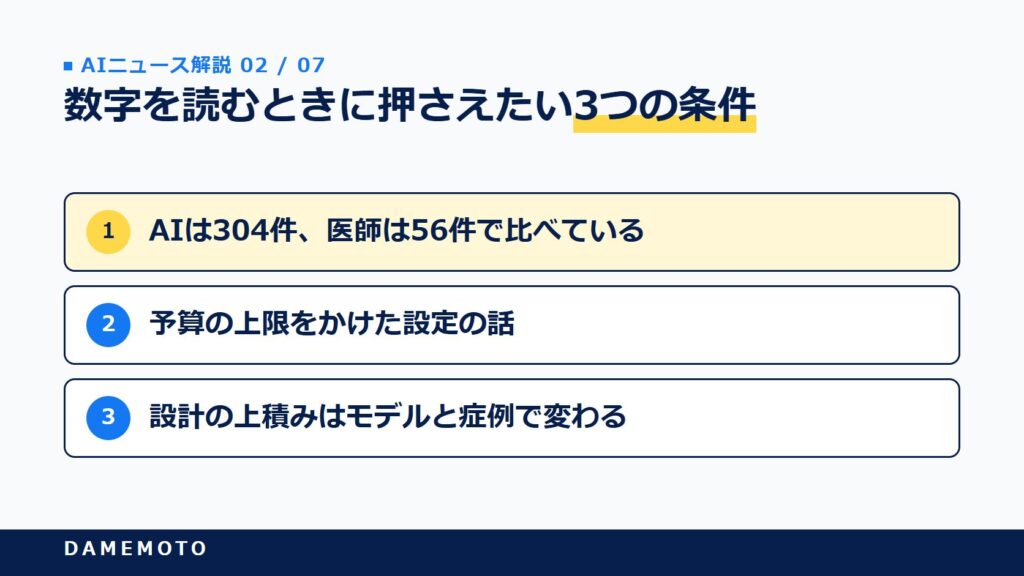
見出しの数字だけを社内で共有すると、あとで説明に困ることがありますよね。論文の本文と報道を突き合わせると、少なくとも3つの条件を添えて読む必要があります。
AIは304件、医師は56件で比べている
NEJMの症例で医師が解いたのは、開発中にAI側が見ていない56件だけです。AIの83.2%は304件全体の成績なので、同じ問題を同じ数だけ解いた比較ではありません。
なお、2025年7月版の原稿には、56件のほうがAIの成績は良い傾向がある、という記述もあります。56件だけでのMAI-DxOの正答率は、本記事の取材では確認できていません。
比較の相手も、専門医や多職種のチームではなく、個人の一般診療医です。論文自身が「専門医や多職種チーム、実際の臨床に対する優位性を示すものではない」と書いています。
「費用が低い」は予算の上限をかけた設定の話
公式ブログは「半分から3分の1の費用で」と表現しています。
一方で論文の数字を見ると、費用の上限をかけない設定のMAI-DxOは、NEJMの症例で1件あたり平均5,431ドルと、参考資料ありの医師の4,725ドルより高くなっていました。
救急の症例でも4,979ドルと、医師の3,400ドルを上回っています。
安くなるのは予算の上限をかけた設定で、正答率80.9%で2,241ドル、79.6%で1,303ドルでした。ここでいう費用は、米国の病院の価格表から見積もった検査の費用(問診は一律の診察料として計上)で、AIの利用料ではありません。
設計の上積みはモデルと症例で変わる
改訂原稿とTechCrunchによると、GPT-5を単独で使った場合でも、NEJMの症例で正答率78.9%(1件あたり8,409ドル)に達していました。
MAI-DxOの設計を加えた上積みは約4ポイントで、検査費は約3,000ドル下がっています。
TechCrunchは、この組み合わせでは改善の多くが強いモデルから来ている、と指摘しています。
論文によると、さまざまな会社のモデルの平均では、上積みはNEJMの症例で7.9ポイント、救急の症例で4.4ポイントでした。
さらに論文は、最も新しいGPT-5.5では、土台のモデル単独に対する上積みがむしろ大きくなったと書いています。
TechCrunchによると、GPT-5.5は難症例で72%から約87%に上がった一方、救急の症例ではほぼ差がありませんでした。
土台が強くなれば設計は要らなくなる、とは言えず、効き方は症例の種類で変わると読むのが妥当だと思います。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
役割を分けて検証させる設計の中身
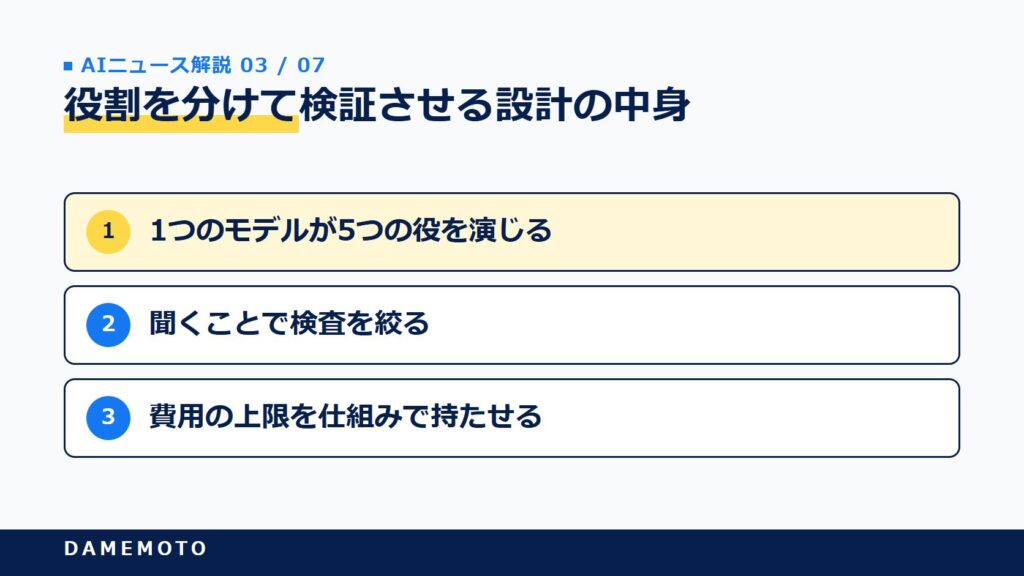
MAI-DxOの「オーケストレーター」は、AIの仕事の分け方そのものを指しています。業務でAIを使う人にとって参考になるのは、むしろこの部分ではないでしょうか。
1つのモデルが5つの役を演じる
Science本文は、MAI-DxOを「補い合う役割を持つ専門家のパネルを模擬する」仕組みと説明しています。
2025年11月8日付の改訂原稿によると、別々のAIを並べるのではなく、1つの言語モデルが5つの役を演じて討議する設計です。
役の名前は改訂原稿に書かれたもので、Science本文には出てきません。
- 仮説の役:可能性の高い診断の上位3つを持ち、新しい所見のたびに見直す
- 検査を選ぶ役:1回に最大3つ、候補を最もよく見分けられる検査を選ぶ
- 反対の役:思い込みを指摘し、仮説を覆す証拠や検査を挙げる
- 費用の役:同じ情報が安く得られるなら安い方を求め、価値の低い高額な検査を止める
- 点検の役:検査名の正しさや、パネルの判断の食い違いを確かめる
討議のあと、パネルは「質問する」「検査を頼む」「診断を確定する」のどれかを選びます。論文によると、最初の検査を頼むまでにMAI-DxOは平均25.5回質問し、医師は平均5.6回でした。聞くことで検査を絞る、という動き方がよく表れています。
費用の上限を仕組みで持たせる
改訂原稿によると、予算を設けた設定では、別の呼び出しが累計の費用を追い、上限を超えそうな検査を見積もりを見たうえで取り消せるようにしていました。
さらに、上限を変えた複数の設定を用意し、正答率と費用の両方で比べています。精度を最大にした設定は84.5%でしたが、費用も1件あたり8,945ドルと最も高い結果でした。
同じように役割を分けて長い仕事を任せる設計は、当サイトのGeminiエージェント4体がMinecraftを攻略した論文の記事でも取り上げました。分け方の考え方を比べてみると、違いが見えて面白いはずです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
2025年の発表から何が変わったのか
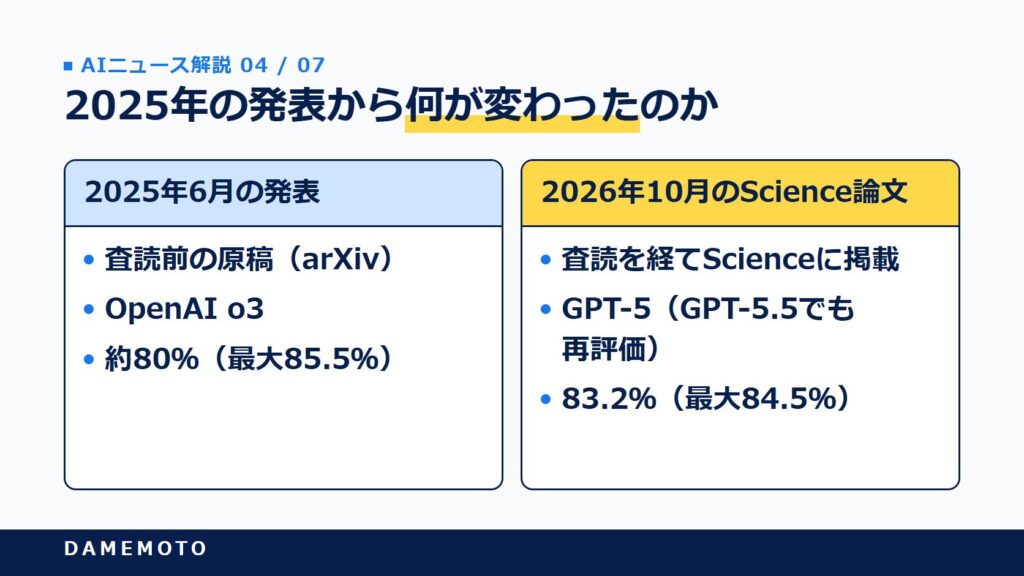
MAI-DxOは2025年6月30日にも発表され、「正答率85.5%」と話題になりました。今回の数字と単純に並べてよいのか、迷うところですよね。
同じ症例でもモデルと比較条件が違う
2025年6月の発表は、OpenAIのo3を土台にした査読前の原稿でした(2025年6月の公式ブログ)。
今回はGPT-5が土台で、救急の症例と参考資料ありの医師の実験が加わり、掲載前にGPT-5.5でも評価をやり直しています。
同じNEJMの304件でも、モデルの世代と比べる条件が違うので、85.5%から83.2%に下がったとは読めません。
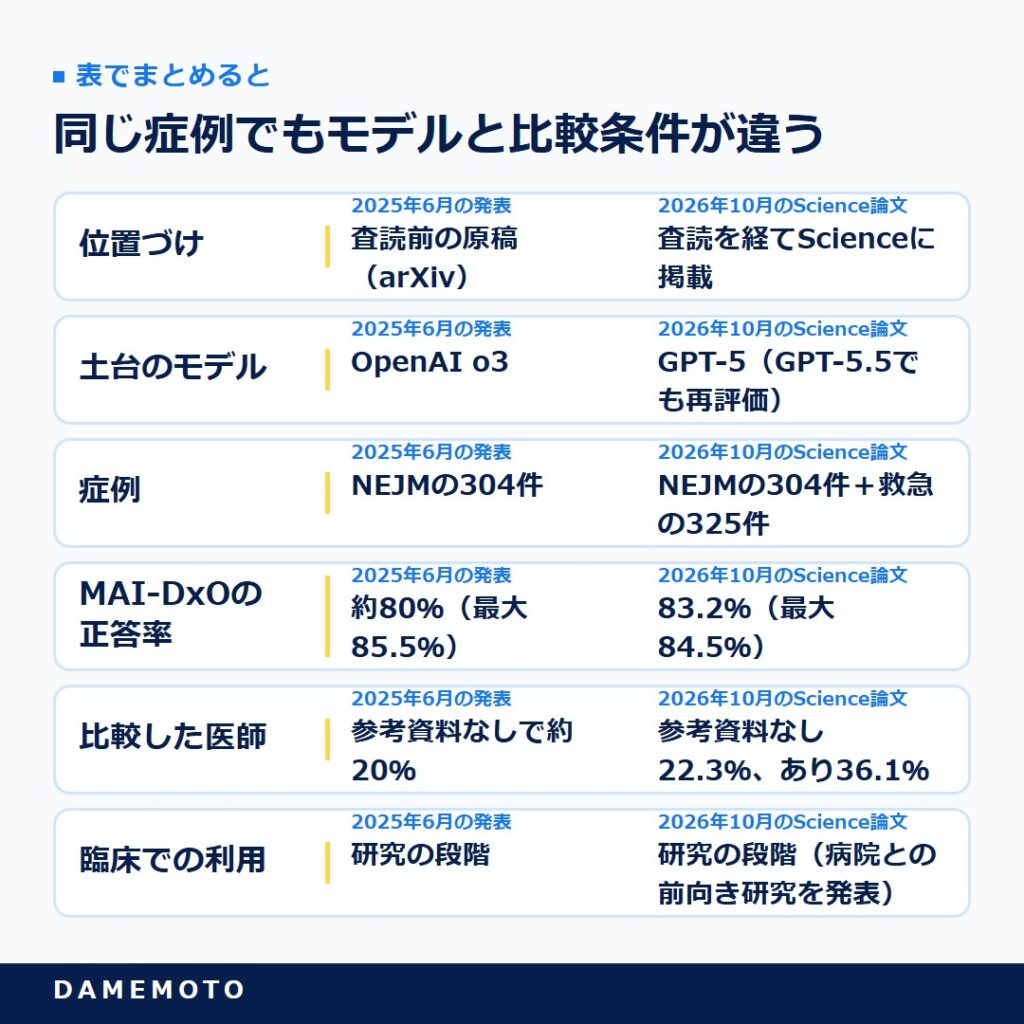
表で詳しく見る
| 項目 | 2025年6月の発表 | 2026年10月のScience論文 |
|---|---|---|
| 位置づけ | 査読前の原稿(arXiv) | 査読を経てScienceに掲載 |
| 土台のモデル | OpenAI o3 | GPT-5(GPT-5.5でも再評価) |
| 症例 | NEJMの304件 | NEJMの304件+救急の325件 |
| MAI-DxOの正答率 | 約80%(最大85.5%) | 83.2%(最大84.5%) |
| 比較した医師 | 参考資料なしで約20% | 参考資料なし22.3%、あり36.1% |
| 臨床での利用 | 研究の段階 | 研究の段階(病院との前向き研究を発表) |
臨床ではまだ使われていない
公式ブログは、ボストンのベス・イスラエル・ディーコネス医療センターと提携し、患者がシステムと直接やりとりして、医師の独立した判断と比べる前向き研究を行うと発表しました。
The Vergeによると、MicrosoftのDominic King氏は数か月のうちに始まる見込みと話しています。ただし、開始日や規模は発表されていません。
製品化や提供の時期についても、公式ブログ・論文・主な報道のどれにも発表はありません。Microsoftが公開したのは、評価に使う仕組み「SDBench」のコードです。
日本では、厚生労働省の2018年の通知が、AIの診断支援を使っても診断の主体は医師で、最終的な判断の責任も医師が負うとしています(厚生労働省医政局医事課長通知)。
このニュースで誰の何が変わるのか
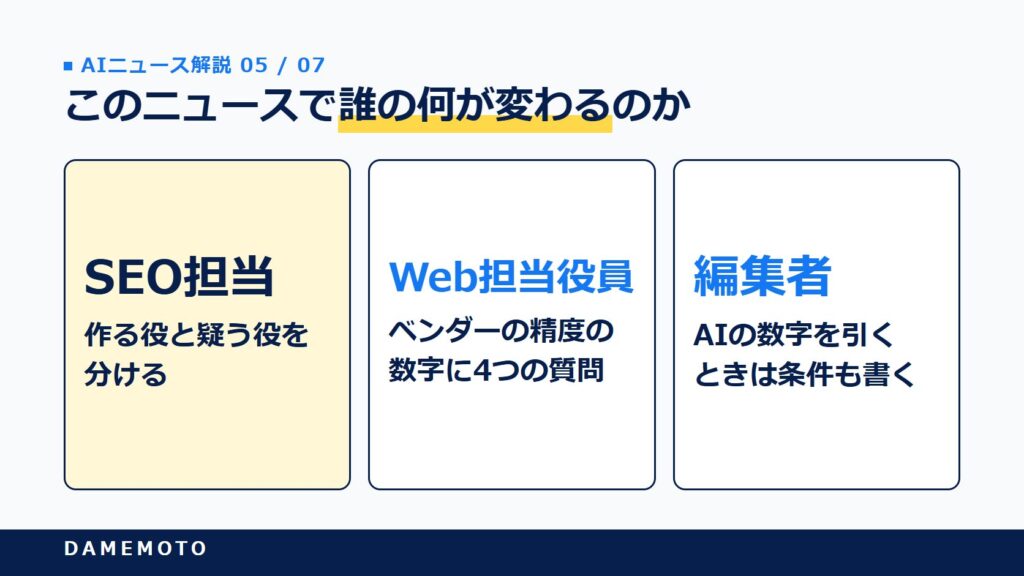
医療の話なので、自分の仕事とは遠いと感じるかもしれません。それでも、AIの設計と評価のしかたは、マーケティングやSEOの現場にもそのまま持ち込めます。
ここからの「明日からやること」と「その先」は、論文の考え方を業務に当てはめた提案で、論文が業務での効果を確かめたわけではありません。
BtoBマーケ担当・SEO担当:作る役と疑う役を分ける
AIに競合調査や記事の下書きを任せても、回答のばらつきが気になって確認の手間が減らない。そんな悩みはよくありますよね。
今回の論文は、役割を分けて討議させる仕組みで、同じモデルを単独で使うより、NEJMの難症例では正答率が上がり、検査費も抑えられたことを示しました(救急の症例では差が小さい組み合わせもありました)。
明日からやることは、重要な作業で作る指示と、間違いだけを探す指示を分け、指摘を戻して直す1工程を入れることです。手戻りが減ったかどうかを、1週間ほど数えてみるとよいでしょう。
この先は、どのAIを選ぶかと同じくらい、役をどう分けてどこで人が確かめるかが成果を分けるようになると考えられます。
Web担当役員:ベンダーの精度の数字に4つの質問
「精度○%」「費用○%減」という提案を受けても、どこまで信じてよいか判断しにくいものです。
今回の論文は、査読を経た研究でも、比べた症例の数や相手の条件、費用の定義によって印象が大きく変わる好例です。
明日からやることは、提案の数字に対して何件で測ったか、比較相手は何を使えたか、費用に何を含むか、誰が評価したかの4点を聞くことです。
論文が正答率と費用を同じ図に並べて比べたように、社内でも2つを並べて判断すると説明がしやすくなります。
この先は、ベンダー自身の評価だけでなく、第三者や自社での再検証を前提にした導入判断が広がっていく可能性があります。
オウンドメディア編集者:AIの数字を引くときは条件も書く
話題の研究を記事やSNSで紹介したいけれど、数字の扱いを間違えるのは怖い。編集者なら誰でも感じることではないでしょうか。
今回も「83%対36%」だけが広まりやすい一方で、症例の数や医師の条件が違うという大事な前提があります。
明日からやることは、AIの成果の数字を引用するとき、比べた件数と比較相手の条件を、数字のすぐ近くに一文で添えることです。医療や健康の話題では、とくに省かないほうが安全といえます。
この先は、数字の条件まで正確に書いた記事のほうが、読者にもAI検索にも信頼される情報源として扱われやすくなると考えられます。

83.2%という数字そのものより、役を分けて疑わせる設計と、精度と費用を同時に測る評価のしかたの方が、私たちの仕事には役立つと感じます
よくある質問
- MAI-DxOとは何ですか?
-
Microsoftが開発した診断AIの仕組みで、Microsoft AI Diagnostic Orchestratorの略です。言語モデルに複数の専門家の役を演じさせ、質問と検査を選びながら診断を進めます。研究の段階のシステムです。
- MAI-DxOの論文はいつ、どこに掲載されましたか?
-
2026年10月22日に、科学誌Scienceの第394巻6822号に「Sequential diagnosis with language models」という題名で掲載されました。Microsoft AIも同じ日に公式ブログで発表しています。
- MAI-DxOの83.2%と医師の36.1%は同じ症例での比較ですか?
-
同じ条件の比較ではありません。83.2%は、医師が解いた56件を含むNEJMの症例304件全体でのAIの正答率で、36.1%は開発中にAIが見ていない56件で、参考資料を使える一般診療医が出した正答率です。参考資料なしの医師は22.3%でした。
- MAI-DxOは医師より費用が安いというのは本当ですか?
-
設定によります。費用の上限をかけない設定では、NEJMの症例で1件あたり5,431ドルと、医師の4,725ドルより高くなりました。予算の上限をかけた設定では2,241ドルや1,303ドルまで下がります。この費用は検査費の見積もりで、AIの利用料ではありません。
- MAI-DxOはどのAIモデルを使っていますか?
-
主な結果はGPT-5を土台にしたものです。掲載前にGPT-5.5でも同じ評価をやり直したと論文に書かれています。報道によると、OpenAI、Google、Anthropicなど各社のモデルでも試し、最も良かったのはGPT-5とGPT-5.5でした。
- MAI-DxOはもう病院で使われていますか?
-
臨床ではまだ使われていません。Microsoftはベス・イスラエル・ディーコネス医療センターとの前向き研究を発表しましたが、開始日や規模は公表されていません。製品化の時期も発表されていません。
- 日本でMAI-DxOは使えますか?
-
日本での提供の発表はありません。日本では、AIの診断支援を使っても診断の主体は医師で、最終的な判断の責任も医師が負うと、厚生労働省の2018年の通知で示されています。
- MAI-DxOの設計は、業務のAIにも同じ効果がありますか?
-
論文は医療の症例で評価したもので、マーケティングやSEOの業務での効果は確かめていません。役を分けて検証させる考え方は参考になりますが、自社の過去の案件などで、正答率と費用を測りながら試すのが確実です。
まとめ
Microsoftの診断AI「MAI-DxO」の論文が2026年10月22日にScienceへ掲載され、NEJMの難症例で正答率83.2%、救急の症例で80.3%という結果が示されました。
比べた医師の36.1%は56件・参考資料ありの条件での数字で、費用が下がるのも予算の上限をかけた設定に限られます。
GPT-5では上積みの多くが土台のモデルの力でしたが、GPT-5.5では設計の上積みが大きくなったと論文は書いています。
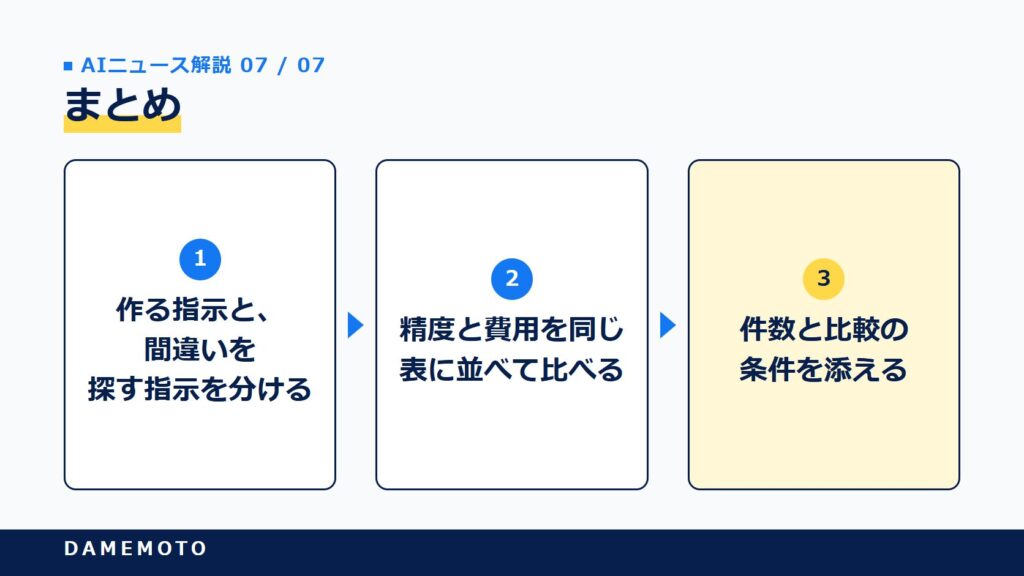
- 作る指示と、間違いを探す指示を分ける
- 精度と費用を同じ表に並べて比べる
- AIの数字を引くときは件数と比較の条件を添える
AIの性能の数字は、これからも次々に発表されていきます。数字の大きさに目を奪われず、何をどう比べたのかを確かめる習慣こそが、AIを仕事に生かすいちばんの近道だと思います。
参考・出典
- Science「Sequential diagnosis with language models」(2026年10月22日):https://www.science.org/doi/10.1126/science.aeh7930
- Microsoft AI「Building Medical Superintelligence」(2026年10月22日):https://microsoft.ai/news/building-medical-superintelligence
- Microsoft AI「The Path to Medical Superintelligence」(2025年6月30日):https://microsoft.ai/news/the-path-to-medical-superintelligence/
- 改訂原稿「Sequential Diagnosis with Language Models」(2025年11月8日付):https://erichorvitz.com/sequential_diagnosis_LM.pdf
- arXiv(2025年7月版):https://arxiv.org/abs/2506.22405
- 厚生労働省医政局医事課長通知(2018年12月19日):https://www.pmda.go.jp/files/000227450.pdf
- TechCrunch(2026年10月22日):https://techcrunch.com/2026/10/22/microsofts-mustafa-suleyman-says-its-ai-outperforms-doctors-on-hard-cases-as-he-chases-medical-superintelligence
- The Verge:https://www.theverge.com/ai-artificial-intelligence/1016690/suleyman-microsoft-diagnostic-orchestrator-science-medical-superintelligence
- Medical Economics(2026年10月22日):https://www.medicaleconomics.com/view/ai-system-outperforms-physicians-on-diagnostic-accuracy-in-microsoft-study






