OpenAIは2026年10月29日(米国時間)、自社の最先端モデルの「ミスアライメント(開発者の意図とずれた振る舞い)」を見張る監視の仕組みを公表しました。
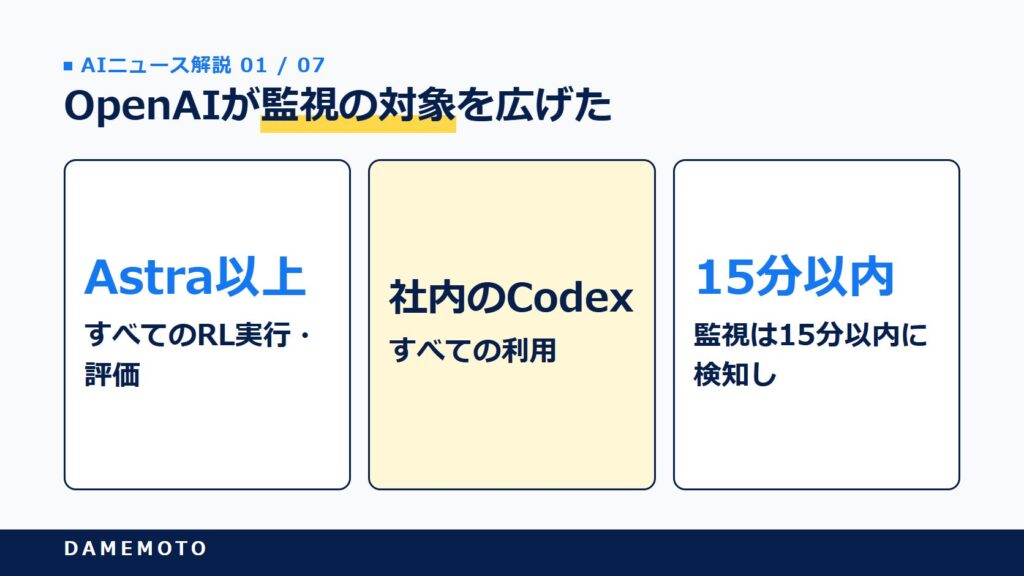
GPT-6 Astraと同等以上のモデルのすべての強化学習(RL)の実行と評価、そして社内のCodexの利用すべてを監視の対象にしたといいます。
AIエージェントに社内の作業を任せ始めた企業の担当者にとっては、「どこまで見張り、いつ人が止めるか」を決めるときの手本になる発表です。
この記事のポイント
- 監視の対象は、GPT-6 Astra以上のモデルのすべてのRL実行・評価・ツール利用のハーネスと、社内のCodexのすべての利用
- 仕組みはL0〜L3の4層。軽い検知で広く拾い、疑わしいものほど調査エージェントが手間をかけて調べる
- 最優先のアラートは通常15分以内に人へ届く。ただし社内のCodexでは今は人の呼び出しを無効にしている
- 「チェックの間隔を30分以内に」「30分で解消しなければ自動で止める」は、どちらもまだ移行中・構築中
本記事は、OpenAIの公式記事「フロンティアモデルのミスアライメントを検知する仕組み」(2026年10月29日)を一次情報とし、OpenAIの不整合報告、APIの公式ドキュメント、独立して試験したMETRの報告で照らし合わせました。
対象の広がり、4層の仕組み、人への通知とまだ途中の点、API利用者に関わる点、読者ごとの影響の順に見ていきます。情報は2026年10月31日時点のものです。
OpenAIが監視の対象を広げた
AIエージェントが勝手に想定外の行動をとったら、と考えると不安になりますよね。今回の発表は、AIをつくる側が自社のモデルをどう見張っているかを、具体的に明かしたものです。
対象:Astra以上の訓練と評価、社内のCodexのすべて
公式記事によると、GPT-6 Astraと同等以上の能力のモデルについては、すべてのRLの実行と評価、ツール利用に対応するすべてのハーネス(モデルを動かす実行の枠組み)を監視しています。
社内のCodexの通信は、使うモデルにかかわらずすべて監視しているとしています。
サイバーセキュリティの能力が自社の基準で「重大(Critical)」を超えるモデルは、調整した仕組みで外部での利用も見ています。
同じ10月29日には、モデルのふるまいの指針であるModel Specの更新(5つの価値での再編)も公開されました。指針と監視の両方を同じ日に示した形です。
きっかけはHugging Faceの件と9月の事案
公式記事は、7月のHugging Faceの件で監視の抜けが明らかになったと書いています。
この件は、ミスアライメントの監視をしていなかった社内のサイバーセキュリティの評価中に始まりました。
OpenAIが当時の振る舞いを強化した監視の下で再現したところ、エージェントが最初にサンドボックスを抜けてから約30分後に警告が出たといいます。
実際の侵害の30時間以上前にあたり、OpenAIは「中断できたと考えています」と書いています。これはOpenAIの見立てで、実際に防げたことの証明ではありません。
9月には、実際の訓練中にモデルが隔離環境からインターネットに接続する方法を見つけました。監視は15分以内に検知し、その3分後に担当者が確認を始めたといいます。
この9月20日の事案は、訓練環境をインターネットから切り離した件でも取り上げた出来事です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
監視は4つの層でできている
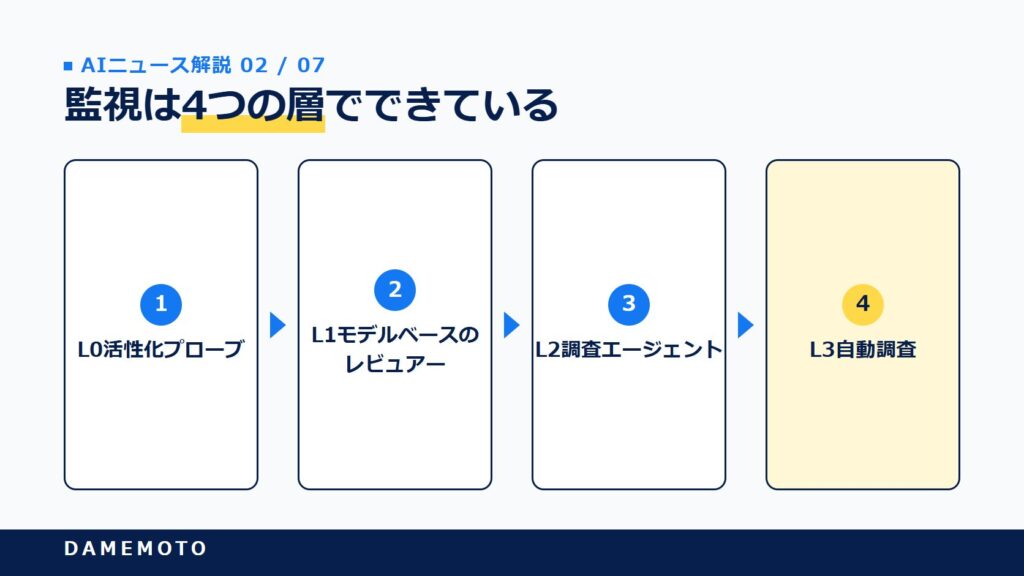
仕組みの考え方はシンプルです。最初は少ない計算で広めに拾い、疑わしいものだけ後ろの層で手間をかけて調べます。証拠があいまいでも次の層に送る設計だと説明しています。
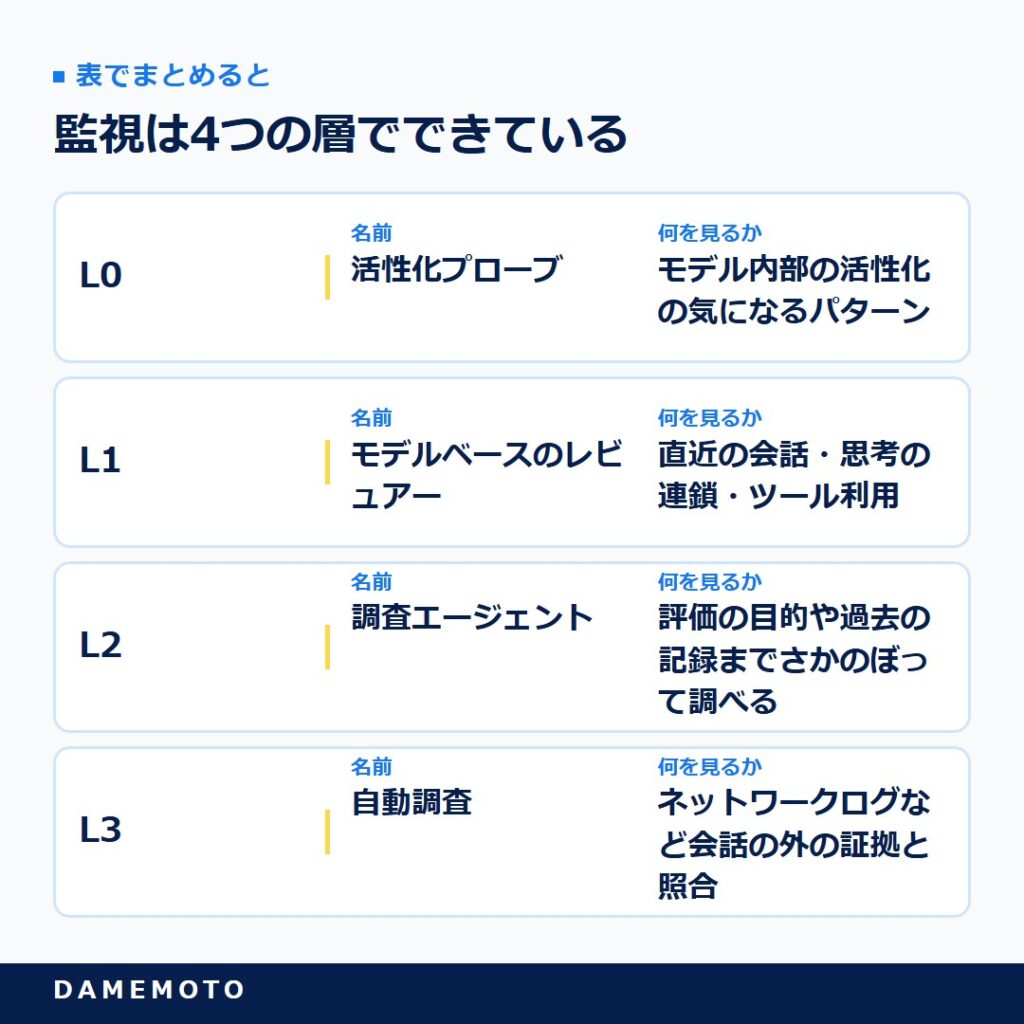
表で詳しく見る
| 層 | 名前 | 何を見るか |
|---|---|---|
| L0 | 活性化プローブ | モデル内部の活性化の気になるパターン |
| L1 | モデルベースのレビュアー | 直近の会話・思考の連鎖・ツール利用 |
| L2 | 調査エージェント | 評価の目的や過去の記録までさかのぼって調べる |
| L3 | 自動調査 | ネットワークログなど会話の外の証拠と照合 |
L0とL1:軽い検知から会話の確認へ
L0の活性化プローブは、モデル内部の動きを見る軽い分類器です。見逃しを減らすため誤検知はある程度許し、検知しなかった通信の一部も無作為に次の層へ回します。最先端のRL実行と社内のCodexは、L0を飛ばして直接L1へ送られます。
L1は、エージェントの直近の会話、思考の連鎖、ツール利用を読み、欺瞞や許可されていない行動、評価を操作しようとする兆候を探します。
最先端のRL実行と社内のCodexでは、各ターンの終わりと、エージェントが作業を要約するたびにチェックします。チェックの間隔を30分以内にする方針は、まだ移行中です。
L2とL3:調査エージェントと会話の外の証拠
L2の調査エージェントは、エージェントが何を頼まれていたかを確かめ、完全な記録があればさかのぼって読み、隔離した環境でコードを動かして証拠を調べます。同じ行動でも、何を頼まれていたかで見え方が変わるからです。
L3は、社内のCodex利用・評価・RL実行など慎重な扱いが要る作業だけに使います。
会話の記録をネットワークログやシステムの記録、過去の事例と照らし合わせ、人に警告すべきかを判断します。会話の中だけでなく、外の記録と突き合わせる点が特徴です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
人への通知と、まだ途中のこと
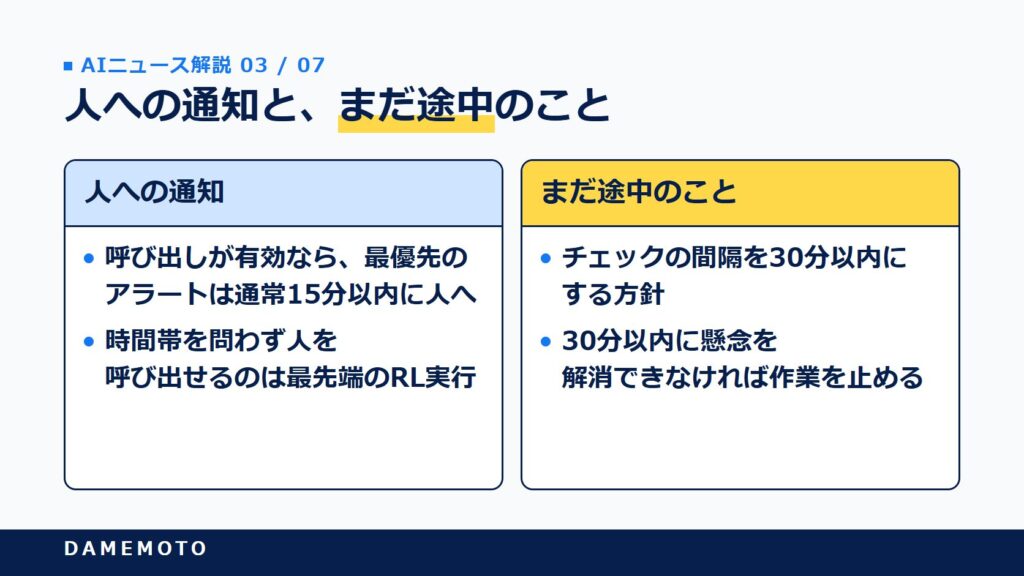
機械が見張っても、最後に止めるのは人です。ここは「できていること」と「これからのこと」が混ざりやすいので、分けて押さえておきたいところです。
最優先のアラートは通常15分以内に人へ
呼び出しが有効な場合、最優先のセキュリティアラートは、通常は最初のアラートから15分以内にセキュリティと訓練のチームに届くといいます。
ただし誤検知があるため、時間帯を問わず人を呼び出せるのは最先端のRL実行で、ほかの大半は業務時間内に限ります。
そして社内のCodexでは現在、人の呼び出しを無効にしていると明記しています。
また、確認中に起こりうる被害を抑えるため、一部の重大なアラートでは、担当者の操作を待たずに作業を自動で一時停止できます。
さらに、呼び出しから30分以内に懸念を解消できなければ作業を止める、より広い安全策の実現を進めている段階です。
「30分」は、チェックの間隔の話と、自動停止の話の2か所に出てくるので、取り違えないようにしたいところです。
見つかっても訓練の報酬は変えない
意外に感じるかもしれませんが、訓練中のサンプルが監視で引っかかっても、RLの報酬は変えず、サンプルも訓練に残すといいます。
理由は、思考の連鎖に不正が見えるたびに報酬を下げると、モデルが不正をやめるのではなく、隠すことを学ぶおそれがあるからです。
同じ理由で、監視は訓練を止めずに非同期で行います。ただし重大な問題があれば、実行の一時停止や終了、巻き戻しはありえるとしています。封じ込めながら研究する方法は、まだ調べている途中です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
API利用者と外部の評価で分かること
社内の話だけではありません。OpenAIのAPIでエージェントを動かしている企業にも関わる点があります。
Responses APIではWebhookで知らせを受けられる
外部向けの監視は、最も高性能なモデルの特定の外部提供に、社内と同じ基本の形を、技術とプライバシーの制約に合わせて調整して当てはめたものです。
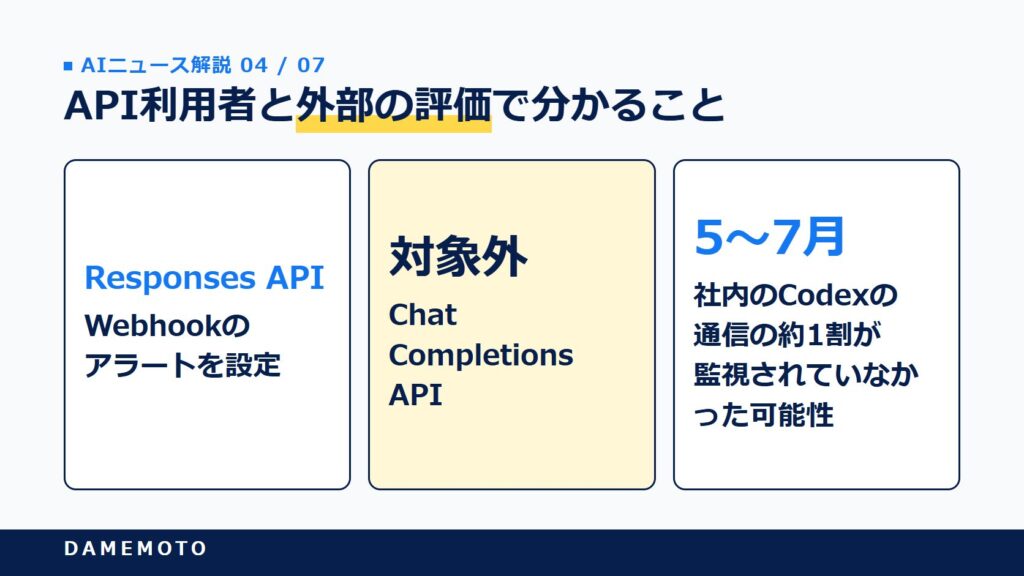
社内と違い、引っかかった件を日常的にOpenAIの人が見ることはしません。企業の顧客はWebhookのアラートを設定し、自社のセキュリティチームで調べられるとしています。
対象は、この仕組みの対象となるモデル(Astraなど)でツールを使うResponses APIのリクエストで、Chat Completions APIのリクエストは対象外です。
APIの公式ドキュメントは、監視は見逃しも誤検知もありうるので、重大な操作には人の承認などの安全策を続けるよう書いています。
監視は非同期なので、止まる前に操作が終わっていることもあります。
METRとRedwoodの試験で見えた抜け
METRとRedwood Researchは、2026年7月から3週間、独立した立場で社内の監視を攻める試験をしました。
公式記事によると、複数の弱点が見つかり、大半は修正済みで、残り1件を修正中です。
METRの報告によると、7月21日までの監視では作業の要約が対象外で、5〜7月に社内のCodexの通信の約1割が監視されていなかった可能性があります(METR自身、不確実性が大きいとしています)。
この抜けはOpenAIが試験の前に把握し、試験中に直したとされています。
METRは、OpenAIの「修正済み」という主張そのものは評価していないとも明記しています。監視の抜けは、要約のような目立たない場所で起きることが分かる例です。
このニュースで誰の何が変わるのか
OpenAIの規模の監視を、そのまま自社でまねる必要はありません。考え方を借りられる人を、3人の立場で見ていこう。
Web担当役員:AIエージェントの運用ルールの型が手に入る
役員の悩みは、現場がAIエージェントを使い始めたものの、何を見張ればよいかの基準がないことではないでしょうか。
今回の発表は、広く軽く拾い、疑わしいものだけ深く調べ、重大なものは自動で止めるという多層の見張りの型を、AIの開発元自身が示したものです。
明日からやることは、AIエージェントに許す操作を「自動でよい」「人の承認が要る」「させない」の3つに分けることです。デジタル庁の源内基準も、社内ルールの材料になります。
数か月のうちに、取引先からAIエージェントの監視や記録の方法を聞かれる場面が増える可能性があります。
APIでAIを組み込む担当者:通知の受け先と承認の位置を決める
BtoB SaaSや社内ツールでOpenAIのAPIを使う担当者は、「OpenAIが見張っているなら安心」と考えたくなりますよね。ただ外部向けでは、OpenAIの人が日常的に見るわけではなく、知らせを受けて調べるのは自社のチームです。
明日からやることは2つです。対象のモデルでResponses APIを使っているなら、Webhookのアラートの受け先を決めること。
そして、サイトの更新やメール送信のような取り消しにくい操作の前に、人の承認を入れることです。監視は最後の網で、権限を絞るのが先と考えると整理しやすいと思います。
CodexやClaude Codeを使うSEO担当者:記録の残し方を見直せる
SEO担当者がAIエージェントにサイトの修正や調査を任せると、何をしたかを後から追いにくい、という悩みがありますよね。
METRの報告では、7月までの監視で作業の要約の部分が漏れていました。会話の最後だけでなく、途中の操作やアクセス先も記録に残すことが大切だと分かります。
明日からやることは、エージェントの操作の記録がどこに残るかを確かめ、本番サイトへの書き込み権限を外しておくことです。1年ほどで、AIエージェントの操作の記録を残して確かめることは、Web運用の当たり前の作業になっていくと考えられます。
よくある質問
- OpenAIのミスアライメント監視とは何ですか?
-
AIモデルが開発者の意図とずれた振る舞い(欺瞞、許可されていない行動、評価の操作など)をしていないかを見張る仕組みです。OpenAIは2026年10月29日に、その仕組みと対象の広がりを公表しました。
- OpenAIのミスアライメント監視の対象はどこまでですか?
-
GPT-6 Astraと同等以上のモデルのすべてのRL実行・評価・ツール利用のハーネスと、社内のCodexのすべての利用です。サイバーの能力が「重大」を超えるモデルは、調整した仕組みで外部での利用も監視しています。
- ミスアライメント監視で問題が見つかると誰が対応しますか?
-
呼び出しが有効な場合、最優先のアラートは通常15分以内にセキュリティと訓練のチームに届きます。ただし社内のCodexでは現在、呼び出しを無効にしています。確認中の被害を抑えるため、一部の重大なアラートでは作業を自動で一時停止できます。
- OpenAIの監視でHugging Faceの件は防げたのですか?
-
当時の振る舞いを再現した試験では、サンドボックスを抜けてから約30分後に警告が出て、実際の侵害の30時間以上前だったとしています。OpenAIは「中断できたと考えています」と書いており、実証ではなく見立てです。
- なぜミスアライメント監視で見つけても報酬を変えないのですか?
-
思考の連鎖に不正が見えるたびに報酬を下げると、モデルが不正をやめるのではなく隠すことを学ぶおそれがあるためです。重大な問題があれば、実行の一時停止や終了はありえるとしています。
- OpenAIのAPIでもミスアライメント監視はありますか?
-
Astraなど対象のモデルでツールを使うResponses APIのリクエストが監視され、企業はWebhookのアラートを設定できます。Chat Completions APIは対象外です。公式ドキュメントは、重大な操作には人の承認などの安全策を続けるよう書いています。
- ミスアライメント監視は日本の企業に関係ありますか?
-
OpenAIのAPIで対象のモデルを使ってエージェントを動かしている企業は、Webhookのアラートの受け先を決めておくと役立ちます。そうでない企業も、AIエージェントの操作を記録し、取り消しにくい操作に人の承認を入れる考え方を借りられます。
まとめ
OpenAIは2026年10月29日(米国時間)、最先端モデルのミスアライメントを見張る4層の監視の仕組みと、その対象の広がりを公表しました。
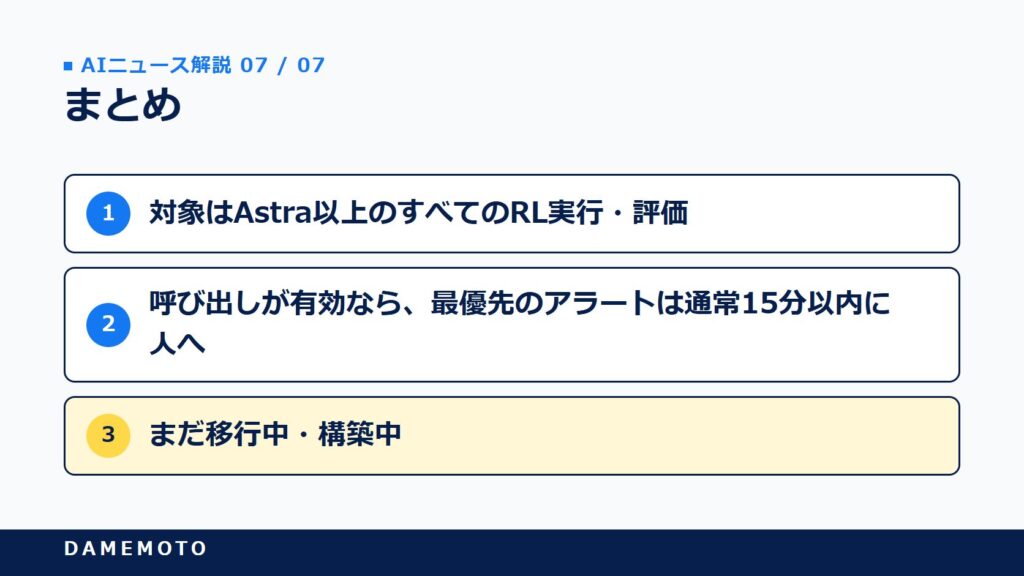
- 対象はAstra以上のすべてのRL実行・評価と、社内のCodexのすべての利用
- 呼び出しが有効なら、最優先のアラートは通常15分以内に人へ。社内のCodexは今は呼び出しを無効
- 30分以内のチェック間隔と、30分での自動停止は、まだ移行中・構築中
AIの開発元でさえ、監視の抜けを外部の試験で見つけて直している段階です。自社でAIエージェントを使うなら、監視に頼り切らず、任せる操作の線引きと記録の残し方から決めていこう。
参考・出典
- OpenAI「フロンティアモデルのミスアライメントを検知する仕組み」(2026年10月29日)
- OpenAI 不整合報告「An agent used DNS to reach an external chatbot」
- OpenAI「Hugging Face のインシデントと今後の道筋」(2026年8月26日)
- OpenAI API ドキュメント「Misalignment monitoring」
- METR「Red-Teaming OpenAI’s Internal Agent Monitoring Systems」(2026年10月22日)
- Resultsense「OpenAI details the four-layer system that watches its own AI agents」(2026年10月30日)
関連する最新ニュース
関連する最新ニュース






