robots.txtは、クローラに「どのURLにアクセスしてよいか」を伝えるクロール制御ファイルです。
User-agent・Disallow・Allow・Sitemapの4つで構成し、ドメインルート直下に設置します。noindex目的では使えない点が最大の注意点です。
robots.txtは少数のディレクティブの組み合わせでサイト全体のクロール挙動を制御できる、テクニカルSEOの基本です。
ただし「Disallow: /」の本番混入やCSS/JSのブロックは検索評価を一気に失う深刻な事故につながります。
本記事は、基本構文、4つのディレクティブの書き方、事故防止の注意点、AIクローラ対応までを、Google検索セントラルを含む一次情報ベースで解説します。
この記事の結論
robots.txtはクロール制御専用。noindexに使わず、変更のたびに検証するのが鉄則と考えています
今日からやること
- 本番のrobots.txtに「Disallow: /」がないか見る
- CSSやJSをブロックしていないか確かめる
- AIクローラを学習用と回答用に分けて判断する
こんな人向け:robots.txtを初めて書く方や、AIクローラの扱いを決めたいサイト運営者
robots.txtとは:役割と設置場所
robots.txtは、検索エンジンのクローラに対して、サイト内のどのURLにアクセスしてよいか/してほしくないかを伝えるテキストファイルです。
まず、その役割とnoindexとの違い、設置場所という基本を押さえましょう。ここを誤解すると、設定そのものが意味をなさなくなります。
クロール制御であり、noindexではない
robots.txtの役割は、あくまでクロール制御です。
クローラがページにアクセスすること自体を制御するもので、インデックス(検索結果への登録)を防ぐものではありません(PLAN-B)。
クロール拒否はnoindex目的で使ってはいけないのです。
robots.txtでDisallowを指定しても、他ページからそのページへのリンクが設置されていると、インデックスされてしまう可能性があります。
検索結果に出したくない場合はnoindexタグを、クローラに来てほしくない場合はrobots.txtを使う、というのが正しい使い分けです(クリエル)。
また、robots.txtを指定してもユーザーはそのページを閲覧できます。役割の正確な理解が、すべての出発点です。
 DAMEMOTO代表鈴木
「クロールを止めれば検索結果からも消える」、ここが一番こじれます
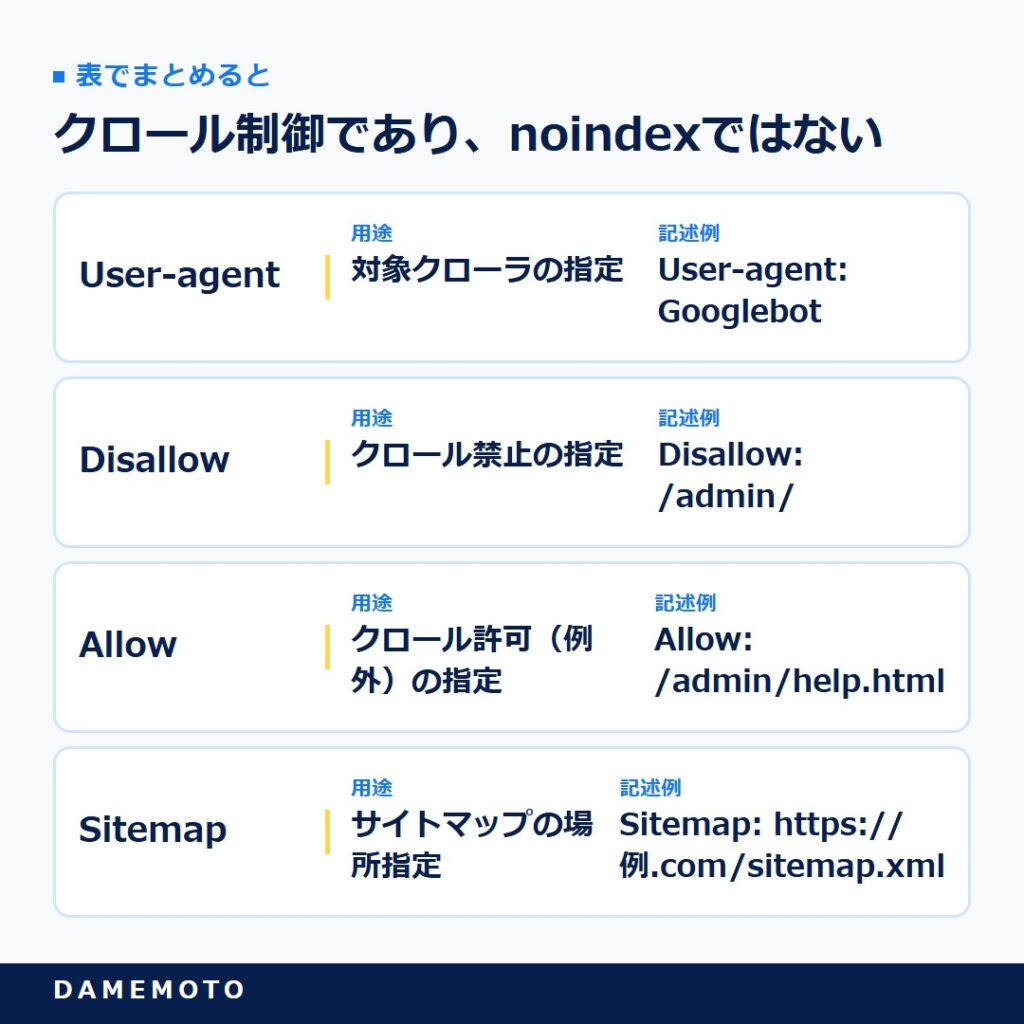
表で詳しく見る
| ディレクティブ | 用途 | 記述例 |
|---|---|---|
| User-agent | 対象クローラの指定 | User-agent: Googlebot |
| Disallow | クロール禁止の指定 | Disallow: /admin/ |
| Allow | クロール許可(例外)の指定 | Allow: /admin/help.html |
| Sitemap | サイトマップの場所指定 | Sitemap: https://例.com/sitemap.xml |
ドメインルート直下に設置する
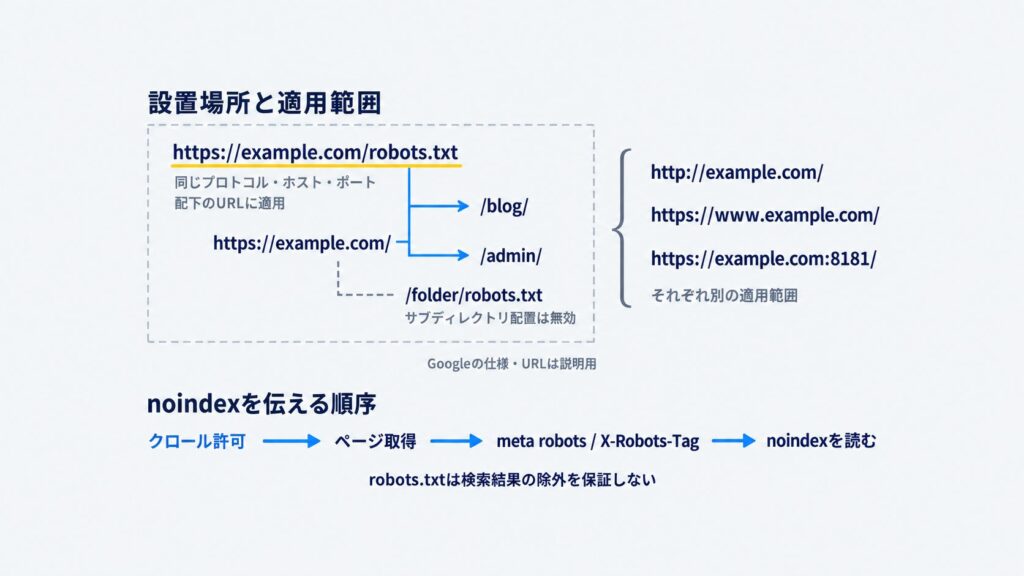
robots.txtは、必ずドメインのルート直下に設置します(例:https://example.com/robots.txt)。
サブディレクトリに置いても認識されません(NeX-Ray)。
ファイルはテキストエディタ(メモ帳など)で作成し、ファイル名を「robots.txt」として保存するだけです(クリエル)。
なお、WordPressにはデフォルトでrobots.txtが仮想ファイルとして設定されています(ウィルゲート)。
WordPressの場合、プラグインやテーマの機能から編集するのが一般的です。設置場所を間違えると設定そのものが無効になるため、ルート直下という原則は確実に守ります。
確認は、ブラウザでドメイン直下のrobots.txtにアクセスすれば内容を見られます。
なお、robots.txtの適用範囲はプロトコル・ホスト・ポートの単位で分かれるため、httpsとhttp、wwwあり・なし、サブドメインはそれぞれ別ファイルとして扱われる点も覚えておきましょう(Google検索セントラル)。
noindexしたいページの正しい手順
noindexとrobots.txtの関係には、注意すべき落とし穴があります。
すでにrobots.txtでクロールを拒否しているページにnoindexタグを設置しても、クローラが巡回しないため「インデックスしないでほしい」という指示が伝わりません(ウィルゲート)。
noindexを効かせるにはクロールが必要という関係です。
そのため、ページを検索結果から確実に外したい場合は、まずrobots.txtの指定を外してクローラが巡回できる状態にし、noindexタグを設置してインデックスから外れたことを確認してから、必要に応じてrobots.txtを設定します。
順序を間違えると、いつまでもインデックスから消えません。この手順は実務で頻繁に誤解されるポイントです。
補足すると、robots.txtでのnoindex記述そのものをGoogleはサポートしていません。
Googleは2019年9月1日付で、robots.txt内のnoindexなど非公式・非サポートのルールを処理するコードを完全に廃止したと明言しています(Google検索セントラル ブログ)。
検索結果から確実に外したいページには、ページ側のmeta robotsタグ、またはサーバー応答ヘッダのX-Robots-Tagでnoindexを指定するのが、唯一サポートされた正攻法です。noindex・canonical・301の使い分けは重複コンテンツの解消法で選定表にまとめています。
robots.txtの相談で最も多いのが、「noindexのつもりでDisallowしていた」というケースです。クロールを止めれば検索結果から消えると思い込んでいる。
でも実際は、リンクされていればURLだけがインデックスに残ることがある。robots.txtとnoindexは、似ているようで目的がまったく違う。
この使い分けを最初に正しておくだけで、後々の事故がぐっと減ると感じています。
クロール制御の全体像はクロールバジェット最適化と深く関わります。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
4つのディレクティブの書き方
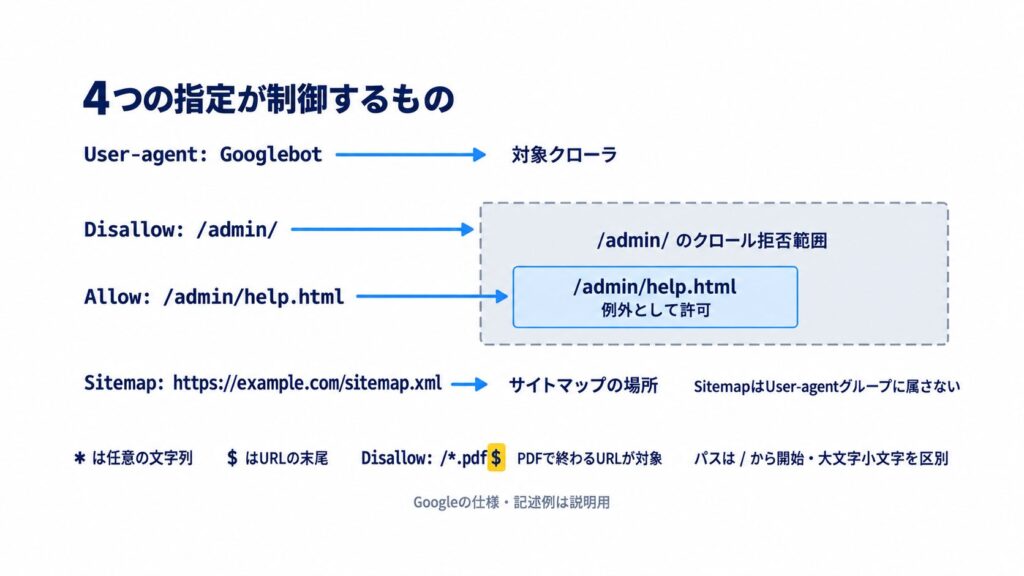
robots.txtは、User-agent・Disallow・Allow・Sitemapの4つのディレクティブで構成します。
それぞれの役割と記述方法、ワイルドカードを使った応用パターンを、具体例とともに見ていきます。基本構文を正確に書けることが、安全な運用の前提です。
User-agentで対象クローラを指定する
User-agentは、どのクローラに対する指示かを指定します。すべてのクローラを対象にする場合は「*(半角アスタリスク)」を使います(ウィルゲート)。
特定のクローラを制御したい場合は、そのユーザーエージェントトークンを記述します。たとえばGoogle検索のクロールを対象にするなら「Googlebot」と書きます。
User-agentブロックは、1つのUser-agent行に続けてDisallowやAllowを記述する形でまとまりを作ります。
複数のクローラに異なる指示を出したい場合は、User-agentブロックを複数並べます。
なお、User-agentトークンの正確な名称はGoogle検索セントラルの「Googleクローラの概要」で確認できます。
対象を明確にすることが、意図したクローラだけを制御する第一歩です。
DisallowとAllowでクロールを制御する
Disallowは、続くパスへのクロールを禁止する指示です。
「Disallow: /admin/」と書けば/admin/配下のすべてのURLへのクロールが抑制されます(NeX-Ray)。
「Disallow: /」はサイト全体のクロール禁止、「Disallow:」(値なし)はサイト全体のクロール許可を意味します。
Allowは、Disallowでブロックした範囲の中から特定の例外を許可するために使います。
たとえば「Disallow: /admin/」で管理画面をブロックしつつ、「Allow: /admin/admin-ajax.php」でAJAX機能に必要なファイルだけ許可する、といった使い方です(バクヤスAI)。
なお、パスの先頭は必ず「/」で始め、パスは大文字・小文字を区別する点に注意してください(Google検索セントラル)。
Googlebotはデフォルトで全許可のため、Allowは基本的にDisallowの例外指定として使います。
Allowは単独でなくDisallowの例外として使うのが基本的な使い方です。
大文字・小文字の不一致、地味ですが本当によくある取りこぼしです
ワイルドカードとSitemapを活用する
パスの記述では、ワイルドカード「*」(任意の文字列にマッチ)と末尾アンカー「$」(URLの末尾を指定)が使えます(ミエルカ)。
たとえば「Disallow: /*.pdf$」はすべてのPDFファイルへのクロールを禁止し、「Disallow: /*?hogehoge=」は特定のパラメータを含むURLのクロールを禁止します。
パラメータ違いの重複URLを制限すれば、クローラが重要ページを優先して巡回でき、クロール効率の向上につながります。
Sitemapディレクティブは、sitemap.xmlの絶対URL(プロトコルとドメインを省略しない完全なURL)をクローラに伝えます(ミエルカ)。
SitemapはUser-agentブロックに属さず、ファイル内のどこに書いても有効です。
Search Consoleでサイトマップを送信していても、robots.txtにも記述しておくのが推奨です。
記号一つの違いが挙動を大きく変えるため、ワイルドカードの記述は慎重に行います。サイトマップそのものの作り方は、sitemap.xmlの書き方もあわせて確認しておきたいところです。
User-agent・Disallow・Allow・Sitemapを正確に書く
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
そのままコピーできるrobots.txt記述例
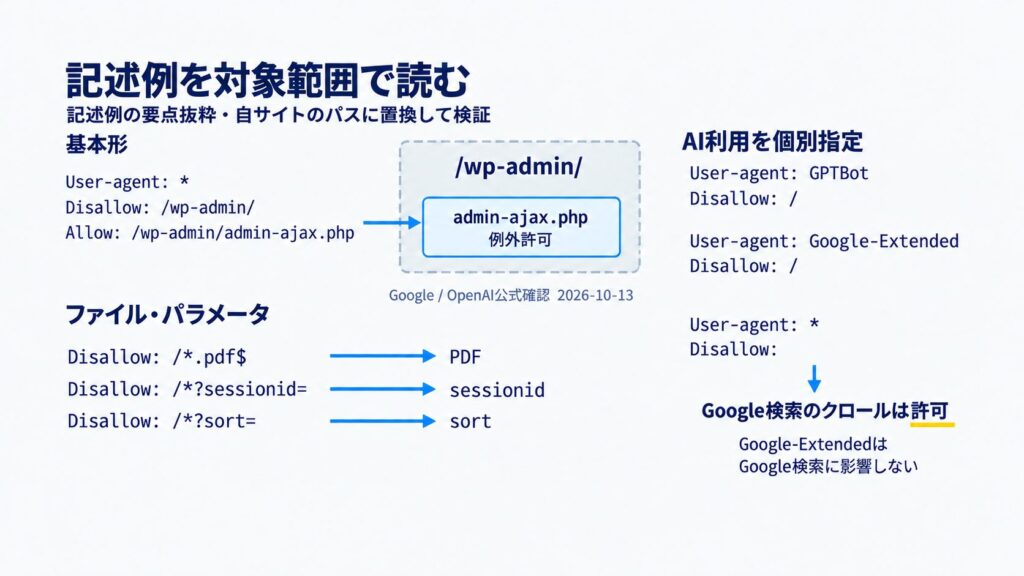
ここでは、実務でよく使う4つの場面を、そのまま貼り付けて調整できる記述例として用意しました。自サイトのパスとドメインに置き換えるだけで使えます。
書き方の型が手元にあると、ゼロから組むより事故が起きにくくなります。
記述例を写経する前に、自サイトのディレクトリ構成とインデックスさせたいURLを一度棚卸ししておくと、なお安全です。
基本形:全クローラ許可+管理画面だけ除外
最も標準的な構成です。すべてのクローラを許可しつつ、管理画面や検索結果ページなどクロール不要なディレクトリだけをDisallowで除外し、末尾にSitemapを記述します。
WordPressであれば、AJAX処理に使う「admin-ajax.php」だけはAllowで通すのが定石です(バクヤスAI)。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://example.com/sitemap.xml
ファイルタイプ・パラメータURLの制御
ワイルドカード「*」と末尾アンカー「$」を使い、特定の拡張子やパラメータ付きURLのクロールを抑制する例です。
パラメータ違いの重複URLが大量に生成されるサイトで、クロール効率を整える際に役立ちます。ただし、対象を広く取りすぎると必要なURLまで止めてしまうため、実機での検証が前提です。
User-agent: *
Disallow: /*.pdf$
Disallow: /*?sessionid=
Disallow: /*?sort=

Sitemap: https://example.com/sitemap.xml
AIクローラを選択的に制御する
Google検索のクロールは通常どおり許可しつつ、AIの学習用クローラだけを個別にブロックする例です。User-agentブロックを分けて記述します。
GoogleのGemini学習用「Google-Extended」をブロックしても、Google検索(Googlebot)のクロールや検索順位には影響しません(Google検索セントラル)。
この独立性を理解しておくと、検索流入を守りながらAI学習だけを線引きできます。
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
「Google-Extended=Google検索」と早合点してブロックを渋る人、要注意です
記述例はあくまで出発点です。
貼り付けたら必ず、後述のSearch Consoleや検証ツールで「意図したURLだけがブロック・許可されているか」を確認してから本番に反映してください。
型を持ちつつ、最後は自サイトで検証する。この二段構えが安全運用の基本です。
クロールの効率そのものを高める施策の全体は、クロールバジェット最適化の7施策を読むと判断しやすくなるはずです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
注意点と設定ミスの防ぎ方
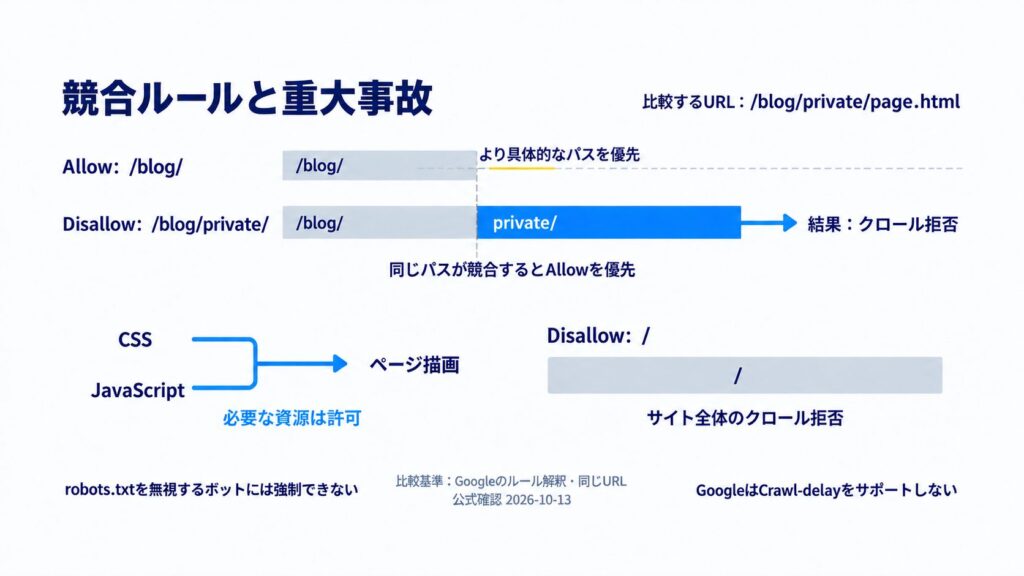
robots.txtはシンプルに見えますが、記述を誤ると検索評価を一気に失う深刻な事故につながります。
優先順位の理解、CSS/JSのブロック回避、Disallow: /の混入防止という3つの注意点を押さえましょう。事故防止こそが、robots.txt運用の核心です。
ルールの優先順位を理解する
複数のルールが同じURLにマッチした場合の優先順位を理解しておく必要があります。
Google検索セントラルでは、クローラはルールのパスの長さに基づいて最も限定的なルールを使用し、ワイルドカードを含むルールが競合する場合は最も制限の少ないルールを使用すると定義されています(Google検索セントラル)。
具体的には、DisallowとAllowが競合した場合、Googleはパス(記述する文字列)の文字数がより長い方を優先します(ウィルゲート)。
たとえば「Allow: /blog/」と「Disallow: /blog/private/」がある場合、/blog/private/page.htmlへのアクセスは、より文字数が長いDisallowが優先されてブロックされます。
競合時はパスの長い方が勝つのが原則です。ただしパスの長さが同じで競合する場合は、制限の少ないAllowが優先されます。
DAMEMOTO代表鈴木「記述順で決まる」と思い込むと、ここで必ずつまずきます
CSS/JSとDisallow: /の事故を防ぐ
最も警戒すべき事故が2つあります。1つは、サイトの表示に必要なCSSやJavaScriptファイルをブロックしてしまうことです。
これらをブロックすると、Googleがページを正しくレンダリング・評価できなくなります(ウィルゲート)。
もう1つが、サイト全体をブロックする「Disallow: /」の本番環境への混入です。
開発環境用の設定をそのまま本番に反映してしまうと、サイト全体がクロールされなくなり、検索評価を一気に失います(NeX-Ray)。
設置・更新時は、Disallow: /が誤って記述されていないか、設置場所はルート直下か、パスが対象URLと正確に一致しているか、JS/CSSをブロックしていないかを必ずチェックします。
これらの確認を習慣にすることで、代表的なミスを防げます。
制御できないクローラもある
robots.txtには限界もあります。
一部の検索エンジンやクローラは、robots.txtのDisallowの記述を無視するため、robots.txtでは制御できません(ウィルゲート)。
悪意のあるボットや、ルールに従わないクローラに確実にアクセスさせたくない場合は、.htaccessによるアクセス制限やIPブロックなど、別の方法を併用する必要があります。
robots.txtはあくまで「行儀のよいクローラへのお願い」であり、強制力はありません。
また、Crawl-delay(クロール間隔の指定)というディレクティブもありますが、Googleはこのフィールドをサポートしておらず、無視されます(NeX-Ray)。
robots.txtでできること・できないことを正しく理解し、目的に応じて他の手段と組み合わせることが大切です。
クロールとインデックスの全体設計は、canonicalやsitemap.xmlとあわせて考えます。
確認方法とAIクローラ対応
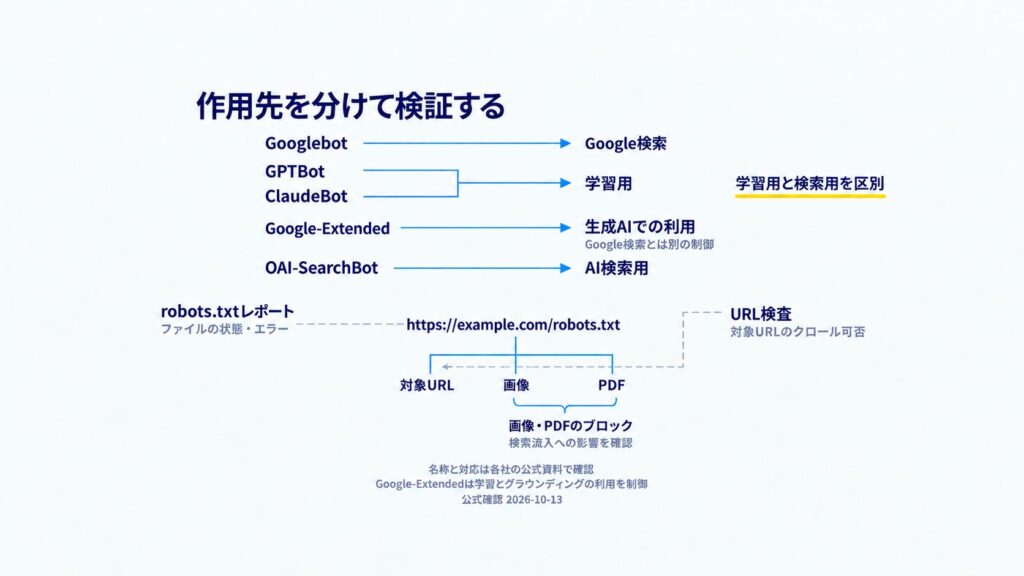
robots.txtは設定後の検証が不可欠です。Search Consoleなどでの確認方法と、2026年の新しいテーマである生成AIクローラへの対応を解説します。誤設定の影響が大きいだけに、変更時の検証は徹底しましょう。
Search Consoleで動作を検証する
robots.txtを設定したら、必ず意図通りに動作しているかを検証します。
Google Search Consoleには、robots.txtの内容を確認できるレポートがあり、Googleが認識している最新のrobots.txtの状態やエラーを確認できます(NeX-Ray)。
さらにURL検査ツールを使えば、特定のURLがクロール可能かどうかをページ単位で確認できます。
意図したURLがブロック(または許可)されているかを、テストツールやサードパーティの検証ツールで確認しましょう(ウィルゲート)。
変更時は必ず検証してから反映するのが、事故を防ぐ鉄則です。
robots.txtの誤設定は影響が大きく、気づくのが遅れると検索流入に深刻なダメージを与えるため、検証の徹底が欠かせません。
生成AIクローラへの対応を判断する
2026年現在、生成AIサービスのクローラ(学習用クロール)への対応が、robots.txt運用の新しいテーマになっています(NeX-Ray)。
自社コンテンツをAIの学習データとして使われたくない場合、OpenAIの「GPTBot」、Anthropicの「ClaudeBot」、Googleの「Google-Extended」、Common Crawlの「CCBot」などを個別にブロックできます。
それぞれにUser-agentブロックを作成し、Disallowを記述します。
たとえば「User-agent: GPTBot」+「Disallow: /」でGPTBotをブロックしつつ、「User-agent: Googlebot」+「Disallow:」でGoogle検索のクロールは許可する、という選択的な設定が可能です。
AI学習を許可するかブロックするかは、コンテンツ戦略や事業目標に応じて慎重に判断します。
一律にブロックすればよいわけではなく、AI検索での露出機会とのトレードオフも考慮した判断が求められます。
AIクローラーのUAごとの書き分けは、AIクローラー制御のrobots.txt記述例で整理しています。
学習用と検索用のクローラを区別する
AIクローラを扱ううえで重要なのが、「学習用クローラ」と「検索・回答用クローラ」の区別です。多くのAI事業者は2種類のボットを運用しています。
学習用クローラ(GPTBot・Google-Extended・ClaudeBotなど)はモデルの学習にデータを使い、検索・回答用クローラ(OAI-SearchBot・PerplexityBotなど)は検索の索引づくりや回答での引用のためにページを取得します(No Hacks)。
なお、ChatGPT-Userはユーザーの質問などをきっかけにページを訪れるエージェントで、自動の巡回には使われません。ユーザーの操作で動くためrobots.txtのルールが適用されない場合があり、ChatGPTの検索に出すかどうかはOAI-SearchBotで管理するよう公式は案内しています(OpenAI)。
つまり、学習はさせたくないがAI検索での引用は獲得したい場合、学習用だけをブロックし回答用は許可する、という線引きができます。
ただしUser-agent名は事業者の都合で変更・追加されることがあるため、各社の公式ドキュメントで最新の名称を確認してから記述してください。
なお、一部のクローラはrobots.txtを無視して巡回することが報告されており、確実に止めたい相手にはサーバー側やWAFでの制御が現実的な防御策になります(No Hacks)。
画像ブロックは流入への影響を確認
ファイルタイプ単位のブロックには、慎重な判断が必要です。
画像やPDFをブロックする場合、たとえば画像SEOやFAQリッチリザルトを狙っているサイトでは、画像をブロックすると検索結果上での視覚的な露出が減ります(NeX-Ray)。
安易にブロックせず、その画像が検索流入に貢献しているかをSearch Consoleで確認してから判断しましょう。
robots.txtによるブロックは「不要なものを除外する」という効果がある一方、「必要なものまで除外してしまう」リスクと常に隣り合わせです。
何をブロックするかは、SEO上のメリットとデメリットを天秤にかけて決めることが大切です。データに基づいて、ブロックの是非を判断する姿勢が求められます。
robots.txtが不要・非推奨なケース(正直コーナー)
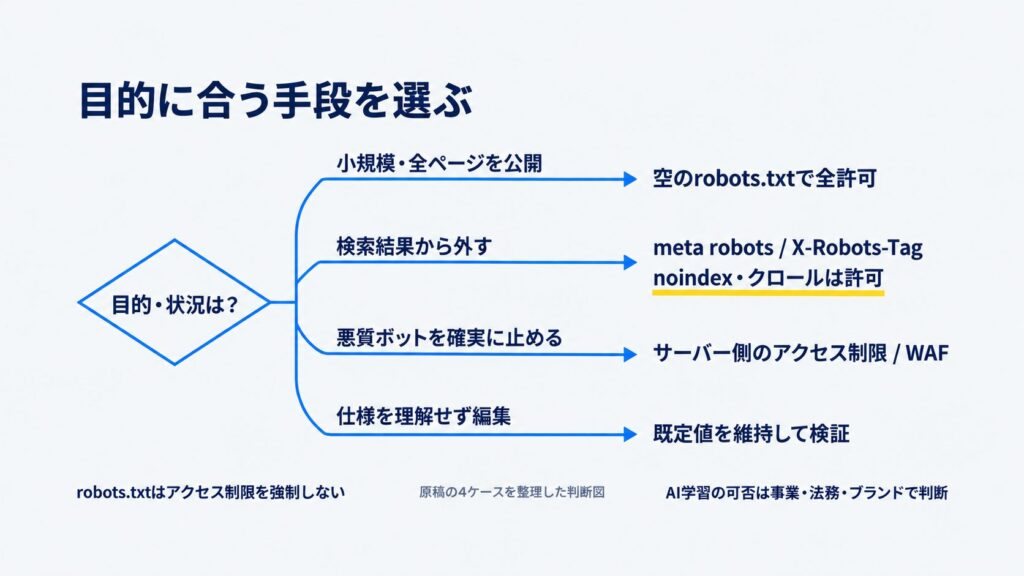
robots.txtは万能の施策ではありません。むしろ「触らないほうが安全」な場面も少なくないため、ここでは本記事の内容が当てはまらない・優先度が低いケースを正直に整理します。
導入の前に、自サイトが本当にrobots.txtを必要としているかを見極めてください。
- 小規模で隠したいURLがないサイト:全ページをインデックスさせたいなら、空のrobots.txt(全許可)で十分。無理にDisallowを書く必要はない
- 検索結果から「確実に」消したいだけの人:それはrobots.txtの仕事ではない。meta robotsまたはX-Robots-Tagのnoindexを使う
- 悪質ボットを確実に止めたい場合:robots.txtは強制力がなく無視されうる。サーバー側のアクセス制限やWAFが必要
- 仕様を理解しないままの編集:1行の誤りでサイト全体が落ちうる。自信がなければ既定値のまま、検証ツールで確認してから触る
本記事だけでは判断しきれないこともあります。たとえば、自社コンテンツをAI学習に使わせるべきか否かは、技術論ではなく事業・法務・ブランドの判断であり、唯一の正解はありません。
また、robots.txtを無視する個別ボットの最新リストや、サーバー・WAFでの具体的なブロック設定は、本記事の範囲外です。
判断に迷う領域は、無理に断定せず専門家やインフラ担当と相談することをおすすめします。
robots.txtは、テクニカルSEOという大きな枠組みの土台にあたる設定です。クロール制御・インデックス制御の全体マップとあわせて確認してください。クロール制御とインデックス制御の全体像はテクニカルSEO完全ガイドで確認できます。
よくある質問
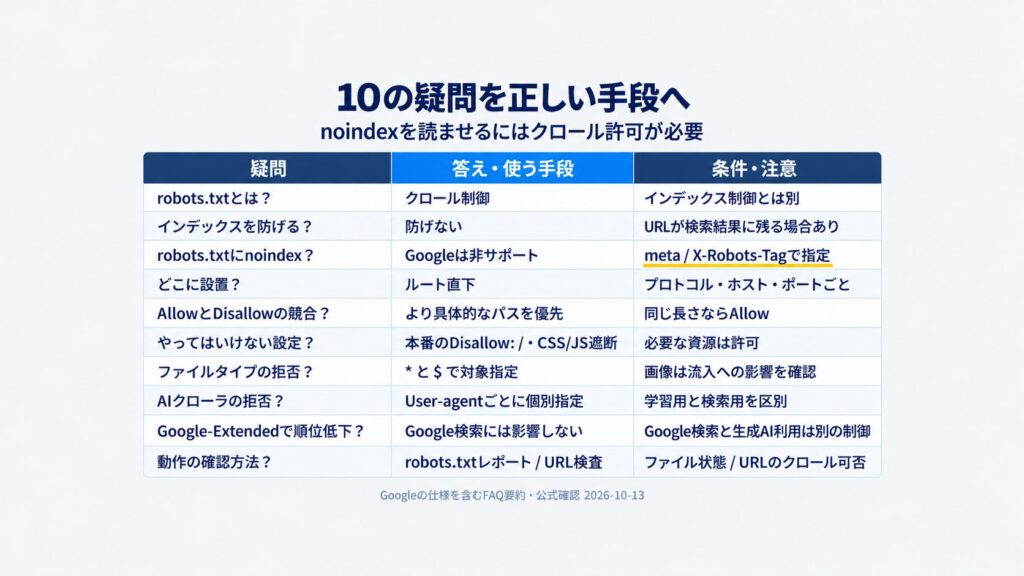
- robots.txtとは何ですか?
-
検索エンジンのクローラに対して、サイト内のどのURLにアクセスしてよいか/してほしくないかを伝えるテキストファイルです。User-agent・Disallow・Allow・Sitemapの4つのディレクティブで構成し、ドメインのルート直下に設置します。クロール制御が役割で、インデックスを防ぐものではありません。
- robots.txtでインデックスを防げますか?
-
防げません。robots.txtはクロール制御で、Disallowを指定してもインデックスは防げません。他ページからリンクされていると、URLがインデックスされる可能性があります。検索結果に出したくない場合はnoindexタグを使い、クローラに来てほしくない場合はrobots.txtを使う、という使い分けが正解です。
- robots.txtにnoindexと書けばインデックスを外せますか?
-
外せません。Googleは2019年9月1日に、robots.txt内のnoindexなど非サポートのルールを処理するコードを廃止しました。robots.txtにnoindexと書いても無視されます。インデックスから確実に外すには、ページのmeta robotsタグかサーバー応答のX-Robots-Tagでnoindexを指定し、その際クロールはブロックしないでください。
- robots.txtはどこに設置しますか?
-
必ずドメインのルート直下に設置します(例:https://example.com/robots.txt)。サブディレクトリに置いても認識されません。テキストエディタで作成し、ファイル名を「robots.txt」として保存します。なお、適用範囲はプロトコル・ホスト・ポート単位で分かれるため、httpsとhttp、wwwあり・なし、サブドメインは別ファイルとして扱われます。
- robots.txtでDisallowとAllowが競合したらどちらが優先されますか?
-
Google検索セントラルの定義では、パスの文字数がより長い方(最も限定的なルール)が優先されます。たとえば「Allow: /blog/」と「Disallow: /blog/private/」がある場合、/blog/private/配下は文字数の長いDisallowが優先されブロックされます。パスの長さが同じで競合する場合は、最も制限の少ないAllowが優先されます。
- robots.txtでやってはいけない設定は?
-
最も危険なのは、サイト全体をブロックする「Disallow: /」の本番環境への混入と、CSS/JavaScriptファイルのブロックです。前者はサイト全体がクロールされなくなり検索評価を失い、後者はGoogleがページを正しく評価できなくなります。設定・更新時は必ずこれらをチェックしましょう。
- robots.txtで特定のファイルタイプだけブロックできますか?
-
できます。ワイルドカード「*」と末尾アンカー「$」を使います。たとえば「Disallow: /*.pdf$」で全PDFファイルを、「Disallow: /*?param=」で特定パラメータを含むURLをブロックできます。ただし画像をブロックすると検索結果での視覚的露出が減るため、流入への影響を確認してから判断しましょう。
- 生成AIのクローラはrobots.txtでブロックできますか?
-
できます。GPTBot(OpenAI)、ClaudeBot(Anthropic)、Google-Extended(Google)、CCBot(Common Crawl)などを、それぞれUser-agentブロックを作りDisallowで個別にブロックできます。学習用と回答用でボットが分かれる事業者もあるため、引用は獲得したい場合は学習用だけを止める線引きも可能です。AI学習の可否は事業戦略で慎重に判断しましょう。
- robots.txtでGoogle-Extendedを止めると検索順位は下がりますか?
-
下がりません。Google-ExtendedはGeminiアプリやVertex AIの学習に関わるクローラで、Google検索には影響しないとGoogleが明言しています。robots.txtでGoogle-Extendedをブロックしても、Googlebotによる通常のクロールや検索順位には影響しないため、AI学習だけを止めたい場合に安心して指定できます。
- robots.txtの動作はどう確認しますか?
-
Google Search Consoleのrobots.txtレポートで、Googleが認識している最新の状態やエラーを確認できます。URL検査ツールを使えば、特定URLがクロール可能かをページ単位で確認できます。誤設定は影響が大きいため、変更時はテストツールで意図通りにブロック・許可されているか必ず検証してから反映しましょう。
【独自】robots.txtの記述判断フローと優先順位の読み解き表
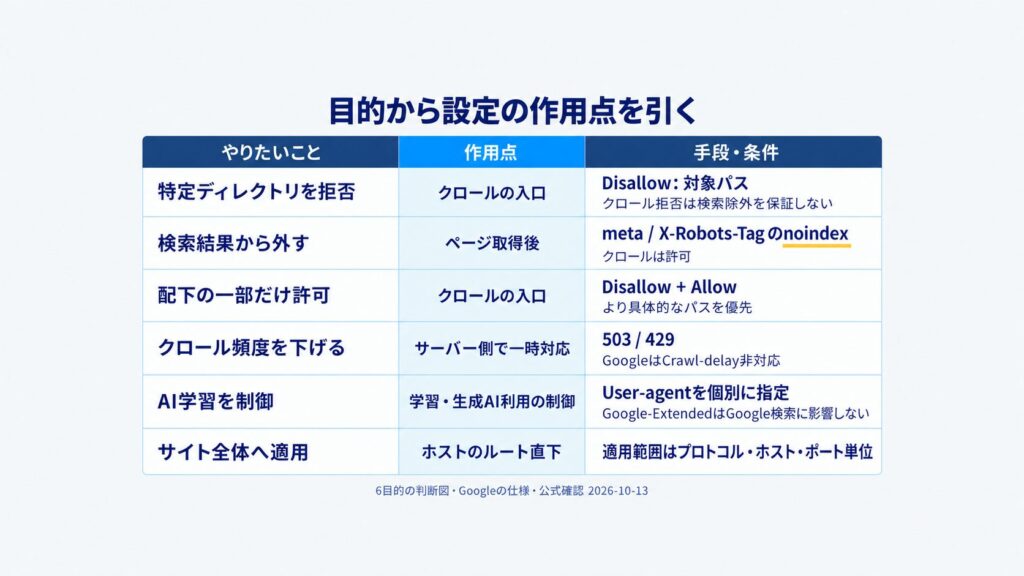
robots.txtはシンプルに見えて、ディレクティブの優先順位を誤解すると意図と逆の挙動になります。
Googleの仕様では、AllowとDisallowが競合した場合、より具体的(マッチする文字数が長い)なルールが優先されます。
ここでは「何をしたいか」から正しい書き方を引ける判断表を用意しました。クロール制御の意図と記述を一致させるための型として使ってください。
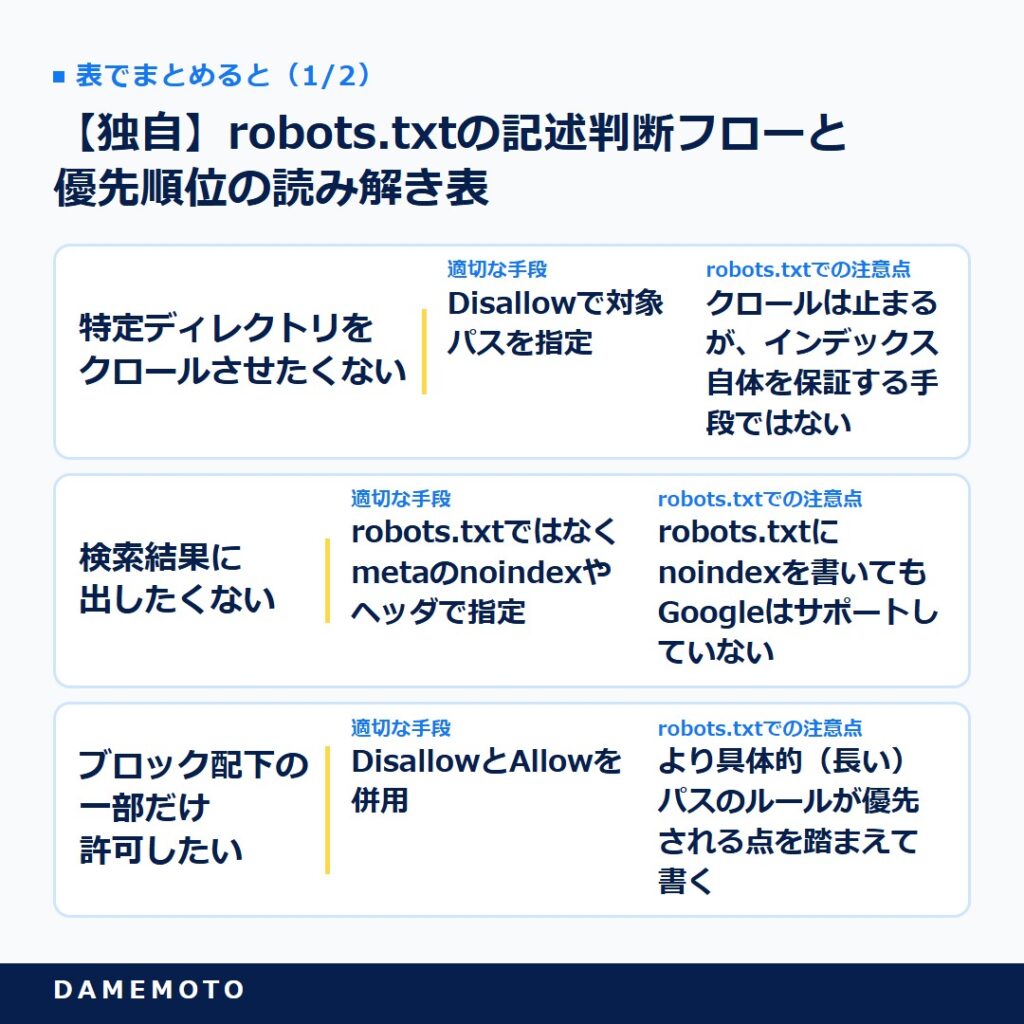
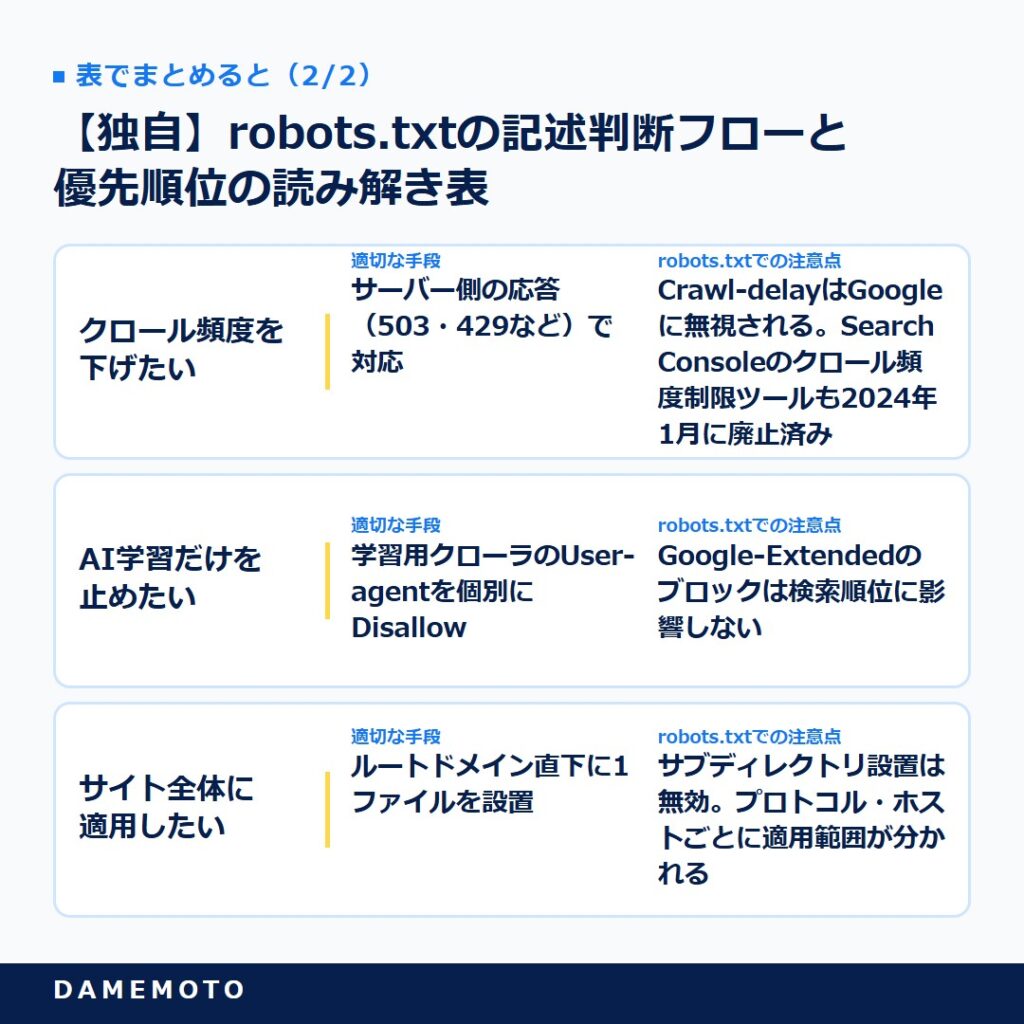
表で詳しく見る
| やりたいこと | 適切な手段 | robots.txtでの注意点 |
|---|---|---|
| 特定ディレクトリをクロールさせたくない | Disallowで対象パスを指定 | クロールは止まるが、インデックス自体を保証する手段ではない |
| 検索結果に出したくない | robots.txtではなくmetaのnoindexやヘッダで指定 | robots.txtにnoindexを書いてもGoogleはサポートしていない |
| ブロック配下の一部だけ許可したい | DisallowとAllowを併用 | より具体的(長い)パスのルールが優先される点を踏まえて書く |
| クロール頻度を下げたい | サーバー側の応答(503・429など)で対応 | Crawl-delayはGoogleに無視される。Search Consoleのクロール頻度制限ツールも2024年1月に廃止済み |
| AI学習だけを止めたい | 学習用クローラのUser-agentを個別にDisallow | Google-Extendedのブロックは検索順位に影響しない |
| サイト全体に適用したい | ルートドメイン直下に1ファイルを設置 | サブディレクトリ設置は無効。プロトコル・ホストごとに適用範囲が分かれる |
要点は、robots.txtは「クロールの可否」を伝えるファイルであり、「インデックスの可否」を決めるものではないという線引きです。
Allow/Disallowの優先は記述順ではなくルールの具体性で決まるため、競合させるときは意図したパスがより長く具体的になっているかを必ず確認してください。
【独自】robots.txtでやりがちな失敗パターン集
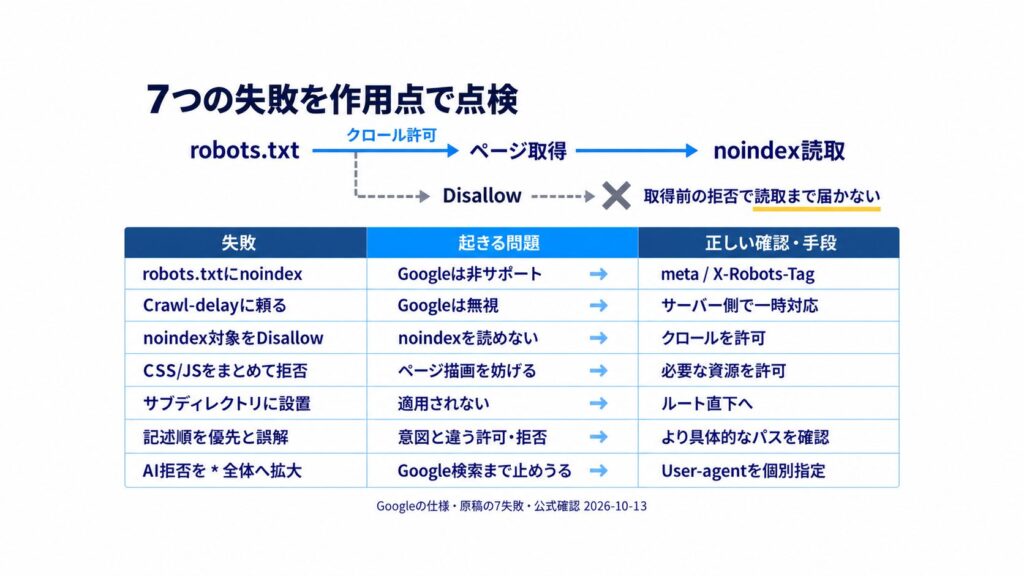
robots.txtは1行の誤りがサイト全体の見え方を左右します。とくに非対応ディレクティブを「効いているつもり」で使い続ける事故が多発します。
Googleがnoindexをサポートせず、Crawl-delayも無視するという事実を踏まえ、以下の失敗パターンを点検してください。
- robots.txtにnoindexを記述:Googleは非サポート(2019年9月廃止)。検索結果から外す目的なら、metaタグやX-Robots-Tagのnoindexを使う。
- Crawl-delayに頼る:Googleは無視する。クロール負荷の調整はサーバー側の応答(503・429など)で行う(Search Consoleのクロール頻度制限ツールは2024年1月に廃止)。
- noindexしたいページをDisallow:クロールを止めるとnoindex指定を読めず、結果的に検索結果に残ることがある。インデックス除去とクロール禁止は両立しない。
- CSS/JSをまとめてブロック:描画に必要な資源を遮断すると、ページの理解が妨げられる。レンダリングに要るファイルは許可する。
- 設置場所の誤り:サブディレクトリに置くと無効。必ずホストのルート直下に配置する。
- Allow/Disallowの優先順位を記述順だと誤解:実際はマッチの具体性で決まる。意図した許可・拒否が成立しているか実機で検証する。
- AIブロックでGoogle検索まで止める誤解:Google-Extendedと検索用Googlebotは別物。学習だけ止めたいのに「*」全体に広げない。
共通する原因は、robots.txtに「インデックス制御」や「速度制御」まで担わせようとすることです。このファイルの役割はクロールの入口の開閉に限定し、表示可否や負荷調整は専用の仕組みに任せる、と割り切ることが事故防止につながります。
まとめ:robots.txtは「役割の理解」と「検証」が命
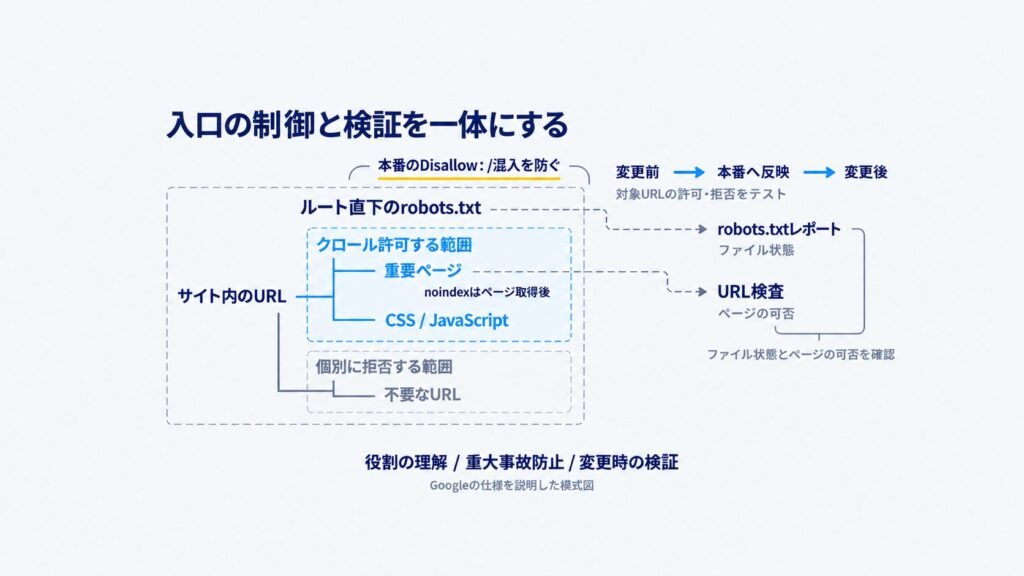
robots.txtはクロール制御の基本ファイルで、User-agent・Disallow・Allow・Sitemapの4つで構成します。
noindex目的では使えず、Disallow: /の混入やCSS/JSのブロックは重大事故につながります。最後に要点を3行で整理します。
- 役割はクロール制御、noindexとは別物
- Disallow: /混入・CSS/JSブロックは厳禁
- 変更時はSearch Consoleで必ず検証
robots.txtは、たった数行のテキストファイルでありながら、書き方を一つ間違えるだけでサイト全体の検索評価を失いかねない、影響力の大きい設定です。
だからこそ、最初に「これはクロール制御であってnoindexではない」という役割を正しく理解し、変更のたびにSearch Consoleで検証する習慣が欠かせません。
2026年はAIクローラへの対応という新しい論点も加わり、robots.txtの守備範囲は広がっています。
シンプルなファイルだからと軽視せず、一行ずつ意味を確認しながら丁寧に運用すること。それが、テクニカルSEOの土台を守ることにつながると考えています。
参考URL一覧
- Google検索セントラル(公式)・robots.txt の概要:https://developers.google.com/search/docs/crawling-indexing/robots/intro?hl=ja
- Google検索セントラル(公式)・Googleによるrobots.txtの指定の解釈:https://developers.google.com/search/docs/crawling-indexing/robots/robots_txt?hl=ja
- Google検索セントラル ブログ(公式)・robots.txtの非サポートルールに関する注意:https://developers.google.com/search/blog/2019/07/a-note-on-unsupported-rules-in-robotstxt?hl=ja
- NeX-Ray・robots.txtとは?書き方・設定方法・SEOへの影響:https://www.ficilcom.jp/ja/blog/robots-txt-guide
- ミエルカ・robots.txtの書き方・設定法(記述例のサンプル付き):https://mieru-ca.com/blog/how_to_write_robots-txt
- ウィルゲート・robots.txtとは?意味やSEO効果、設定方法を徹底解説:https://www.willgate.co.jp/promonista/robots-txt
- クリエル・robots.txtとは?書き方とSEO効果を解説:https://www.creal.co.jp/column/seo/15076
- バクヤスAI・robots.txtとは?SEO効果を高める書き方から設定ミスの防ぎ方:https://bakuyasu.techsuite.co.jp/7783
- PLAN-B・robots.txtとは?うまく活用するとSEO効果もアップ:https://www.plan-b.co.jp/blog/seo/4880
- No Hacks・The AI User-Agent Landscape in 2026: A Complete Reference:https://nohacks.co/blog/ai-user-agents-landscape-2026