LLMOで失敗する典型パターンとは、SEOの土台を飛ばす・小手先のハックに走る・効果測定をしない・一度やって放置する・自社主張ばかりで外部評価がない、の5つに集約されます。共通項は「近道狙い」と「継続不足」です。
LLMOはSEOの拡張であり、SEOの土台がないサイトはAIにも掲載されにくくなります。
不自然なフレーズの埋め込みなどのハックは長期的に機能せず、プリンストン大学のGEO研究でも引用率を下げると実証されています。AI引用は継続更新が前提で、放置すると引用から外れます。
「自社で良いと言っているだけ」ではAIは評価せず、第三者の言及が必要です。さらに見落とされがちなのが、回答系AIクローラーを誤ってブロックしているケース。誠実なコンテンツと継続こそが、唯一の正道です。
この記事の結論
LLMOの失敗は近道狙いと継続不足から生まれます。SEOの土台と地道な更新が王道と考えています
今日からやること
- robots.txtで回答系AIクローラーを止めていないか見る
- Search Consoleでインデックス状況を確かめる
- 引用状況を月1回、定点で観測する
こんな人向け:LLMO対策を始めたものの、成果が見えず手応えのない担当者
LLMOで失敗する典型パターンは「5つ+1」に集約される
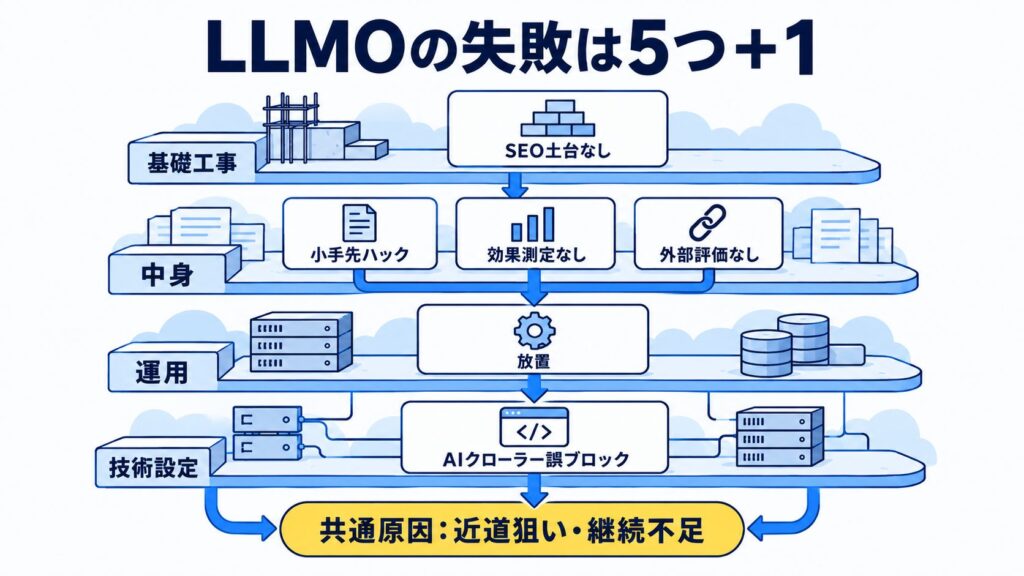
結論から示すと、LLMOの失敗は5つの典型パターンに集約され、それに「見落としがちな技術的失敗」を1つ加えた構図で理解すると過不足がありません。
SEOの土台を飛ばしてLLMOだけやる、不自然なハックに走る、効果測定をしない、一度やって放置する、自社主張ばかりで外部評価がない。
この5つに、回答系AIクローラーの誤ブロックを加えた6点です。共通項は「近道をしようとした」ことと「継続しなかった」こと。
AIは表面的な操作を検出する方向に進化しているため、小手先は短期的に効いても必ず反動が来ます。
 DAMEMOTO代表鈴木
ほとんどの失敗、原因はこの2つに尽きます
なぜ「失敗パターン」を先に知るべきか
LLMO(大規模言語モデル最適化)は2024年以降に広まった新しい領域で、確立した成功法則がまだ少ない一方、失敗の型は早くも共通化しています。
先行事例の失敗を知ることは、限られた工数を無駄にしないための最短ルートです。やってはいけないことを先に潰せば、残った打ち手は自然と「誠実なコンテンツの継続発信」に収束します。
本記事では各失敗を「症状・なぜ起こるか・回避策」の順で具体化します。
Google検索のAI Overviews側で起きやすい失敗は、AIO対策の失敗5パターンと回避策で確認できます。
失敗の全体像を1枚で把握する
6つの失敗は、影響する層が異なります。
SEO土台の不在は「基礎工事」の問題、ハック・量産・外部評価の欠如は「中身」の問題、放置は「運用」の問題、クローラー誤ブロックは「技術設定」の問題です。
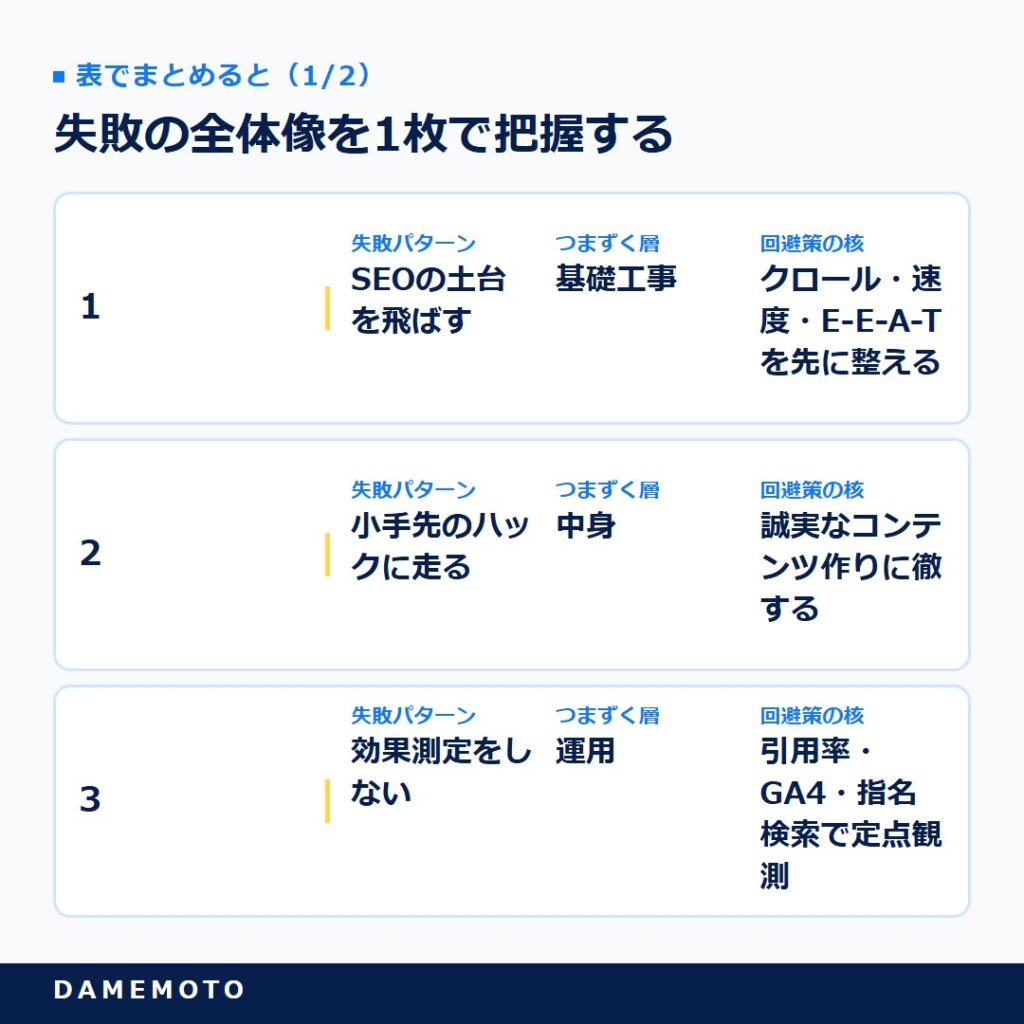
どの層でつまずいているかを切り分けると、打ち手が一気に明確になります。次表は本記事で扱う失敗の見取り図です。
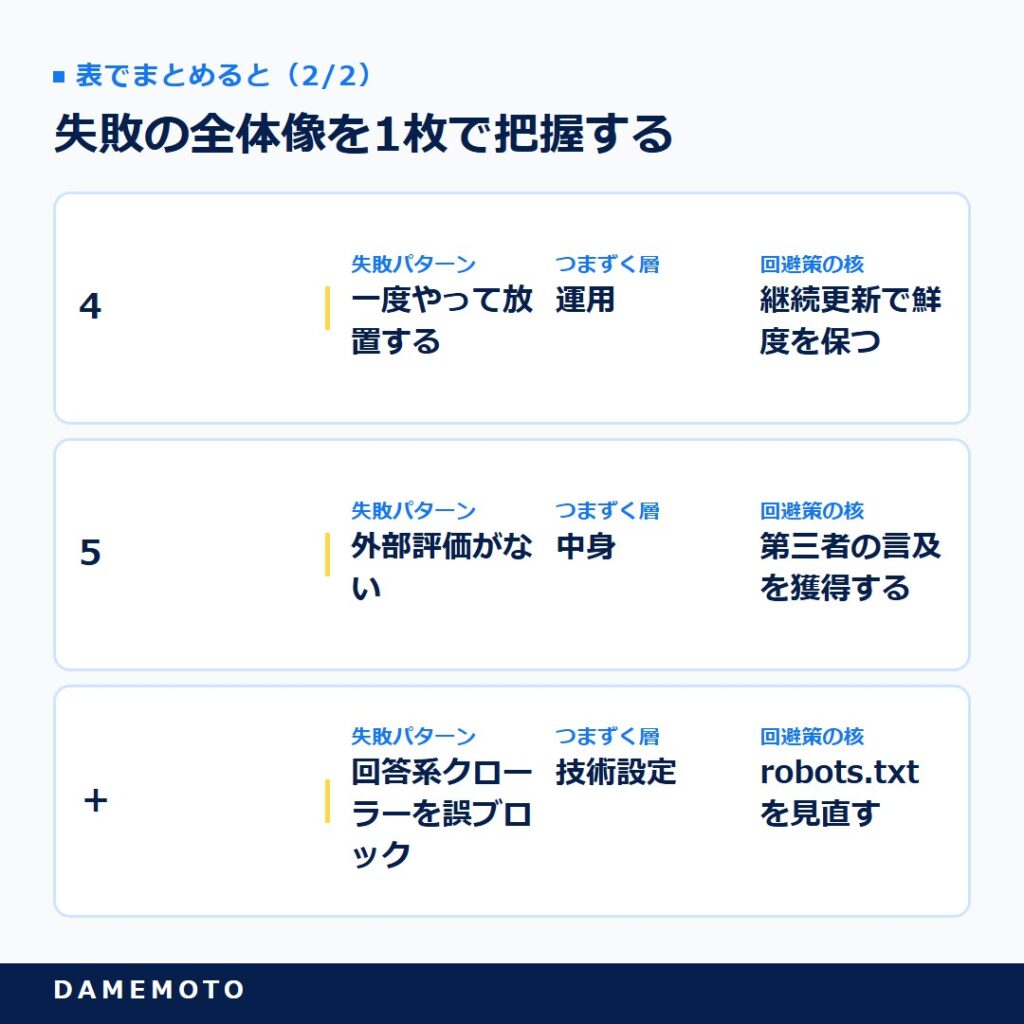
表で詳しく見る
| No. | 失敗パターン | つまずく層 | 回避策の核 |
|---|---|---|---|
| 1 | SEOの土台を飛ばす | 基礎工事 | クロール・速度・E-E-A-Tを先に整える |
| 2 | 小手先のハックに走る | 中身 | 誠実なコンテンツ作りに徹する |
| 3 | 効果測定をしない | 運用 | 引用率・GA4・指名検索で定点観測 |
| 4 | 一度やって放置する | 運用 | 継続更新で鮮度を保つ |
| 5 | 外部評価がない | 中身 | 第三者の言及を獲得する |
| + | 回答系クローラーを誤ブロック | 技術設定 | robots.txtを見直す |
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
失敗1・2:土台を飛ばす/小手先のハックに走る
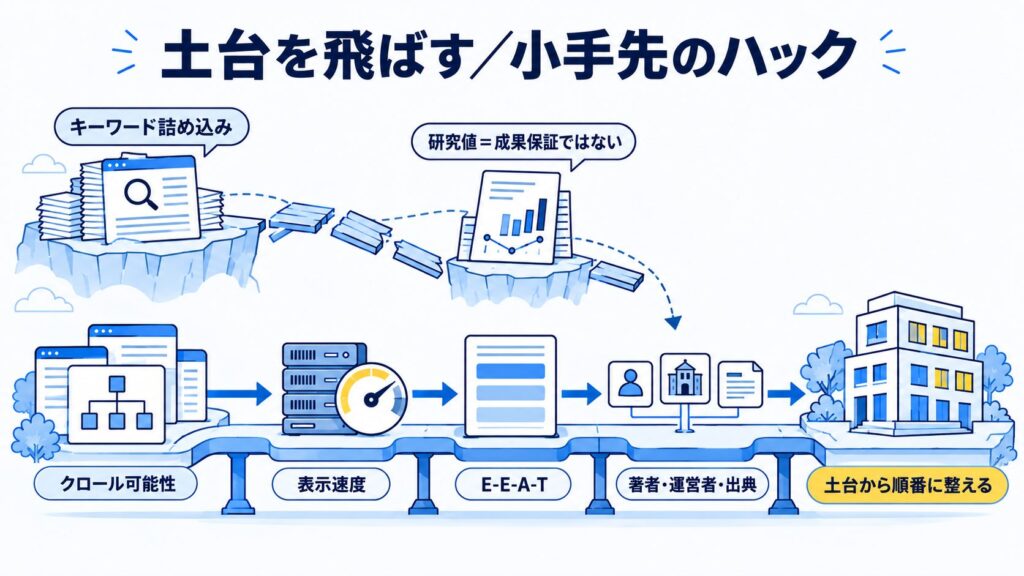
最初の2つは「中身づくりに入る前」のつまずきです。土台を飛ばす失敗は、基礎工事をせずに屋根を乗せる行為。小手先のハックは、楽をして引用を狙う行為。
どちらも「AIに見つけてもらう前提」と「AIに評価される前提」を取り違えています。ここを正すだけで、後続の施策の効きが大きく変わります。
失敗1:SEOの土台を飛ばしてLLMOだけやる
AIが引用判断に使う材料の多くは、Googlebotがクロールしたインデックス・構造化データ・E-E-A-Tです。
SEOの基礎が整っていないサイトは、そもそもAIの参照対象に入りにくくなります。
Googleは2026年5月15日公開の公式ガイドで「生成AI検索の最適化も本質はSEO」と明言し、llms.txtやAI向けの特殊なschemaは不要としています(Google検索セントラル「生成AI機能向け最適化ガイド」)。
クロール可能性・表示速度・E-E-A-Tという土台がないのにLLMOだけやるのは、順序が逆です。
具体的な症状としては、JavaScript依存でクロールされない、ページ速度が遅くインデックスが薄い、運営者情報や一次情報がなくE-E-A-Tが弱い、といった状態が挙げられます。
回避策はシンプルで、まずGoogle Search Consoleでインデックス状況を確認し、Core Web Vitals(LCP2.5秒以内・INP200ms以内・CLS0.1以下が合格目安)を整え、著者情報・運営者情報・出典を明記することです。
土台が整えば、AIに引用される確率は自然と上がります。
失敗2:小手先のハックに走る
GEO研究(KDD 2024)は、回答内での位置や引用された文章量などを用いた可視性指標を評価しています。
GEO-benchは計1万クエリですが、学習8,000・検証1,000・テスト1,000に分かれ、主な手法比較はテスト集合で行われました。
約40%という改善は研究内の指標の相対変化で、現在のChatGPTやGoogleでの引用率・クリック・売上の保証値ではありません。
論文の数値の読み方は、GEO論文(KDD 2024)の要点で整理しています。
キーワード詰め込みを有効策としない
GEO研究の改善幅は実験内の可視性指標です。現在のサービスでの引用率や売上の伸びとは区別します。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
失敗3:効果測定をしないまま量産する
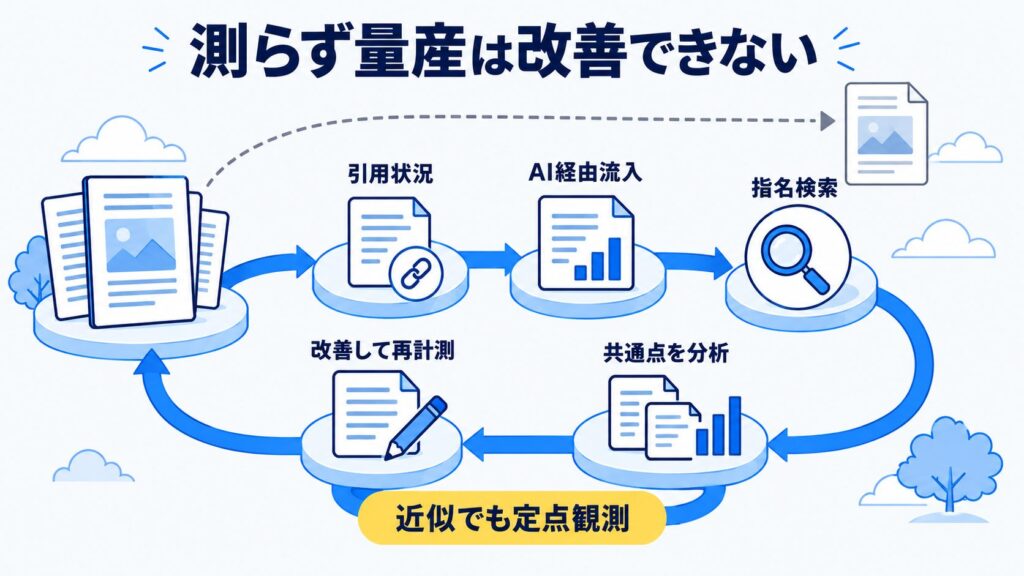
3つ目は運用フェーズで最も多い失敗です。LLMOの最大の難所は効果測定で、「やったつもり」で放置し、引用されているか確認しないケースが後を絶ちません。
測らなければ改善できず、改善できなければ記事をいくら増やしても成果は伸びません。完璧な計測は不要ですが、近似的にでもトレンドを追う仕組みが必要です。
なぜLLMOは測りにくいのか
AIの回答はユーザーごと・セッションごとに生成されるため、検索順位のように固定的な「引用順位」が存在しません。同じ質問でも回答が揺れ、引用回数の把握手段が限られます。
Ahrefsが2026年7月に公開した日本向け分析では、2025年12月時点の1位のCTRは、非表示の場合から推計した24.1%に対し、AIO表示時は9.0%でした。
約62.7%という差は対象データと推計方法に基づくもので、日本の全検索の実測減少率ではありません。流入だけを見ていると施策が無意味に見えてしまうのが、測定を難しくしています。
近似的にでも測る3つの指標
だからこそ、複数の近似指標を組み合わせて定点観測します。代表的なのは次の3系統です。完璧でなくても、トレンドが見えれば施策の方向性は判断できます。
- 引用率の把握:主要プロンプトを定期投入し、自社が引用・言及されるかをモニタリング
- AI経由流入:GA4の参照元やAI Assistantチャネルで、ChatGPT・Perplexity等からの流入を確認
- 間接効果:指名検索数・ブランド名検索の推移で、AIでの露出が需要を生んでいるかを観測
「引用されたか」だけでなく「引用経由で売上に繋がったか」まで追って初めて、施策の良し悪しが判断できます。
編集部の視点で言えば、失敗3が最も「もったいない」失敗です。施策はやっているのに、効果を測っていないから改善できない。
引用されている記事の共通点を分析すれば次に活かせるのに、それをせず量産だけ続ける。計測は地味ですが、ここをサボると成長が止まります。
近似指標を追う道具の選び方は、LLMO効果測定ツールの選び方もあわせて確認しておきたいところです。
DAMEMOTO代表鈴木測らない量産、いちばん効率が悪いです
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
失敗4・5:放置と外部評価の欠如
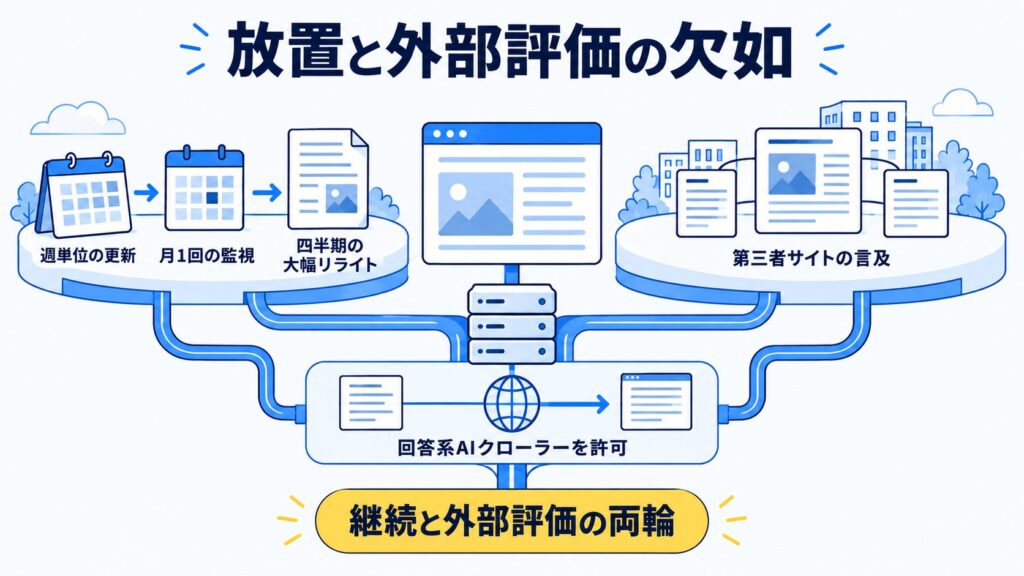
残る2つは、一度やって放置することと、自社主張ばかりで外部評価がないことです。
AI引用コンテンツは時間とともに減衰するため継続更新が必須で、AIは「自社で良いと言っているだけ」のコンテンツより、第三者サイトでの言及(サイテーション)を信頼の根拠にします。
攻めの引用獲得は、継続と外部評価の両輪で成り立ちます。
失敗4:一度やって放置する
「半年前にLLMO対策をやったから大丈夫」と放置すると、特にPerplexityで引用が減衰します。
Perplexityは鮮度(recency)を強く重視し、固定の知識カットオフを持たず継続更新されたインデックスを使うため、公開・更新からの新しさが引用に直結します。
海外の分析でも、新しい情報ほど引用されやすく、古い記事は同テーマの新しい記事に競り負ける傾向が報告されています(Contently「How to Optimize Content for Perplexity AI」)。
週単位の更新、月1回の構造化データ検証と引用状況モニタリング、四半期に1回の大幅リライトが運用の基本です。
見直す記事の優先順位は、リライトの判断基準と優先順位を読むと決めやすくなるはずです。
失敗5:自社主張ばかりで外部評価がない
内部整備(構造化・見出し整理)はSEOの段階で済んでいる企業が多く、そこから本質的に露出を伸ばすには第三者サイトでの言及が要ります。
ニュースサイト・比較サイト・レビューサイト・業界メディアでの露出を強化し、「他者からの推薦」を獲得することが核心です。
実際、AI検索エンジンが最も多く引用するドメインを調べた調査では、Reddit・YouTube・LinkedInなどの第三者プラットフォームが上位を占め、PerplexityではクエリのカテゴリによってReddit由来の引用が最大46.7%に達したと報告されています(Search Engine Land「AI search engines cite Reddit, YouTube, and LinkedIn most」)。
自社サイトの作り込みだけでは届かない領域がある、という事実を直視する必要があります。
第三者の言及、効きどころが違います
見落としがちな失敗+:AIクローラーの誤ブロック
5パターン以外で最も見落とされるのが、robots.txtで回答系AIクローラーをブロックしているケースです。
OpenAIは学習用のGPTBotと検索用のOAI-SearchBot・ChatGPT-Userを、Perplexityはインデックス用のPerplexityBotと取得用のPerplexity-Userを、Anthropicは学習・検索・取得でClaudeBot・Claude-SearchBot・Claude-Userを使い分けています(Search Engine Journal「Anthropic’s Claude Bots Make Robots.txt Decisions More Granular」)。
学習系と回答系を混同して一律ブロックすると、どれだけ良いコンテンツでもAIの参照対象から外れます。重要なのは、学習系をブロックしても回答系は別UAなので検索引用には影響しない点。
回答系クローラーの許可を必ず確認
失敗の根本原因と「脱・近道」の考え方
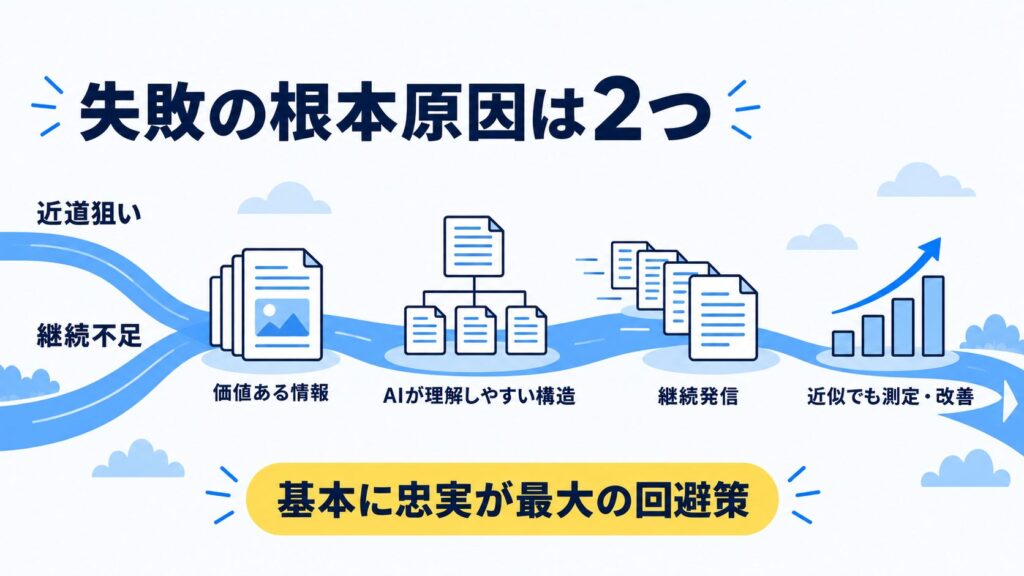
6つの失敗を貫く根本原因は「近道狙い」と「継続不足」です。少ない手間で大きな効果を得ようとする施策は、短期的に効いても必ず反動が来ます。
LLMOの本質は「ユーザーにとって価値ある情報を、AIが理解しやすい構造で、継続的に発信する」こと。この原則から外れた施策は機能しません。
「近道狙い」がほぼすべての失敗を生む
出典や統計は、根拠を確認したうえで説明に必要な箇所へ加えます。研究の数値を成果保証や数値追加のノルマにしないことが大切です。
「測れない」を言い訳にしない
LLMOは効果測定が難しいですが、それを「やらない言い訳」にしてはいけません。
引用率はプロンプトモニタリングで、AI経由流入はGA4で、間接効果は指名検索の推移で、それぞれ近似的に測れます。完璧な計測でなくても、トレンドを追えば施策の方向性は判断できます。
「測れないから放置」ではなく「近似的にでも測って改善」する姿勢が、失敗3・4を同時に防ぎます。
構造化データは「表示が消えても残す」
細かいが重要な落とし穴として、Googleは2026年5月7日にFAQリッチリザルトの視覚表示を終了しました。
これを受けてFAQの構造化データを慌てて削除する動きがありますが、Google公式は「FAQPage構造化データを削除する必要はない」と明言しています(Web担当者Forum「グーグル、FAQリッチリザルトのサポートを完全終了」)。
表示層が閉じただけで、AIが引用元を抽出する際の理解層としては有効です。「表示されないから無意味」と早合点して構造化データを外すのも、地味な失敗の一つです。
FAQPageの実装方法は、FAQPage構造化データ実装ガイドでJSON-LD例とともにまとめています。
基本に忠実が最大の回避策
この対策が不要・非推奨な人(正直コーナー)
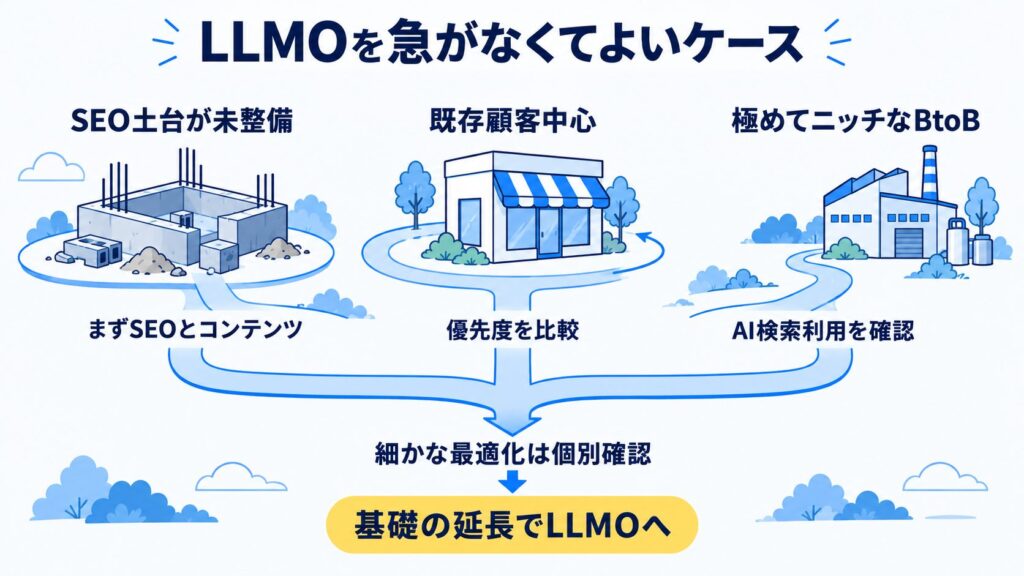
本記事は「LLMOの失敗を避けたい人」に向けていますが、すべての事業者にLLMOが最優先というわけではありません。正直に、急いで取り組む必要が薄いケースと、この記事だけでは分からないことを明示します。
LLMO対策を急がなくてよいケース
そもそもSEOの土台が未整備のサイト、指名検索や既存顧客中心で集客が回っている事業、AI検索の利用が少ない極めてニッチなBtoB領域などは、LLMOより先に着手すべきことが残っています。
失敗1で述べた通り、土台がないままLLMOだけ進めても効果は出にくいからです。まずはSEOとコンテンツの基礎を固め、その延長線上でLLMOに広げるのが順序として正解です。
土台の上に積むLLMOの進め方は、LLMO対策完全ガイドで整理しています。
この記事で分からないこと
本記事は「失敗の型と回避の考え方」に焦点を当てており、各AIプラットフォームごとの細かな最適化手順や、最新の引用アルゴリズムの内部仕様までは扱いません。
AI各社の仕様・利用者数・引用傾向は流動的で、本記事執筆時点(2026年6月)で確認できない数値は記載していません。
プラットフォーム別の具体策は個別記事を、確定していない領域は一次情報の更新を随時確認してください。
置き土産:LLMO失敗回避セルフチェック10項目
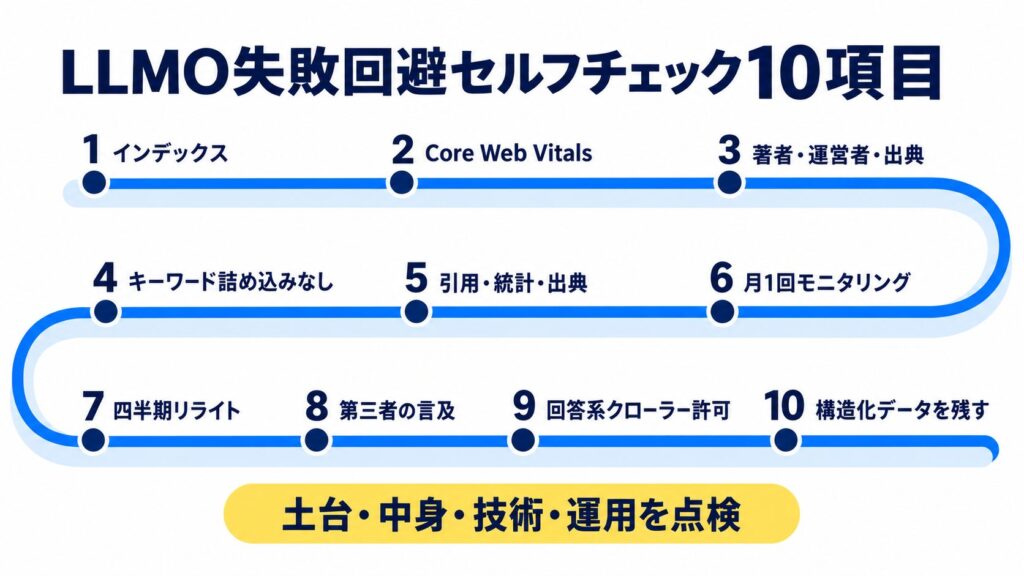
最後に、保存して使える「失敗回避セルフチェックリスト」を置いていきます。施策の前後で点検すれば、6つの典型失敗をほぼ網羅的に防げます。すべてに「はい」と答えられる状態が、反動のないLLMOの基準線です。
- Search Consoleでインデックスされているか
- Core Web Vitalsは合格目安内か
- 著者・運営者情報と出典が明記されているか
- 不自然なキーワード詰め込みをしていないか
- 引用文・統計・出典で情報を強化しているか
- 引用状況を月1回はモニタリングしているか
- 四半期に1回は大幅リライトしているか
- 第三者サイトでの言及が獲得できているか
- 回答系AIクローラーを許可しているか
- 構造化データを表示終了だけで削除していないか
このリストは、施策の着手前チェックにも、半期ごとの運用監査にも使えます。
多くの人は「中身(コンテンツ)」ばかりを疑いますが、実際は土台や技術設定の見落としが原因のことも少なくありません。
3層(土台・中身・技術)と運用の観点でまんべんなく点検することが、原因の早期特定につながります。
よくある質問
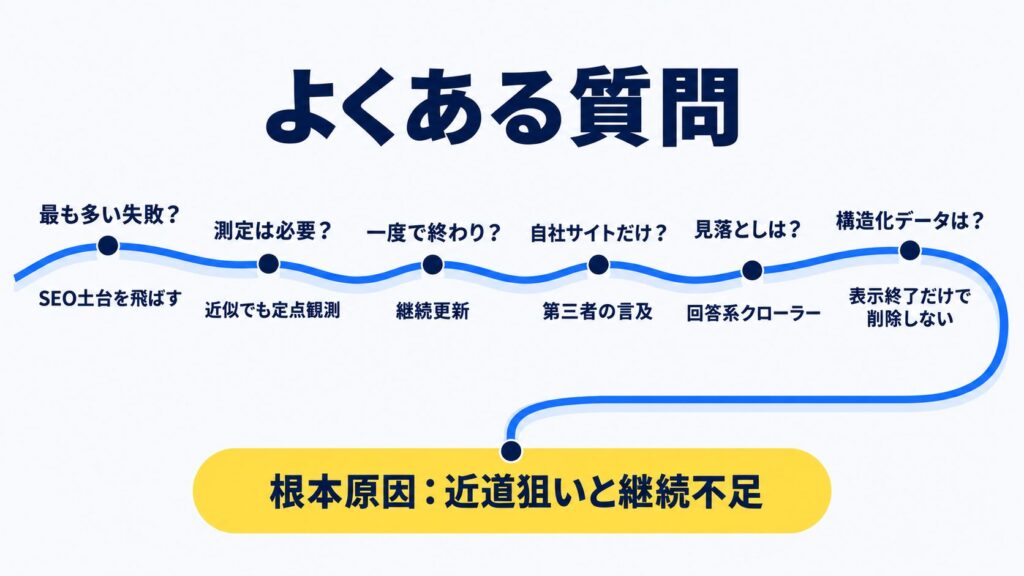
- LLMOで最も多い失敗は?
-
SEOの土台を飛ばしてLLMOだけやることです。AIの引用材料の多くはGooglebotのインデックスやE-E-A-Tで、土台が前提になります。
- LLMOでハックを使って引用を狙ってもいい?
-
施策の評価には、自社で定めた質問集合と実際の引用結果を使います。研究結果は仮説の参考とし、同じ改善幅の再現は前提にしません。
- LLMOの効果測定はしなくてもいい?
-
必要です。測らないと改善できません。引用率(プロンプトモニタリング)・GA4のAI経由流入・指名検索の推移を組み合わせ、近似的にでもトレンドを追います。
- LLMO対策は一度やれば終わりですか?
-
終わりません。Perplexityは鮮度を強く重視するため、放置すると引用が減衰します。週単位の更新と四半期の大幅リライトが運用の基本です。
- 自社サイトの対策だけでAIに引用されますか?
-
されにくいのが実情です。「自社で良いと言っているだけ」はAIが評価しにくく、第三者サイトでの言及(サイテーション)が信頼の根拠になります。
- LLMOで見落としがちな失敗は?
-
回答系AIクローラーのブロックです。OAI-SearchBotやPerplexityBot、ClaudeBot等をDisallowにすると、良い記事でもAIの参照対象に入りません。学習系と回答系は別UAなので分けて設定します。
- AI引用を考えるとFAQの構造化データは消すべき?
-
消す必要はありません。2026年5月にFAQリッチリザルトの視覚表示は終了しましたが、Google公式は構造化データの削除は不要としています。AIの引用元抽出には有効に働きます。
- LLMOの失敗の根本原因は何ですか?
-
「近道狙い」と「継続不足」の2つです。楽をして成果を出そうとする施策はAIに検出されやすく、短期的に効いても反動が来ます。
- LLMOで最初に着手すべき失敗対策は?
-
SEOの土台の点検です。インデックス・表示速度・E-E-A-T・出典が整っているかを確認し、そのうえで一次情報の発信と継続更新に進むと効率的です。
まとめ:LLMOの失敗は「近道と継続不足」、王道は地道さ
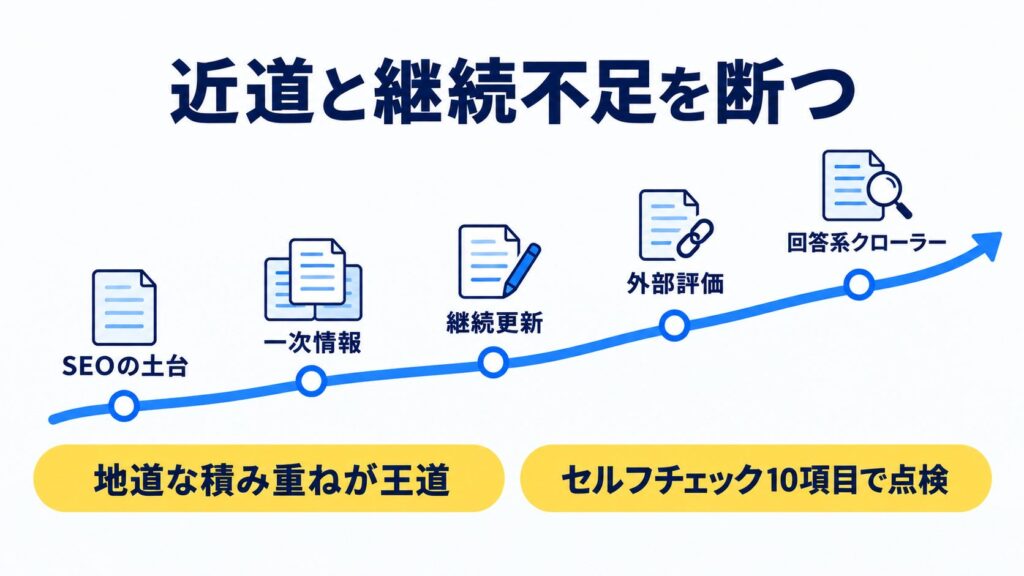
LLMOで失敗する典型パターンは、SEO土台を飛ばす・小手先ハック・効果測定なし・放置・外部評価の欠如の5つに、回答系AIクローラーの誤ブロックを加えた構図です。
共通項は「近道狙い」と「継続不足」。AIは表面的操作を検出する方向に進化しており、近道は逆効果になります。
SEOの土台・一次情報・継続更新・外部評価という地道な積み重ねこそ、反動なくAIに選ばれ続ける王道です。
今日できる一歩として、まずは失敗回避セルフチェック10項目で自社の現在地を点検してみてください。
- 近道狙いと継続不足が根本原因
- 読者の理解を妨げるキーワード詰め込みは避ける
- 土台・中身・技術・運用を地道に積む
参考URL一覧
- Google検索セントラル・生成AI機能向け最適化ガイド:https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=ja
- arXiv・GEO: Generative Engine Optimization(キーワード詰め込み-10%の実証):https://arxiv.org/abs/2311.09735
- Ahrefs・AI Overviews reduce clicks(CTR世界58%/日本37.8%減):https://ahrefs.com/blog/ai-overviews-reduce-clicks-update
- Search Engine Journal・Anthropic Claude Bots robots.txt:https://www.searchenginejournal.com/anthropics-claude-bots-make-robots-txt-decisions-more-granular/568253/
- Search Engine Land・AI search engines cite Reddit, YouTube, LinkedIn most:https://searchengineland.com/ai-search-engines-cite-reddit-youtube-and-linkedin-most-study-473138
- Contently・How to Optimize Content for Perplexity AI(鮮度重視):https://contently.com/2026/02/20/how-to-optimize-content-for-perplexity-ai/
- Web担当者Forum・グーグル、FAQリッチリザルトのサポートを完全終了:https://webtan.impress.co.jp/e/2026/05/22/52663/page/1
補足参考資料