エンティティ最適化とは、企業名・サービス名・人名などの固有名詞を、AIや検索エンジンが「同一の実体」として正しく認識できるよう情報を整える施策です。
生成AIは、質問に答える前に固有名詞をナレッジグラフ上の実体(エンティティ)に照合し、信頼できる情報源を選びます。
自社が実体として認識されていなければ、どれだけ良い記事を書いても引用候補に乗りません。
核となるのは、Organization構造化データ(name・logo・sameAs)の実装、会社概要の充実、表記の一貫性(NAP)、Wikipedia/Wikidataなど権威ある外部ソースとの連結、そして第三者からの一貫した言及です。本記事はこれを実装手順に落とし込みます。
この記事の結論
エンティティ最適化は、地味でもAIに引用される前提をつくる土台の仕事だと考えています
今日からやること
- 会社概要ページにOrganization構造化データを置く
- sameAsに公式SNSや外部プロフィールを並べる
- 社名・住所・設立年の表記を全媒体でそろえる
こんな人向け:AIに自社名を正しく覚えてもらいたい中小企業の広報・Web担当の方数値の出典:Google検索セントラル「Organization構造化データ」
エンティティ最適化とは:AIに自社を「一つの実体」として認識させる
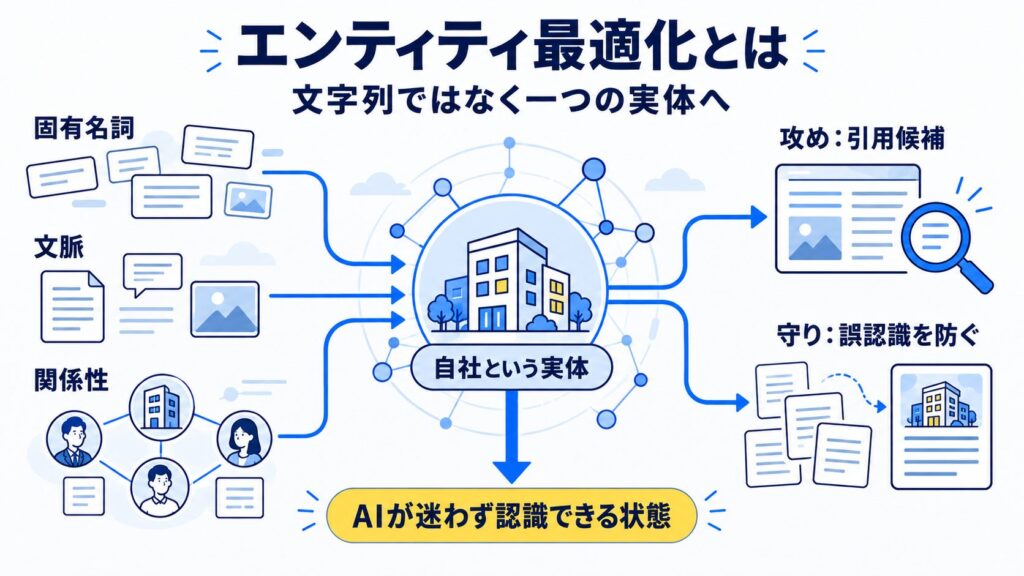
先に結論を言うと、エンティティ最適化とは「AIが自社を、世界に一つだけの固有の実体として迷わず認識できる状態」を作る作業です。
エンティティとは、人名・企業名・製品名・場所・概念など、検索エンジンや生成AIが固有の意味を持つものとして識別する対象を指します。
大規模言語モデルはWebテキストを丸暗記するのではなく、「エンティティ」と「その関係性」のネットワークとして知識を保持します。
だからこそ、自社という実体の輪郭がぼやけていると、AIの知識ネットワークの中で自社が存在しないも同然になります。
AIは固有名詞をナレッジグラフのIDに照合する
生成AIは質問に答える際、まず固有名詞をナレッジグラフ上の実体に照合し、紐づく情報源を選びます。
SEM Plusは、自社のエンティティが正しく認識されていないと自社情報が引用候補から外れると指摘しています(SEM PlusのLLMO解説)。ここで二つの作業が必要になります。
第一に「自社が実在する固有の組織だ」と機械可読な形で示すこと、第二に「その組織が何の専門家か」という文脈を一貫して与えることです。
前者はOrganization構造化データ、後者は会社概要や第三者言及が担います。
「実体の曖昧さ(Entity Ambiguity)」を排除する
自社サービス名が一般的な単語(例:「Next」「Apple」「ベース」)と重なる場合、AIはそれを一般名詞や他の有名な実体と混同します。
これがEntity Ambiguity(実体の曖昧さ)です。
排除の基本は、Aboutページ・フッター・各記事の中で「○○(ブランド名)は△△業界の××サービスである」という文脈を一貫して繰り返し提示し続けること。
トロブズは、AIに「文字列」ではなく「実体」として認識させるには、ブランド名と説明を同じ表現でそろえて発信することが要だと整理しています(トロブズのエンティティ・リンキング解説)。
固有名詞と文脈をセットで定着させる——これが曖昧さ排除の出発点です。
エンティティ最適化はLLMOの「攻め」と「守り」の土台
エンティティ最適化は即効性のある施策ではなく、長期的な土台づくりです。
AIに自社を正しく認識させることで、「業界20年の実績」「特許技術Aを保有」といった断片が一つの実体に統合的に紐づきます。
これらが個別ブログ記事として散在しているだけでは、AIは「同じ会社の話だ」と束ねられません。土台が固まれば、引用獲得という「攻め」だけでなく、誤情報の流布を防ぐ「守り」も効きます。
エンティティ最適化を含むLLMO全体の打ち手は、LLMO対策完全ガイドで整理しています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
ナレッジグラフと構造化データ:機械可読に自社を定義する
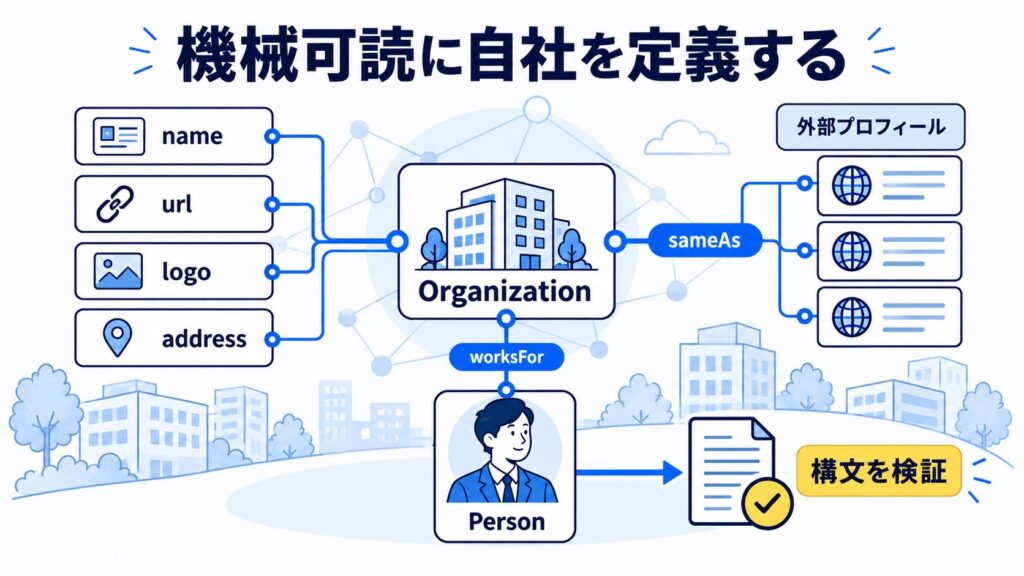
ナレッジグラフとは、実体と実体の関係を結んだ巨大な知識のネットワークです。
AIに自社を載せる第一歩は、自社サイトに正しいOrganization構造化データを置き、外部の権威ある実体とsameAsで連結すること。
ここは推測ではなくGoogle公式の仕様に沿って実装できる、エンティティ最適化で最も再現性の高い領域です。検索結果に出る情報ボックスの仕組みと認証の手順は、ナレッジパネルの表示条件と認証・修正の手順で整理しています。
Organization構造化データの実装(Google公式仕様)
Googleは公式ドキュメントで、ホームページにOrganization構造化データを追加すると「組織の管理情報の理解を助け、検索結果上で自社を他社と区別(disambiguate)できる」と明記しています(Google検索セントラル・Organization構造化データ。最終更新2026年9月8日)。
重要なのは、必須プロパティは存在せず「関連するプロパティをできるだけ多く追加する」という方針である点。
推奨されるのは、name(site nameと一致させる)・alternateName・url・logo(112×112px以上・クロール可能)・address・telephone・description、そして外部連結のためのsameAsです。
設置場所はホームページか会社概要(About us)ページが推奨されています。
sameAsで外部の権威プロフィールに連結する
sameAsは、自社を語る外部ページのURLを束ねるプロパティです。
Googleの定義では「自社に関する追加情報が載った別サイトのページのURL(SNSやレビューサイトのプロフィールなど)。複数指定できる」とされています。
LLMO観点では、ここにWikipedia・Wikidataのエントリ、公式SNS(X・Facebook・LinkedIn・YouTube)、業界ディレクトリのプロフィールを並べることで、AIが「これらは全て同一の組織だ」と束ねやすくなります。
LLMO研究所も、Organization・Person等のSchema型と、外部リソースを指すsameAsをそろえることがナレッジグラフ整備の起点だとしています(LLMO研究所・JSON-LD実装戦略)。
実装後はGoogleのリッチリザルトテストで構文を検証します。
Personスキーマと著者情報で「誰が」を明確にする
組織だけでなく「人」の実体も整えると効果が高まります。
代表者や執筆者にPersonスキーマを実装し、name・jobTitle・worksFor(自社Organizationへの参照)・sameAs(本人のSNSや登壇プロフィール)を記述します。
これにより「この記事を書いたのは、この会社に所属する、この分野の専門家だ」という関係性がAIに伝わります。
著者の専門性はE-E-A-Tの中核であり、AIが情報源の信頼性を判断する材料にもなります。属人的な発信が多いBtoBほど効果が見込めます。
著者情報の整え方は、オーサーシップと著者プロフィール整備もあわせて確認しておきたいところです。

必須項目ゼロ、でも入れた分だけ実体が濃くなります
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
Wikipedia・Wikidataと第三者言及:外部からの裏付けを増やす
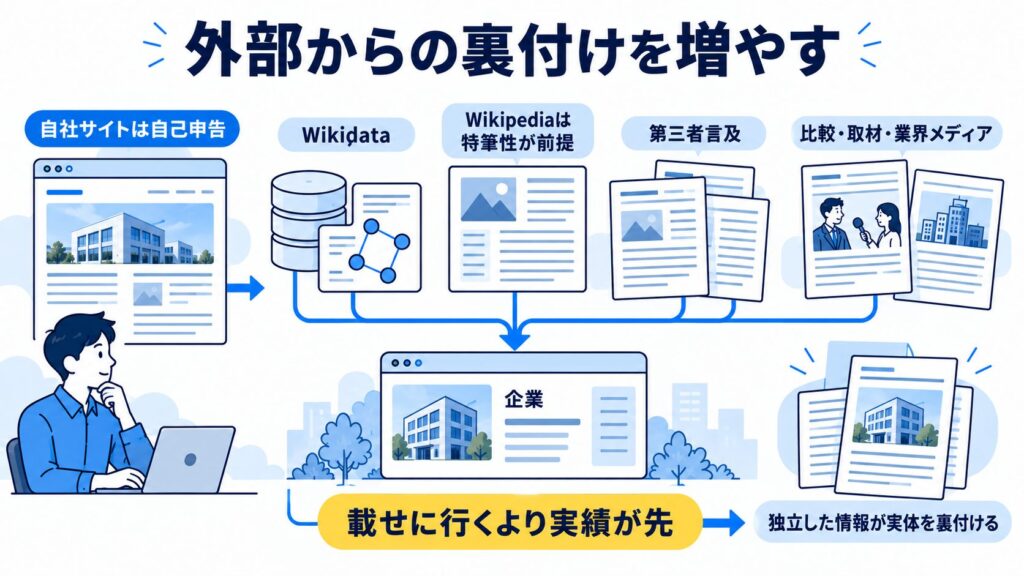
自社サイトの構造化データは「自己申告」です。AIはそれだけでは信頼しきりません。
複数の独立した外部ソースが同じ事実を語っている状態——いわゆる外部からの裏付けが、エンティティの信頼度を決めます。
ここで効くのが、Wikipedia/Wikidataへの掲載と、第三者メディアでの一貫した言及(サイテーション)です。
WikidataとWikipediaはなぜ効くのか
Wikipediaとその構造化データベースであるWikidataは、多くの大規模言語モデルの学習データの中でも信頼度の高いソースとして扱われます。
フランクマーケティングは、WikidataがSEO・LLMO・ナレッジグラフを下支えする「見えないインフラ」として機能すると解説しています(フランクマーケティング・Wikidata解説)。
ChatGPT・Perplexity・Google AI Overviewsは回答生成時にこれらを高い信頼度で参照する傾向があり、百科事典的記述と自社の構造化データが一致しているとAI回答に登場しやすくなります。
ただしWikipediaは「自社で書いて宣伝する場所」ではありません。
Wikipedia掲載は「特筆性」が壁(正直な前提)
Wikipedia日本語版の「特筆性(組織)」では、掲載には対象と利害関係のない独立した第三者による有意な言及が複数必要とされ、利害関係者が書いた情報源は特筆性の証明に使えません(Wikipedia:特筆性(組織))。
つまり多くの中小企業にとって、Wikipedia掲載は「やればできる施策」ではなく「実績の結果として満たせるかどうか」のハードルです。
掲載基準を満たす企業は正確な情報を整える価値がありますが、満たさない場合に無理な作成を試みるのは逆効果。
Wikidataはエントリ作成の自由度が比較的高いため、まずはこちらの整備から検討するのが現実的です。
DAMEMOTO代表鈴木「載せに行く」より「載るに値する実績」が先です
第三者サイトでの言及(サイテーション)を増やす
「自社で良いと言っているだけ」ではAIは評価しません。
サイテーション(リンクの有無を問わず、Web上で自社名・サービス名・代表者名が言及されること)を増やすことが、実体の信頼性を押し上げます。
スリードットは、AIは同じ情報が複数の独立したソースで言及されているときに信頼すると整理しています(スリードット・サイテーション解説)。
ニュースサイト・業界メディア・比較サイト・登壇/取材記事での露出を、表記をそろえて積み上げます。プレスリリース配信や業界メディアへの寄稿が現実的な打ち手です。
第三者からの言及を増やす具体策は、サイテーション獲得の5つの方法でまとめています。
「○選」リスト記事・比較記事への掲載を狙う
「○○のおすすめ会社10選」のようなリスト記事・比較記事への掲載は、選定文脈での候補入りに直結します。
AKARUMI(株式会社ipe)がBtoB支援会社・サービスを対象に行った300プロンプト調査(データ取得日2026年5月19日)では、公式サイトと並んで比較記事・費用相場記事がAI回答の主要な引用元になっていました(PR TIMES・AKARUMI INSIGHTS)。
つまり「自社が業界の比較記事に繰り返し登場する状態」を作れば、AIに「この分野の候補企業」と認識されやすくなります。掲載依頼・寄稿・取材対応で露出を増やします。
外部の裏付けが信頼を作る
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
NAP一貫性と表記ゆれの排除:実体の輪郭をぼかさない
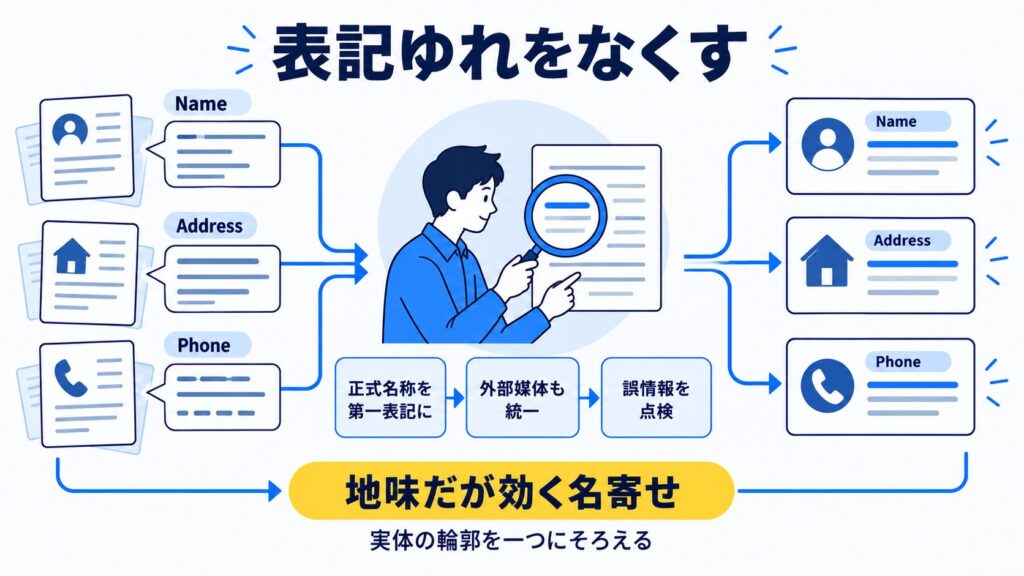
エンティティ最適化で最も見落とされ、かつ最も効くのが表記の一貫性です。
NAP(Name・Address・Phone=名称・住所・電話番号)をはじめ、社名・所在地・設立年・代表者名が媒体ごとに食い違うと、AIは「同じ会社」と束ねられず、実体の輪郭がぼやけます。地味ですが、土台のさらに土台にあたる作業です。
なぜ表記ゆれが評価を下げるのか
AIは固有名詞を軸に周辺情報を関連付けます。
「株式会社○○」と「○○株式会社」、「(株)○○」と「○○」、旧社名と新社名、英語表記と日本語表記が混在すると、AIはそれらを別々の実体と認識する恐れがあります。
AtoZ Designは、サイトAで「株式会社ABC」、サイトBで「(株)ABC」と表記が異なると別企業と認識されうると指摘します(AtoZ Design・エンティティ最適化解説)。
第一表記(正式名称)を決め、やむを得ず略称を使う場面では正式名称を併記する。この単純なルールの徹底が効きます。
自社サイトだけでなく外部媒体も統一する
表記統一は自社サイトだけでは足りません。
社名・所在地・設立年・代表者名は、商工会議所や業界団体の名簿、登記情報、取引先の紹介ページ、求人サイトの会社情報など、複数の外部媒体に散在します。
これらに古い記載や差異があると、AIは情報の正確性に疑問を持ちます。
NAP一貫性はもともとMEO(ローカルSEO)で重視されてきた概念ですが、LLMO時代には全社的なエンティティ信頼の指標として再注目されています。
定期的な棚卸しで、外部も含めて最新かつ統一された内容に保つことが必要です。NAPを重視してきたMEOの基本は、ローカルSEO(MEO)の最新対策を読むと理解しやすくなるはずです。外部の媒体を直す前に「正」の表記を決める自社ページの作り方は、会社概要の書き方で確かめられます。
エンティティが弱いと「誤情報」が広がるリスク
自社のエンティティ情報がWeb上に十分存在しないと、第三者の断片的・不正確な情報が一人歩きし、AIが自社について誤った内容を語るリスクが高まります。
これはハルシネーション対策という、LLMOの「守り」の側面です。攻めの引用獲得に走る前に、まず自社が正しく認識されているかを、各AIに自社名で質問して確認するのが堅実です。
正確な一次情報を自ら整え、構造化データと外部の裏付けで補強する。この守りが、結果的に攻めの精度も上げます。
正直なところ、エンティティ最適化は「地味だが効く」施策の代表格です。構造化データの実装や表記の名寄せは、派手な引用獲得テクニックに比べて見栄えがしません。
それでも、AIが自社を「誰なのか」正しく認識していなければ、どれほど良い記事も引用の土俵に乗れません。土台づくりこそ最初にやるべき仕事だと、編集部は考えています。
地味だが効く名寄せ作業
この施策が「不要・後回し」でよい人(正直コーナー)
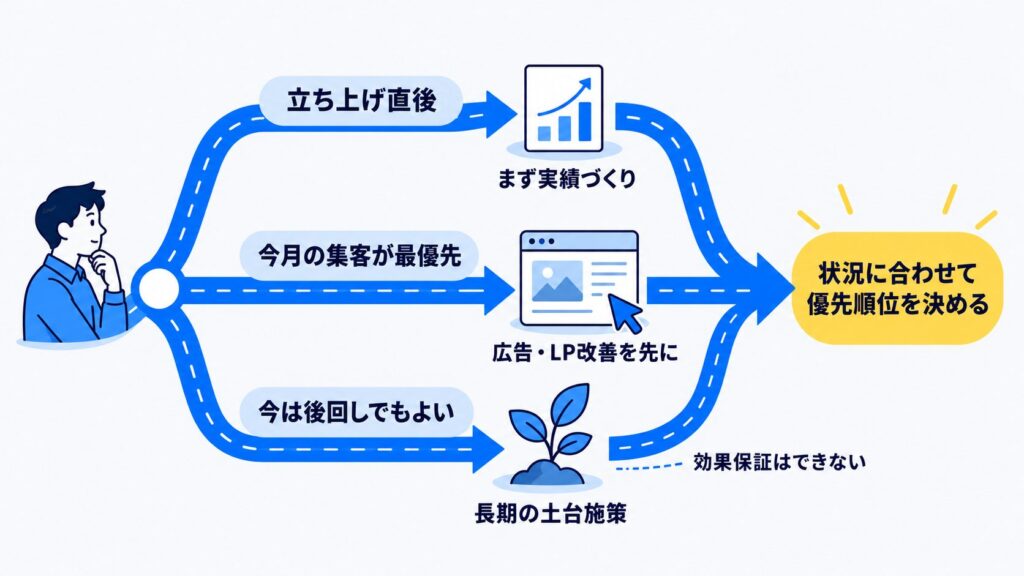
エンティティ最適化は万能ではありません。費用対効果が薄いケースや、優先順位を下げてよいケースを正直に挙げます。読者の状況次第では「今はやらなくていい」が正解です。
立ち上げ直後で実績が乏しい場合
創業直後で第三者言及がほぼゼロの段階では、Wikipedia掲載は特筆性の壁で現実的でなく、サイテーションも母数が足りません。
この段階で凝った施策に時間を割くより、まずは本業の実績づくりと、Organization構造化データ・会社概要・表記統一という「自分でできる範囲」を固める方が費用対効果は高くなります。
外部の裏付けは、実績が積み上がってから自然に増やすものです。自分で進められる構造化データの実装は、JSON-LDによる構造化データ実装ガイドで手順を整理しています。
即効の集客成果を今月求めている場合
エンティティ最適化は長期の土台づくりで、来月のリード数を跳ね上げる施策ではありません。短期のCV獲得が最優先なら、広告やランディングページ改善を先に回すべきです。
本施策は「半年〜1年かけてAIに正しく覚えてもらう」投資だと割り切れる場合に効きます。即効性を期待して始めると、成果が見えず途中で投げ出すことになりがちです。
この記事で分からないこと(限界の明示)
sameAsやWikidata連結が「どのAIで・どの程度・いつまでに」引用率を上げるかを保証する公開データは、2026年6月時点で確立されていません。
各社が効果を報告していますが、AI各社は内部のランキング・引用ロジックを公開しておらず、施策と成果の因果は断定できないのが実情です。
本記事は「公式仕様に沿った再現性のある実装」と「複数ソースで共通する考え方」を示すもので、特定の数値効果を約束するものではありません。
効果保証はできない、でも土台は確実に効きます
【保存版】エンティティ最適化・実装チェックリストと名寄せ手順
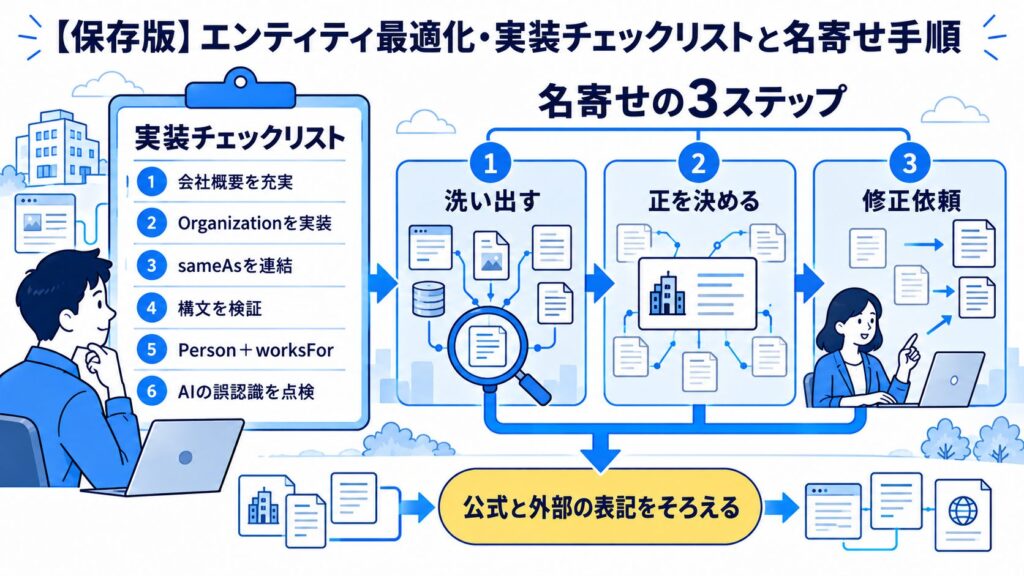
抽象論で終わらせないために、そのまま着手できる実装チェックリストと、表記ゆれを潰す名寄せ手順をまとめます。上から順に進めれば、自分でできる範囲から外部連携まで一通りカバーできます。コピーして社内タスク表に転記してください。
置き土産1:実装チェックリスト(優先順)
- 会社概要を充実(設立年・所在地・代表者・資格・沿革)
- Organizationスキーマ実装(name/url/logo/address/sameAs)
- sameAsに公式SNS・Wikidata等を列挙
- リッチリザルトテストで構文検証
- 代表者・執筆者にPersonスキーマ+worksFor
- 各AIに自社名で質問し誤認識を点検
置き土産2:表記ゆれ点検テーブル
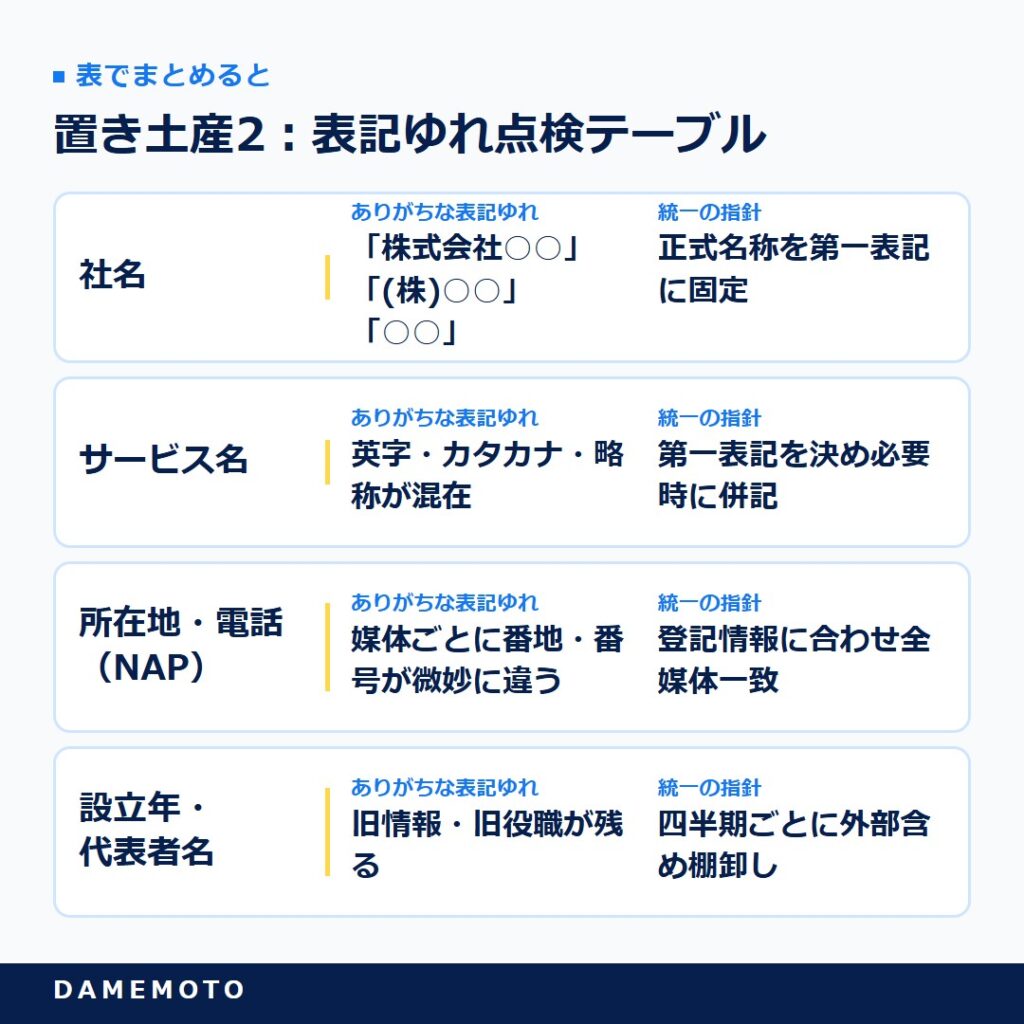
表で詳しく見る
| 項目 | ありがちな表記ゆれ | 統一の指針 |
|---|---|---|
| 社名 | 「株式会社○○」「(株)○○」「○○」 | 正式名称を第一表記に固定 |
| サービス名 | 英字・カタカナ・略称が混在 | 第一表記を決め必要時に併記 |
| 所在地・電話(NAP) | 媒体ごとに番地・番号が微妙に違う | 登記情報に合わせ全媒体一致 |
| 設立年・代表者名 | 旧情報・旧役職が残る | 四半期ごとに外部含め棚卸し |
名寄せの進め方(3ステップ)
第一に、自社名・サービス名で検索し、自社が登場する全媒体(公式・SNS・名簿・求人・取材記事)を洗い出します。
第二に、上表の指針で「正」の表記を一つに定め、自社サイトとSNSプロフィールから直します。第三に、外部媒体は運営元へ修正依頼を出し、対応可否を記録します。
見落としがちなのは、自社サイトだけ整えて外部を放置することです。
AIは外部ソースも参照するため、公式サイトと求人サイトで設立年が違うといった矛盾があるとエンティティ認識が揺らぎます。構造化データで機械可読にしつつ、外部も含めて表記を一致させる。
この名寄せが、AIに自社を一つの実体として覚えさせる地味だが確実な一手です。会社の公式サイトでエンティティと信頼を設計する流れは、コーポレートサイトSEO事例もあわせて確認しておきたいところです。
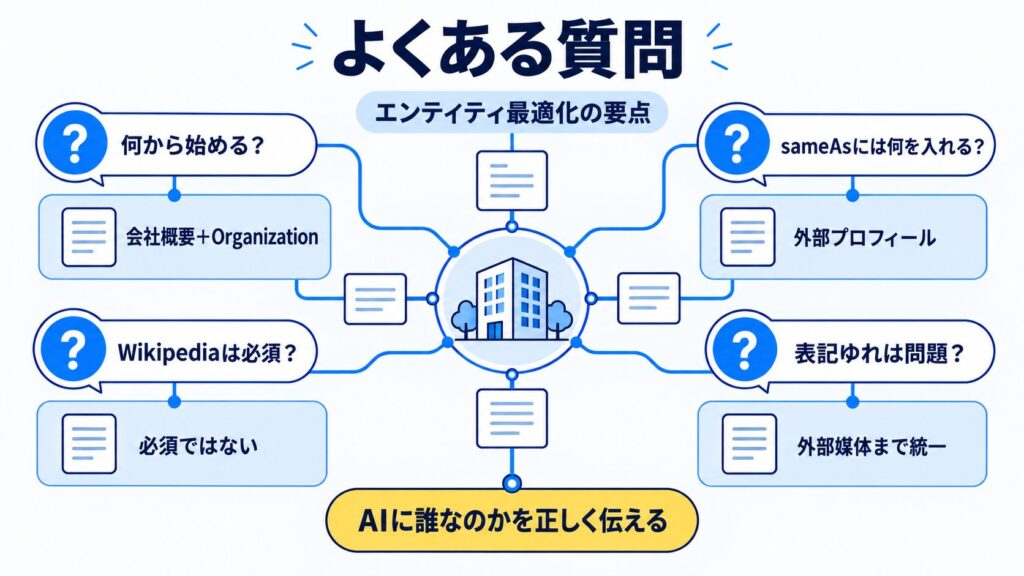
よくある質問
- エンティティとは何ですか?
-
検索エンジンや生成AIが「固有の意味を持つもの」として識別する対象です。人名・企業名・製品名・場所・概念などが含まれます。
- なぜエンティティ最適化が重要なのですか?
-
生成AIは固有名詞をナレッジグラフ上の実体に照合してから情報源を選ぶためです。自社が実体として認識されないと、そもそも引用候補に入れません。良い記事を書く前提として、まず「誰なのか」を正しく伝える必要があります。
- エンティティ最適化は何から始めればいいですか?
-
会社概要の充実とOrganization構造化データの実装です。name・url・logo・address・sameAsを記述し、リッチリザルトテストで検証します。自分で着手でき、Google公式仕様に沿うため再現性が高い領域です。
- エンティティ最適化でsameAsには何を入れますか?
-
自社を語る外部ページのURLです。公式SNS、Wikipedia・Wikidataのエントリ、業界ディレクトリのプロフィールなどを複数並べると、AIが「同一の組織」と束ねやすくなります。
- エンティティ最適化にWikipedia掲載は必須ですか?
-
必須ではありません。掲載には独立した第三者による有意な言及が複数必要で、自社で書いて宣伝することは認められていません。基準を満たさない場合は、まずWikidataの整備や構造化データから着手するのが現実的です。
- エンティティ認識でNAPや表記ゆれはそんなに問題ですか?
-
問題になり得ます。社名・住所・電話・設立年が媒体間で食い違うと、AIが別の実体と誤認したり情報の正確性を疑ったりします。正式名称を第一表記に固定し、外部媒体まで含めて統一します。
- サービス名が一般的な単語だとエンティティとして不利ですか?
-
不利になり得ます。AIが一般名詞や別の有名な実体と混同するためです。「○○は△△業界の××サービス」という文脈を一貫して提示し続け、実体を定着させます。
- エンティティの信頼に第三者の言及はなぜ重要なのですか?
-
AIは同じ情報が複数の独立したソースで語られているときに信頼するためです。自社サイトの自己申告だけでなく、外部メディアでの一貫した言及が実体の信頼度を押し上げます。
- エンティティ最適化の効果はどのくらいで出ますか?
-
長期の土台施策のため即効性は期待しにくく、半年〜1年単位で捉えるのが現実的です。AI各社が引用ロジックを公開していないため、特定の数値効果は保証できません。
まとめ:エンティティ最適化は「定義し・連結し・裏付け・統一する」
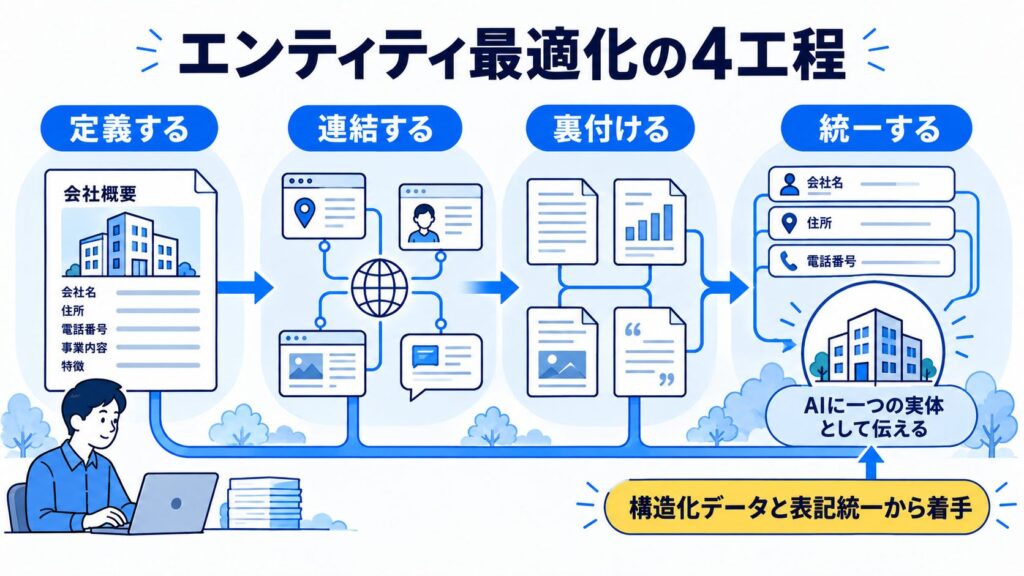
エンティティ最適化は、AIに自社を一つの実体として正しく認識させる土台づくりです。やることは四つ。
Organization構造化データで自社を機械可読に定義し、sameAsで外部の権威プロフィールに連結し、第三者言及やWikidata掲載で裏付けを増やし、NAPと表記を全媒体で統一する。
地味ですが、AIが自社を正しく認識していなければ引用の土俵にすら乗れません。即効性はないと割り切り、自分でできる構造化データと表記統一から着手しましょう。
- 構造化データで定義・sameAsで連結
- 第三者言及とWikidataで裏付け
- NAP・表記を全媒体で統一
参考URL一覧
- Google検索セントラル・Organization(Organization)構造化データ:https://developers.google.com/search/docs/appearance/structured-data/organization
- Wikipedia:特筆性(組織):https://ja.wikipedia.org/wiki/Wikipedia:特筆性_(組織)
- PR TIMES・AKARUMI INSIGHTS(AIはBtoB企業をどの情報から選ぶか・300プロンプト調査):https://prtimes.jp/main/html/rd/p/000000029.000145103.html
- SEM Plus・LLMOとは(対策方法・エンティティ):https://white-link.com/sem-plus/llmo/
- LLMO研究所・ナレッジグラフを強固にする4つのJSON-LD実装戦略:https://note.com/lab_llmo/n/n1cdabc2452e7
- フランクマーケティング・Wikidataとは(SEO・LLMOへの影響):https://note.com/frank_marketing/n/n87c1aa4cb483
- トロブズ・エンティティ・リンキングとLLMO:https://trobz.co.jp/knowledge/entiti/
- AtoZ Design・エンティティ最適化とは:https://atoz-design.jp/column/entity-llmo/
- スリードット・サイテーションがLLMOの有効打に:https://three-dots.co.jp/llmo-citation/