Schema.org完全活用ガイド(AI検索観点)とは、Article・Organization・Person・BreadcrumbList等のスキーマをJSON-LDで実装し、AIや検索エンジンにコンテンツの意味・著者・組織を正確に伝えて、信頼される情報源として扱われやすくする方法のことです。
結論として、AI検索観点でまず実装すべきはOrganization・Article・Person・BreadcrumbListの4つです。
記事・著者・運営者・階層をAIに機械可読で伝え、E-E-A-Tの土台にします。
ただしGoogle公式は「生成AI検索に構造化データは必須ではなく、特別なschemaも不要」と明言しており、構造化データは引用を保証しません。
可視コンテンツとの完全一致とガイドライン遵守を守りつつ、Googleがリッチリザルト対象とする型に絞って実装するのが、過不足のない現実解です。
この記事の結論
まずは組織・記事・著者・階層の4型を、表示内容と一致させて入れるのが現実解と考えています
今日からやること
- ページソースで自動出力のJSON-LDを確認する
- 不足するPerson型とsameAsを足す
- マークアップと表示内容のずれをなくす
こんな人向け:AI検索を意識して構造化データを整えたいが、どの型から入れるか迷っている方
AI検索でまず実装すべき4つのスキーマ
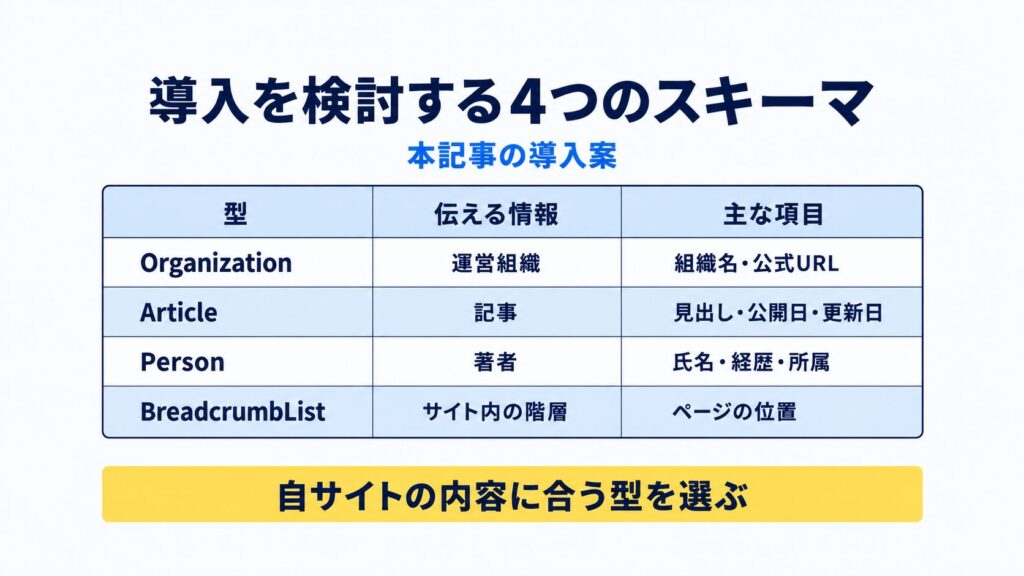
AI検索観点で最初に実装すべきは、Organization(運営組織)・Article(記事)・Person(著者)・BreadcrumbList(パンくず)の4つです。
これらは「誰が・どの組織が・何について書いたか」と「サイト内の位置」をAIに機械可読で伝える基盤になります。
Schema.orgには数百の型がありますが、全部を入れる必要はありません。Googleがリッチリザルト対象とし、かつエンティティ理解に効く型に絞るのが効率的です。
構造化データがAI検索最適化全体のどこに位置づくかは、AI検索最適化とAIO・LLMO・GEO・AEOの違いで整理しています。
Organization:運営者の実体をAIに伝える
Organization型は「誰が運営しているサイトか」をAIに伝える、最も優先度の高い構造化データです。
組織名・ロゴ・公式サイトURL・公式SNSやプロフィールへのリンク(sameAs)を記述します。
Organization型はGoogleがリッチリザルト対象とする型の一つで、ナレッジパネルの素材にもなります。
Google検索セントラルの構造化データギャラリーで、対応する型の一覧が公開されています。
後述のsameAsを併用すると、AIが運営者の実体をナレッジグラフ上で特定しやすくなります。
 DAMEMOTO代表鈴木
「誰のサイトか」が曖昧だと、AIは引用しづらいんです
Article:記事の著者・更新日を機械可読に
Article型(またはBlogPosting型)は記事ページに実装し、見出し(headline)・公開日(datePublished)・更新日(dateModified)・著者(author)・画像(image)・発行者(publisher)を記述します。
これにより、AIは「いつの・誰の・何についての記事か」を推測ではなく確実に把握できます。
authorプロパティでPerson型を、publisherプロパティでOrganization型を参照すると、記事・著者・組織が連携した構造になります。
Article型もGoogleのリッチリザルト対象です。
Person・BreadcrumbList:著者と階層を示す
Person型は著者プロフィールに実装し、氏名(name)・職業(jobTitle)・経歴(description)・所属(worksFor)・外部プロフィールへのリンク(sameAs)を記述します。
BreadcrumbList型はパンくずリストをマークアップし、サイト内の階層構造をAIに伝えます。
BreadcrumbListもGoogleのリッチリザルト対象で、検索結果のパンくず表示に使われます。
Person型はE-E-A-Tの「専門性・権威性」を機械可読で補強する役割を担います。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
JSON-LD実装の具体コードとsameAs接続
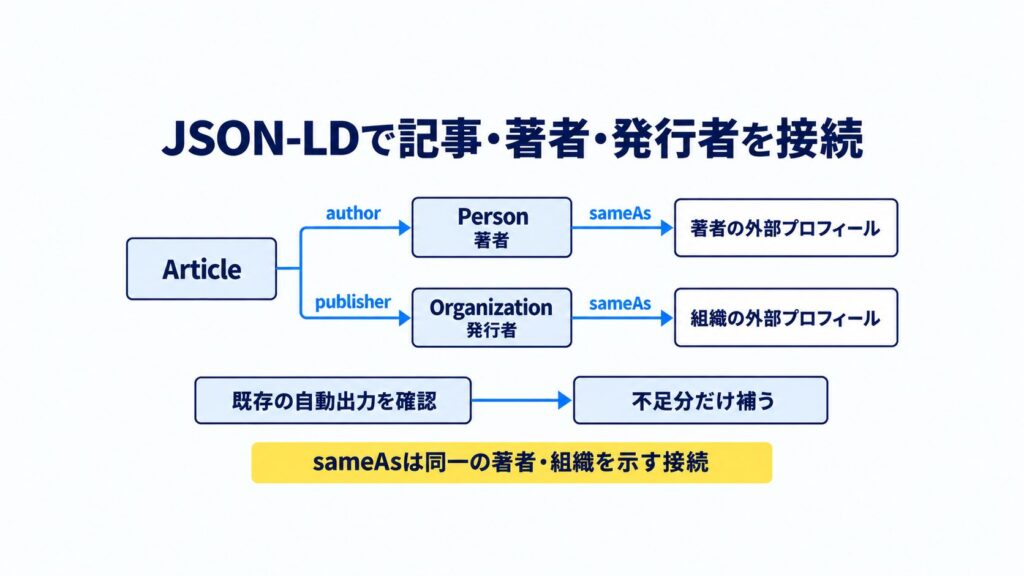
ここでは、Article・Organization・Person・sameAsをまとめて記述したコピペ可能なJSON-LDを示します。
記述形式はJSON-LDが推奨で、Google検索セントラルの構造化データ概要でも「サイトの設定が許す限りJSON-LDの使用を推奨」と明記されています。
MicrodataやRDFaも理解はされますが、本文と分離して書けるJSON-LDが保守しやすく第一選択です。
Article+著者+発行者の完成形コード(コピペ可)
記事ページ向けの実用的な雛形です。これが1つ目の「置き土産」になります。
authorでPerson、publisherでOrganizationを参照し、記事・著者・組織を1つのJSON-LDで連携させています。
各値(URLや氏名)を自サイトのものに書き換えれば使えます。datePublishedとdateModifiedはISO 8601形式(YYYY-MM-DD)で記述します。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Schema.org完全活用ガイド(AI検索観点)",
  "datePublished": "2026-06-10",
  "dateModified": "2026-06-19",
  "author": {
    "@type": "Person",
    "name": "著者名",
    "jobTitle": "SEOエディター",
    "sameAs": [
      "https://x.com/your-account",
      "https://www.linkedin.com/in/your-profile"
    ]
  },
  "publisher": {
    "@type": "Organization",
    "name": "運営会社名",
    "logo": {
      "@type": "ImageObject",
      "url": "https://example.com/logo.png"
    }
  }
}
</script>
authorとpublisherの入れ子、ここが構造の肝です
sameAsでエンティティを名寄せする
sameAsは、自サイトの著者や組織を、外部の権威あるプロフィール(Wikipedia・Wikidata・LinkedIn・公式SNS等)と結びつけるプロパティです。
これにより、AIや検索エンジンが「この著者・組織は、ナレッジグラフ上のこのエンティティと同一だ」と特定(名寄せ)しやすくなります。
複数のSEO解説では、Organization/Person schemaにsameAsで権威ある外部識別子を結びつけると、ナレッジグラフでのエンティティ認識が改善し、AI回答での引用が増えやすいと整理されています(Stackmatixのエンティティ解説)。
ただし効果の程度は型やサイトにより異なり、定量的な保証はありません。sameAsを含む名寄せの進め方は、エンティティ最適化の実装チェックリストもあわせて確認しておきたいところです。
DAMEMOTO代表鈴木「他人の同名」と混同されない、これが名寄せの価値です
WordPress・SWELLでの実装と確認
WordPressでは、SWELLなどのテーマがArticle・BreadcrumbList・Organization等のJSON-LDを自動出力することが多いです。
まずはページソースのapplication/ld+jsonを確認し、何が自動出力されているかを把握します。
そのうえで、不足する型(Person・追加のsameAs等)をプラグインやカスタムHTMLで補うのが効率的です。
手動で全部書くより、自動出力を土台に差分を足す方が、二重出力の事故も防げます。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
2026年に「使える型/廃止された型」の最新整理
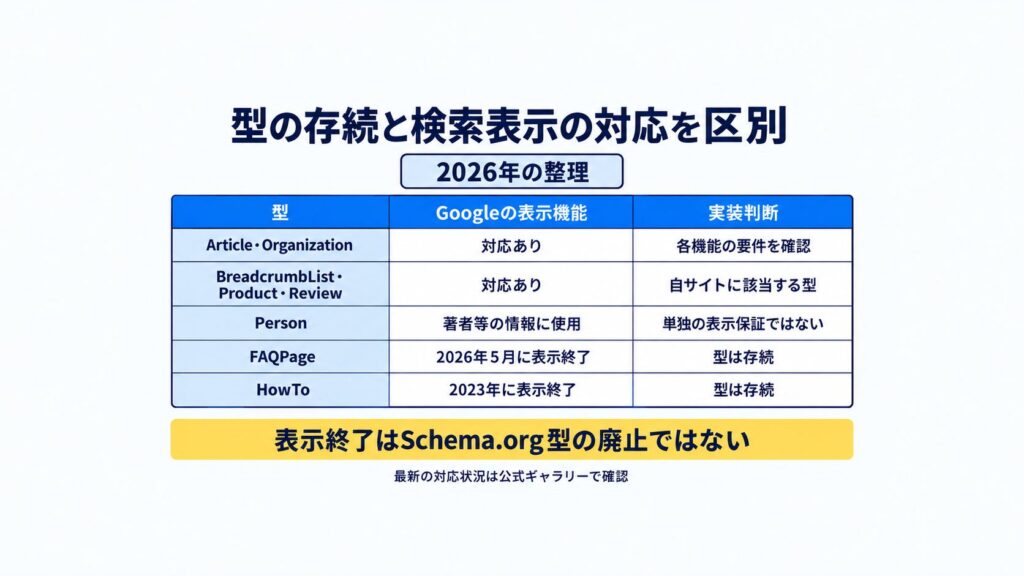
Schema.orgの型は数百ありますが、Googleがリッチリザルト対象とする型は限定的で、しかも年々変動しています。
2026年時点では、Article・BreadcrumbList・Product・Review/AggregateRating・Recipe・Video・Organization・LocalBusiness・Event等が引き続き対象です。
一方、FAQリッチリザルトは2026年5月に視覚表示が廃止され、HowToは2023年に廃止済みです。「対応している前提」で古い型を実装しないよう、最新の対応状況を押さえます。
Googleが今もリッチリザルト対象とする主な型
2026年も有効な主要型は、Product・Review/AggregateRating・Article・Recipe・Video・Organization・LocalBusiness・BreadcrumbList・Eventなどです。
これらはGoogleの構造化データギャラリーに掲載され、検索結果でのリッチな表示やナレッジグラフへの取り込みに使われます。
AI検索観点では、リッチリザルト表示の有無に関わらず、Organization・Article・Personが「運営者・記事・著者」の伝達に効く中核です。
最新の一覧は必ずGoogle検索セントラルの構造化データギャラリーで確認してください。
廃止・縮小された型(FAQ・HowTo・7型)
近年、Googleはリッチリザルト対象を絞り込んでいます。HowToリッチリザルトは2023年(モバイル8月・デスクトップ9月)に廃止され、関連ドキュメントも削除されました。
FAQリッチリザルトは2026年5月7日に視覚表示が廃止。
さらに2025年6月には、Book Actions・Course Info・Claim Review・Estimated Salary・Learning Video・Special Announcement・Vehicle Listingの7型が廃止されたと、Search Engine Journal等が報じています。
これらの型はschema.org上には存在しますが、Googleのリッチリザルトとしては表示されません。
FAQPageの書き方と廃止後の扱いは、FAQPage構造化データ実装ガイドでまとめています。
HowToはもうリッチ表示されません、古い記事に注意です
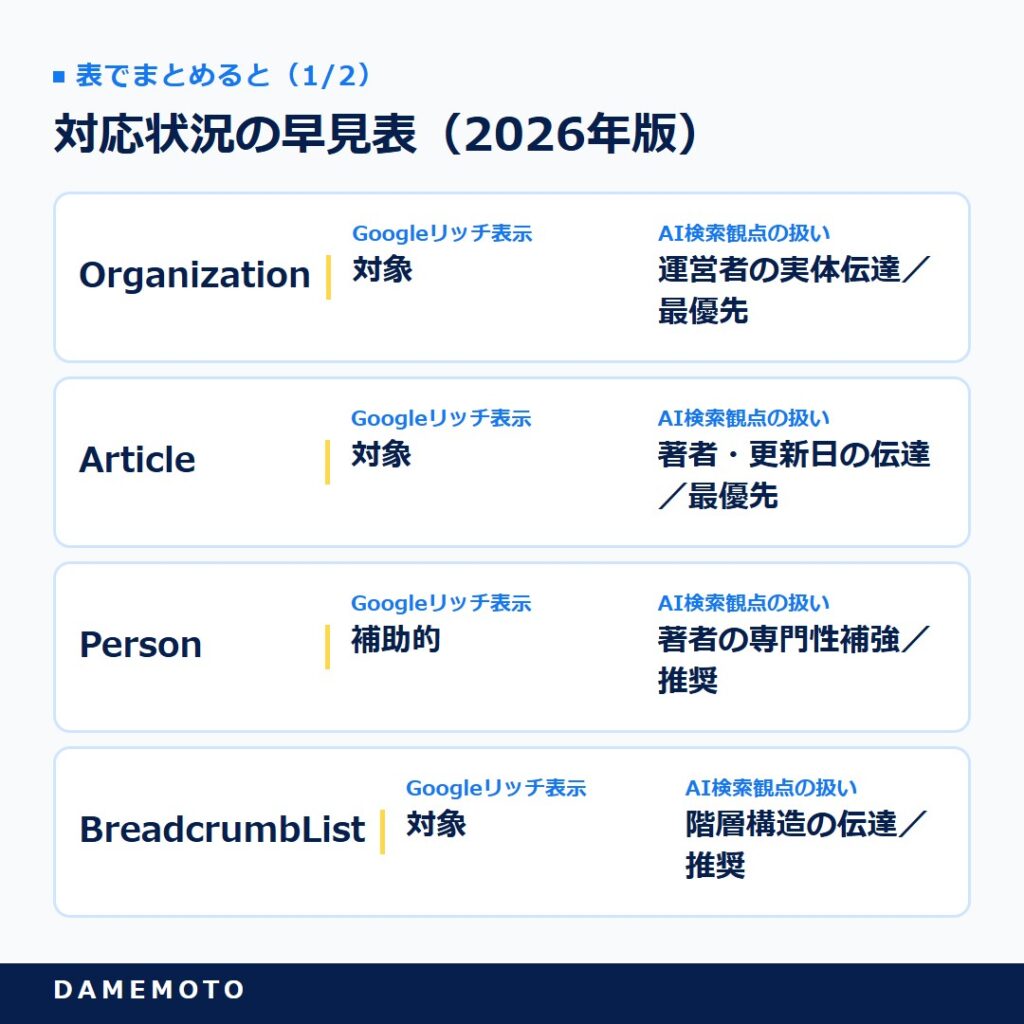
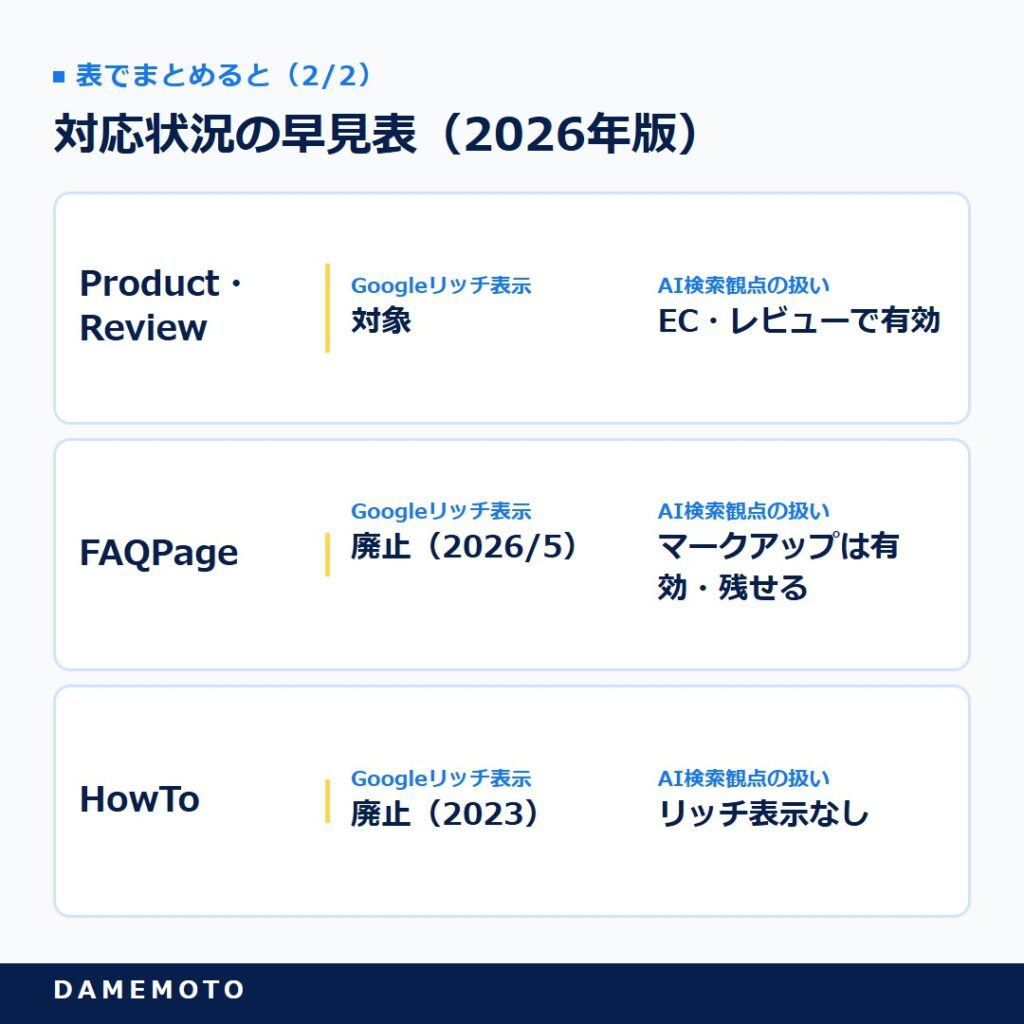
対応状況の早見表(2026年版)
主要な型の現状を早見表にまとめました。これが2つ目の「置き土産」です。「リッチ表示」と「マークアップの有効性」は別物である点に注意してください。
表示が廃止された型でも、schema.org型としては有効で、AIや他エンジンの理解に使われうるものがあります。実装判断の出発点として活用してください。
表で詳しく見る
| 型 | Googleリッチ表示 | AI検索観点の扱い |
|---|---|---|
| Organization | 対象 | 運営者の実体伝達/最優先 |
| Article | 対象 | 著者・更新日の伝達/最優先 |
| Person | 補助的 | 著者の専門性補強/推奨 |
| BreadcrumbList | 対象 | 階層構造の伝達/推奨 |
| Product・Review | 対象 | EC・レビューで有効 |
| FAQPage | 廃止(2026/5) | マークアップは有効・残せる |
| HowTo | 廃止(2023) | リッチ表示なし |
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
ガイドライン遵守と「効く3つから入れる」運用
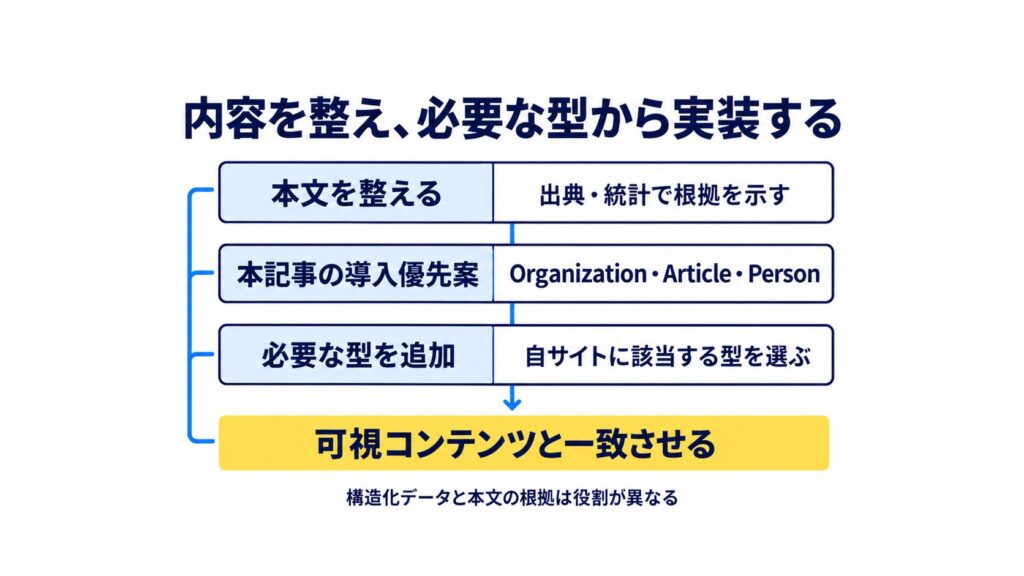
Schema.org活用の大原則は、可視コンテンツとの完全一致とガイドライン遵守です。
表示にない情報・誇張・非表示コンテンツをマークアップするのは違反で、リッチリザルト対象外や手動による対策の対象になり得ます。
そのうえで、Google公式が「生成AI検索に構造化データは必須でない」とする以上、全種類を盛るより「効く3つ」から入れるのが費用対効果の高い運用です。
可視コンテンツと一致させる(最重要)
すべての構造化データに共通する大原則は、ページに表示されている内容と一致させることです。
Googleの構造化データの一般ガイドラインは「ユーザーに見えないコンテンツをマークアップしない」と明記し、ログインなしで全ユーザーが見られる内容に限ると定めています。
会員限定の価格や非表示の情報をschemaに書くのは違反です。違反すると、リッチリザルト対象外や手動による対策(ペナルティ)の対象になり得ます。
マークアップした情報は、必ず実際のページに表示し、内容を一致させてください。スパムポリシー全般はGoogle検索セントラルのスパムに関するポリシーを参照します。
出典・統計を添えるとAIに拾われやすい
構造化データそのものとは別に、本文に出典や統計を添える工夫もAI引用に効くと示されています。
GEO(生成エンジン最適化)の学術研究(Princeton大学やIIT Delhiなどの研究者によるAggarwal et al.、KDD 2024採択)は、計1万クエリのベンチマークを構築し、主な手法比較は1,000件のテスト集合で行い、出典・統計・引用文の追加が生成エンジンでの引用可視性を最大約40%高めたと報告しています(位置調整済みワードカウント指標で引用文の追加が約41%、統計の追加が約31%。arXiv論文)。
構造化データで「誰が・何を」を伝え、本文で出典・統計の裏付けを示す。この両輪が、AIに信頼される情報の作り方です。
本文に出典を添える具体的な方法は、出典明記でAI引用率が上がる書き方を読むと判断しやすくなるはずです。
schemaは「誰が」、本文は「何を根拠に」。役割が違います
「効く3つ」から始める優先順位
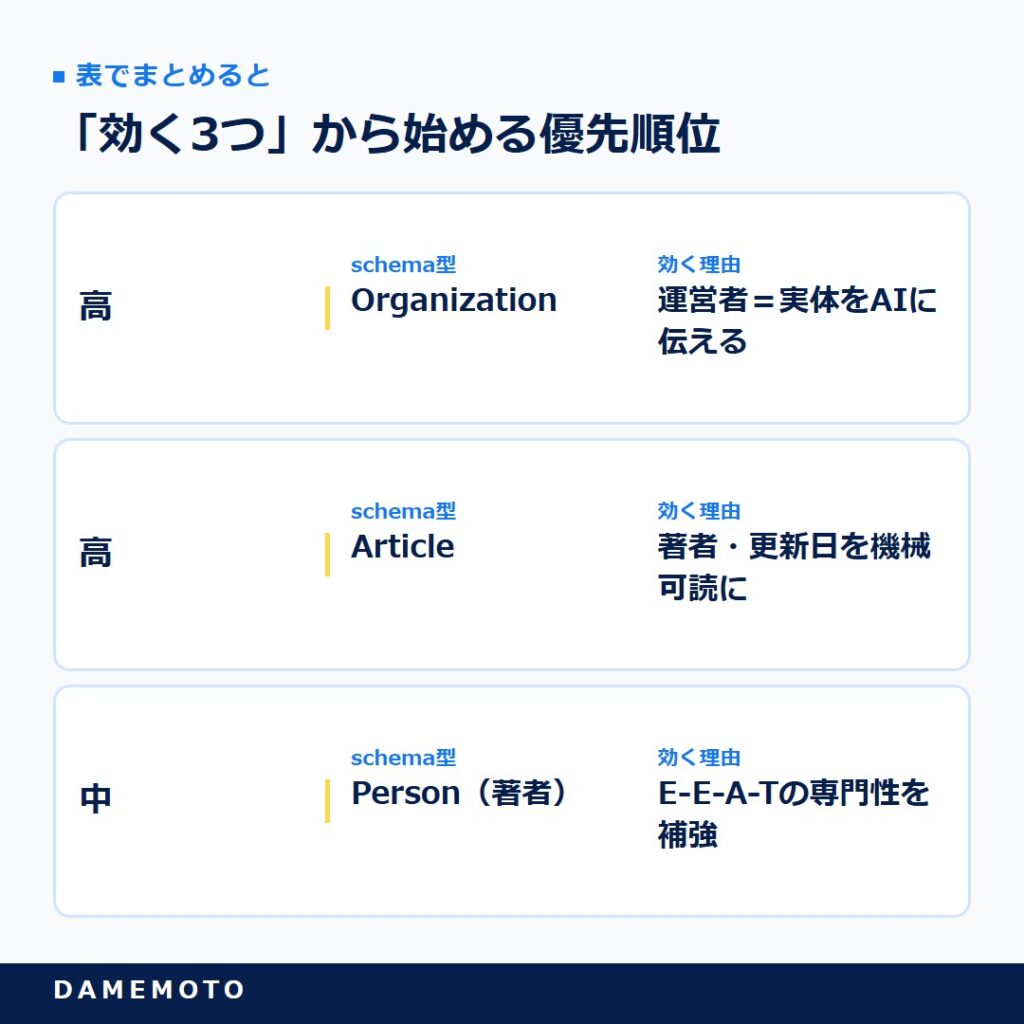
限られた工数を活かすなら、優先順位を決めて入れます。下表は、AI検索・SEOの観点で優先すべき構造化データを独自に整理したものです。
まずOrganization・Article・Personで「運営者・記事・著者」をAIに正確に伝える土台を作り、リッチリザルト対象の型(Product・Review・Breadcrumb等)は自サイトに該当するものを余力で足す。
「全部入れる」のではなく「効く3つから」が、費用対効果を高めます。
表で詳しく見る
| 優先 | schema型 | 効く理由 |
|---|---|---|
| 高 | Organization | 運営者=実体をAIに伝える |
| 高 | Article | 著者・更新日を機械可読に |
| 中 | Person(著者) | E-E-A-Tの専門性を補強 |
正直コーナー:構造化データを「盛りすぎ」てはいけない理由
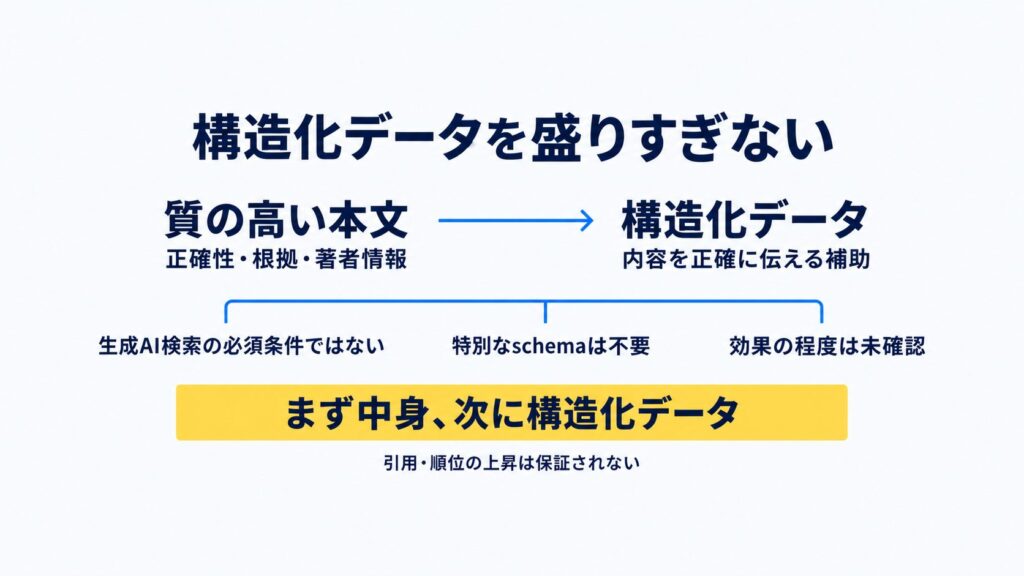
構造化データは「やればやるほど良い」ものではありません。むしろ盛りすぎは逆効果になり得ます。ここでは正直に、構造化データの限界と、本記事だけでは分からないことを明示します。
スキーマは「中身を正確に伝える道具」であって「中身を良く見せる魔法」ではないという前提が出発点です。
構造化データは引用も順位も保証しない
構造化データを実装すれば必ずAIに引用される、順位が上がる、というのは誤解です。
引用や評価の決め手はコンテンツの質・正確性・E-E-A-Tであり、構造化データはそれを正確に伝える補助にすぎません。
実体のないコンテンツにschemaだけ盛っても、AIや検索エンジンは見抜きます。
Googleの生成AI検索向け最適化ガイド(2026年5月15日公開)も「生成AI検索に構造化データは必須ではなく、特別なschemaも不要。ただしSEO全体の一部として使い続けるのは良い考え」と述べています。採用ページで求人情報を構造化する場合は、JobPosting構造化データの実装ポイントで注意点を整理しています。
DAMEMOTO代表鈴木まず中身、次に構造化データ。順序を逆にしないことです
本記事だけでは分からないこと
正直に書くと、「どの型をどれだけ実装すれば、AI検索でどれだけ引用が増えるか」は定量的に断定できません。
Google AI OverviewsやAIモードが各schema型をどう重み付けしているかは公式に開示されておらず、「未確認」です。
sameAsやOrganization schemaがエンティティ認識を助けるという整理は業界の観測・解説に基づくもので、効果の程度は型・分野・サイトによって異なります。
本記事は「正しい実装と、可視一致というガイドライン遵守」を保証するもので、特定の引用率・順位上昇を保証するものではありません。
確実な部分(実装方法・遵守事項)と、不確実な部分(効果の程度)を分けて受け取ってください。
よくある質問
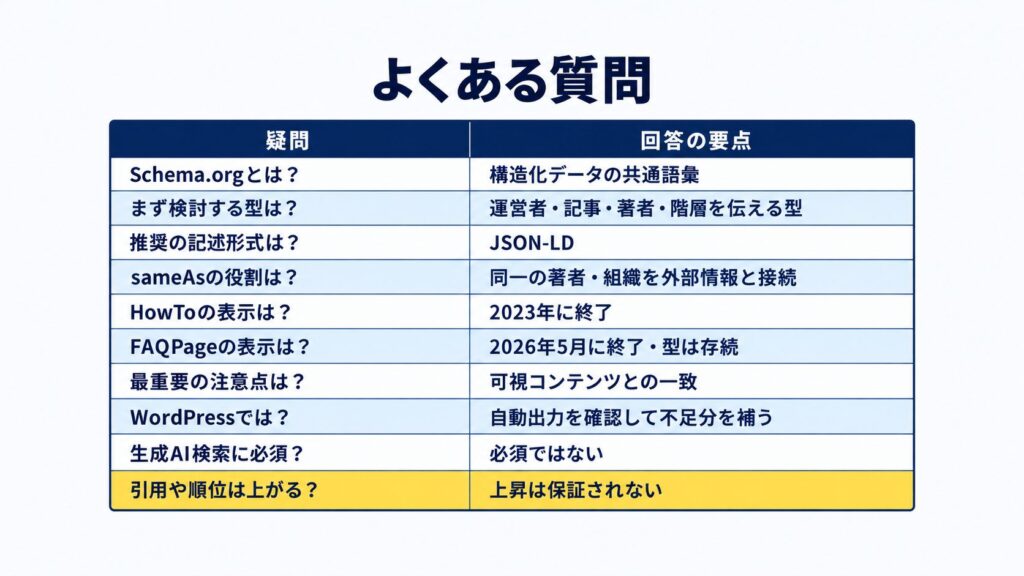
- Schema.orgとは何ですか?
-
Google・Microsoft等が共同策定した構造化データの共通語彙です。コンテンツの意味・著者・組織をAIや検索エンジンに機械可読で伝えます。
- AI検索でまず実装すべきSchema.orgの型は?
-
Organization・Article・Person・BreadcrumbListの4つです。運営者・記事・著者・階層を伝える基盤になります。リッチリザルト対象の型(Product・Review等)は自サイトに該当するものを余力で足します。
- 構造化データの記述形式は何が推奨ですか?
-
JSON-LDです。本文と分離してscriptタグ内に記述でき、Googleも「サイトの設定が許す限りJSON-LDを推奨」としています。MicrodataやRDFaも理解はされます。
- Schema.orgのsameAsは何のために使いますか?
-
著者や組織を、Wikipedia・Wikidata・LinkedIn・公式SNS等の外部プロフィールと結びつけ、AIや検索エンジンがエンティティを特定(名寄せ)しやすくするためです。ナレッジグラフでの認識改善に役立つと整理されています。
- HowToスキーマはまだ使えますか?
-
HowToリッチリザルトは2023年に廃止され、Googleの検索結果でリッチ表示されません。schema.org上には存在しますが、リッチリザルト目的での実装価値はなくなっています。
- FAQPageスキーマは実装すべきですか?
-
視覚表示は2026年5月7日に廃止されましたが、マークアップ自体は有効なschema.org型として残せます。装飾目的なら不要、AIや他エンジンの理解を助ける目的なら残す価値があります。詳細は専用ガイドを参照してください。
- 構造化データで最も重要な注意点は何ですか?
-
可視コンテンツとの完全一致です。表示にない情報・誇張・非表示コンテンツをマークアップするとガイドライン違反となり、リッチリザルト対象外や手動による対策の対象になり得ます。
- WordPressでのSchema.orgの実装は?
-
SWELL等のテーマがArticle・Organization・BreadcrumbList等を自動出力します。まずページソースのapplication/ld+jsonで出力内容を確認し、不足分(Person・追加sameAs等)をプラグインやカスタムHTMLで補います。
- 構造化データは生成AI検索に必須ですか?
-
必須ではありません。Google公式は「生成AI検索に構造化データは不要、特別なschemaも不要。ただしSEO全体の一部として使い続けるのは良い考え」としています。
- 構造化データを実装すれば引用や順位は上がりますか?
-
保証されません。引用・評価の決め手は中身の質・正確性・E-E-A-Tです。構造化データは良い中身を正確に伝える補助であり、効果の程度は型や分野により異なります。
まとめ:Schema.orgは「効く型×可視一致×中身が前提」
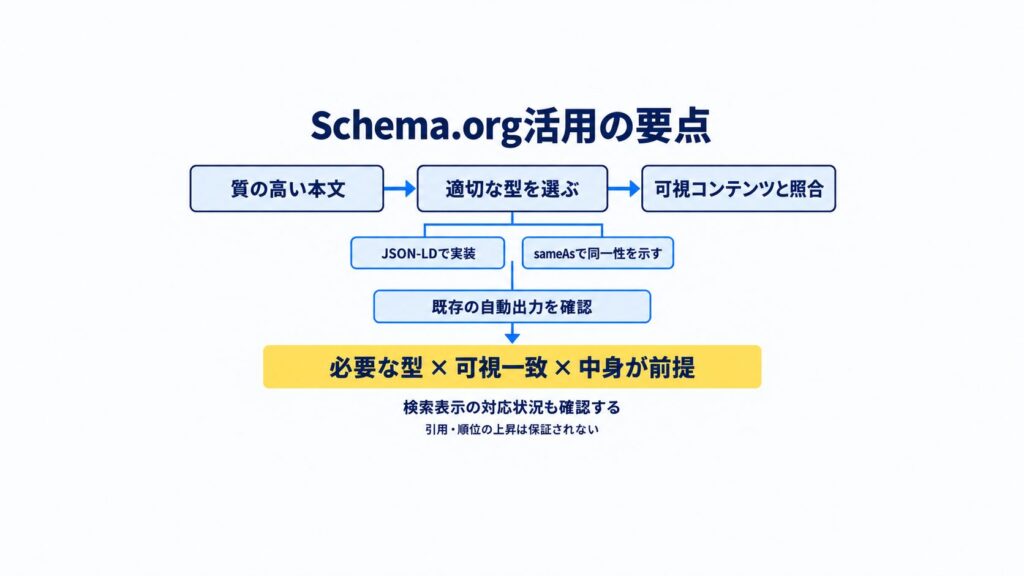
Schema.org構造化データは、AIにコンテンツの意味・著者・組織を伝える翻訳辞書です。
AI検索観点では、まずOrganization・Article・Person・BreadcrumbListを実装し、sameAsで外部プロフィールと名寄せして、E-E-A-Tの土台を機械可読で示します。
JSON-LDで記述し、SWELL等の自動出力を土台に不足分を足すのが効率的。
HowTo(2023年廃止)・FAQ(2026年5月視覚表示廃止)など対応状況は変動するため、最新のギャラリーで確認します。
可視コンテンツとの完全一致は絶対条件で、違反は手動による対策の対象。Google公式は構造化データを生成AI検索の必須要件とはしておらず、引用・順位の上昇は保証されません。質の高い中身を前提に、効く型から入れてください。
- 効く型(運営者・記事・著者)から実装
- 可視コンテンツと完全一致させる
- 質の高い中身が大前提
参考URL一覧
- Schema.org(構造化データ語彙の公式サイト):https://schema.org/
- Google検索セントラル・構造化データの仕組み(JSON-LD推奨・対応タイプ):https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data?hl=ja
- Google検索セントラル・構造化データギャラリー(対応する型の一覧):https://developers.google.com/search/docs/appearance/structured-data/search-gallery?hl=ja
- Google検索セントラル・構造化データの一般ガイドライン(可視一致・違反):https://developers.google.com/search/docs/appearance/structured-data/sd-policies?hl=ja
- Google・生成AI検索向け最適化ガイド(構造化データは必須でない):https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=ja
- Search Engine Journal・GoogleがFAQリッチリザルトを検索から削除(型廃止の動向):https://www.searchenginejournal.com/google-drops-faq-rich-results-from-search/574429/
- arXiv・GEO: Generative Engine Optimization(Aggarwal et al.・統計追加で引用可視性向上):https://arxiv.org/abs/2311.09735
補足参考資料