構造化データは、ページの内容を機械(Google・AI)に伝えるマークアップです。
JSON-LD形式が推奨で、Article・FAQPage・BreadcrumbListなどをschema.orgに従って記述。リッチリザルトの表示候補になるために役立ちます。実装後はリッチリザルトテストで必ず検証します。
構造化データは、ページの意味を機械に伝えるマークアップです。
Googleが対応する検索機能の表示候補になるために役立ちますが、実装だけで順位・クリック率・AI引用が向上するとは限りません。
本記事ではJSON-LDの基礎、タイプの選び方、実装と検証の方法を整理します。
この記事の結論
構造化データは順位の魔法ではなく、正確さと検証で効く土台だと考えています
今日からやること
- BreadcrumbListとArticleから実装を始める
- マークアップとページの表示内容を突き合わせる
- 公開前にリッチリザルトテストで検証する
こんな人向け:構造化データを正しく入れたいけれど、どこから手を付けるか迷っている方数値の出典:Google検索セントラル「FAQ(FAQPage)の構造化データ」
構造化データとJSON-LDの基礎
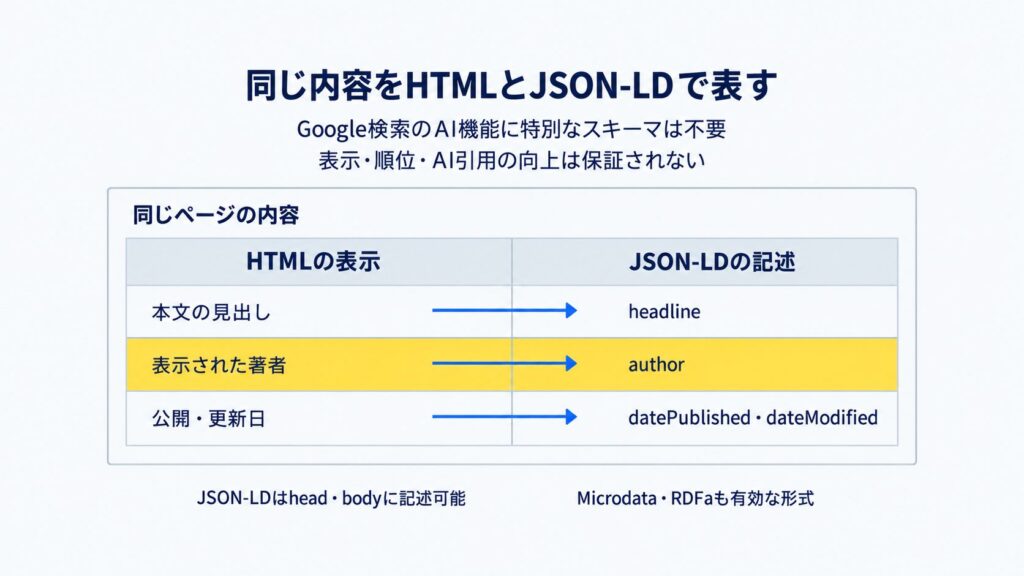
構造化データを理解する出発点は、それが「機械のための情報」だということです。構造化データとは何か、なぜJSON-LDが推奨されるのか、そしてどんな効果があるのかを押さえましょう。難しく聞こえますが、本質はシンプルです。
機械が読む情報を伝えるマークアップ
Webページには2種類の情報があります。1つは、人間が読むHTMLコンテンツ(見出し・本文・画像など)。
もう1つは、機械(Google・AI)が読む構造化データです(課題解決プラットフォーム)。
構造化データは、「これはFAQページです」「著者は〇〇です」といった情報を、検索エンジンに明確に伝えます。
「構造化データ」という言葉は難しく聞こえますが、実際にはHTMLファイルに数行のJSONコードを追加するだけです。構造化データは機械にページの意味を伝える共通言語です。
人間は見出しや文脈からページの内容を理解できますが、機械はそうはいきません。
「このテキストは質問で、これは回答」「これは著者名で、これは公開日」と明示的にラベル付けすることで、検索エンジンがページの内容を正確に理解できるようになります。これが、構造化データの基本的な役割です。
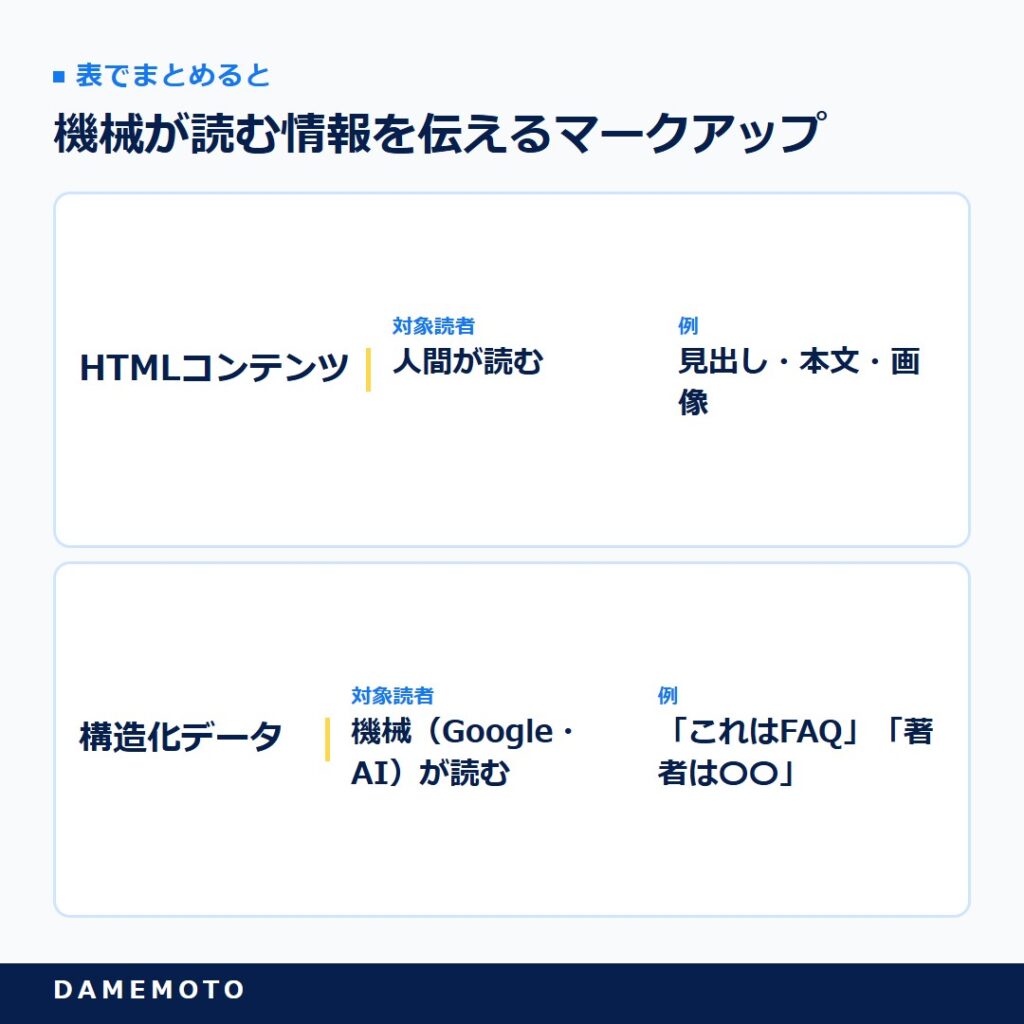
表で詳しく見る
| 情報の種類 | 対象読者 | 例 |
|---|---|---|
| HTMLコンテンツ | 人間が読む | 見出し・本文・画像 |
| 構造化データ | 機械(Google・AI)が読む | 「これはFAQ」「著者は〇〇」 |

人が読めば自明な情報も、機械には「ラベル」がないと伝わりません
JSON-LDがGoogle推奨形式
構造化データの記述形式には、いくつか種類がありますが、新規実装ではJSON-LD一択です。
JSON-LD(JavaScript Object Notation for Linked Data)は、Googleが公式に推奨している形式です(柏崎剛)。
「<script type=”application/ld+json”>」というタグの中に、schema.orgの語彙に従ってJSONを記述します。
新規ならJSON-LD、Googleが公式推奨しているのです。JSON-LDの利点は、HTMLの本文に手を入れずに構造化データを追加できることです。
MicrodataやRDFaといった他の形式は、HTMLタグの中に属性として埋め込むため、保守性が低くなります。
JSON-LDなら、コンテンツとは独立したブロックとして記述でき、保守もデバッグもしやすくなります。
なお、すでにMicrodataで動いているサイトを、わざわざ全部JSON-LDに書き換える必要はありません。新しく実装するなら、JSON-LDを選ぶのが正解です。
基本構文には、@context(”https://schema.org”)と@type(Articleなど)が必須です。
リッチリザルトとAI引用の効果
構造化データはページの意味を伝え、Googleが対応するリッチリザルトの候補となるために役立ちます。ただし検索機能の表示やクリック率の改善は保証されません。
Google検索のAI機能に特別なスキーマは不要であり、マークアップを加えるだけでE-E-A-Tや引用率が上がると断定しないでください。
JSON-LDの大きさは内容によって変わります。可視内容との一致、必要プロパティ、JSON構文と配信状態を確認します。
構造化データの相談でよく聞かれるのが、「実装すれば順位が上がりますか」という質問です。答えは「直接は上がらない」。
でも、リッチリザルトで検索結果が目立てばクリック率が上がることもありますし、AIにページの意味を伝える助けにもなる。つまり、順位を直接動かす施策でなく、見え方と機械理解を底上げする施策です。
この性質を理解しておくと、過度な期待も過小評価もせず、適切に取り組めると感じています。AI検索で優先したいスキーマはAI検索で実装すべき優先4スキーマで整理しています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
主要なタイプと書き方
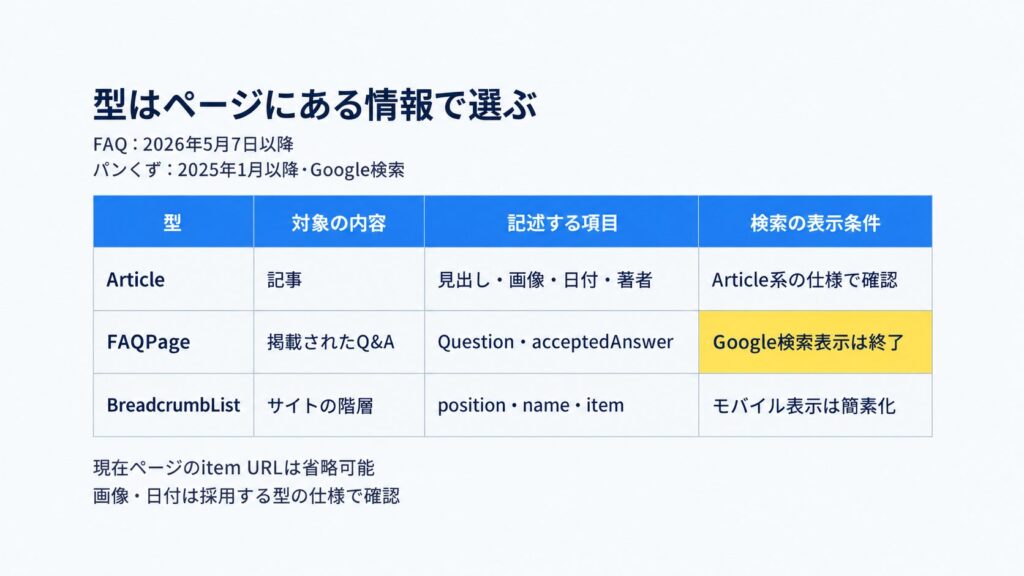
構造化データには多くのタイプがあり、ページの種類に応じて使い分けます。とくに重要なArticle、FAQPage、BreadcrumbListの3つを中心に、書き方と注意点を解説します。まずはこの3つを押さえることが、実装の第一歩です。
Article:記事の基本情報を伝える
記事ページの基本となるのが、Articleスキーマです。記事の見出し、公開日、著者などの情報を構造化します。タイプは、ページの性質に応じて使い分けます。
記事にはArticle、ニュースにはNewsArticle、ブログにはBlogPosting、固定ページにはWebPageを使用します(柏崎剛)。
記述のポイントとして、headline(見出し)は簡潔なタイトルにし(Googleは2023年1月にArticleのheadline「110文字以内」の上限を撤廃し、現在は「長いタイトルは一部デバイスで切り捨てられる可能性があるため簡潔に」と案内)、image(画像)には横幅1200px以上の画像URLを指定し、datePublished(公開日)とdateModified(更新日)はISO 8601形式(YYYY-MM-DD)で記述します(Scale Basics)。
headlineは簡潔に、imageは1200px以上、日付はISO 8601が基本です。authorには、PersonまたはOrganizationを指定します。
mainEntityOfPageで、このArticleがそのページのメインコンテンツであることを示します。正しく実装すると、検索結果に著者名や公開日が表示される可能性があります。
FAQPage:Q&Aを構造化する
FAQPageスキーマは、Q&A形式のコンテンツに使います。
mainEntityを配列形式にし、複数のQuestion(質問)とacceptedAnswer(回答)のペアを含めます(Scale Basics)。
ただし、FAQPageには重要な注意点があります。
Googleは2023年8月にFAQリッチリザルトの表示を一部の権威あるサイトに大幅制限したのち、2026年5月7日をもってFAQリッチリザルトの表示を全サイトで終了しました。
リッチリザルトレポートやリッチリザルトテストのFAQ対応も2026年6月で終了すると、Googleがドキュメント上で告知していました(Search Engine Land)。
FAQリッチリザルトの検索表示は2026年5月に廃止されたのです。マークアップを残しても問題は起きませんが、検索結果に視覚的なFAQは表示されません。
それでも、FAQPageスキーマやページ内のFAQコンテンツ自体には価値があります。AI検索エンジンやアシスタントがFAQデータを情報源として活用する可能性があるためです。
AnswerのtextにはHTMLを含めることも可能ですが、エスケープ処理が必要になるため、プレーンテキストで記述するほうがエラーを避けやすくなります。
検索結果での表示は廃止されても、AI検索時代にはコンテンツとして依然有効です。
FAQPageの書き方とエラー対処はFAQPage構造化データの実装ガイドもあわせて確認しておきたいところです。
DAMEMOTO代表鈴木「表示が消えた=もう不要」と早合点しがちな所、ここが分かれ目です
BreadcrumbList:サイト構造を伝える
BreadcrumbListスキーマは、パンくずリスト(サイトの階層構造)を構造化します。
itemListElementプロパティにListItemの配列を設定し、各ListItemにposition(順番を1から連番)、name(表示名)、item(リンク先URL)を指定します(柏崎剛)。
トップページから現在のページまでの階層を順に記述することで、サイト構造が検索エンジンに正確に伝わります。FAQPageと同様に、注意点があります。
Googleは2025年1月にモバイル検索結果のスニペットをドメイン名のみに簡素化し、モバイルではパンくずリストの表示を取りやめました(デスクトップでは引き続き表示)。
BreadcrumbList構造化データはモバイル・デスクトップとも引き続きGoogleに認識されており、サイト構造の理解やSearch Consoleでのレポートに活用されるため、実装する価値は変わりません。
モバイル表示は簡素化されたが、構造化データの価値は残るのです。BreadcrumbListは全ページに実装するのが基本で、まず実装すべき構造化データの一つです。
Articleと並んで、最初に取り組むべきタイプといえます。
Article・FAQPage・BreadcrumbListから始める
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
実装方法と業種別の選び方
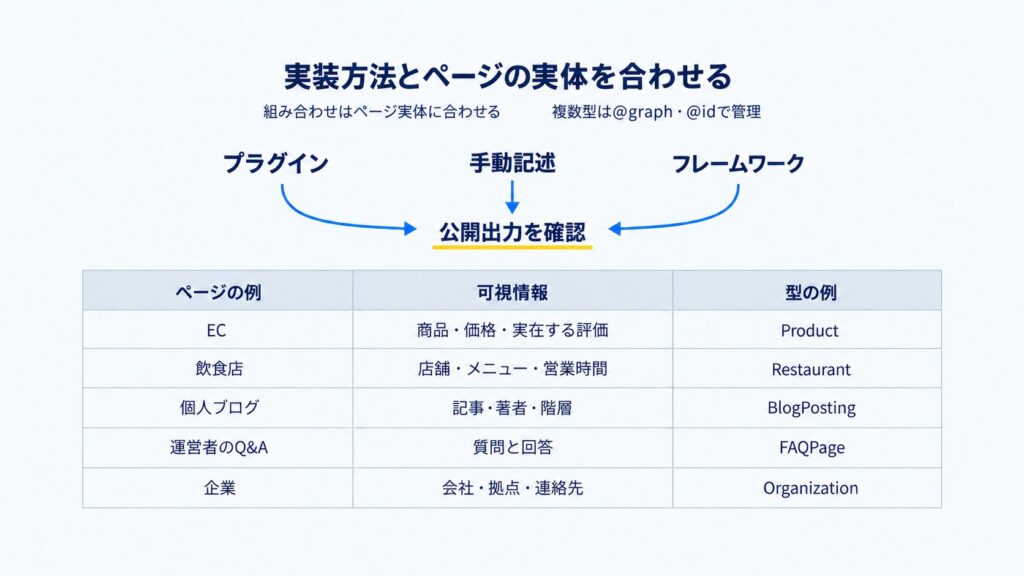
構造化データの実装方法は、WordPressのプラグイン、手動記述、フレームワークの3パターンです。複数タイプの組み合わせ方や、業種別のおすすめも含めて解説します。サイトの環境に応じて、適した方法を選びましょう。
WordPressはプラグインで自動出力
WordPressでは、プラグインによる自動出力が便利です。
Yoast SEOやRank Math SEOを使うと、Organization・WebSite・BreadcrumbListが自動的に出力されます(WEBRIES)。
これらの基本的な構造化データは、プラグインを入れるだけで対応できます。
一方、LocalBusinessやFAQPageなど、より細かい制御が必要な場合は、手動で追加するか、「Schema Pro」や「WP Schema」などの専用プラグインを併用するのが効率的です。
基本はプラグイン自動、細かいものは専用プラグインか手動という使い分けです。手動で記述する場合は、WordPressのカスタムHTMLブロックにJSON-LDを記述します。
カスタムHTMLブロックはbodyタグ内に出力されますが、Googleは正常に認識します。なお、JSON-LDの配置は、head・bodyのどちらでもGoogleが認識します。
全ページ共通のスキーマ(Organization・WebSiteなど)はhead内、ページ固有のスキーマ(FAQ・Eventなど)はbody内のコンテンツ近くに配置するのが一般的です。
プラグインの選び方を含む初期設定はWordPress SEOの初期設定5つで手順をまとめています。
複数タイプは@graphでまとめる
1つのページに複数の構造化データを実装する場合、2つの方法があります。1つは、それぞれを独立したJSON-LDブロックとして実装する方法です。
もう1つは、@graphで1つにまとめる方法です(WEBRIES)。
@graphを使うと、「@context」を1つにして、その中に複数の「@type」(LocalBusiness・BreadcrumbList・FAQPageなど)を配列で含められます。
どちらの方法でもGoogleは正しく認識しますが、管理のしやすさを考えると、@graphで1つにまとめるほうがおすすめです。複数タイプは@graphでまとめると管理しやすいのです。
たとえば記事ページなら、Article・FAQPage・BreadcrumbListを@graphで1つのブロックにまとめます。
なお、ProductにReviewを含めるなど、入れ子にできる場合は、一つのブロック内に統合することも可能です。
複数のタイプを組み合わせることで、一つのページで複数のリッチリザルト表示の可能性が高まります。サイトの構造に合わせて、適切に組み合わせましょう。
@idで相互参照すると、エンティティの重複認識を防げます
業種別のおすすめの組み合わせ
構造化データは、業種や目的に応じて効果的な組み合わせがあります。
ECサイトなら、Product+Offer+AggregateRating+Review+BreadcrumbListで、商品情報・価格・評価・レビュー・階層を伝えます(バクヤスAI)。
飲食店なら、LocalBusiness+Restaurant+Menu+OpeningHoursで、店舗情報・メニュー・営業時間を伝えます。
個人ブログなら、BlogPosting+Person+BreadcrumbListが基本です。Q&Aサイトなら、FAQPage+Question+Answer。
企業サイトなら、Organization+LocalBusiness+ContactPointです。これらの組み合わせは、それぞれの業種特有のニーズに対応しています。
ただし、無関係な構造化データを入れるのは避けます(WEBRIES)。
BreadcrumbListは全ページに、FAQPageはFAQが記載されているページにだけ、LocalBusinessは店舗情報ページに、というように、ページの種類に応じて適切なタイプを選びます。
まずは基本的なタイプから始め、サイトの特徴に合わせて拡張していくのがコツです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
検証とよくある失敗
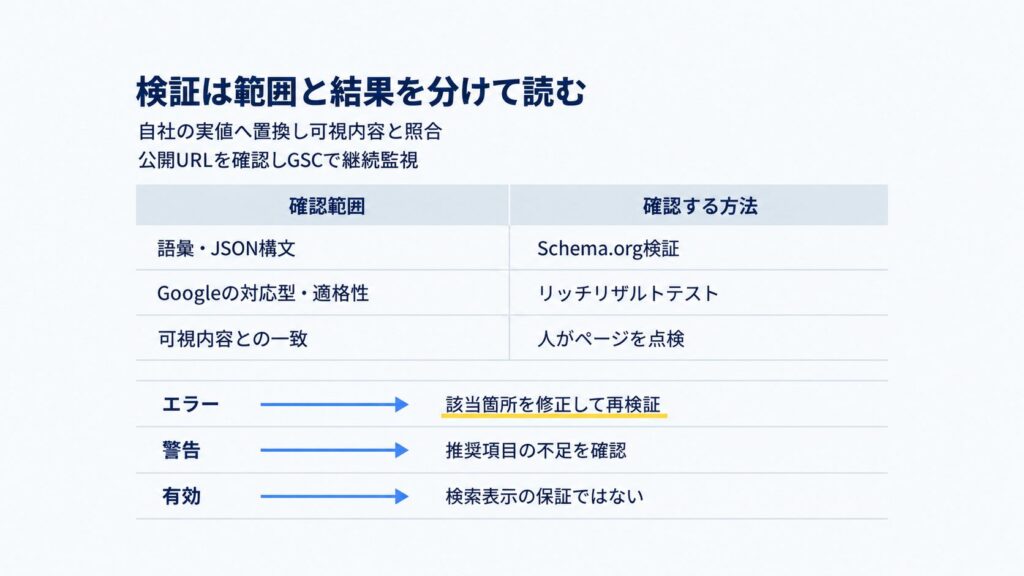
構造化データは、書いただけでは正しく動作しているか分かりません。実装後の検証は必須です。リッチリザルトテストの使い方と、絶対に守るべき3つのルール、よくあるエラーを解説します。検証を怠ると、構造化データは無視されます。
リッチリザルトテストで検証する
実装後は、必ずGoogleのリッチリザルトテストで検証します。
リッチリザルトテスト(search.google.com/test/rich-results)に、URLまたはコードを入力するだけで、構造化データが正しく認識されているか、リッチリザルトとして表示される資格があるか、エラーや警告がないかを確認できます(WEBRIES)。
テスト結果は「有効」「警告あり」「エラー」の3段階で表示されます。エラーがあると構造化データは完全に無視されるため、エラーは必ず修正します。
警告は、推奨プロパティが不足している場合に表示されるもので、可能であれば対応します。
あわせて、実装後はGoogle Search Consoleの拡張(エンハンスメント)レポートで、継続的に監視することが大切です(柏崎剛)。
いつの間にかエラーが出ていた、という事態を防げます。書いて終わりでなく、テストと継続監視まで含めて、構造化データの実装は完了です。検証は省略できない工程です。
必ず守る3つのルール
構造化データの実装には、必ず守るべき3つのルールがあります(crevia)。1つ目、自社の正確な情報に書き換える。
サンプルコードのexample.comや「会社名」「質問文」などは、すべて自社の実際の情報に置き換えます。サンプルのまま使用するとガイドライン違反になります。
2つ目、ページ上に表示されている内容と一致させる。
FAQPageの質問・回答、Productの価格・在庫など、構造化データに記述した内容は、ページ上に実際に表示されている必要があります。
「構造化データだけに情報を入れてページには載せない」はガイドライン違反です。構造化データはページ表示内容と必ず一致させるのが鉄則です。
3つ目、実装後は必ずリッチリザルトテストで確認する。この3つは、構造化データを正しく機能させ、ペナルティを避けるための基本です。
とくに「ページ内容との不一致」は、Googleのガイドライン違反にあたるため、絶対に避けます。実在しない評価やFAQをマークアップするのは厳禁です。
DAMEMOTO代表鈴木サンプルのexample.comを消し忘れる、これが一番多い初歩ミスです
よくあるエラーと対処
構造化データでよくあるエラーを、対処法とあわせて押さえておきましょう。代表的なのは、次のパターンです。
「必須プロパティがありません」(FAQPageにmainEntityがないなど)→必要なプロパティを追加します。
「値の型が正しくありません(日付)」→日付をYYYY-MM-DD形式(ISO 8601)に修正します。「画像のURL形式が無効」→httpsで始まる絶対URLを指定します。
「@contextが見つかりません」→「https://schema.org」の記述漏れを補います(課題解決プラットフォーム)。
これらは、JSON構文エラー、必須プロパティの欠落、ページ内容との不一致という、3つの代表的なエラーパターンに集約されます(Scale Basics)。
これらを事前に理解しておくことで、効率的な実装ができます。
なお、URLは相対パスでなく絶対URLで記述すること、型を仕様に従って正しく指定すること(数値に文字列を入れないなど)も重要です。
構造化データは、一度仕組みを構築すれば運用コストが低く、長期的なリターンが大きい施策です。エラーを潰し、正確に実装すれば、検索とAIの両方で効果を発揮します。
拡張レポートでの監視とあわせて確認してください。
構造化データはAI検索(AIO/LLMO)対策としても価値が高まっています。ただし、マークアップだけでAIに引用されやすくなるとは限りません。
AIO・LLMOなど用語の違いと全体の進め方はAI検索最適化の統合戦略を読むと整理しやすいはずです。
よくある質問
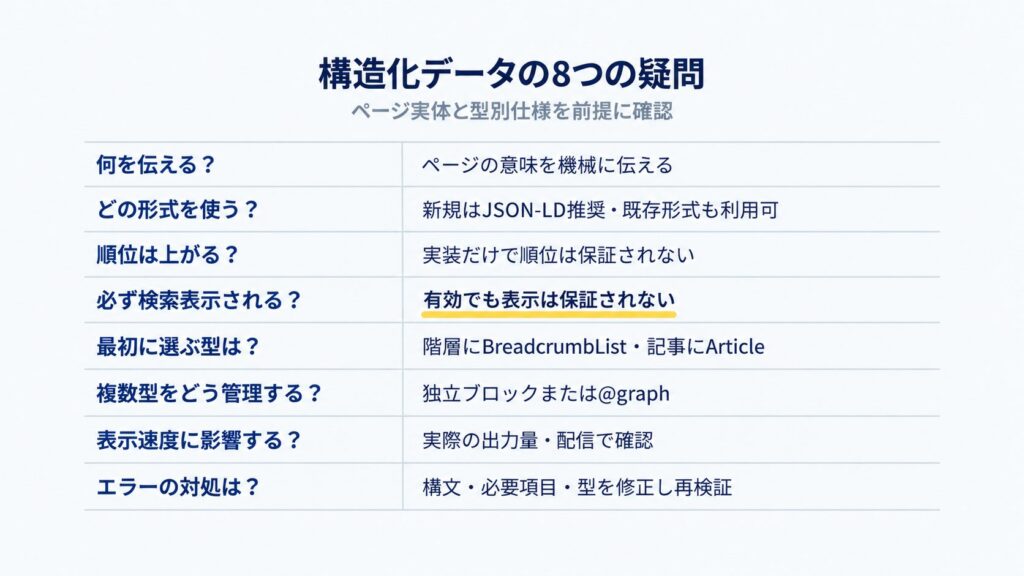
- 構造化データとは何ですか?
-
機械(Google・AI)にページの内容を伝えるマークアップです。「これはFAQページ」「著者は〇〇」といった情報を明示的にラベル付けし、検索エンジンが内容を正確に理解できるようにします。HTMLに数行のJSONコードを追加するだけで実装でき、検索結果のリッチリザルト表示の候補になります。
- 構造化データはJSON-LDとMicrodataのどちらで書くべきですか?
-
新規実装ならJSON-LD一択です。Googleが公式に推奨しており、HTMLの本文に手を入れず独立したブロックとして追加でき、保守性・デバッグ性が高いためです。ただし、すでにMicrodataで動いているサイトを、わざわざ全部JSON-LDに書き換える必要はありません。これから実装するならJSON-LDを選びましょう。
- 構造化データを実装すれば順位は上がりますか?
-
実装しただけで順位が上がるとは限りません。Googleが対応する検索機能に必要なプロパティを満たし、ページ内容を正確に伝えるために使います。リッチリザルトの表示、CTRの向上、AIでの引用は保証されません。
- リッチリザルトは構造化データを入れれば必ず表示されますか?
-
いいえ。構造化データの実装はリッチリザルト表示の前提条件ですが、表示を保証するものではありません。Googleは検索クエリやページの品質、ユーザーの状況などを総合的に判断して表示を決めます。とくにFAQリッチリザルトは2023年8月に表示が制限されたのち、2026年5月7日に検索表示が全廃されました。それでもFAQコンテンツ自体はAIの情報源として価値があります。
- まず実装すべき構造化データは何ですか?
-
BreadcrumbListとArticle(またはOrganization)から始めるのがおすすめです。BreadcrumbListは全ページに、Articleは記事ページに実装します。これらは効果が出やすく、実装も比較的簡単です。その後、サイトの種類に応じてFAQPage、LocalBusiness、Productなどを追加していきます。基本から段階的に拡張しましょう。
- 複数の構造化データはどう実装しますか?
-
独立したJSON-LDブロックとして実装するか、@graphで1つにまとめます。どちらもGoogleは正しく認識しますが、管理のしやすさから@graphでまとめるのがおすすめです。@contextを1つにして、その中にArticle・FAQPage・BreadcrumbListなどを配列で含めます。記事ページではこの3つをまとめるのが定番です。
- 構造化データはページの表示速度に影響しますか?
-
ほぼ影響しません。JSON-LDのコードはファイルサイズが非常に小さく(通常1KB未満)、レンダリングにも関与しないため、表示速度への影響は無視できるレベルです。Core Web Vitalsを気にして構造化データの実装をためらう必要はありません。むしろ、適切に実装することで、検索とAIの両方での価値が高まります。
- 構造化データのよくあるエラーと対処法は?
-
「必須プロパティがありません」はプロパティの追加、「値の型が正しくありません(日付)」はYYYY-MM-DD形式への修正、「画像URL形式が無効」はhttpsの絶対URL指定、「@contextが見つかりません」は記述漏れの補完で対処します。エラーがあると構造化データは完全に無視されるため、リッチリザルトテストで必ず確認・修正しましょう。
構造化データ実装 5ステップ設計フロー
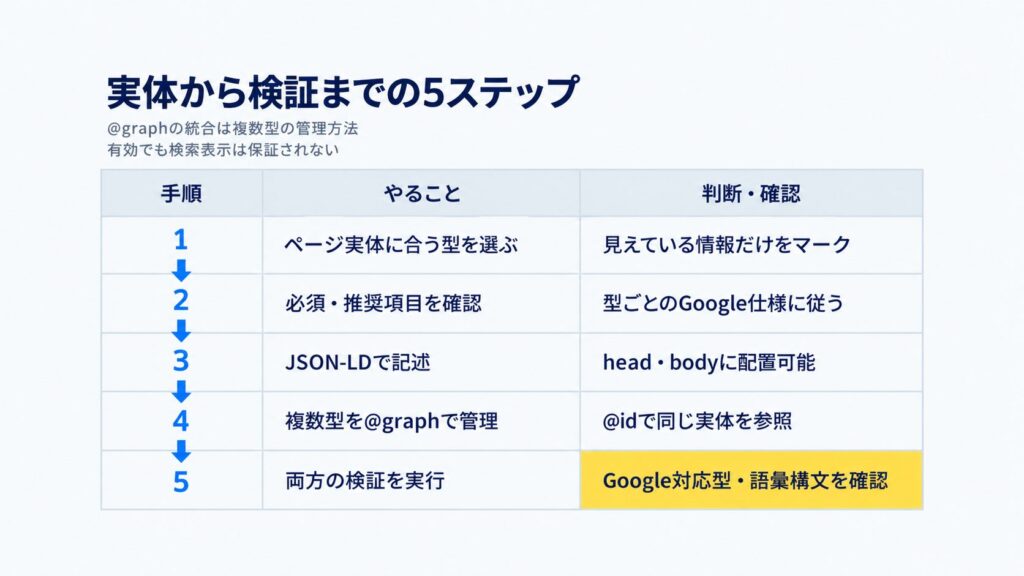
構造化データは「とりあえず付ける」ものではなく、ページの実体に合わせて型を選び、JSON-LDで一貫して記述するのが原則です。
Googleは記法としてJSON-LDを推奨しており、複数のエンティティはひとつの@graphにまとめて関連付けると管理しやすくなります。
下のフローは、設計から検証までを5ステップに分けた型です。各ステップを順に進めてください。
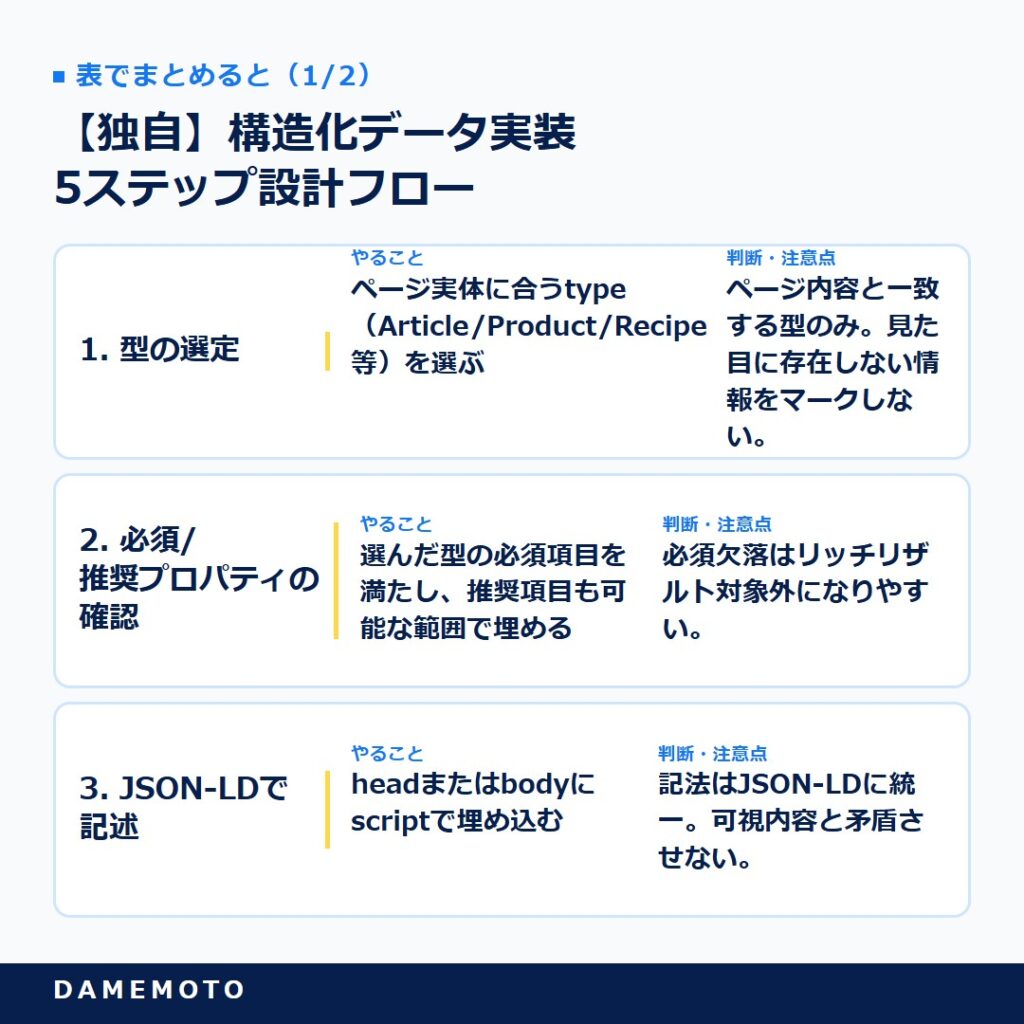
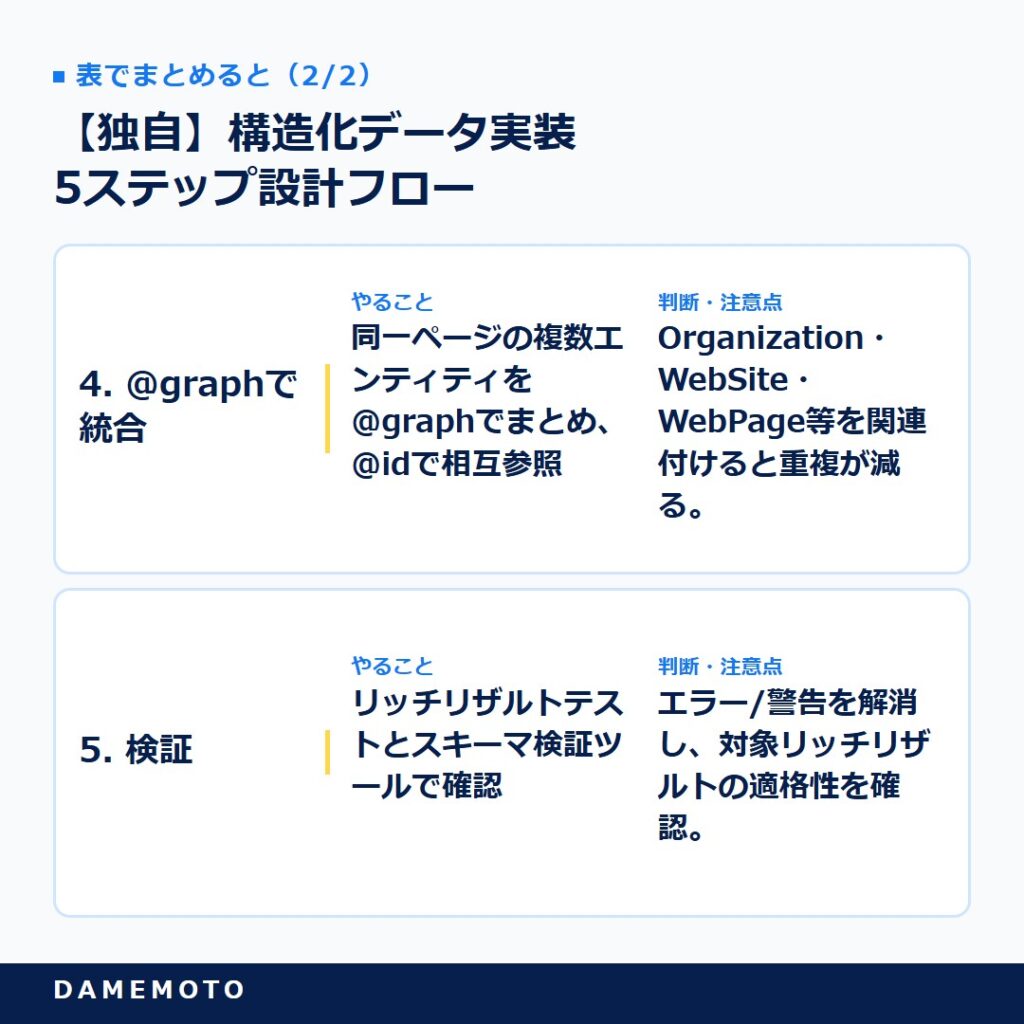
表で詳しく見る
| ステップ | やること | 判断・注意点 |
|---|---|---|
| 1. 型の選定 | ページ実体に合うtype(Article/Product/Recipe等)を選ぶ | ページ内容と一致する型のみ。見た目に存在しない情報をマークしない。 |
| 2. 必須/推奨プロパティの確認 | 選んだ型の必須項目を満たし、推奨項目も可能な範囲で埋める | 必須欠落はリッチリザルト対象外になりやすい。 |
| 3. JSON-LDで記述 | headまたはbodyにscriptで埋め込む | 記法はJSON-LDに統一。可視内容と矛盾させない。 |
| 4. @graphで統合 | 同一ページの複数エンティティを@graphでまとめ、@idで相互参照 | Organization・WebSite・WebPage等を関連付けると重複が減る。 |
| 5. 検証 | リッチリザルトテストとスキーマ検証ツールで確認 | エラー/警告を解消し、対象リッチリザルトの適格性を確認。 |
このフローの要は、ステップ1で「ページの実体に合う型だけを選ぶ」ことです。実態のない情報をマークアップするとガイドライン違反になり得ます。
なお、よく使われてきたFAQのリッチリザルト表示は2026年5月に廃止されましたが、FAQPageマークアップ自体を残すこと(構造化情報としての記述)は問題ありません。
表示目的だけに頼った設計から見直しておくと安全です。
構造化データのエラー 症状別早見表
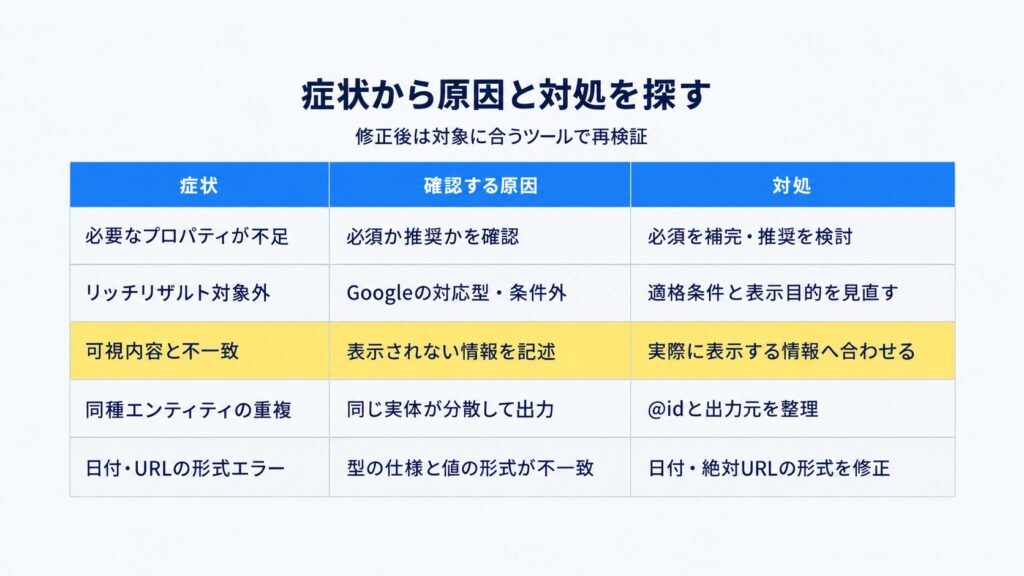
構造化データはエラーや警告が出ても見た目には影響しないため、放置されがちです。しかしリッチリザルトの適格性は確実に下がります。下表は検証時に出やすい症状から、原因と対処を引くための早見表です。テスト結果と突き合わせて使ってください。
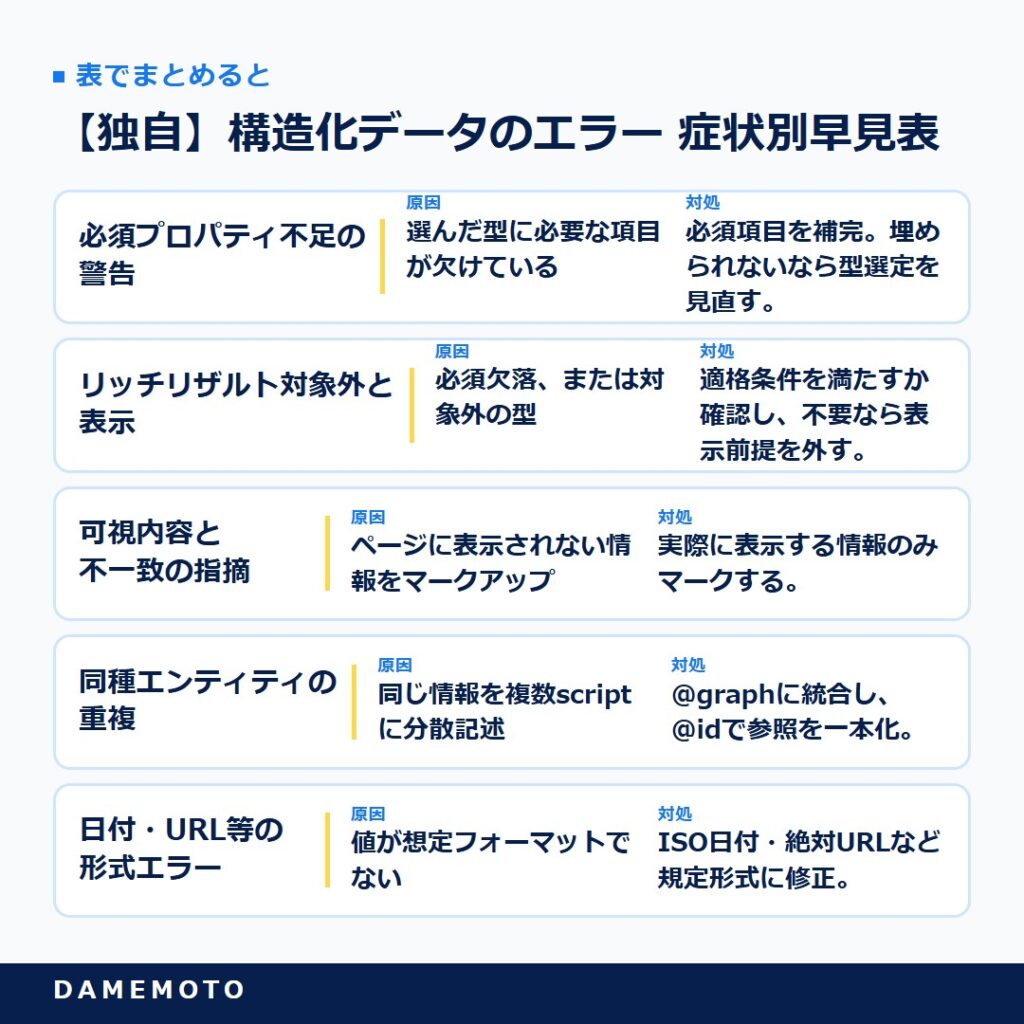
表で詳しく見る
| 症状 | 原因 | 対処 |
|---|---|---|
| 必須プロパティ不足の警告 | 選んだ型に必要な項目が欠けている | 必須項目を補完。埋められないなら型選定を見直す。 |
| リッチリザルト対象外と表示 | 必須欠落、または対象外の型 | 適格条件を満たすか確認し、不要なら表示前提を外す。 |
| 可視内容と不一致の指摘 | ページに表示されない情報をマークアップ | 実際に表示する情報のみマークする。 |
| 同種エンティティの重複 | 同じ情報を複数scriptに分散記述 | @graphに統合し、@idで参照を一本化。 |
| 日付・URL等の形式エラー | 値が想定フォーマットでない | ISO日付・絶対URLなど規定形式に修正。 |
対処の原則は「実体に合わせる」と「重複を統合する」の2点です。エラーが多いときは個別修正より、ステップ1の型選定とステップ4の@graph統合に立ち返ると根本解決が早まります。修正後は必ずリッチリザルトテストで再検証してください。
コピペで使える正しいJSON-LD実例(@graph統合版)
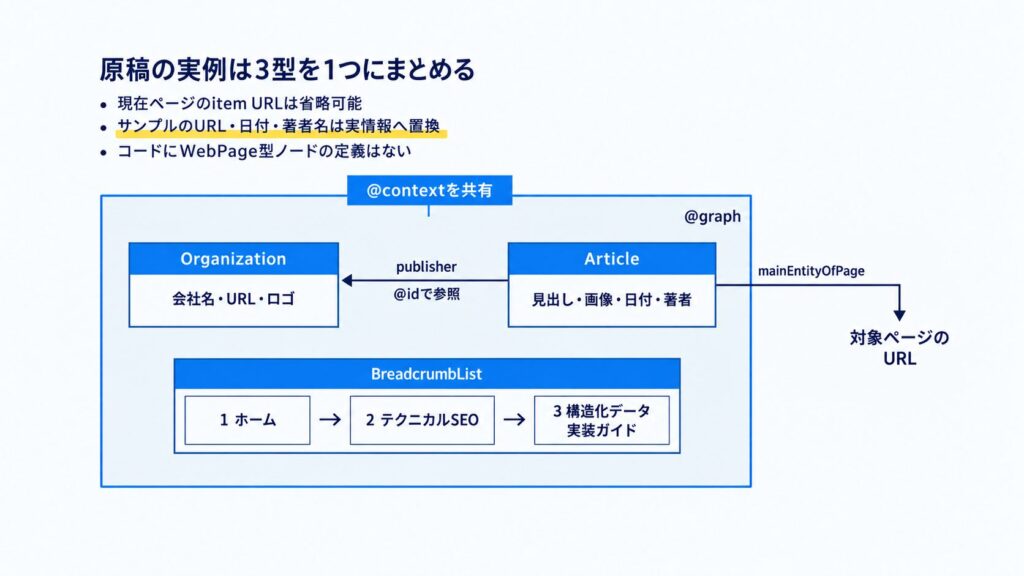
ここまでの型選定・@graph統合・可視内容一致を、実際のコードに落とし込みます。
下のJSON-LDは、記事ページで定番のArticle・BreadcrumbList・Organizationを1つの@graphにまとめ、@idで相互参照した雛形です。
example.comや日付・著者名は必ず自社の実値に置き換えてください(置き換えずに使うとガイドライン違反になります)。
BreadcrumbListのpositionは1からの連番、ArticleのdatePublished・dateModifiedはISO 8601(YYYY-MM-DD)で記述しています。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://example.com/#organization",
      "name": "サンプル会社",
      "url": "https://example.com/",
      "logo": "https://example.com/logo.png",
      "sameAs": ["https://x.com/example", "https://www.facebook.com/example"]
    },
    {
      "@type": "BreadcrumbList",
      "@id": "https://example.com/seo/structured-data/#breadcrumb",
      "itemListElement": [
        { "@type": "ListItem", "position": 1, "name": "ホーム", "item": "https://example.com/" },
        { "@type": "ListItem", "position": 2, "name": "テクニカルSEO", "item": "https://example.com/seo/" },
        { "@type": "ListItem", "position": 3, "name": "構造化データ実装ガイド" }
      ]
    },
    {
      "@type": "Article",
      "@id": "https://example.com/seo/structured-data/#article",
      "headline": "構造化データ実装ガイド",
      "image": ["https://example.com/images/structured-data-1200.jpg"],
      "datePublished": "2026-06-11",
      "dateModified": "2026-08-10",
      "author": { "@type": "Person", "name": "編集部 太郎" },
      "publisher": { "@id": "https://example.com/#organization" },
      "mainEntityOfPage": { "@id": "https://example.com/seo/structured-data/" }
    }
  ]
}
</script>ポイントは3つです。1つ目、BreadcrumbListの最終要素(現在のページ)はitemのURLを省略するのがGoogleの推奨です(自分自身へのリンクは不要)。
2つ目、publisherとmainEntityOfPageを@idで参照し、Organization・WebPageの重複記述を避けています。
3つ目、FAQをページに掲載しているならこの@graphにFAQPageを追加できますが、検索結果のFAQ表示は2026年5月7日に廃止済みのため、表示目的ではなくAI・機械の構造理解を狙う位置づけになります。
貼り付けたら、必ずリッチリザルトテストとスキーマ検証ツールの両方で確認してください。パンくずの設計と表示の合わせ方はパンくずリストのSEO効果と実装方法で掘り下げています。
構造化データが「効かない・不要な」ケース
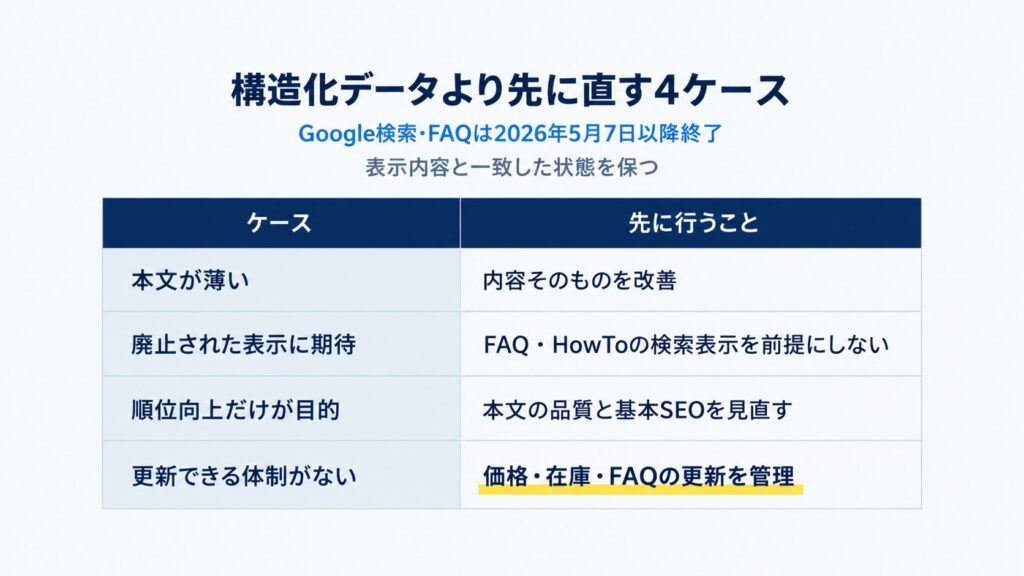
構造化データは万能ではありません。過度な期待を避けるため、効果が出にくい・優先度が下がるケースを正直にお伝えします。次のような状況では、構造化データより先に着手すべきことがあります。
- そもそもコンテンツの質が低い:マークアップは内容を機械に正しく伝えるだけで、内容そのものを良くはしません。中身が薄ければ先に本文を改善すべきです。
- 対象リッチリザルトが廃止された型に期待している:FAQ・HowToは検索表示が廃止済み。表示を目的に実装しても、検索結果での視覚的な見返りはありません。
- 順位そのものを上げたい:構造化データは直接のランキング要因ではないため、順位対策としては本文・被リンク・E-E-A-Tが先です。
- 運用体制がなく更新できない:価格・在庫・FAQが変わるのにマークアップを放置すると、可視内容との不一致でかえって違反リスクになります。
逆に言えば、本文の質が担保され、BreadcrumbListやArticleのように現役で機能する型を、運用しながら正確に保てるなら、構造化データは費用対効果の高い施策です。
「実装すれば順位が上がる魔法」ではなく「正しく理解させ、見え方を底上げする土台」と捉えるのが、過不足ない付き合い方です。
構造化データより先に見直したい技術要素はテクニカルSEOの監査チェックリストで一覧にしています。
まとめ:構造化データは「正確さ」と「検証」が命
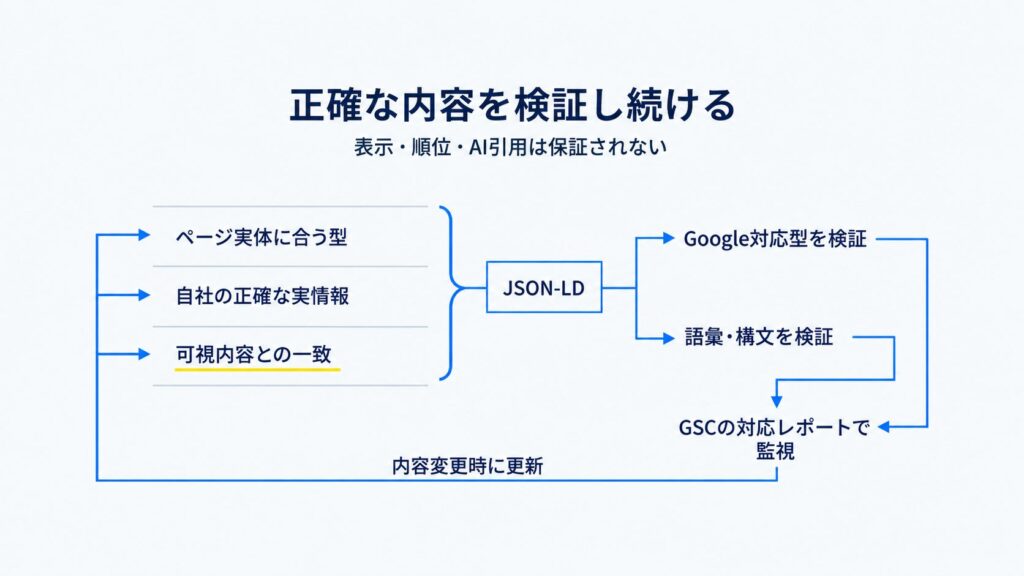
構造化データは、機械にページの意味を伝えるマークアップです。
JSON-LD形式で、Article・FAQPage・BreadcrumbListなどをschema.orgに従って記述します。
ページ内容と一致させ、実装後は必ずリッチリザルトテストで検証します。最後に要点を3行で整理します。
- JSON-LD形式、BreadcrumbList・Articleから
- ページ表示内容と必ず一致させる
- リッチリザルトテストで検証、GSCで監視
構造化データは、検索とAIの両方にページの意味を正確に伝える、地味ながら重要な施策です。
直接順位を上げるものではありませんが、リッチリザルトでの視認性や、検索エンジン・AIにページの意味を正確に伝えるうえで役立ちます。
大切なのは、正確さと検証です。サンプルをそのまま使わず自社情報に書き換え、ページに表示されている内容と一致させ、実装後は必ずリッチリザルトテストで確認する。
FAQリッチリザルトの検索表示は2026年5月に廃止され、パンくずもモバイル表示は簡素化されました(デスクトップは継続)が、構造化データ自体はAIの情報源やサイト構造の理解に活用され続けています。
一度仕組みを作れば運用コストは低く、長期的なリターンが大きい。まずはBreadcrumbListとArticleから、今日始めてみることをおすすめします。
自社の動画ページで、実際の作品と記述を照合する
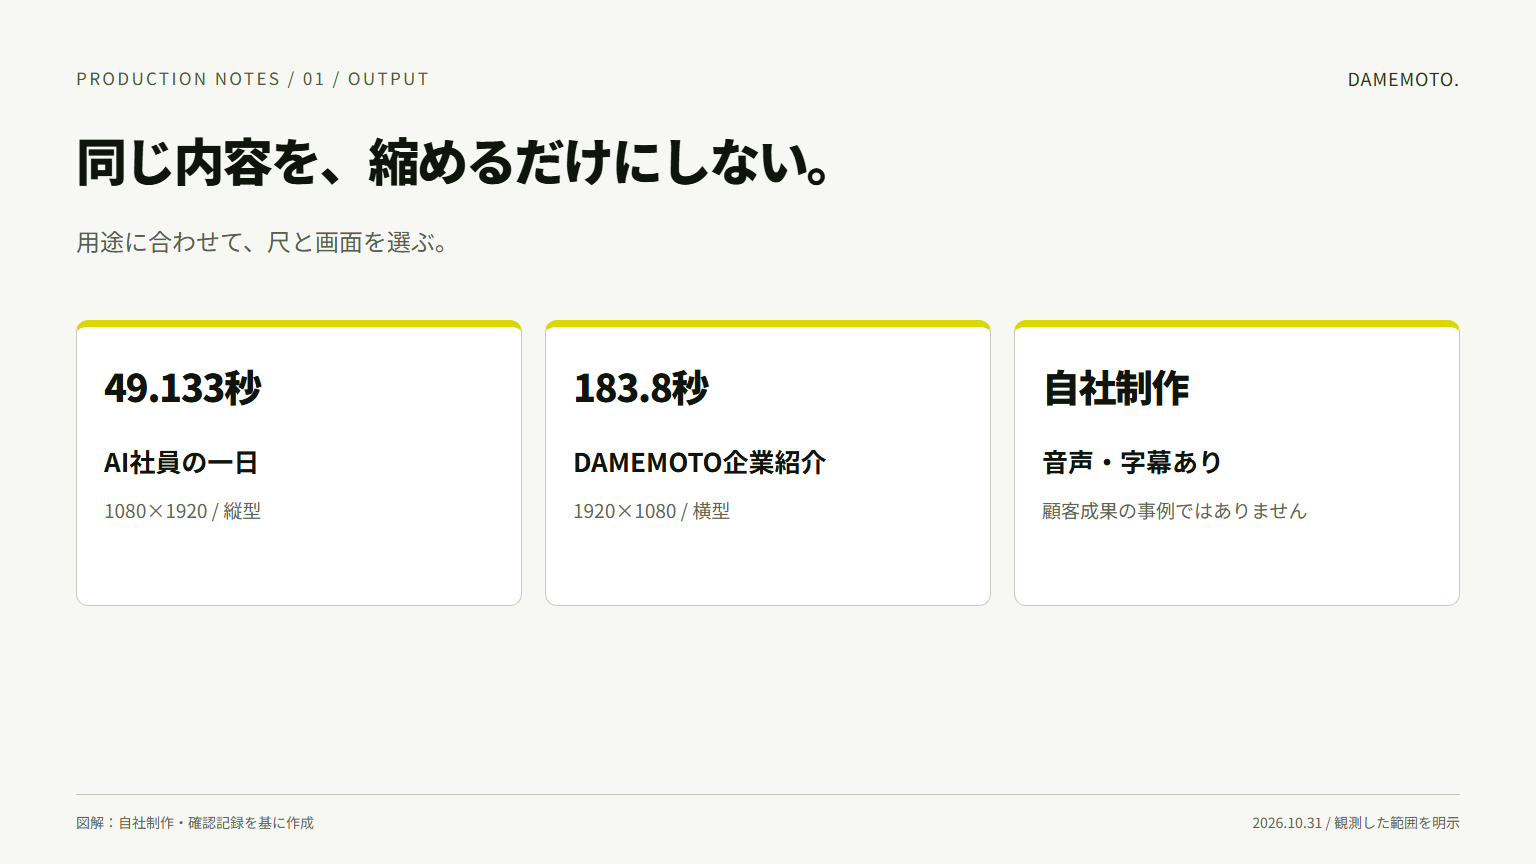
自社の動画サンプルページでは、音声付き動画のタイトル、説明、尺、視聴できるファイルなどを作品ごとに整理しています。確認の基準は、構造化データの欄を埋めることだけでなく、画面にある作品と対応しているかです。
| 照合するもの | 避けたい状態 |
|---|---|
| 作品名と説明 | 別の動画や架空の受注実績を説明している |
| 動画・画像の参照先 | ファイルが開けない、別作品へ移動する |
| 公開ページの表示 | 記述された作品をそのページで視聴できない |
構造化データがあることと、検索結果に動画や特別な表示が出ることは別です。この自社事例でも、検索での特別な表示や順位の向上を確認したという主張はしていません。
以下の制作記録に、対象・確認したこと・まだ分からないことをまとめています。
参考URL一覧
- 課題解決プラットフォーム・構造化データ入門|初心者でもわかるJSON-LDの書き方:https://0120.co.jp/blog/aio-40
- WEBRIES・構造化データ(JSON-LD)とは?店舗サイトに実装すべきマークアップ:https://webries.co.jp/seo/structured-data
- Scale Basics・構造化データマークアップ完全ガイド|JSON-LDコード例付き:https://scale-basics.com/blog/structured-data-markup
- 柏崎剛・構造化マークアップとは?SEOに効くJSON-LDの書き方とschema.org完全ガイド:https://www.tsuyoshikashiwazaki.jp/blog/seo-effects-of-structured-data
- crevia・JSON-LDの書き方完全ガイド|業種別・タイプ別サンプルコード:https://crevia-ts.com/archives/1057
- バクヤスAI・構造化データの正しい実装方法【リッチスニペットでCTRアップ】:https://bakuyasu.techsuite.co.jp/29095
仕様・データの確認資料:仕様の一次資料 / Google:検索のAI機能