Perplexity経由トラフィックを増やす実装術とは、回答に必ず付く出典リンクから自社サイトへ送客するための最適化で、被引用=そのまま流入になるのが最大の特徴です。
Perplexityは「アンサーエンジン」を掲げ、すべての回答に番号付きの参照リンクを表示して出典サイトへ送客します。
被引用がそのまま流入になるため、増やす実装術の中心は「引用されやすい構造」を作ること。
具体的には、PerplexityBot/Perplexity-Userのクロールを許可し、冒頭で結論を即答し、出典を明記し、最新性と専門性を担保する一連の設計です。
流入は数こそChatGPTに劣る一方、出典を自ら確かめに来る濃い層が中心で、計測もGA4のリファラーで完結します。
この記事の結論
Perplexityは引用がそのまま流入になるので、クローラー許可と結論の即答から始めたいと考えています
今日からやること
- robots.txtとWAFでPerplexityBotを通す
- 記事の冒頭に40〜80字の定義文を置く
- GA4でperplexity.aiの参照元を毎月見る
こんな人向け:AI検索からの流入を数字で確かめながら増やしたいWeb担当の方数値の出典:Perplexity公式・Crawlersドキュメント
Perplexity経由トラフィックを増やす最短ルートは「引用される設計」
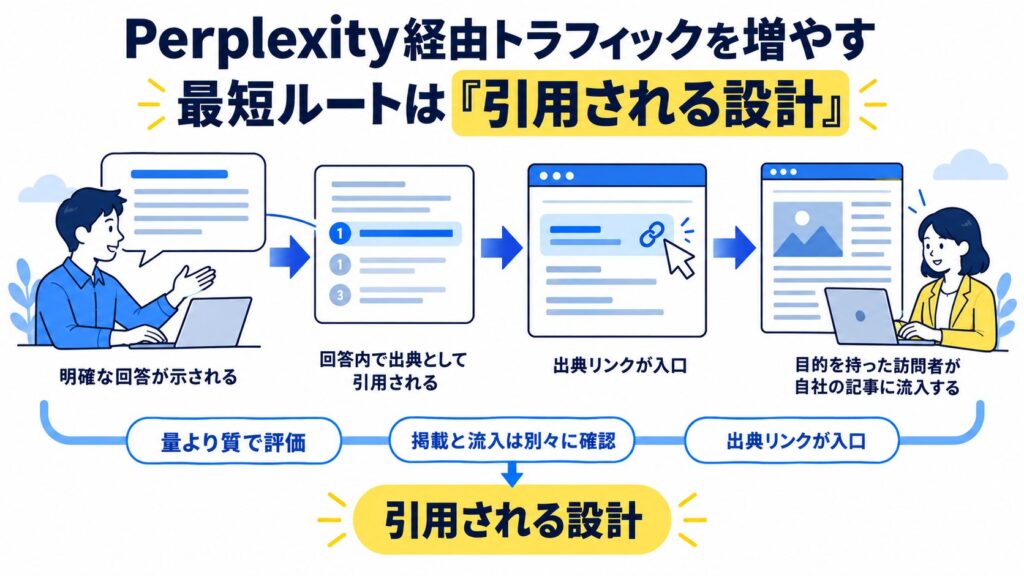
先に答えを言えば、Perplexity経由の流入を増やす最短ルートは、回答に表示される出典リンクに自社ページを載せること、つまり「引用される設計」を作ることです。
Perplexityは回答の各文に番号付きの参照リンクを添え、ユーザーをその出典サイトへ送り出します。
GoogleのAI Overviewsが本文内に答えを抱え込みがちなのに対し、Perplexityは透明性を売りにする分、被引用がそのまま流入の入口になります。
 DAMEMOTO代表鈴木
つまり「引用されること」がゴールなんです
出典リンクが流入の入口になる理由
Perplexityは回答の根拠を1件ごとに番号化して提示し、ユーザーが「本当か」を確かめられるよう設計されています。
実際、Perplexity公式の検索向けクローラー「PerplexityBot」は「Perplexityの検索結果にサイトを表示・リンクするために設計されており、AI基盤モデルの学習用にコンテンツをクロールするものではない」と明記されています(Perplexity公式・Crawlersドキュメント)。
送客を前提に作られたエンジンだからこそ、引用が流入に直結します。answerを出すだけでなく、出典へ橋を架けるのがPerplexityの基本姿勢です。
Google AI Overviewsとの送客モデルの違い
PerplexityもGoogleのAI検索も、回答の表示と引用先への訪問は分けて測ります。
引用されてもクリックされるとは限らず、最初の引用先が得るクリックの割合を一律に置くことはできません。自社URLの掲載と参照流入、流入後の有効CVを別々に確認します。
同じAI検索でも、送客の作りが正反対です
流入の「量」より「質」で見るべきチャネル
Perplexity流入の評価は、セッション数だけで判断すると過小評価になりがちです。
Perplexity-referred トラフィックはB2Bで質が高いと複数の調査が報告しており、たとえばあるB2Bクライアント群ではPerplexity経由が通常のGoogleオーガニックの約3.1倍のCVRで成約したとする集計があります(MarGen・2026、特定ポートフォリオの値で普遍的数値ではない)。
出典を自ら確かめに来る層は目的意識が高く、滞在も長い傾向があるためです。数で切り捨てず、CVRまで見て優先度を判断するのがコツです。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
PerplexityBot/Perplexity-Userの挙動と許可設定
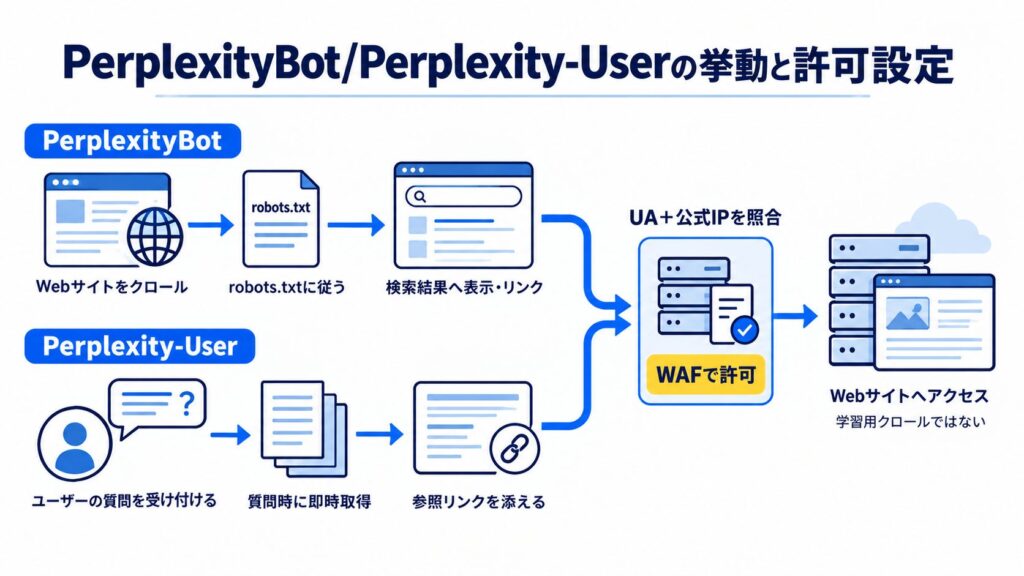
Perplexity経由トラフィックの土台は、2種類のクローラーを正しく通すことです。
Perplexityは「PerplexityBot」と「Perplexity-User」という挙動の異なるユーザーエージェントを使い分けており、片方をブロックすると引用機会そのものを失います。
WAF(Web Application Firewall)でAIアクセスを一律遮断している場合は、ここが盲点になりやすいポイントです。
PerplexityBot:検索インデックス用クローラー
PerplexityBotは、Perplexityの検索結果にサイトを表示・リンクするためのクローラーです。
完全なユーザーエージェント文字列は「Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)」で、robots.txtの指示に従います(Perplexity公式・Crawlersドキュメント)。
検索結果に載せたいなら、robots.txtでPerplexityBotを許可し、公式が公開するIPレンジ(perplexitybot.json)からのアクセスを通すのが推奨されています。
学習用クロールではない点が、後述のAIクローラー制御の議論と切り分けるべき重要な違いです。
Perplexity-User:ユーザー要求に応じた即時取得
Perplexity-Userは、ユーザーが質問した瞬間に、回答の正確性を高めるためページを訪問して参照リンクを添える挙動を担います。
ユーザーの能動的な要求に基づくため、「ユーザーがフェッチを要求したため、このフェッチャーは一般にrobots.txtのルールを無視する」と公式に明記されています(Perplexity公式・Crawlersドキュメント)。
これも学習用ではなく、リアルタイム回答の出典確認のためのアクセスです。
robots.txtでPerplexity-Userを止めても無視され得るので、確実に制御したい場合はIP・UAを組み合わせたWAFルールで判断する設計になります。
2つの挙動の違い、ここは取り違えやすいです
WAF・robots.txtで「通す」設定の勘所
クローラーを通す実装は、robots.txtとWAFの2層で考えます。
公式はWAF設定として、ユーザーエージェント(PerplexityBot/Perplexity-User)と、公式JSONエンドポイントの最新IPレンジを「AND条件」で照合してAllowするルールを推奨しています(Cloudflare・AWS WAFの手順を明示)。
IPは随時更新されるため、JSONを定期取得してルールを自動更新するのが安全です。
「学習は拒否したいが検索・回答には載せたい」を分けて設計できる点が、Perplexity制御の実務的な要です。
ボット別の許可と拒否の書き分けは、AIクローラー制御のrobots.txt記述例で整理しています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
Perplexityで引用を獲得する6つの実装術
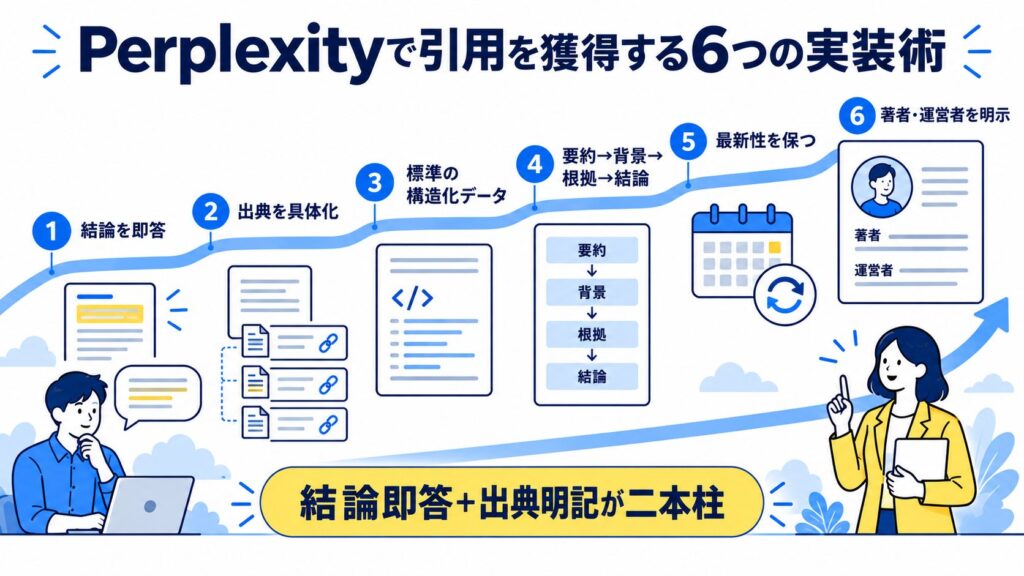
クローラーを通したうえで、引用を獲得するための実装は大きく6つです。冒頭での結論即答、出典の明記、構造化データ、学術的な論理構造、最新性の担保、著者・運営者情報の明示。
いずれもSEOで重視される品質要素と重なり、Perplexityが信頼性・透明性を強く評価する設計だからこそ効きます。順に具体化します。
実装1:冒頭で結論を即答する(定義先出し)
「○○とは何か」という定義型・質問型のクエリに対し、Perplexityは記事冒頭の即答文を抜き出して引用する傾向があります。
「主語+とは+定義内容」の構造で、H1直下に40〜80字の定義文を置くのが基本形です。
たとえば「Perplexity AIとは、回答に出典を明示するアンサーエンジン型のAI検索です」のように、結論を先頭に出します。
Bing公式も「明確な見出し・表・FAQでキー情報を表面化させると、AIが正確に参照しやすい」と助言しており(Microsoft Advertising・AI回答に含まれるための最適化(2025年10月))、即答形式はAI検索全般に通じる作法です。
即答文の組み立て方は、結論ファーストでAI引用される記事の書き方で文型とあわせてまとめています。
DAMEMOTO代表鈴木最初の一文で答え切る、ここが効きます
実装2:出典を具体的に明記する
Perplexityは「すでに信頼できる出典を引いている記事」を評価しやすい傾向があります。出典の書き方は粒度が命です。
「ある調査によると」は弱く、「○○社の調査では」は中程度、「(出典:Ahrefs・AI Overviews調査、2026年2月公開)」のように媒体名・調査名・日付まで添えると強くなります。
数値には必ず一次ソースを紐づけ、本文中にリンクで分散させます。被引用の多いドメインが優先されやすいため、サイテーションや被リンクの獲得もそのまま引用率に効きます。
実装3:構造化データ(Article/FAQPage)を実装する
構造化データは、AIにコンテンツの意味を正確に伝える補助線です。
記事にはArticle、Q&A型のブロックにはFAQPageを実装し、著者はPerson、運営者はOrganizationで記述します。
Perplexityはリアルタイム検索で外部インデックスも参照するため、検索エンジンに正しく理解される構造はそのまま引用されやすさに効きます。
なおGoogle公式は「生成AI向けの特殊なschemaは不要」と明言しており(Google検索セントラル・生成AI最適化ガイド)、AI専用の独自マークアップを足すより、標準仕様を正確に実装するのが筋です。実装の詳細は構造化データ専門記事に譲ります。
実装4〜6:学術的構造・最新性・著者情報
残り3つは、論理構造・鮮度・発信者の明示です。学術的構造とは「要約→背景→根拠→結論」の順で論点を一つずつ展開する形で、エッセイ的に話が飛ぶ記事より引用されやすい傾向があります。
最新性は、本文に「2026年6月時点」のような時間軸を明記し、定期更新で鮮度を保つのが効果的とされます(複数の国内解説で共通して指摘)。
著者情報は、資格・実績・所属を明記してProfile/Organizationと結びつけます。3点とも単独では地味でも、組み合わせると「信頼できる出典」としての総合点が上がります。
結論即答+出典明記が二本柱
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
Perplexityの仕組みと、Publishers’ Program・Cometの送客拡大
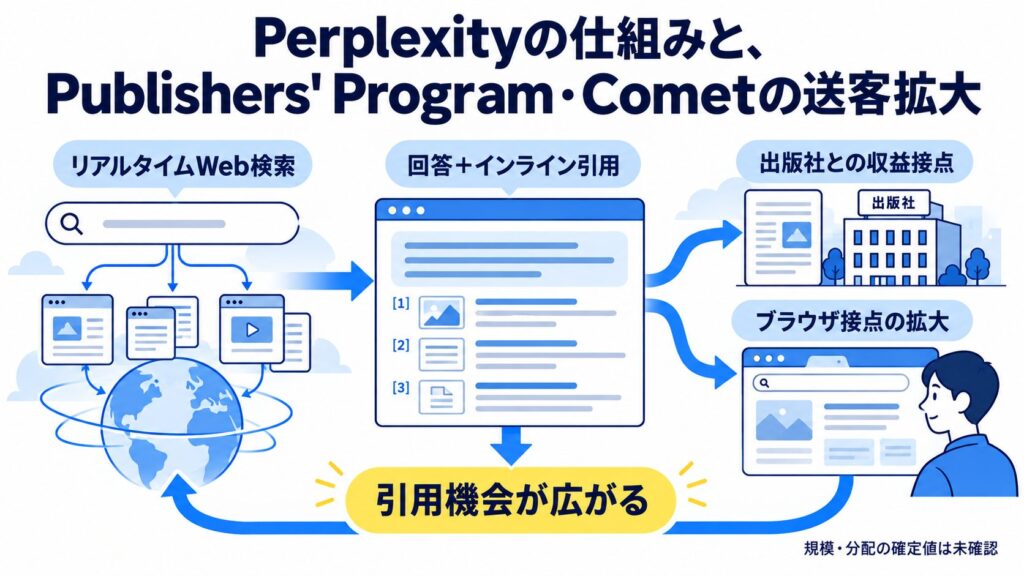
引用を狙う前提として、Perplexityがどう答えを作り、どう送客を広げているかを押さえておきます。
中核は自社モデル「Sonar」とリアルタイムWeb検索の組み合わせで、近年は出版社への収益還元プログラムや独自ブラウザCometを通じて、送客と引用の接点を広げています。
仕組みを理解すると、「どんな主張なら拾われるか」が見えてきます。
Sonar+リアルタイム検索という回答生成
Perplexityの回答は、クエリ時にWebを検索して取得した最新情報を根拠に、各文へインライン引用を添えて生成されます。
自社モデルSonarはMeta Llama 3.3 70Bをベースにし、静的な学習知識に頼らず取得した実データで回答を組み立てる設計と報じられています(Perplexity公式・API Platform)。
Pro版では他の最新モデルを選べる構成もあり、モデルの種類より「検索で取得されやすい構造か」が引用の分かれ目になります。
Publishers’ Program:被引用が収益にもつながる動き
Perplexityは出版社向けの収益還元(Publishers’ Program/Comet Plus)を拡大しており、コンテンツが回答で引用・閲覧された際に出版社へ分配する仕組みが報じられています(Search Engine Journal・Comet Plus/出版社収益分配)。
報道される分配プールの規模や分配率(例:80/20)、1,000引用あたりの推定単価などは、Perplexity公式が確定数値として公表したものではなく二次・アナリスト推計が中心のため、ここでは「そういう方向性が報じられている」までを事実として扱います(具体額は未確認)。
重要なのは、被引用が露出だけでなく将来的な収益接点にもなり得る、という流れです。
Comet・規模拡大が引用機会を押し上げる
Perplexityはエージェント型ブラウザ「Comet」を2026年にiOSを含む全プラットフォームへ展開し、利用接点を広げています(Search Engine Journalほか)。
利用者規模は集計により幅があり、Financial Timesは「エージェント製品を含めると月間1億人超」と報じる一方、より小さい数値を示す集計もあります(出典により大きく異なるため、単一の確定値は未確認)。
1日のクエリ数も2026年時点でおおむね数千万件規模とされます。母数が増えるほど引用機会も増えるため、いま土台を整える価値があります。
数字は揺れますが、伸びの方向は明確です
引用を流入につなげる計測と運用フロー
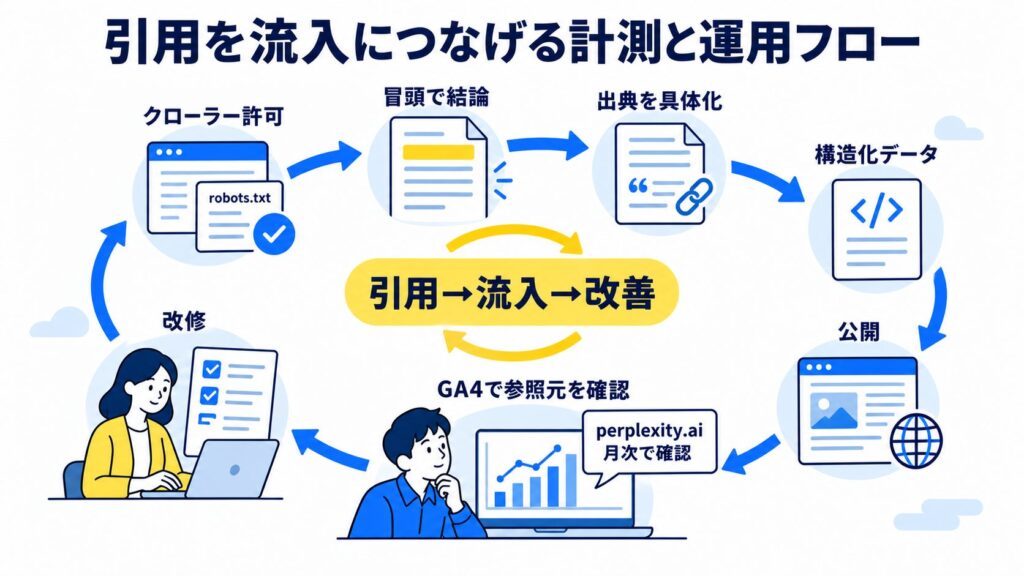
引用は獲得して終わりではなく、流入として計測し、改善に回して初めて成果になります。
Perplexityは出典に必ずURLが付くため、GA4のリファラーで効果を数字に落としやすいのが利点です。ここでは計測の起点と、既存記事を活かした運用の回し方を示します。
GA4でperplexity.aiリファラーを追う
Perplexity経由の流入は、GA4の「参照元/メディア」レポートで「perplexity.ai」を確認するのが最短です。
引用リンク経由のクリックはリファラーとして記録されるため、どのページが引用され流入を生んでいるかを把握できます。
まずは「perplexity.aiが参照元に出ているか」を毎月見る運用から始めると、引用獲得の感覚が数字でつかめます。参照元の抽出と確認の手順は、Perplexity流入をGA4で計測する方法もあわせて確認しておきたいところです。
既存記事の冒頭・出典リライトから着手する
新規記事を量産しなくても、既存記事の「冒頭の即答」と「出典の具体化」を整えるだけで引用は立ち上がりやすくなります。
理由は単純で、Perplexityが拾うのは結論先出しの明確な主張と、根拠の明示された記述だからです。
手順は、(1)主要記事のH1直下に定義文を追加、(2)曖昧な出典を媒体名・日付付きに置換、(3)Article/FAQPageを実装、の順が取り組みやすい。
置き土産:Perplexity引用獲得チェックリスト
運用に持ち帰れるよう、引用獲得の確認項目を一覧にまとめました。新規・既存どちらの記事でも、公開前にこの順で点検すると抜けが減ります。
- robots.txtでPerplexityBotを許可、WAFで遮断していない
- H1直下に40〜80字の定義文(結論先出し)がある
- 主要な数値に媒体名・日付付きの出典リンクがある
- Article/FAQPageの構造化データを実装済み
- 本文に「2026年〇月時点」など時間軸を明記している
- 著者・運営者情報を明示しProfile/Organizationと接続
- GA4でperplexity.aiリファラーを月次で確認している
このチェックリストは、そのまま社内の記事公開フローに組み込めます。とくに上3つ(クローラー許可・定義文・出典)は効果が出やすく、最初に着手する価値が高い項目です。
Perplexity対策にまつわる3つの誤解
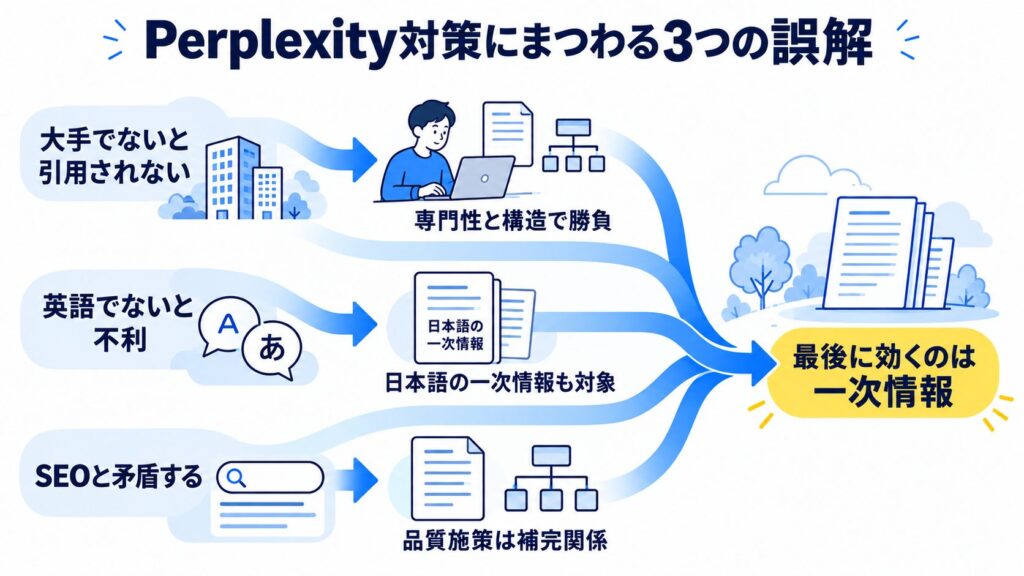
実装に入る前に、よくある誤解を3つほどいておきます。「大手サイトでないと引用されない」「英語でないと不利」「SEOと矛盾する」。いずれも実態とずれており、誤解のまま進めると優先順位を見誤ります。
誤解1・2:大手・英語でなくても引用される
「大手サイトでないと引用されない」は誤解です。Perplexityは情報の正確性と構造の明確さを重視するため、専門領域で深い知見を提供すれば中小サイトでも引用対象になります。
Bing公式も「深さ・専門性・明確な構造」を引用されやすさの要因に挙げています(前掲・Microsoft Advertising 2025年10月)。
「英語でないと不利」も誤解で、日本語記事も引用されます。とくに日本の法律・商習慣・国内事例といったローカル情報は、日本語の一次情報が優先的に拾われやすい領域です。規模や言語より、内容の質と独自性が問われます。
誤解3:SEOと矛盾せず、むしろ補完する
「SEO対策と矛盾する」も誤解です。Perplexity向けの施策(結論即答・出典明記・構造化・E-E-A-T)は、SEOで評価される品質要素とほぼ重なります。
Google公式も「生成AI検索への最適化も本質はSEO」と整理しています(前掲・生成AI最適化ガイド)。
SEOで上位のコンテンツはPerplexityのリアルタイム検索でも参照されやすく、SEOを捨ててPerplexityだけに注力する必要はありません。
SEOの土台に、結論先出しと出典明記を上乗せする。この重ね方が現実的です。
最後に効くのは「他では読めない一次情報」
引用の最終的な決め手は、一次情報です。他サイトの焼き直しではなく、自社で集めた数値・自社の事例・独自の解釈があると、引用率は明確に上がります。
AIは「他では拾えない情報」を優先する性質があるためです。逆に言えば、一次情報と結論先出しの構造さえ押さえれば、ドメインの大小に関わらず勝負できます。
この2点が、Perplexity引用獲得の核心です。自社ならではのデータの集め方は、一次情報の作り方と4系統の取得術を読むと進めやすくなるはずです。
正直コーナー:Perplexity対策が「向かない/後回しでよい」ケース
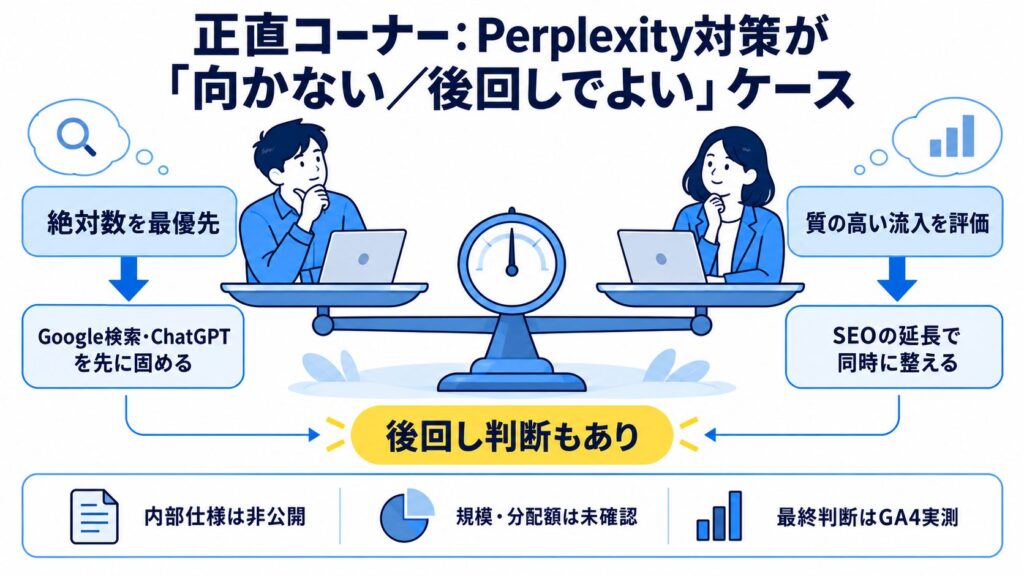
メリットばかり並べても判断は鈍ります。ここでは、Perplexity対策を急がなくてよい場合と、本記事で扱い切れない限界を正直に書きます。
流入の「絶対数」を最優先するなら後回しでよい
Perplexityの利用者数はChatGPTやGoogleに比べれば小さく、流入の絶対数だけを追うフェーズの事業では、対策の優先度は高くありません。
来訪者の質は高い一方で、母数が要るリード獲得をいま最大化したい場合は、まずGoogle検索とChatGPT(Bing基盤)を固める方が費用対効果が出やすい。
Perplexityは「質で効くチャネル」と割り切り、SEOの延長で同時に整えるのが現実的です。
指名検索やローカル中心で、そもそもAI検索経由の比率が低い事業も、後回し判断はあり得ます。どのAIから手をつけるかは、5大AI別のLLMO対策で比べながら決められます。
本記事で「断定できないこと」
正直に言えば、引用アルゴリズムの内部仕様や、引用順位を決める重み付けはPerplexity公式が詳細を公表しておらず、ここで断定はできません。
利用者数・1日のクエリ数・出版社への分配額といった数値も、出典によって大きく振れ、確定値は「未確認」とせざるを得ないものが含まれます。
本記事の数値は「報じられている範囲」と「自社GA4で確かめるべき範囲」を分けて記しています。最終的な効果は、各サイトのGA4実測で確認するのが確実です。
DAMEMOTO代表鈴木分からないことは、正直に分からないと書きます
独自の視点:Perplexityは「数より質」、流入の評価軸を変える
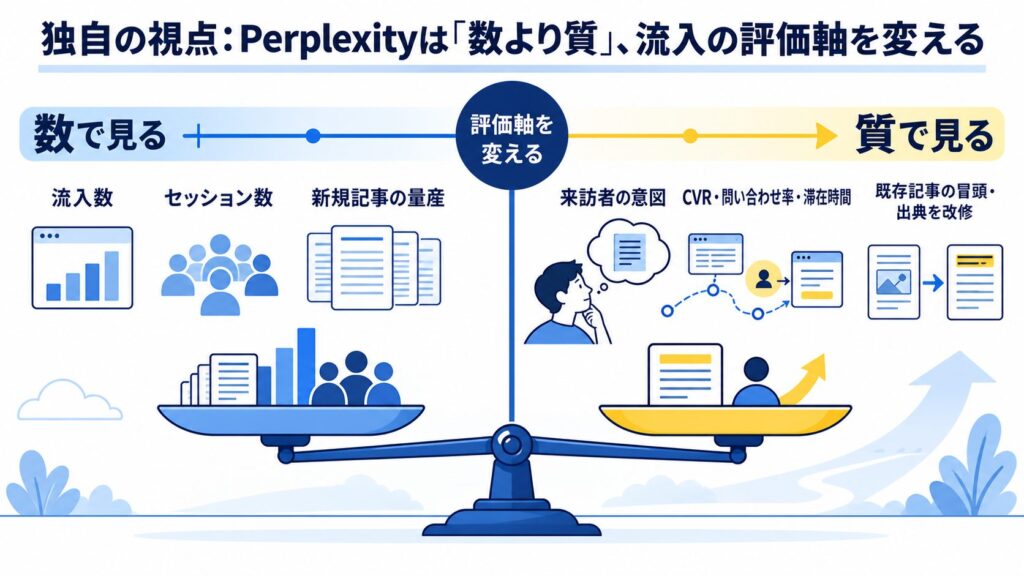
Perplexityは出典を明示して送客する設計のため、流入数こそChatGPTに劣るものの、「来た人の濃さ」で評価すべきチャネルです。
流入数だけで判断するとPerplexityの価値を見誤ります。
下表は、Perplexity流入を“数”でなく“質”で捉え直す独自の視点です。
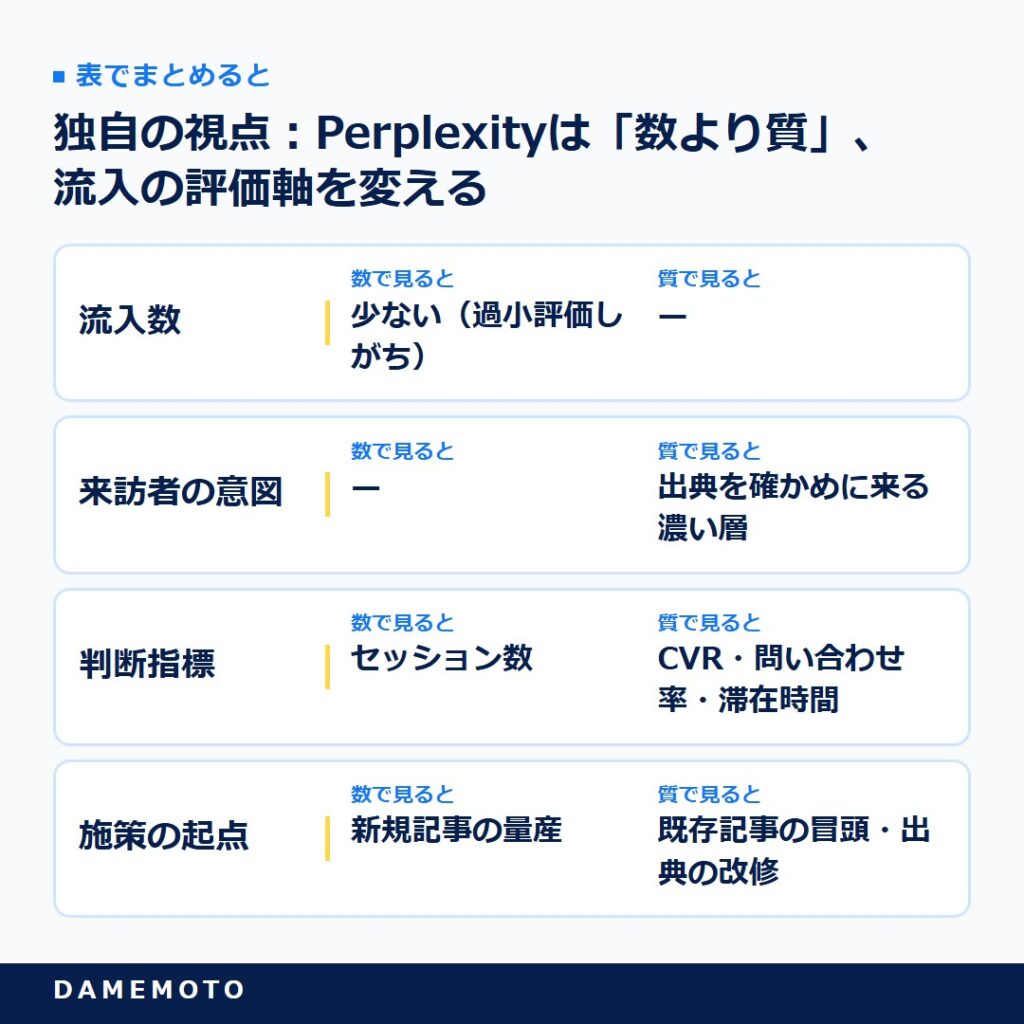
表で詳しく見る
| 評価軸 | 数で見ると | 質で見ると |
|---|---|---|
| 流入数 | 少ない(過小評価しがち) | — |
| 来訪者の意図 | — | 出典を確かめに来る濃い層 |
| 判断指標 | セッション数 | CVR・問い合わせ率・滞在時間 |
| 施策の起点 | 新規記事の量産 | 既存記事の冒頭・出典の改修 |
見落としがちなのは、流入数の少なさだけ見てPerplexity対策を後回しにすること。
出典を自ら確認しに来るユーザーは目的意識が高く、CVRで見ると割の良いチャネルになり得ます(具体的なエンゲージメント率は調査により幅があるため、自社のGA4実測で確認するのが確実です)。
チャネルを“流入数”で一律評価せず、CVRまで見て優先度を判断する——これがPerplexityを取りこぼさないコツです。
よくある質問
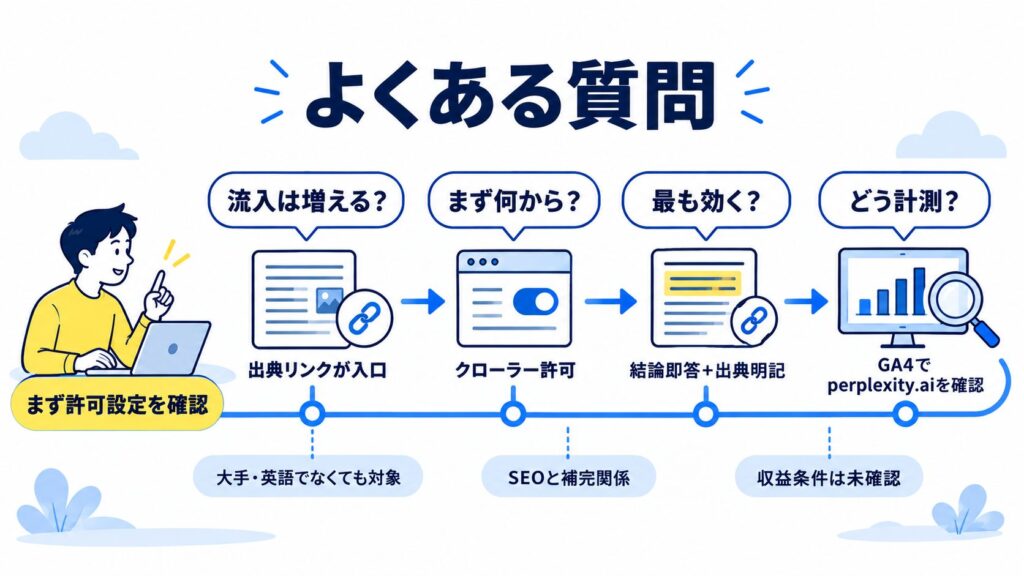
- Perplexityで引用されると流入は増えますか?
-
増えます。Perplexityは回答に必ず出典リンクを表示して送客するため、被引用がそのまま流入の入口になります。
- Perplexity対策はまず何から始めればいいですか?
-
クローラーの許可です。robots.txtでPerplexityBotを通し、WAFで遮断していないかを確認するのが土台。そのうえで冒頭の即答文と出典を整えます。
- PerplexityBotとPerplexity-Userの違いは?
-
PerplexityBotは検索結果にサイトを載せる索引用クローラーでrobots.txtに従います。Perplexity-Userはユーザーの質問時にページを訪問する即時取得で、公式上は一般にrobots.txtを無視します。いずれも学習用のクロールではありません。
- Perplexityで最も効く実装は何ですか?
-
冒頭の結論即答(定義先出し)と、出典の具体的な明記です。Perplexityは明確な主張と根拠の示された記述を拾いやすいためです。
- Perplexityに引用される出典はどう書けばいいですか?
-
媒体名・調査名・日付まで具体的に書きます。「ある調査によると」ではなく「(出典:○○調査、2026年)」のように一次ソースへリンクすると評価されやすくなります。
- Perplexityでは大手サイトや英語でないと不利ですか?
-
不利ではありません。Perplexityはドメイン規模より内容の正確性・構造・専門性を重視し、日本語記事も引用します。とくに日本市場特化の一次情報は日本語が有利です。
- Perplexity対策はSEOと矛盾しませんか?
-
矛盾しません。むしろ補完関係です。Google公式も「生成AI最適化の本質はSEO」と整理しており、品質要素は大きく重なります。
- Perplexityからの流入はどう計測しますか?
-
GA4の「参照元/メディア」で「perplexity.ai」を確認します。出典に必ずURLが付くため、引用経由のクリックがリファラーとして記録されます。
- PerplexityのPublishers’ Programに参加すると収益になりますか?
-
引用・閲覧に応じた還元が報じられていますが、分配額や条件はPerplexity公式が確定数値として公表しておらず、現時点では未確認の部分が多い点に留意してください。
まとめ:被引用=流入。クローラー許可と結論即答から始める
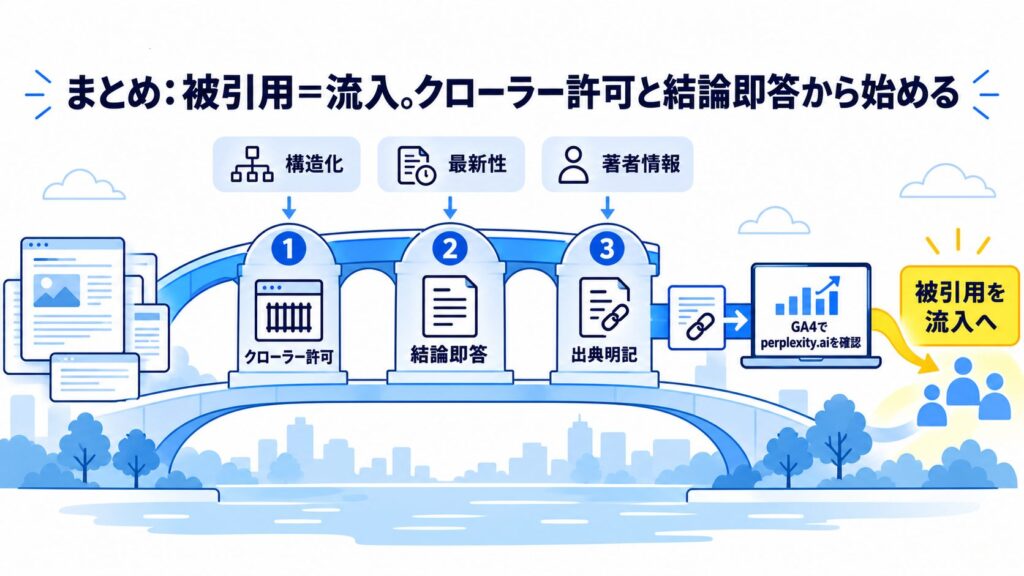
Perplexityは出典を明示して送客するアンサーエンジンで、被引用がそのまま流入になります。
増やす実装術の核は、(1)PerplexityBot/Perplexity-Userを通すクローラー許可、(2)冒頭の結論即答、(3)具体的な出典明記。
これに構造化・最新性・著者情報を重ねれば引用は立ち上がります。流入はGA4のperplexity.aiリファラーで計測でき、効果が数字で見えるのも強みです。
数の少なさに惑わされず、質の高いチャネルとしてSEOの延長で整えるのが、取りこぼさない設計です。
- クローラー許可が出発点
- 結論即答+出典明記が核
- GA4リファラーで効果を見る
参考URL一覧
- Perplexity公式・Crawlers(PerplexityBot/Perplexity-User):https://docs.perplexity.ai/docs/resources/perplexity-crawlers
- Perplexity公式・API Platform(Sonar):https://www.perplexity.ai/api-platform
- Microsoft Advertising・AI回答に含まれるための最適化(2025年10月):https://about.ads.microsoft.com/en/blog/post/october-2025/optimizing-your-content-for-inclusion-in-ai-search-answers
- Google検索セントラル・生成AI最適化ガイド:https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=ja
- Ahrefs・AI Overviews調査(2026年2月公開):https://ahrefs.com/blog/ai-overviews-reduce-clicks-update
- Web担当者Forum・AI Overviews表示時のCTR低下続報(2026年6月データ):https://webtan.impress.co.jp/n/2026/07/29/53036
- Search Engine Journal・Perplexity Comet Plus/出版社収益分配:https://www.searchenginejournal.com/perplexity-launches-comet-plus-shares-revenue-with-publishers/554596/