LLM(大規模言語モデル)とは、膨大なテキストを学習し「次に来る単語(トークン)を確率的に予測する」AIで、トークン化→エンコード→Transformer処理→デコードの4ステップで文章を生成する技術です。
LLMの心臓部は2017年発表のTransformerで、Self-Attention(自己注意)機構が文脈を理解します。
ChatGPT・Claude・GeminiはすべてLLMを基盤とし、GPT-3は約1,750億パラメータを持ちます。
確率で次の語を選ぶ仕組みゆえにハルシネーション(誤情報)が起き、最新情報はRAG(検索拡張生成)で補います。この5分の理解が、AIに引用されるLLMO対策の土台になります。
この記事の結論
LLMは次の語を確率で選ぶAIで、仕組みを知るとAIに引用される書き方が見えると考えています
今日からやること
- 主語を省かず、定義を添えた一文で書く
- 年号・統計は一次ソースで再確認する
- 見出しの直後に結論を言い切る一文を置く
こんな人向け:LLMの仕組みを短時間でつかみ、LLMO対策に生かしたい方数値の出典:Brownら「Language Models are Few-Shot Learners」(arXiv)、Vaswaniら「Attention Is All You Need」(NeurIPS 2017)
LLMとは:「次の単語を確率的に予測する」AI
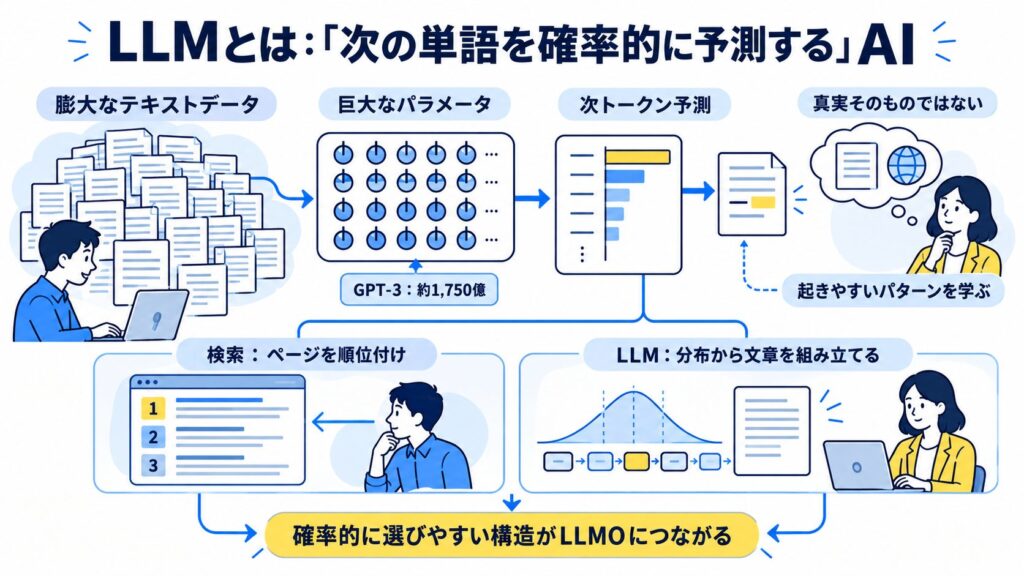
端的に言えば、LLM(Large Language Model:大規模言語モデル)とは、膨大なテキストデータを学習し、与えられた文脈に対して次に来る単語(トークン)を確率的に予測するAIモデルです。
ChatGPT・Claude・Geminiはすべて、基盤にLLMを使っています。
一見すると単純な「次トークン予測」を、数千億語のデータと巨大なパラメータで超大規模に行うことで、要約・翻訳・推論まで創発的に獲得する——これがこの10年でAIが急に賢く見えるようになった正体です。
 DAMEMOTO代表鈴木
「賢いAI」の正体、案外シンプルなんです
なぜ「大規模」と呼ばれるのか?
LLMが「大規模」と呼ばれる理由は、学習データ量とパラメータ(重み付けの数値)の規模にあります。
パラメータとは、モデルが文脈と次の語の関係を覚えるための無数の調整ツマミのようなものです。
OpenAIの論文「Language Models are Few-Shot Learners」によれば、GPT-3のパラメータ数は約1,750億個に達し、これは当時の非スパースな言語モデルの10倍以上の規模でした(OpenAI/arXivのGPT-3論文)。
日本語の解説でも、GPT-3はインターネット上の書籍・Webページ・論文など数千億語規模のテキストを学習したと整理されています(JAPAN AIラボのChatGPT仕組み解説)。
パラメータが増えるほど複雑な言語パターンを捉えられ、文法・語彙の使い分け・論理的推論に近い能力までが段階的に立ち上がります。
「予測」だからこそ重要なこと
ここで誤解しやすいのは、LLMが学んでいるのは「真実」そのものではなく「データの中で起きやすいこと」だという点です。
文脈に対してどの語が続きやすいか、どの説明が一般的かという統計的規則を身につけているにすぎません。
米CIOの解説でも、知識を覚えているように見えるのは「その話題にこういう言い回しが続く」というパターンを大量に学んだ結果だと説明されています(CIO・次トークン予測の本質)。
だからこそ、後述するLLMO(大規模言語モデル最適化)では、AIが「確率的に選びやすい=引用しやすい」言い回し・構造でコンテンツを整えることが効きます。
どんなモデルがLLMなのか(具体例で確認)
身近な生成AIサービスは、ほぼすべてLLMを土台にしています。
OpenAIのChatGPT(GPTシリーズ)、AnthropicのClaude、GoogleのGeminiが代表例で、いずれも「次トークン予測」という同じ原理の上に、独自の学習データと調整を重ねています。
重要なのは、これらが「検索エンジン」ではなく「言語モデル」だという点です。検索エンジンがWebページを順位付けして返すのに対し、LLMは学習した分布から文章を組み立てて返します。
この性質の違いが、後で触れるハルシネーションやRAG(検索拡張生成)の必要性につながっていきます。
代表例のClaudeで引用されるための設定と条件は、Claude対策と3つのClaudeBot設定で整理しています。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
LLMが文章を生成する4ステップ
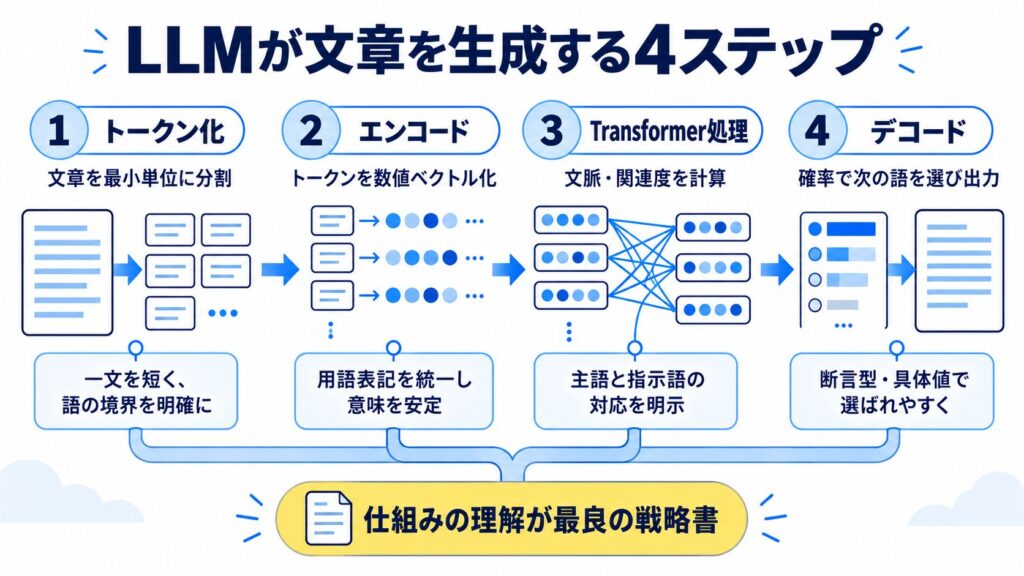
LLMは大きく4ステップで文章を生成します。
トークン化(文章を最小単位に分割)、エンコード(トークンをベクトル=数値に変換)、モデル処理(Transformerで文脈を反映)、デコード(数値を自然なテキストに変換)です。
この各段階を理解すると、AIがコンテンツをどう「読む」かが見え、なぜ特定の書き方がLLMOで効くのかという理由まで腑に落ちます。
ステップ1・2:トークン化とエンコード
まずトークン化です。LLMは文章をそのまま処理できないため、「単語」や「サブワード」に分割し、トークンという最小単位にします。
たとえば「生成AIは便利です」は「生成」「AI」「は」「便利」「です」のようなトークン列になります(分割の単位はモデルごとに異なります)。
次にエンコードで、各トークンをベクトル(数値の並び)に変換します。似た意味の単語はベクトル空間上で近い位置に配置され、「犬」と「猫」は近く、「犬」と「飛行機」は遠くなります。
さらに語順を表す位置情報も加え、文脈理解の土台を作ります。
日本語は英語より1単語あたりのトークン数が多くなりやすく、同じ内容でも消費トークンが増える点は実務上も覚えておくと役立ちます。
AIは文字でなく「数値」で読んでいます
ステップ3:Transformer処理(頭脳)
3つ目がTransformer処理です。エンコードで得た入力ベクトル列が、より文脈を反映したベクトル列へと変換されます。
Transformerは「どの言葉が大事か」「どの言葉と関係があるか」を計算する頭脳のような存在です。
中核となる「Attention(注意)」の働きにより、文章の中で今どの単語に注目すべきかを自動で判断します。
たとえば「それは便利だ」という文の「それ」が直前のどの名詞を指すかを、関連度の計算で特定できます。この文脈理解こそがLLMの核心技術で、次のH2で詳しく掘り下げます。
ステップ4:デコード(テキスト出力)
最後がデコードです。ニューラルネットワークが処理した数値データを、人間が読める自然なテキストに戻します。
LLMは「次に来る確率が最も高い単語」を選び、それを次の入力に加えて、また次の単語を選ぶ。この操作を1トークンずつ繰り返して文章を生成します。
この確率的な選択が、出力に多様性をもたらす一方で、後述するハルシネーション(誤情報生成)の温床にもなります。
同じ質問に毎回まったく同じ回答が返らないのも、温度(temperature)などの設定で確率分布から語を選ぶ仕組みによるものです。
この4ステップを理解すると、LLMO施策が「腑に落ち」ます。
なぜ結論ファーストが効くのか、なぜ固有名詞や数値が引用されやすいのか——AIがトークン単位で文脈を計算し、確率で次の語を選ぶ仕組みを知ると、「曖昧な表現はAIが選びにくい」という当たり前の結論に行き着きます。
仕組みは、最良の戦略書です。結論ファーストを記事で実践する文型は、結論ファーストでAI引用される記事の書き方もあわせて確認しておきたいところです。
仕組みの理解が最良の戦略書
置き土産:4ステップ早見表(保存版)
4ステップは言葉だけだと忘れがちなので、各段階で「何が起き」「実務で何が示唆されるか」を1枚に圧縮しました。コンテンツ制作の前にこの表を見返すと、書き方の判断がぶれません。
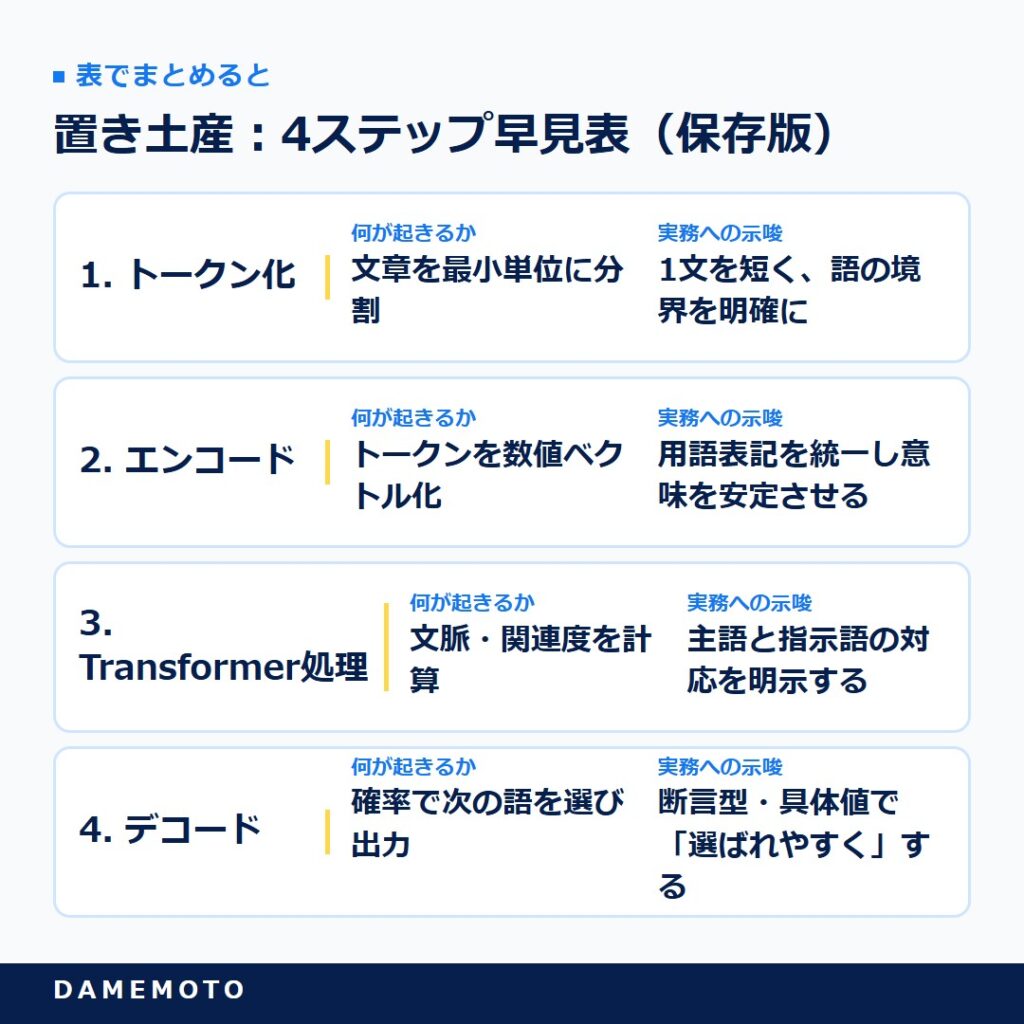
表で詳しく見る
| ステップ | 何が起きるか | 実務への示唆 |
|---|---|---|
| 1. トークン化 | 文章を最小単位に分割 | 1文を短く、語の境界を明確に |
| 2. エンコード | トークンを数値ベクトル化 | 用語表記を統一し意味を安定させる |
| 3. Transformer処理 | 文脈・関連度を計算 | 主語と指示語の対応を明示する |
| 4. デコード | 確率で次の語を選び出力 | 断言型・具体値で「選ばれやすく」する |
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
Transformerとattention:文脈を読む心臓部
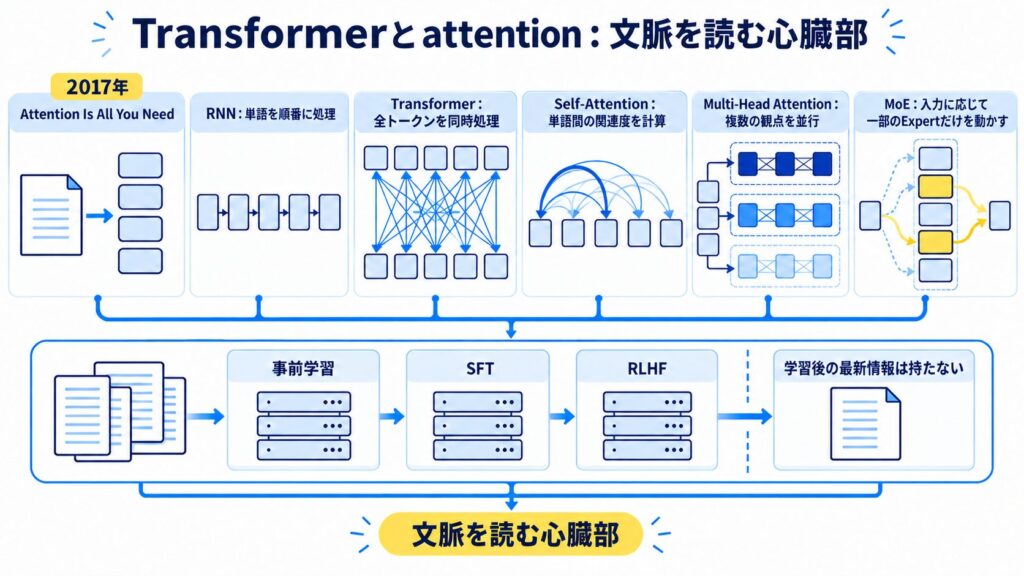
LLMの性能を支えるのは、2017年の論文「Attention Is All You Need」で登場したTransformerです。
最大の革新はSelf-Attention(自己注意)機構で、各トークンが文中の他のすべてのトークンとの関連度を計算し、文脈に応じて重要な情報に「注意」を向けます。
これにより、単語の表面的な意味だけでなく、文脈に応じたニュアンスまで捉えられるようになりました。
論文「Attention Is All You Need」が変えたこと
Transformerは、Googleの研究者Ashish Vaswaniらが2017年にNeurIPS(旧NIPS)で発表した論文で提案されました(NeurIPS・Attention Is All You Need原論文)。
それ以前の主流だったRNN(再帰型ニューラルネットワーク)は単語を順番に処理するため学習が遅く、長い文脈を保持しにくいという弱点がありました。
Transformerは再帰や畳み込みを使わず、Attentionだけで全トークンを同時に処理できるため、学習・推論が大幅に高速化しました。
この論文は、現在のGPT・BERT・Geminiなど、ほぼすべての主要モデルの共通基盤になっています。
Self-Attentionが「文脈」を読む仕組み
Self-Attentionは、文中のすべての単語間の関連性の強さを数値化し、文脈理解に重要な単語を動的に特定します。
AI Heartlandの解説では、「彼女は銀行の川岸で釣りをしていた」という文で「銀行(bank)」を「金融機関」ではなく「川の岸」と解釈できるのは、Self-Attentionが「川岸」「釣り」との関連度を高く計算するためだと説明されています(AI HeartlandのLLM完全ガイド)。
同じ単語でも周囲の語に応じて意味を切り替えられるこの能力が、Transformerを従来モデルと一線を画す要因です。
複数の観点を並行して計算するMulti-Head Attentionにより、文法・意味・指示関係など異なる側面を同時に捉えられる点も特徴です。
同じ「bank」でも文脈で意味が変わる、ここが肝
2026年の主流アーキテクチャ「MoE」
2026年のフロンティアモデルの多くは、Transformerを発展させたMoE(Mixture-of-Experts/混合エキスパート)を採用しています。
これは、モデル内部に複数の「専門家(Expert)」を持ち、ルーターが入力に応じて一部のExpertだけを動かす仕組みです。
推論時にアクティブ化するのは全パラメータの一部に絞られるため、「知識量は巨大だが計算コストは抑える」という効率を実現します。
総パラメータが1兆級でも、1トークンの計算で動くのはその数%、というモデル構成が一般的になりつつあります。
結果として「パラメータ数=計算コスト」という古い図式は当てはまらなくなりました。
※個別モデルの正確なアクティブパラメータ比率は公表値が限られ、ここでは一般傾向として記載しています(特定モデルの数値は未確認)。
学習の3段階:事前学習→SFT→RLHF
ChatGPTのようなモデルの学習は、大きく3段階で進みます。
事前学習(膨大なデータで言語の基礎を獲得)、ファインチューニング/SFT(特定タスクや指示への追従を追加学習)、RLHF(人間のフィードバックによる強化学習で対話性能と安全性を向上)です。
ここで決定的に重要なのは、事前学習を終えたモデルは「その時点までの知識」しか持たないという点です。学習後に起きた出来事や、最新の統計・料金は、モデル内部には存在しません。
この知識の鮮度の限界を補うのが、次のH2で扱うRAG(検索拡張生成)です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
LLMの限界:ハルシネーションとRAGによる対策
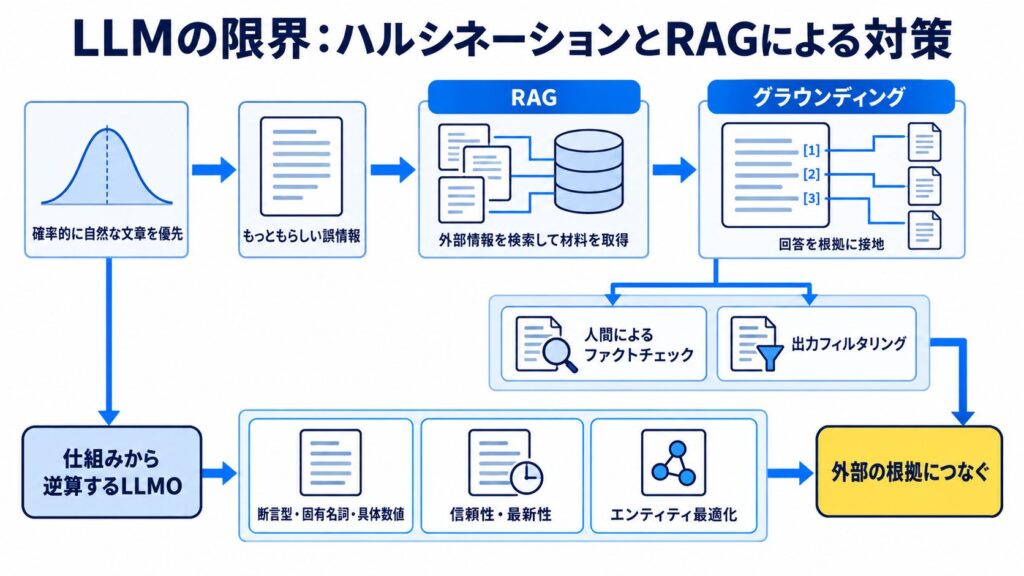
LLMの最大の限界がハルシネーション(誤情報生成)です。確率的に次の単語を選ぶ仕組みゆえ、学習データに少ない領域では、誤った内容を自信たっぷりに出力してしまいます。
主な対策はRAG(検索拡張生成)の活用、人間によるファクトチェック、出力フィルタリングの3つ。
LLMの出力は「下書き・参考情報」として扱い、重要な判断には人間が確認するのが基本です。
なぜハルシネーションが起きるのか
ハルシネーションとは、LLMが事実と異なる情報や文脈に合わない内容を、もっともらしく生成してしまう現象です。
富士フイルムビジネスイノベーションの解説では、生成AIは「次に来る確率が最も高い単語」を予測しながら文章を作るため、情報の正確性よりも文脈としての自然さが優先され、結果としてもっともらしい嘘が生まれると整理されています(富士フイルム・ハルシネーション解説)。
学習データに含まれない情報やデータが薄い領域ほど、この傾向は強まります。
情報処理推進機構(IPA)の「テキスト生成AI 導入・運用ガイドライン」(2024年)でも、対策としてRAGの活用・人間によるファクトチェック体制・出力フィルタリングが挙げられています。
AIは「自信満々に間違える」性質があるため、年号・統計・法令名は一次ソースでの再確認が欠かせません。
DAMEMOTO代表鈴木AIは「知らない」と言わず、堂々と間違えます
RAG(検索拡張生成)がLLMOの鍵
RAG(Retrieval-Augmented Generation/検索拡張生成)は、AIが回答を生成する前に外部のデータベースやWebから関連情報を検索し、その内容を踏まえて回答を作る仕組みです。
日立ソリューションズ・クリエイトの解説でも、回答前に外部の信頼できる情報源を参照することで、ゼロから創作する場合に比べてハルシネーションのリスクを大幅に低減できると整理されています(日立ソリューションズ・クリエイトのRAG解説)。
LLMOにとってRAGは特に重要で、Google AI Overviews・ChatGPT検索・PerplexityはいずれもRAG型で外部サイトを参照し、回答に引用します。
つまり、RAGで参照されやすいコンテンツ(信頼性が高く、構造が明確で、最新)を整えることが、引用獲得に直結します。
取得されたページが引用まで届かない理由は、RAGとLLMOの関係を読むと腑に落ちるはずです。
グラウンディング:回答を「根拠」につなぐ
RAGと近い概念にグラウンディング(grounding)があります。
これは、LLMの回答を検索結果や指定の知識ソースといった「外部の根拠」に接地させ、確率だけで生成させないようにする考え方です。
たとえばGeminiはGoogle検索の結果にグラウンディングして回答を補強し、出典を示します。
RAGが「検索して材料を取ってくる」工程に重きを置くのに対し、グラウンディングは「その材料に回答を縛りつけ、根拠を明示する」発想だと捉えると区別しやすいでしょう。
いずれも、LLM単体の弱点である鮮度と正確性を、外部情報で補うための仕組みです。
書き手側から見れば、「根拠として引かれやすい一次情報・明確な事実」を用意することが、そのまま露出につながります。
仕組みから逆算するLLMO
ここまでの仕組みを踏まえると、LLMO施策は逆算で導けます。確率的に「引用しやすい」テキストを狙うなら、断言型・固有名詞・具体数値が効きます。
RAGやグラウンディングで参照されるなら、信頼性と最新性が効きます。学習データのレベルで定着を狙うなら、ブランド名を文脈とともに繰り返し示すエンティティ最適化が効きます。
「要するに○○です」「○○とは〜のことです」という言い切りの一文が、AIに最も引用されやすい形のひとつです。
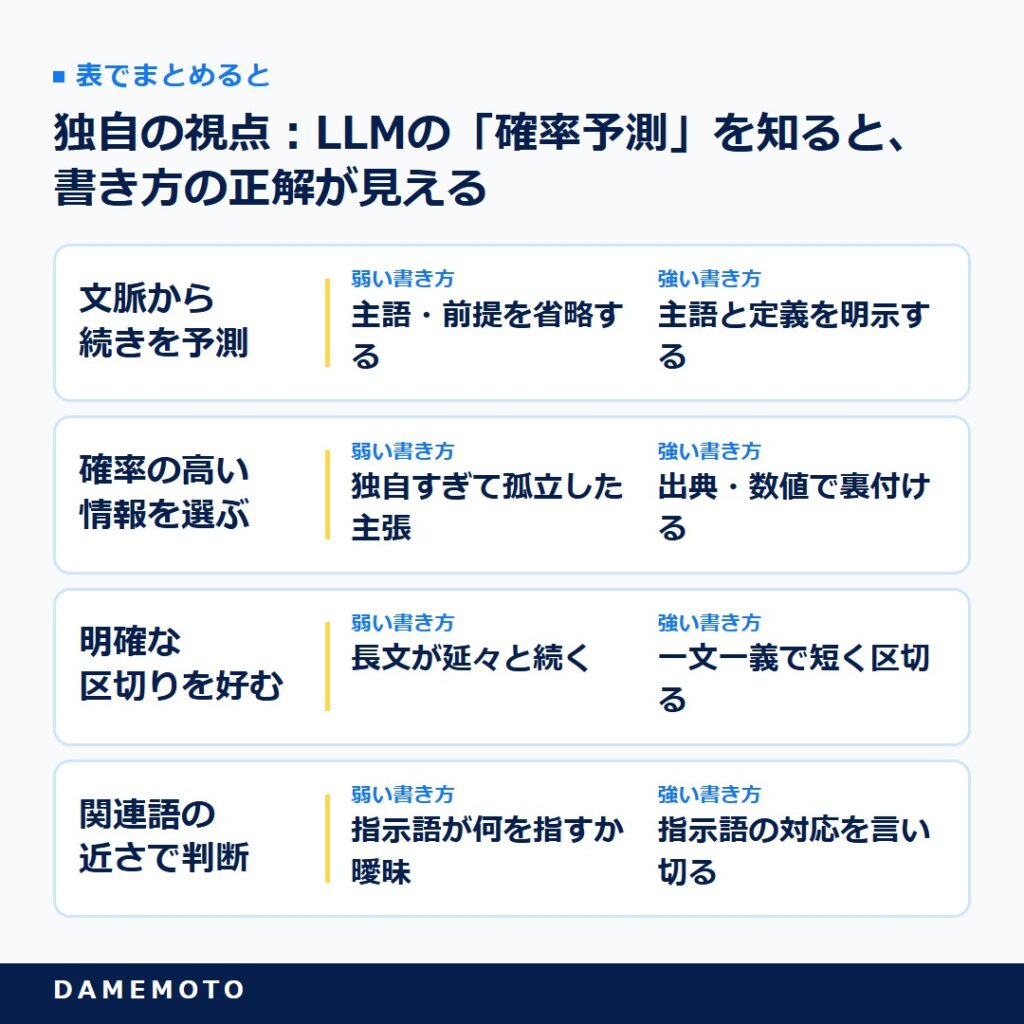
独自の視点:LLMの「確率予測」を知ると、書き方の正解が見える
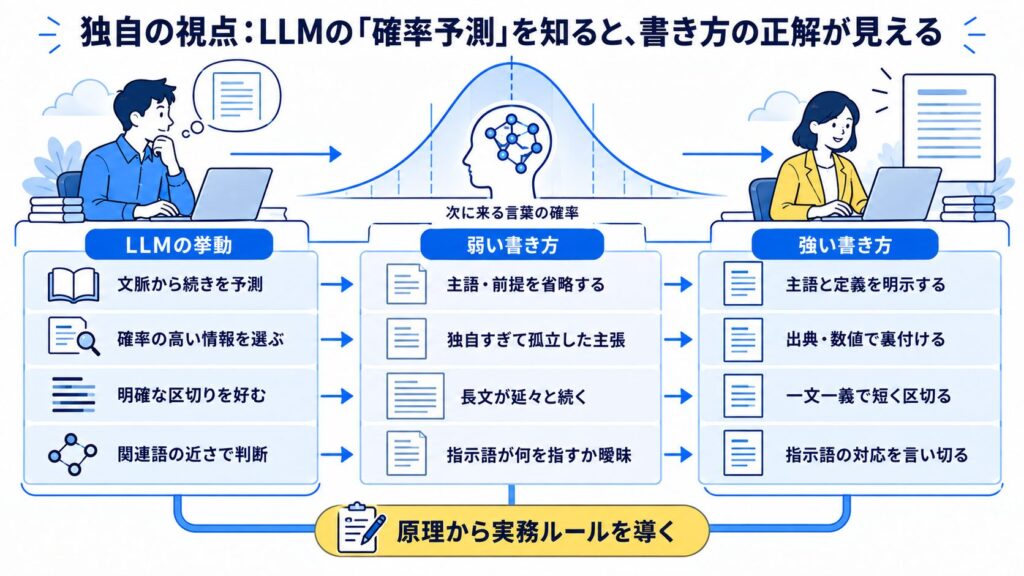
LLMが「次の単語を確率的に予測する」仕組みだと分かると、なぜ“曖昧な文”がAIに弱いかが腑に落ちます。
AIは文脈から最も確率の高い続きを選ぶため、主語が省略され前提が曖昧な文は、誤って解釈されたり、そもそも拾われにくくなったりします。
逆に言えば、仕組みから逆算すれば書き方の正解が導けるということです。下表は、LLMの挙動と「弱い書き方/強い書き方」の対応を編集視点で整理したものです。
表で詳しく見る
| LLMの挙動 | 弱い書き方 | 強い書き方 |
|---|---|---|
| 文脈から続きを予測 | 主語・前提を省略する | 主語と定義を明示する |
| 確率の高い情報を選ぶ | 独自すぎて孤立した主張 | 出典・数値で裏付ける |
| 明確な区切りを好む | 長文が延々と続く | 一文一義で短く区切る |
| 関連語の近さで判断 | 指示語が何を指すか曖昧 | 指示語の対応を言い切る |
見落としがちなのは、仕組みの理解を“教養”で終わらせてしまうことです。
LLMが確率予測であるという事実は、そのまま「主語を省くな」「定義を添えろ」「一文を短く」という実務ルールに翻訳できます。
仕組みを学ぶ目的は知識自慢ではなく、AIに誤読されない文章を書くため。原理から書き方を導ければ、流行りのテクニックに振り回されずに済みます。
この書き方の原則をAI別の実装まで落とし込むなら、LLMO対策の完全ガイドが次の一歩になります。
正直コーナー:この記事で「分かること」と「分からないこと」
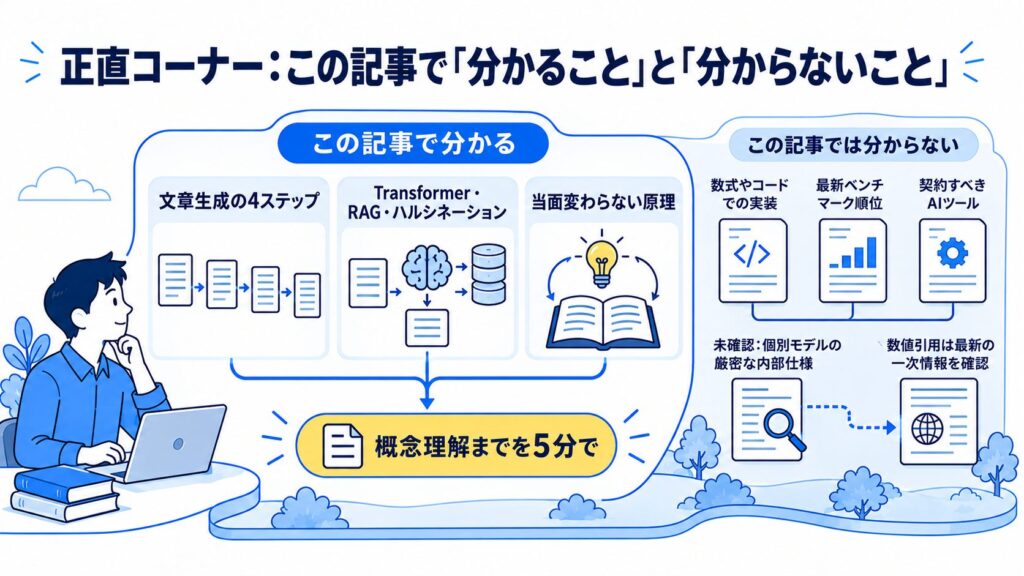
本記事は初学者がLLMの全体像を5分でつかむことを狙ったものです。だからこそ、扱える範囲には正直に線を引いておきます。次に当てはまる方には、本記事だけでは物足りないはずです。
- 数式やコードでTransformerを実装したい開発者(本記事は概念理解までで、行列演算には踏み込みません)
- 各モデルの最新ベンチマーク順位を比較したい方(性能ランキングは変動が激しく、本記事では追いません)
- 「どのAIツールを契約すべきか」を今すぐ決めたい方(料金・機能比較は別記事の領域です)
また、正直に補足すると、本記事の数値の一部には不確実性があります。
MoEのアクティブパラメータ比率や2026年時点の最大パラメータ規模は、公式公表が限られるため一般傾向として記しており、特定モデルの厳密な内部仕様は未確認です。
仕組みの理解には影響しませんが、数値をそのまま引用する際は最新の一次情報をご確認ください。
逆に、本記事で「確実に役立つ」のは、4ステップとTransformer・RAG・ハルシネーションという、当面変わらない原理の理解です。
土台が変わらないからこそ、ここを押さえる価値があります。
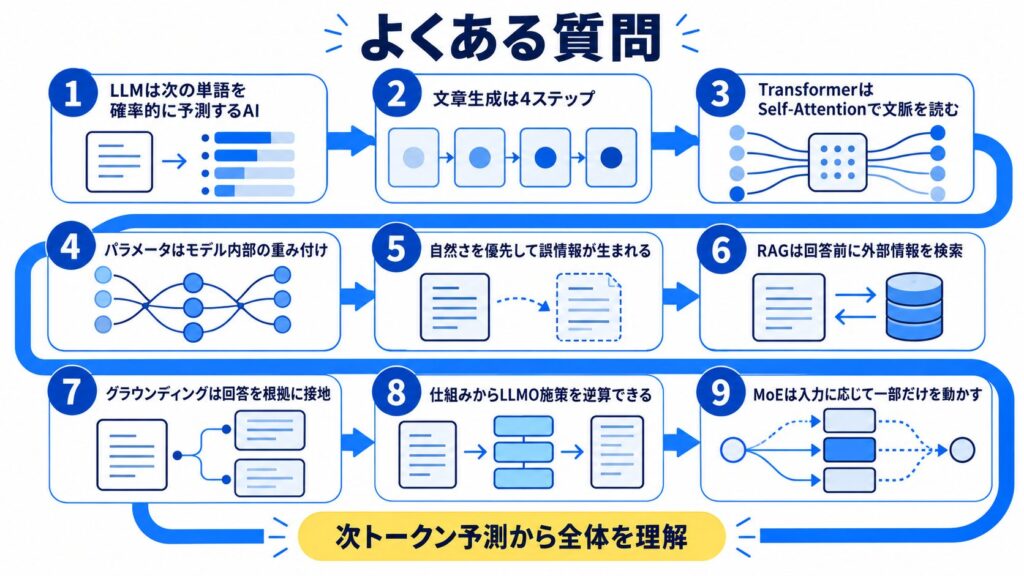
よくある質問
- LLMとは何ですか?
-
大規模言語モデルの略で、膨大なテキストを学習し次の単語を確率的に予測するAIです。ChatGPT・Claude・Geminiの共通の基盤技術です。
- LLMはどうやって文章を作るのですか?
-
トークン化→エンコード→Transformer処理→デコードの4ステップです。最も確率の高い単語を1つずつ選び、つなげて文章を組み立てます。同じ質問でも回答が毎回少し変わるのは、確率分布から語を選ぶためです。
- LLMの中核技術Transformerとは何ですか?
-
2017年の論文「Attention Is All You Need」で発表されたLLMの中核技術です。Self-Attention機構によって文中のどの単語に注目すべきかを判断し、文脈を読み解きます。
- LLMのパラメータとは何ですか?多いほど良いのですか?
-
モデル内部の重み付けの数値で、GPT-3は約1,750億個です。多いほど複雑なパターンを捉えやすくなりますが、2026年はMoEのように「総数は巨大でも一部だけ動かす」効率型が主流で、単純な多さだけでは性能を測れません。
- なぜLLMは平気で嘘をつくのですか?
-
確率的に次の単語を選ぶ仕組みのため、正確さより文章の自然さが優先されることがあるからです。データの少ない領域では誤りを自信たっぷりに出力します。これがハルシネーションです。
- LLMの弱点を補うRAGとは何ですか?
-
検索拡張生成の略です。AIが回答前に外部のデータベースやWebを検索し、その情報を踏まえて回答を作る仕組みで、古い知識を補い誤情報を抑制します。
- LLMにおけるグラウンディングとRAGはどう違いますか?
-
RAGは「検索して材料を取ってくる」工程、グラウンディングは「その材料に回答を接地させ根拠を示す」発想です。重なる部分も多く、どちらもLLM単体の鮮度・正確性の弱点を外部情報で補います。
- LLMの仕組みを知るとLLMO対策に役立ちますか?
-
役立ちます。確率予測という原理から、断言型・固有名詞・具体数値・最新性が引用されやすいことが逆算でき、小手先のテクニックに頼らず施策の理由が腑に落ちます。
- 最近のLLMで主流のMoEとは何ですか?
-
Mixture-of-Experts(混合エキスパート)の略で、2026年の主流アーキテクチャです。内部に複数の専門家を持ち、入力に応じて一部だけを動かすことで、知識量を保ちながら計算コストを抑えます。
まとめ:LLMは「次トークン予測」、仕組みがLLMOの土台
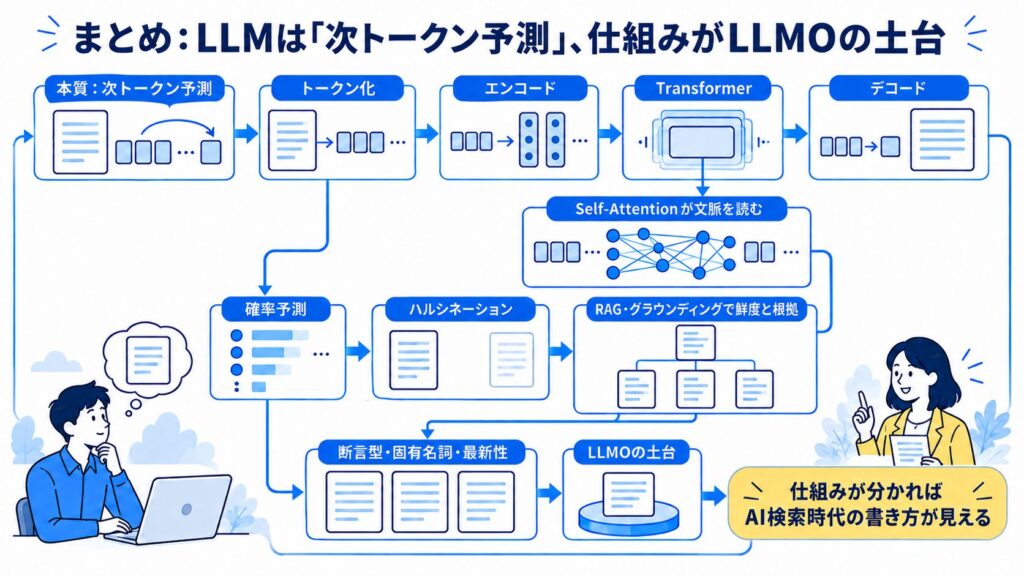
LLMは膨大なテキストを学習し、次のトークンを確率的に予測するAIです。
文章生成はトークン化→エンコード→Transformer→デコードの4ステップで進み、Self-Attentionが文脈を読みます。
確率的に語を選ぶ仕組みゆえにハルシネーションが起き、RAGやグラウンディングで最新情報と根拠を補います。
この原理を5分で押さえることが、断言型・固有名詞・最新性が効くLLMOの土台になります。仕組みが分かれば、AI検索時代の書き方は怖くありません。
- 本質は次トークン予測の4ステップ
- 心臓部はTransformer/Attention
- RAG・グラウンディングと仕組み理解がLLMOの鍵
参考URL一覧
- OpenAI/arXiv・Language Models are Few-Shot Learners(GPT-3論文):https://arxiv.org/abs/2005.14165
- NeurIPS・Attention Is All You Need(Transformer原論文):https://papers.neurips.cc/paper/7181-attention-is-all-you-need.pdf
- 富士フイルムビジネスイノベーション・ハルシネーションとは:https://www.fujifilm.com/fb/solution/dx_column/ai/about-ai-hallucinations
- 日立ソリューションズ・クリエイト・RAG(検索拡張生成)とは:https://www.hitachi-solutions-create.co.jp/column/technology/rag.html
- JAPAN AIラボ・ChatGPTの仕組みとは:https://japan-ai.co.jp/media/5710
- AI Heartland・LLMとは 仕組み・主要モデル比較:https://ai-heartland.com/explain/llm-complete-guide-2026
- CIO・次トークン予測の本質:https://www.cio.com/article/4112842/