LLMO(大規模言語モデル最適化)とは、ChatGPT・Gemini・Claude・Perplexity・CopilotなどのAIに自社情報を引用・推薦させる最適化施策の総称です。
結論として、LLMOはSEOの代替ではなく拡張です。
「事実密度の高いコンテンツ」「Article/FAQ/Organization構造化」「第三者からの言及(サイテーション)」の3点をSEO基盤に上乗せし、まず顧客が最も使う1プラットフォームの土台(Bing or Google)を固めるのが、規模に関係なく勝てる王道です。本記事はその全手法を一次情報で体系化します。
この記事の結論
LLMOはSEOの拡張で、事実密度・構造化・サイテーションの3点を上乗せするのが王道と考えています
今日からやること
- 主要AIで自社名を検索し、言及と誤情報を確かめる
- アクセス上位の記事から結論ファーストに直す
- 社名・サービス名の表記を全チャネルで統一する
こんな人向け:ChatGPTやGeminiの回答に自社を登場させたいWeb担当者・マーケターの方数値の出典:OpenAI発表(eWEEK報道、2026年2月27日)、Google公式ブログ「I/O 2026」
LLMO対策とは:AIに引用・推薦させる全手法の総称
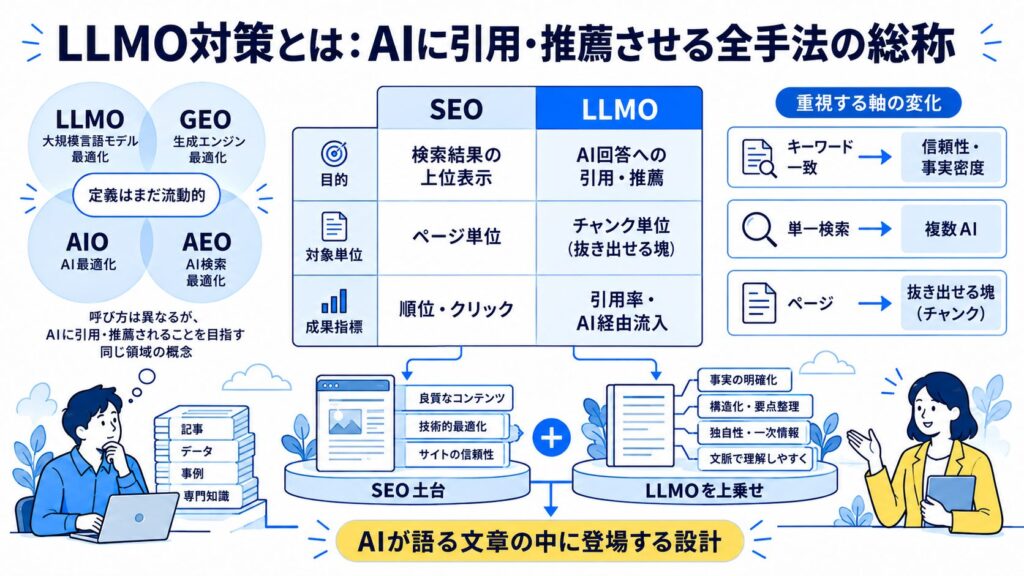
LLMO(Large Language Model Optimization)とは、ChatGPT・Gemini・Claude・Perplexity・Copilotなどの大規模言語モデルが回答を生成するときに、自社コンテンツを引用ソースや推薦先として選ばせるための最適化です。
SEOが「検索結果での上位表示」をゴールにするのに対し、LLMOは「AIの回答そのものに登場すること」を目指します。
検索結果の青いリンクではなく、AIが語る文章の中に自社が織り込まれるかどうか、という戦いです。
 DAMEMOTO代表鈴木
順位より「AIが何と言うか」の時代です
定義はまだ確定していない(GEO・AIO・AEOとの関係)
最初に正直に書くと、LLMOの定義は業界で確定していません。
同じ概念を、ある会社はGEO(Generative Engine Optimization=生成エンジン最適化)、別の会社はAIO(AI Optimization)、また別の会社はAEO(Answer Engine Optimization=回答エンジン最適化)と呼びます。
Web制作会社ベイジは「この用語の不統一さがまだ黎明期であることを物語っている」と述べ、自社ガイドではLLMOで統一しています(ベイジのLLMO/AIO入門)。
本記事も大規模言語モデル全般を対象とする最適化を広くLLMOと呼びます。4つの用語の違いと統合の考え方は、AIO・LLMO・GEO・AEOの違いと統合戦略で一枚に整理しています。
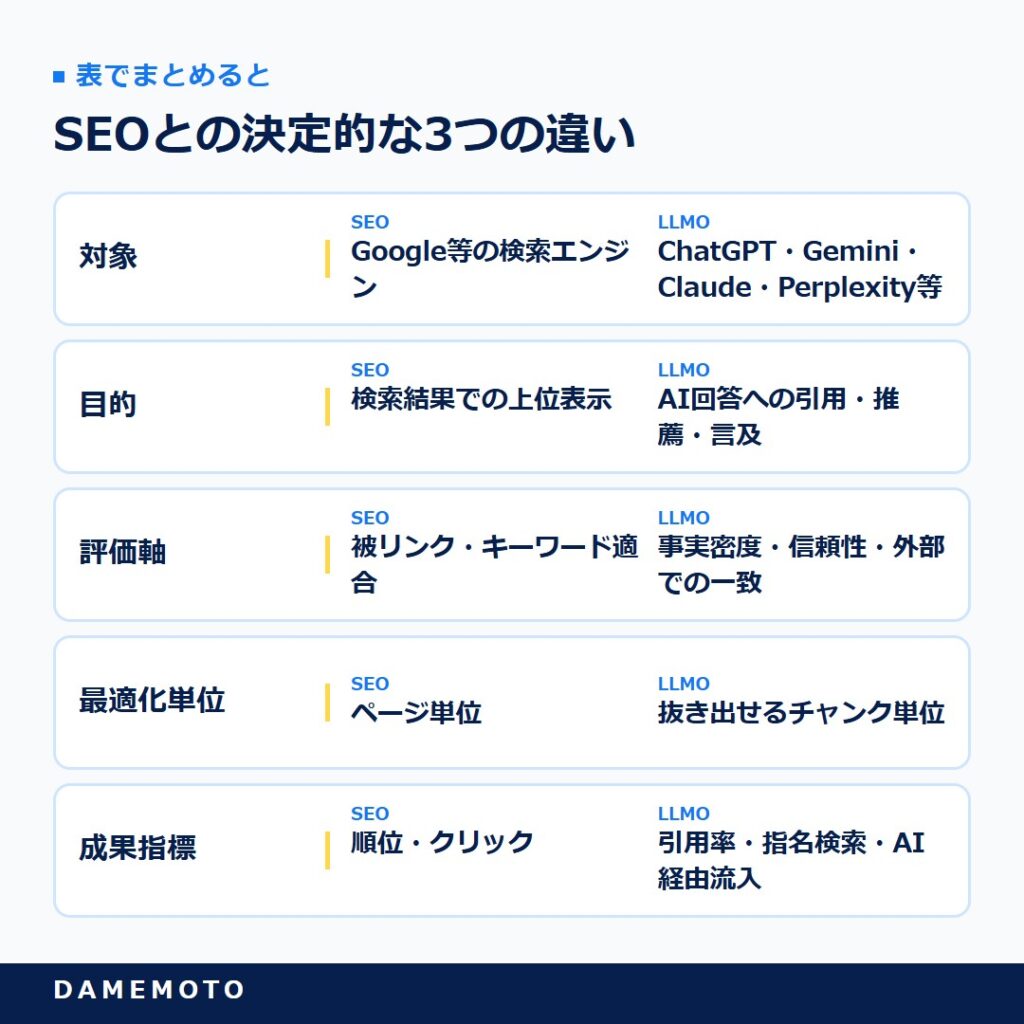
SEOとの決定的な3つの違い
LLMOはSEOと3点で性質が異なります。第1に評価軸が「キーワードの一致」から「引用に値する信頼性・事実密度」へ移ること。
第2に対象が単一の検索エンジンから複数のAIプラットフォームへ広がり、各社が異なる仕組みで引用を判定すること。
第3に最適化の単位がページから「抜き出せるコンテンツの塊(チャンク)」へ細分化されることです。下表は両者の力点の違いを整理したものです。
表で詳しく見る
| 観点 | SEO | LLMO |
|---|---|---|
| 対象 | Google等の検索エンジン | ChatGPT・Gemini・Claude・Perplexity等 |
| 目的 | 検索結果での上位表示 | AI回答への引用・推薦・言及 |
| 評価軸 | 被リンク・キーワード適合 | 事実密度・信頼性・外部での一致 |
| 最適化単位 | ページ単位 | 抜き出せるチャンク単位 |
| 成果指標 | 順位・クリック | 引用率・指名検索・AI経由流入 |
SEOが土台、LLMOが上乗せ
LLMOはSEOの代替ではなく拡張です。
ベイジは、SEOの土台(クローラビリティ・技術的健全性・E-E-A-T)を維持しながら、LLMOならではの追加施策(チャンクを意識したコピー・構造化データの厳密化・AIクローラー最適化・外部での言及設計)を上乗せする感覚が近い、と整理しています。
実際、Googleは2026年5月15日公開の公式「生成AI最適化ガイド」で「生成AI検索への最適化も、本質はSEOである」と明言しました(Google検索セントラル公式ガイド)。
AIが引用判断に使う材料の多くは、Googlebotがクロールしたインデックス・構造化データ・E-E-A-Tです。SEOの基礎がないサイトは、AIにも掲載されにくくなります。
土台が無い家に内装だけ足しても住めません
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
LLMの仕組みとLLMOの3つの情報経路
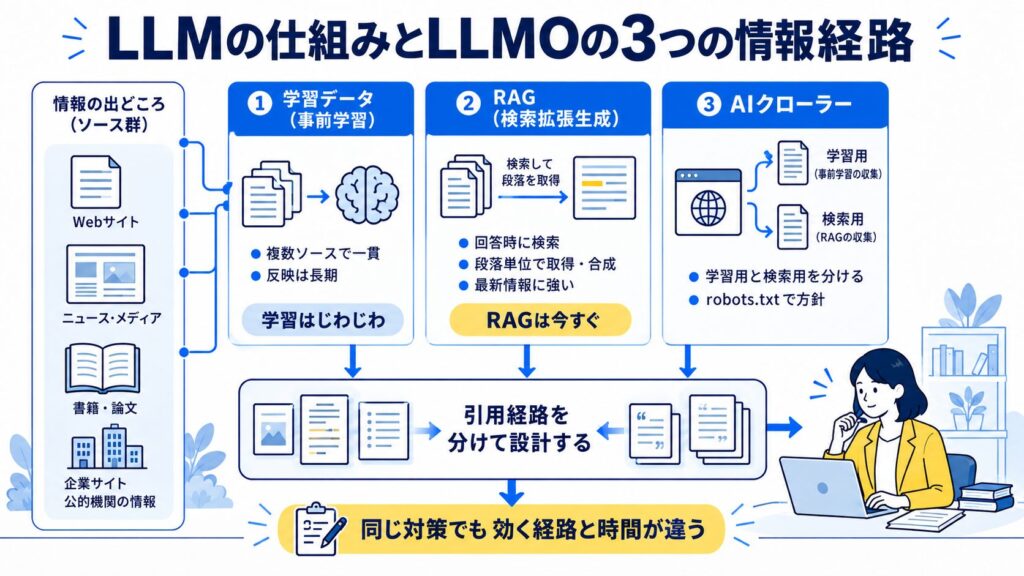
LLMOを正しく設計するには、AIがどこから情報を得ているかを理解する必要があります。経路は大きく3つ、「学習データ」「RAG(検索拡張生成)」「AIクローラー」です。
「AIに引用されたい」という相談の多くは、この3経路の区別がついていないことに原因があります。それぞれ動くボットも、効くまでの時間も違います。
3つの経路の土台になる仕組みは、LLMの仕組み4ステップで5分ほどで押さえられます。
経路1:学習データ(事前学習)
第1の経路は、モデルの事前学習時に取り込まれる情報です。膨大なWebテキストを学習する過程で、頻出し、複数の独立ソースで一貫して言及されている事実ほど強く定着します。
ここへの反映には時間がかかり、即効性はありません。逆に言えば、一度「○○といえばこの会社」という関連がモデルの重みに刻まれれば、検索を介さずとも回答に登場しやすくなります。
学習データへの定着は長期戦であり、短期施策とは切り分けて考えるべき領域です。
経路2:RAG(検索拡張生成)とグラウンディング
第2の経路はRAG(Retrieval-Augmented Generation=検索拡張生成)です。
AIが回答時にリアルタイムで検索を実行し、取得したページの内容を根拠(グラウンディング)として回答を組み立てる仕組みを指します。
Google公式の解説によれば、AI OverviewsとAIモードは「クエリファンアウト」で1つの質問を複数のサブクエリに分解し、検索インデックスから段落(パッセージ)単位で抽出・合成します。
複雑な質問ほど多様なサイトが引用されます。RAGは最新情報を即座に反映できるため、LLMOで最も即効性のある経路です。
RAGは「今すぐ効く」、学習は「じわじわ効く」
経路3:AIクローラー(GPTBot/ClaudeBot等)
第3の経路は、各社のAIクローラーによる巡回です。
学習用とリアルタイム検索用でボットが分かれているのが2026年時点の特徴で、OpenAIは学習用のGPTBot・リアルタイム検索用のOAI-SearchBot・ユーザー起点のブラウジング用ChatGPT-Userを使い分けています(Botifyの70億件超ログ分析)。
AnthropicはClaudeBot・Claude-SearchBot、GoogleはGemini学習用のGoogle-Extended、PerplexityはPerplexityBotを運用します。
どのボットを許可し、どれを拒否するかをrobots.txtで設計するのがLLMOの技術的な土台です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
なぜ今LLMO対策が重要か:利用者数で見る地殻変動
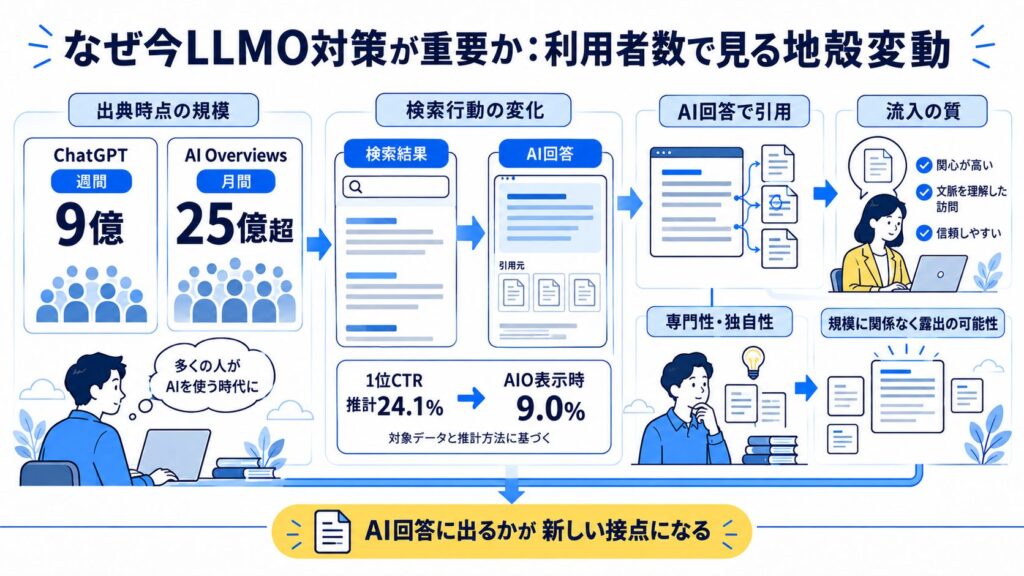
LLMOが急務になった理由は、ユーザーの情報探索がAIへ大きく移行したことです。利用者数の規模を一次・準一次ソースで押さえると、対策の緊急度が見えてきます。具体的な数字を3点に絞って確認します。
ChatGPT9億・AI Overviews25億という規模
OpenAIは2026年2月27日、ChatGPTの週間アクティブユーザーが9億を突破したと公表しました(Search Engine Landの報道)。
2025年10月時点の8億、2025年2月の4億から急拡大しています。
GoogleもI/O 2026(5月)で、AI Overviewsの月間アクティブユーザーが25億超、AIモードが1年で10億超に達したと発表しました(Google公式ブログ I/O 2026)。
検索の入口がAIに置き換わりつつある以上、AIに引用されないことは「存在しないに等しい」状況へ近づいています。
利用者の急増を踏まえた取り組む理由は、LLMOとは何かと今すぐ取り組むべき5つの理由で整理しています。
ゼロクリック化とAI経由流入の質
Ahrefsが2026年7月に公開した日本向け分析では、2026年6月時点の情報収集型キーワードで、1位のCTRはAIOがなければ得られたと予測される24.1%に対し、AIO表示時の実測は9.0%でした。
約62.7%という差は対象データと推計方法に基づくもので、日本の全検索の実測減少率ではありません。また、AI回答の表示と外部サイトへのクリックは別の指標です。
対象と定義が異なるゼロクリック率を自社の予測値として使わないでください。一方で、AI回答内に引用されたブランドは約35%多くクリックを獲得しています。
さらに複数レポートでは、AI経由の流入は通常の自然検索流入の約2倍のコンバージョン率を示すとされ(MediaPostによるStatcounter分析報道)、「量は減るが質は高い」流入へ構造が変わっています。
DAMEMOTO代表鈴木「出ない=無い」に近づいているんです
規模に関係なく露出できる先行者利益
SEOではドメインの力が強い大企業が有利になりがちですが、AI検索は情報の専門性や独自性を比較的フラットに評価します。
良質で固有性の高い情報を発信していれば、中小企業でもAIの回答元として単独で引用される可能性があります。
S&Eパートナーズも「会社規模に関係なく露出できる」をLLMOのメリットに挙げています(S&EパートナーズのLLMO解説)。
取り組む企業がまだ少ない今は、先行者利益を得やすい局面です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
LLMO対策の3つの核心アプローチ
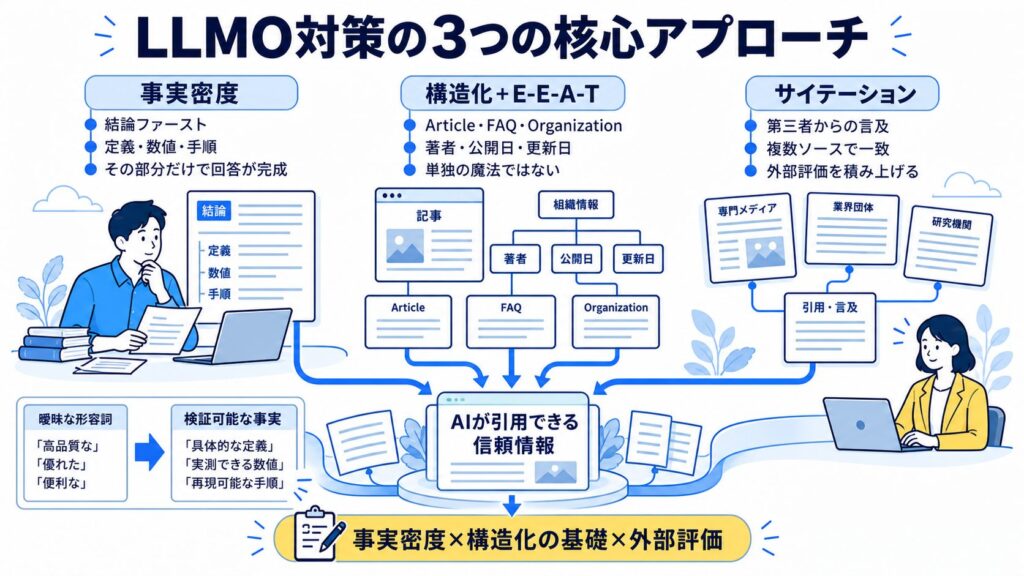
個別プラットフォームの話に入る前に、すべてに共通する核心を押さえます。LLMOは突き詰めると3つに集約されます。
事実密度の高いコンテンツ設計、構造化データとE-E-A-T、第三者からのサイテーション(外部評価)です。順に、なぜ効くのかと具体策を見ていきます。
核心1:事実密度の高いコンテンツ設計
AIに引用されるコンテンツは「その部分だけ抜き出せば回答が完成する」自己完結型のブロックを含みます。冒頭で結論を述べ、定義・数値・手順を続ける即答形式が有効です。
「業界トップクラス」ではなく「導入社数3,500社」「LCPは2.5秒以内が合格目安」のように、検証可能な事実の密度(事実密度)を高めることが核心です。
曖昧な形容詞をやめて固有名詞・数値・日付に置き換えるだけでも、AIが「引用できる事実」と判断する確率は上がります。
核心2:構造化データとE-E-A-T(ただし過信しない)
Article・FAQ・Organizationなどの構造化データは、AIがコンテンツの意味を解釈するヒントになります。
著者・公開日・更新日を明記するArticle、よくある質問を明示するFAQ、運営者情報を束ねるOrganizationが基本セットです。ただし過信は禁物です。
Google公式ガイドは生成AIのために特殊なschemaは不要と述べ、Ahrefsの2026年5月調査(1,885ページ対象)でも「スキーマを追加しただけではAI引用は明確には増えなかった」と報告されています(シュワットによるAhrefs調査の整理)。
構造化データは「引用の前提条件を整える基礎施策」であり、単独の魔法のレバーではない、と位置づけるのが正確です。
schemaは効く。でも「足せば勝ち」ではない
核心3:サイテーション(外部での一致)の獲得
AIは「同じ情報が複数の独立した情報源で一貫して言及されている」とき、その情報を信頼に足ると判断する傾向があります。
自社サイトでいくら「業界No.1」と書いても、それは1ソースにすぎません。
業界メディア・比較サイト・専門家のブログ・SNSでの第三者言及・Wikipediaの記事に同じ情報が並んではじめて、AIは「複数ソースで一致する信頼情報」と判定します。
内部整備(構造化・見出し整理)はSEOで終わっている企業が多いため、本質的に露出を増やす最後の鍵は外部評価の獲得です。
外部での言及を増やす具体策は、サイテーション獲得の5つの方法もあわせて確認しておきたいところです。
主要プラットフォーム別の最適化要点(ChatGPT/Gemini/Claude/Perplexity/Copilot)
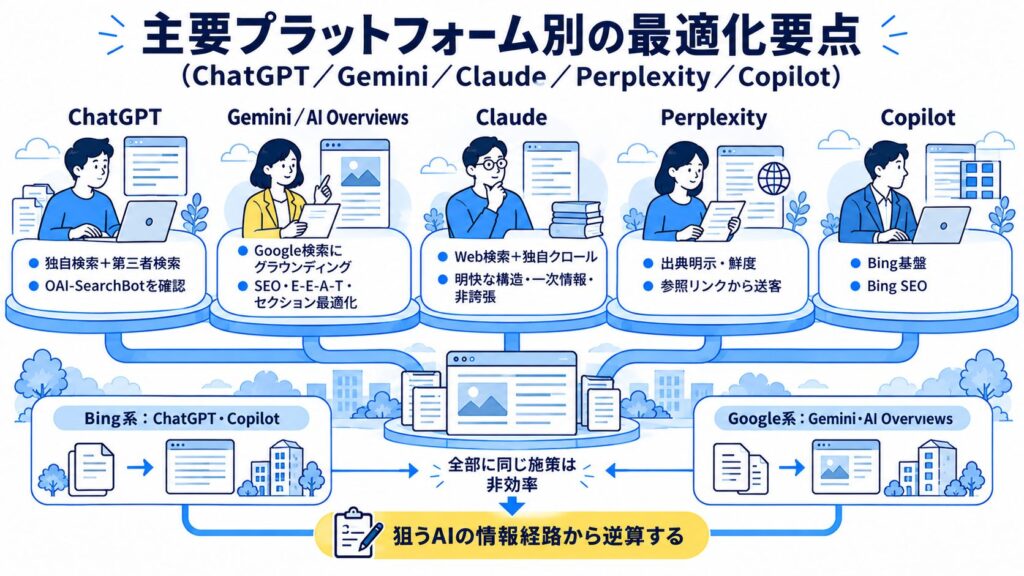
ここがLLMOの肝です。AIごとに情報の取り方が異なるため、「全部に同じ施策」は非効率になります。各プラットフォームの土台と最優先の打ち手を整理します。利用者数や仕様は流動的なため、本節の数値はいずれも出典時点のものです。
ChatGPT(独自クロール+外部の検索サービス)
ChatGPT検索は、独自の検索ボットと第三者検索サービスを利用します。
OpenAIは検索結果への掲載のためにOAI-SearchBotと公開されたIPからのアクセスを許可するよう案内しています。
Bing Webmaster Toolsへの登録自体は引用の必須条件ではありません。
ChatGPTで引用される条件をもう少し掘り下げるなら、ChatGPT SEOの5つの要件を読むと判断しやすくなるはずです。
Gemini/AI Overviews(Google検索にグラウンディング)
GeminiはGoogle検索を使ったグラウンディングで回答を組み立て、Google生態系(Search・Android・Workspace・Chrome)と深く連携します。
Google I/O 2026では、AIモードの既定モデルがGemini 3.5 Flashへ更新され、AI OverviewsからAIモードへ会話を継続できる統合も発表されました(Google公式ブログ)。
要点は「通常のGoogle SEOとE-E-A-Tを固めること」、そしてGeminiはページ全体が長くても単一のH2ブロックを引用できるため「セクション単位の最適化」が効くことです。
なお独立分析会社Statcounterによれば、Geminiは2026年3月にPerplexityを抜いてサイトへのAI参照流入第2位(8.65%)になりました。
DAMEMOTO代表鈴木GeminiはほぼGoogle SEOの延長で戦えます
Claude(明快な構造と一次情報を好む設計)
Claude(Anthropic)はWeb検索機能を備え、ClaudeBot(学習用)・Claude-SearchBot(検索用)・Claude-User(ユーザー起点)のクローラーを使い分けます。
Statcounterの集計では、ClaudeのAI参照流入シェアは2026年2月の1.37%から3月に2.91%へと1か月で倍増し、急成長プラットフォームとして注目されています。
最適化の要点は、論理的に整理された見出し構造・正確な一次情報・誇張のない記述です。誇大表現の少ない、検証に耐える文章ほど好まれる傾向があるため、事実ベースの記述が活きます。
Perplexity(出典明示型・送客に直結)
Perplexityは回答に出典・参照リンクを明示し、ユーザーをソースへ送客する設計が特徴です。被引用がそのまま流入につながりやすく、鮮度(更新頻度)と明確な出典提示が効きます。
利用者規模は、コア製品で月間約4,500万、エージェント製品を含めると月間1億超とされます(Pantoのデータ集計)。
独自インデックスに加えBingも併用するため、Bing露出も効きます。
Copilot(Microsoft・Bing基盤・Edge統合)
Microsoft CopilotはBing基盤でEdge・Windows・Microsoft 365と統合されています。
全サーフェスで約3,300万人が利用し、Microsoft 365 Copilotの有料シートは2026会計年度Q2時点で1,500万(前年比160%増)に達しました(XtendedViewの統計まとめ)。
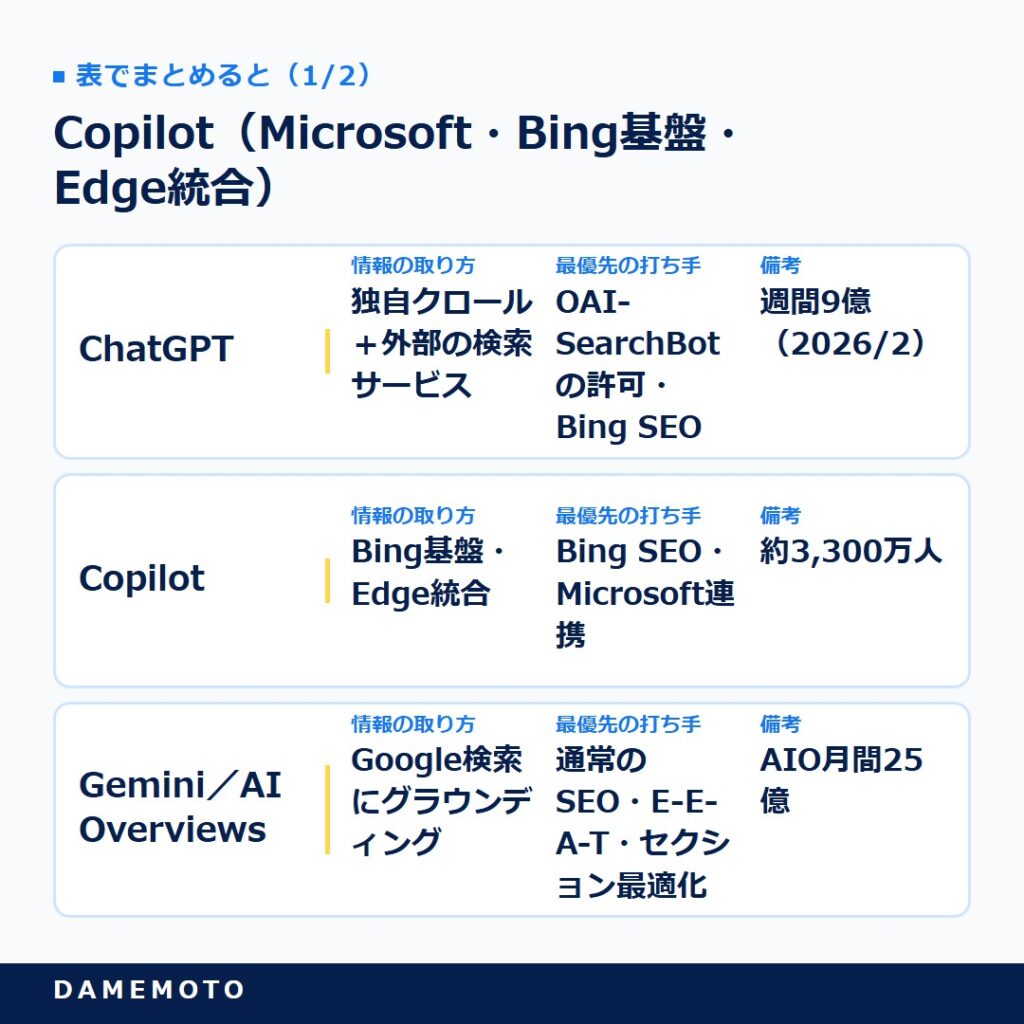
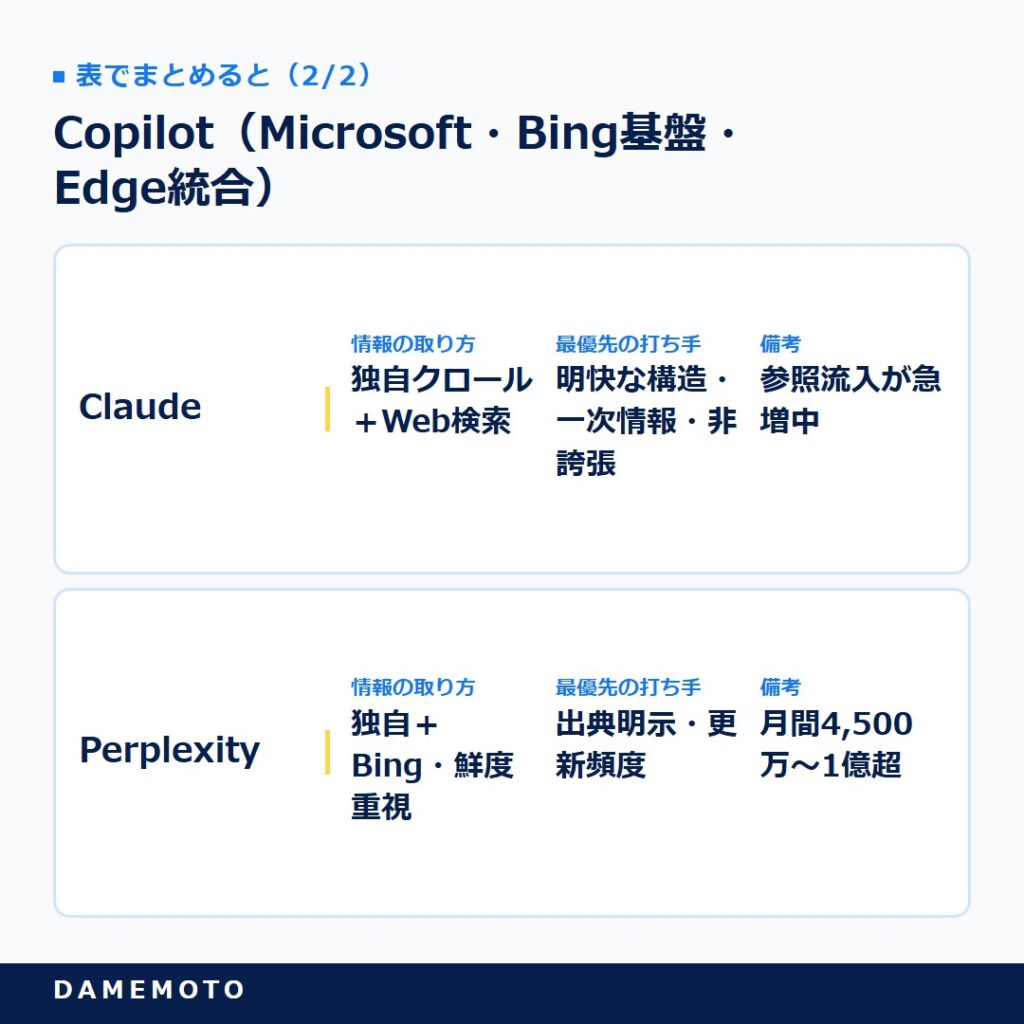
CopilotはBing基盤で、ChatGPTの検索提携先にもMicrosoftが含まれるため、Bing SEOがそのまま効きます。下表は「狙うAI」別の土台と最優先の打ち手をまとめた早見表です。
表で詳しく見る
| 狙うAI | 情報の取り方 | 最優先の打ち手 | 備考 |
|---|---|---|---|
| ChatGPT | 独自クロール+外部の検索サービス | OAI-SearchBotの許可・Bing SEO | 週間9億(2026/2) |
| Copilot | Bing基盤・Edge統合 | Bing SEO・Microsoft連携 | 約3,300万人 |
| Gemini/AI Overviews | Google検索にグラウンディング | 通常のSEO・E-E-A-T・セクション最適化 | AIO月間25億 |
| Claude | 独自クロール+Web検索 | 明快な構造・一次情報・非誇張 | 参照流入が急増中 |
| Perplexity | 独自+Bing・鮮度重視 | 出典明示・更新頻度 | 月間4,500万〜1億超 |
エンティティ最適化と構造化データ:AIに「何者か」を伝える
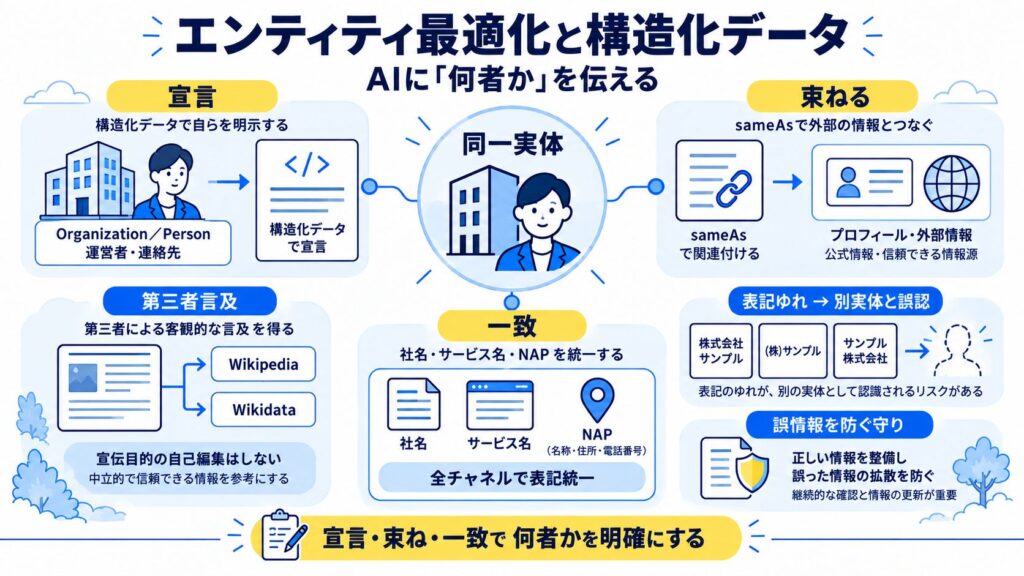
プラットフォーム横断で効く中核施策が、エンティティ最適化です。AIに「自社が特定可能な実体(エンティティ)である」と認識させることで、関連する質問で呼び出される確率が上がります。鍵は宣言・束ね・一致の3点です。
Organization/sameAsで実体を宣言する
まず、Schema.orgのOrganization(またはPerson)で組織・人物の情報を宣言し、sameAsプロパティで自社SNS・Wikipedia・各種プロフィールのURLを「同一実体」として束ねます。
ベイジは、Organization schema・sameAsでのSNSアカウント宣言・社名やサービス名の表記がブレない一貫性が揃えば、AIは「特定可能なエンティティ」として認識し、呼び出し確率が上がると整理しています。
運営者情報・連絡先・ロゴをOrganizationで明示することは、企業情報の誤認(ハルシネーション)を防ぐ守りの施策にもなります。
sameAsや名寄せの具体的な手順は、エンティティ最適化の実装チェックリストで3手順にまとめています。
Wikipedia/Wikidataとナレッジグラフ
WikipediaはAIの学習データで大きな重みを持ち、Wikidataはエンティティの「戸籍簿」のような役割を果たします。
両者に正確な情報が掲載され、Googleナレッジグラフに実体として登録されることは、エンティティ認識を一段強めます。
ただしWikipediaは独自の特筆性ガイドラインがあり、宣伝目的の自己編集は推奨されません。第三者言及を積み上げて自然に掲載される土壌を作る、という順序が現実的です。
NAP・表記の一貫性で「同一実体」を強化
社名・サービス名・住所・電話番号(NAP)・人名の表記が、自社サイトと外部ソースで揺れていると、AIは複数の別実体と誤認しかねません。
正式名称・英語表記・略称のルールを定め、全チャネルで統一します。
FAQPage・HowTo・Article・BreadcrumbList・VideoObjectなど、コンテンツの性質に応じた構造化データを併用すると、AIの文脈理解がさらに進みます。
なおGoogleは2026年5月にFAQリッチリザルトの表示サポートを終了しましたが、FAQ構造化データ自体はAIの意味解釈の手がかりとして引き続き有用とされます。
表記ゆれは「別人扱い」される原因です
AIクローラー制御とllms.txt:技術的な土台を整える
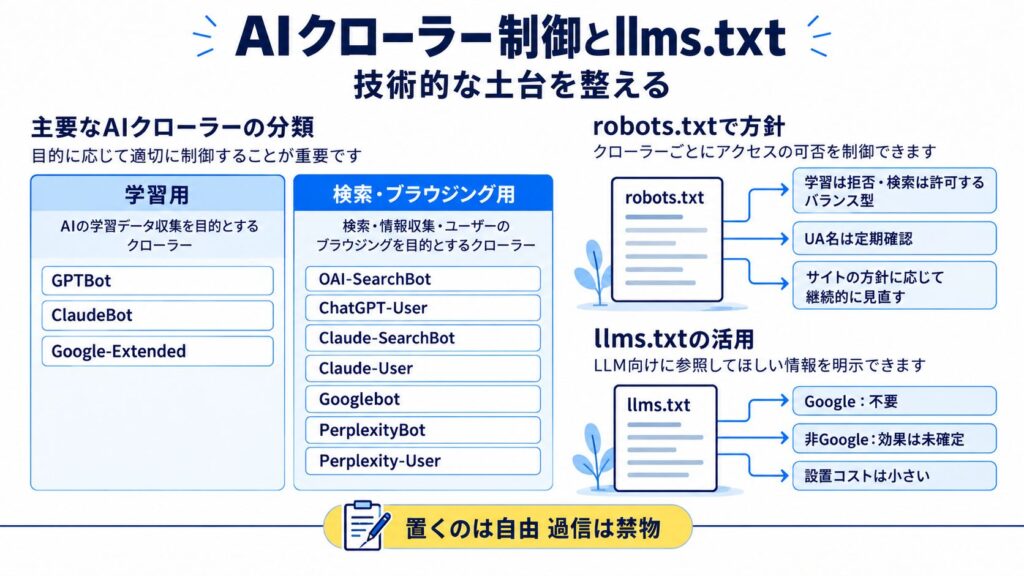
引用される前提として、AIにクロールを許可する設定が必要です。同時に、学習には使わせたくないが検索には出したい等の方針も技術で表現できます。
ここでは制御の考え方と、話題のllms.txtの実態を正直に整理します。ボットごとの記述例をそのまま使いたい方は、AIクローラー制御のrobots.txt記述例が役立つはずです。
robots.txtでボットを許可・拒否する
AIクローラーの制御はrobots.txtで行います。多くのブランドは「学習用クローラーは拒否しつつ、リアルタイム検索用クローラーは許可する」バランス型を採ります。
これにより、コンテンツの無断学習を抑えながらAI検索での可視性を保てます。
重要なのは、Gemini学習用のGoogle-Extendedをブロックしても通常のGooglebot検索(順位)には影響しないことです(Anagramのクローラー解説)。
UA名は変更されうるため、定期的な確認が前提です。
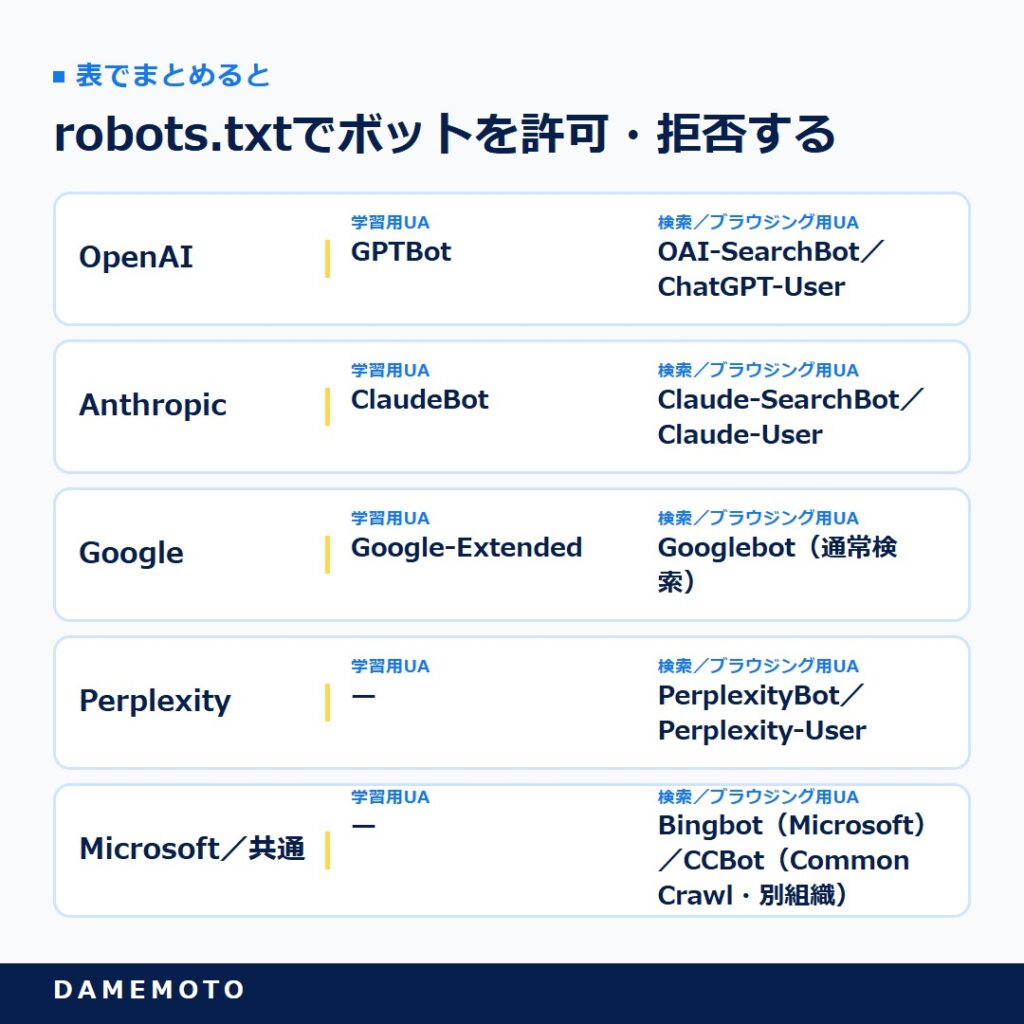
表で詳しく見る
| 運営者 | 学習用UA | 検索/ブラウジング用UA |
|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot/ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot/Claude-User |
| Google-Extended | Googlebot(通常検索) | |
| Perplexity | — | PerplexityBot/Perplexity-User |
| Microsoft/共通 | — | Bingbot(Microsoft)/CCBot(Common Crawl・別組織) |
llms.txtは「Google不要・非Googleは未確定」
llms.txtは、LLM向けにサイト構造や主要コンテンツを伝える提案中のファイルです。ここは特に正直に書きます。
Googleは公式に不要と明言しており、2025年7月にGary Illyes氏が「Googleは対応しておらず、その予定もない」と述べ、John Mueller氏は廃れたキーワードメタタグになぞらえました(Search Engine Journalの報道)。
非Google系LLMでの効果は未確定で、OpenAI・Anthropic・Meta・Mistralを含むどの主要LLMも、本番の検索・回答面でllms.txtを使うと公式表明していません。
実測も同じ方向を示します。
SE Rankingの30万ドメイン調査では設置率は約10.13%にとどまり、ある分析では5億件超のAIボット流入のうちllms.txtに直接アクセスしたのはごくわずかでした(Limyの5億件超ログ分析)。
設置コストは小さいため「将来に備えて短く置く」のは合理的ですが、「置けば引用が増える」は現時点で根拠が薄い、というのが2026年6月時点の誠実な結論です。
DAMEMOTO代表鈴木「置くのは自由、過信は禁物」が正解です
LLMO実装の5ステップと優先順位
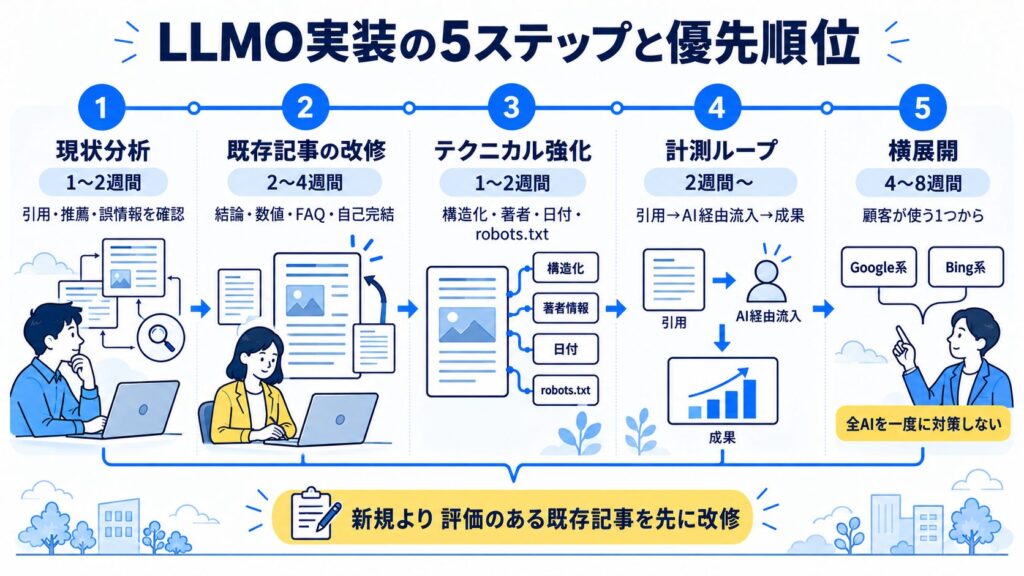
ここまでの知識を実装手順に落とします。5ステップで進めるのが現実的です。新規作成より既存改修が先という原則も、ここで明確にします。すでに評価のあるページのほうが引用されやすいためです。
Step1〜2:現状分析と既存記事の改修
Step1(1〜2週間)では、ChatGPT・Gemini・Perplexityで自社名や主要キーワードを検索し、現在の引用・推薦・言及の状況を把握します。
誤情報があればここで洗い出します。Step2(2〜4週間)では、アクセス上位の既存記事から順に、結論ファースト化・数値データ・FAQ・自己完結型回答ユニットを追加します。
新規作成より既存改修が先なのは、一定の評価があるページのほうがRAGで取得・引用されやすいからです。何から始めるかの判断は本記事冒頭の核心3点に戻って優先付けすると迷いません。
Step3〜4:テクニカル強化と計測ループ
Step3(1〜2週間)では、Organization・Article・FAQの構造化データ、著者情報、公開日・更新日のメタデータ、robots.txtのAIクローラー設定を整えます。
Step4(2週間〜)では計測ループを回します。「引用されたか」だけでなく「引用経由でコンバージョンに繋がったか」まで追うのが要点です。
GA4は2026年5月13日に「AI Assistant」チャネルを追加し、ChatGPT・Gemini・Deepseek・Copilot・Grokをネイティブ認識します(Claudeは公式リリースでも対象例として挙げられています。Perplexityは対象外と断定せず、実際の参照元・メディア・チャネルを確認します)。
Search Consoleも2026年6月3日に生成AIパフォーマンスレポートを追加しました(ただし表示回数のみでクリック・順位は出ません)。
計測ループに使うツール選びは、LLMOツールの選び方と効果測定ツール8種で目的別に比べています。
Step5:まず1つに集中して横展開する
Step5(4〜8週間)では、成功パターンを他プラットフォームへ横展開します。
全AIを一度に対策するのは非効率なので、顧客が最も使う1つ(多くの場合ChatGPTかGemini)に集中して効果を出すのが定石です。
コンテンツの質が上がれば、プラットフォームを跨いで効果が波及する傾向があります。
土台がBing系(Copilot、外部検索にMicrosoftも使うChatGPT)かGoogle系(Gemini/AI Overviews)かを見極め、まずどちらかを固めてから広げてください。
新規より既存改修が先
置き土産:LLMO実装チェックリストとプラットフォーム別早見表
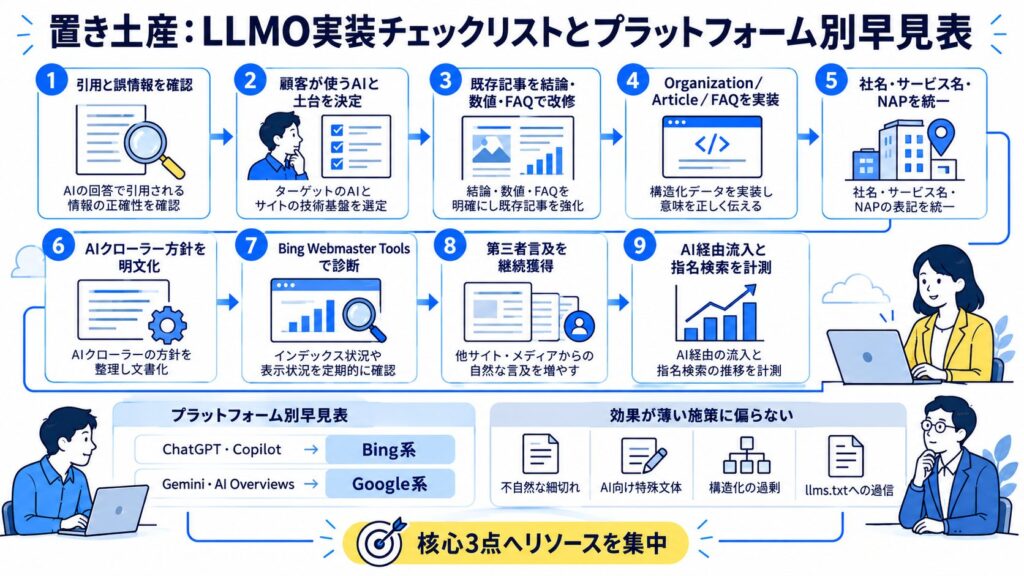
ここまでの全手法を、保存して使える実用物に落とし込みます。明日から着手する順番でチェックリスト化しました。上から順に潰せば、抜け漏れなくLLMOの土台が整います。
LLMO実装チェックリスト(保存版)
- 各AIで自社名・主要KWを検索し引用と誤情報を確認
- 顧客が最も使うAIを特定し土台(Bing or Google)を決定
- 上位記事に結論ファースト+数値+FAQ+自己完結ユニットを追加
- Organization/Article/FAQ構造化とsameAsを実装
- 社名・サービス名・NAPの表記を全チャネルで統一
- robots.txtでAIクローラーの許可・拒否方針を明文化
- Bing Webmaster Tools登録(Copilot対策・ChatGPTでは補助的な診断用)
- 第三者言及(メディア・比較・レビュー)の獲得を継続
- GA4「AI Assistant」と指名検索でAI経由の成果を計測
「やりがちだが効果が薄い」NG施策
逆に、もっともらしいが現時点で根拠の薄い施策も明示します。Google公式ガイドや前述の一次情報を踏まえると、次は慎重に扱うべきです。
コンテンツを不自然に細切れにする、AI向けの特殊な文体に書き換える、構造化データを過剰に詰め込む、llms.txtを置けば引用が増えると期待する——これらは「AIに効く」と語られがちですが、公式の方向性とは一致しません。
限られたリソースは、核心3点(事実密度・構造化の基礎・サイテーション)に集中させるのが合理的です。
llms.txtがGoogle検索に不要とされる理由は、llms.txtの書き方と設置判断で整理しています。
LLMOの費用相場・効果測定・失敗回避
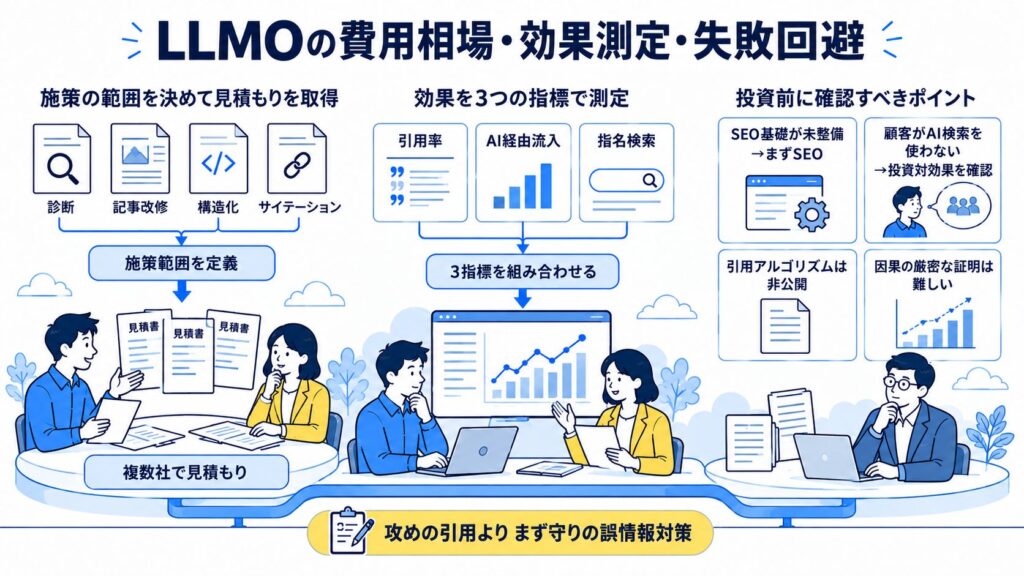
最後に、現実的な運用の話です。費用、測定、そしてつまずきやすいポイントをまとめます。費用は相場として報告される目安であり、施策範囲で大きく変動する点に留意してください。
費用相場と内製・外注の判断
LLMOの費用は、対象範囲(診断のみか、コンテンツ改修・構造化・サイテーション獲得まで含むか)で大きく変わります。
診断・初期調査を切り出すサービスや、SEO支援の延長で提供する会社が増えています。
具体的な料金は各社で揺れが大きいため、本記事では断定せず「施策範囲を定義してから複数社で見積もる」ことを推奨します。
効果測定は「引用率×AI経由流入×指名検索」
LLMOの効果測定は難しい領域です。AIの引用は完全には可視化できないため、複数の指標を組み合わせます。
具体的には、主要プロンプトでの引用・推薦の有無(手動またはツールで定点観測)、GA4のAI経由流入、指名検索ボリュームの推移の3つです。
指名検索は、AIで推奨されたユーザーが後日社名で検索する行動を捉えるため、LLMOのKPIに含める価値があります。
専用ツールはAKARUMI、ミエルカGEO、Profound、Otterly.AI、Peec AIなどがあり、機能・料金は2026年時点で各社確認が必要です(ミエルカGEOのリリース情報)。
正直コーナー:LLMOが不要・非推奨なケースと限界
すべての企業にLLMOを勧めるわけではありません。
正直に書くと、SEOの基礎(インデックス・E-E-A-T・最低限の技術健全性)が整っていない段階でLLMO専用施策に走るのは順序が逆で、まずSEOを固めるべきです。
また、ターゲット顧客がAI検索をほぼ使わない領域では、投資対効果が見合わないこともあります。本記事で「分からないこと」も明示します。
各AIの引用アルゴリズムは非公開で、効果の因果を厳密に証明することは困難です。
費用相場・利用者数・UA名・llms.txtの将来対応はいずれも流動的で、本記事の数値は出典時点の値です。
LLMOで最も過小評価されているのは「引用獲得」より「ハルシネーション対策」——AIが自社について語る古い・誤った情報を、正しい一次情報の整備で防ぐ守りだと考えています。
攻めの前に、まずこの守りから着手するのが堅実です。陥りやすいつまずき方の全体像は、LLMOの失敗パターンと回避セルフチェックで10項目に整理しています。
攻めの引用より、まず守りの誤情報対策
よくある質問
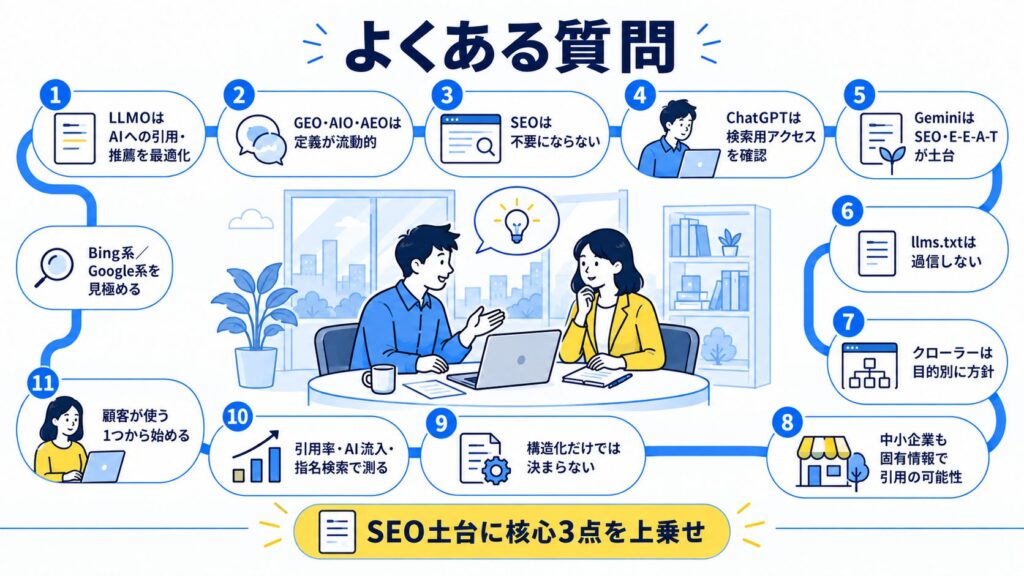
- LLMO対策とは何ですか?
-
ChatGPT・Gemini・Claude・Perplexity・CopilotなどのAIに自社を引用・推薦させる最適化です。SEOの土台に、事実密度・構造化・サイテーションを上乗せします。
- LLMOとGEO・AIO・AEOは何が違いますか?
-
ほぼ同じ概念を別の名前で呼んでいるのが実情で、定義は業界で確定していません。本記事は大規模言語モデル全般を対象とする最適化を広くLLMOと総称しています。
- LLMO対策をすればSEOは不要になりますか?
-
なりません。Googleは2026年5月の公式ガイドで「生成AI検索の最適化も本質はSEO」と明言しています。AIの引用材料の多くがインデックスやE-E-A-Tのため、SEO基盤がないと掲載されにくくなります。
- LLMOでChatGPTに引用されるには何が必要ですか?
-
Googleでの順位とChatGPTでの引用は別に確認します。OpenAIの公式案内に沿ってOAI-SearchBotと公開IPからのアクセスを確認し、実際の回答と参照流入を計測します。Bingの管理ツールは補助的な診断に利用できます。
- LLMO対策でGeminiの露出を増やすには?
-
GeminiはGoogle検索にグラウンディングするため、通常のSEOとE-E-A-Tがほぼそのまま効きます。長い記事でも単一のH2を引用できるので、セクション単位の最適化が有効です。
- LLMO対策としてllms.txtは設置すべきですか?
-
Googleは不要と明言し、非Google系LLMでの効果も未確定です。設置コストは小さいので将来に備えて短く置くのは合理的ですが、「置けば引用が増える」という期待は現時点で根拠が薄いです。
- LLMOのためにAIクローラーは全部許可すべきですか?
-
方針次第です。多くは学習用を拒否し検索用を許可するバランス型を採ります。Gemini学習用のGoogle-Extendedをブロックしても、通常のGoogle検索順位には影響しません。
- 中小企業でもLLMO対策でAIに引用されますか?
-
されます。AI検索は規模よりも専門性・独自性を比較的フラットに評価します。固有性の高い良質な情報を発信していれば、単独で引用される可能性があります。
- 構造化データを入れればLLMOの引用は増えますか?
-
前提条件としては重要ですが、単独の決め手ではありません。Ahrefsの2026年5月調査では、スキーマ追加だけではAI引用が明確に増えなかったと報告されています。事実密度と外部評価と組み合わせて効きます。
- LLMO対策の効果測定はどうすればいいですか?
-
引用率・AI経由流入・指名検索の3点を組み合わせます。GA4は2026年5月にAI Assistantチャネルを追加し、ChatGPT・Gemini・Deepseek・Copilot・Grokを認識します(Claudeも公式リリースの対象例です。Perplexityの分類は実データで確認します)。引用経由の売上まで追うのが理想です。
- LLMOでは複数AIを一度に対策すべきですか?
-
非効率です。顧客が最も使う1つに集中し、土台(Bing or Google)を固めてから横展開します。質が上がればプラットフォームを跨いで効果が波及します。
まとめ:LLMOは「SEO土台+事実密度・構造化・サイテーション」
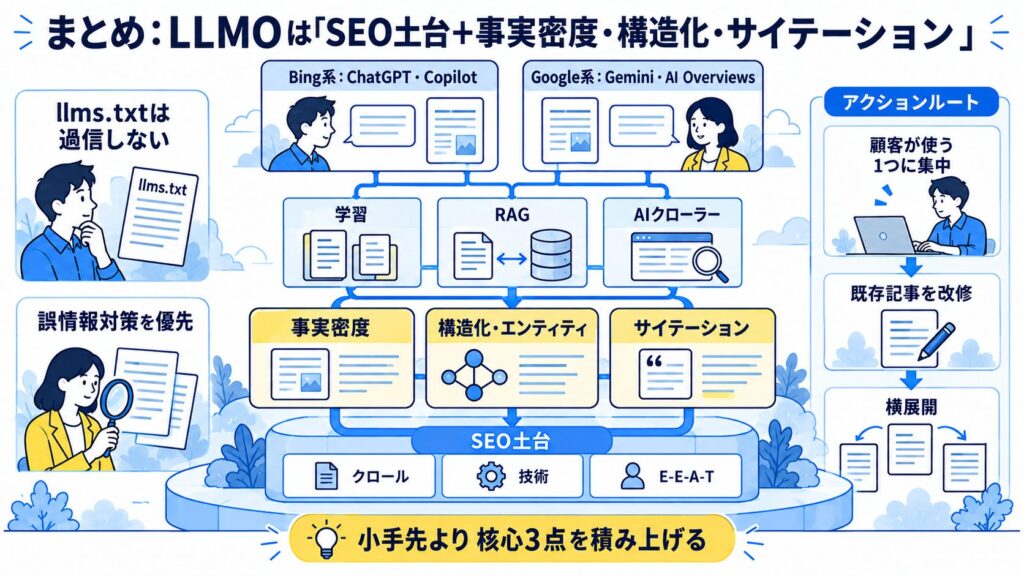
LLMO対策は、AIに引用・推薦させる全手法の総称です。定義はまだ流動的ですが、核心は変わりません。
事実密度の高いコンテンツ、構造化とエンティティ最適化、第三者からのサイテーション。この3点をSEO基盤に上乗せします。
LLMには学習・RAG・クローラーの3経路があり、CopilotはBing、Gemini/AI OverviewsはGoogleが土台です。
ChatGPTは自社のクローラーに加え、Microsoftなど外部の検索プロバイダーとも提携しています。
顧客が最も使う1つに集中し、既存記事を改修して横展開するのが、規模に関係なく勝てる王道です。
llms.txtや小手先のハックに走るより、まずは誤情報対策と核心3点に集中してください。
- 核心は事実密度・構造化・外部評価の3点
- プラットフォーム別に土台(Bing/Google)が違う
- 1つに集中して横展開・既存改修が先
- llms.txtは過信せず誤情報対策を優先
参考URL一覧
- Google検索セントラル・生成AI最適化ガイド(公式):https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=ja
- Google公式ブログ・Search I/O 2026 updates(公式):https://blog.google/products-and-platforms/products/search/search-io-2026/
- Ahrefs・AI Overviews reduce clicks(業界調査):https://ahrefs.com/blog/ai-overviews-reduce-clicks-update
- Search Engine Land・ChatGPT 900M weekly active users(大手メディア):https://searchengineland.com/chatgpt-900-million-weekly-active-users-470492
- Search Engine Journal・Google says llms.txt is speculative(大手メディア):https://www.searchenginejournal.com/google-says-llms-txt-is-purely-speculative-for-now/577576/
- MediaPost・Gemini overtakes Perplexity(Statcounterデータ報道):https://www.mediapost.com/publications/article/414030/gemini-overtakes-perplexity-becomes-no-2-bot-ref.html
- Botify・OpenAI tripled web crawl(業界分析):https://www.botify.com/blog/openai-tripled-web-crawl
- Limy・LLMs.txt in 2026 The Full Guide(業界分析):https://limy.ai/blog/llms.txt-in-2026-the-full-guide
- Anagram・AI Crawlers Explained 2026(業界解説):https://www.anagram.ai/blog/ai-crawlers-explained-gptbot-claudebot-perplexitybot-and-how-to-let-them-in-2026
- XtendedView・Microsoft Copilot Statistics 2026(業界統計):https://xtendedview.com/microsoft-copilot-statistics/
- Panto・Perplexity AI Statistics 2026(業界統計):https://www.getpanto.ai/blog/perplexity-ai-statistics
- ベイジ・ウェブを作る人のためのLLMO/AIO入門(支援会社):https://baigie.me/officialblog/2026/05/20/llmo
- S&Eパートナーズ・LLMOとは(支援会社):https://seo-best.jp/topics/web/aio/llmo
- シュワット・LLMO対策で実装すべき構造化データ一覧(支援会社):https://shwat.jp/ultra/marketing-aix/llmo-structured-data
- ミエルカGEO・リリース情報(ツール提供元):https://mieru-ca.com/blog/mieruca-geo
仕様・データの確認資料:Google:アナリティクスの新機能
補足参考資料