RAG(検索拡張生成)とは、AIが回答を作る前に外部情報を検索・取得し、その内容を根拠に回答を生成する仕組みで、LLMOにおける引用獲得の最大の経路です。
RAGは「検索→取得→拡張→生成」の流れで動き、Google AI Overviews・AIモード・ChatGPT検索・PerplexityはいずれもRAGで自社サイトを参照します。
LLMの古い知識や誤情報を補うのがRAGの役割です。
LLMOへの最大の示唆は、RAGで取得・選別・引用されやすいコンテンツ(信頼性が高く・構造が明確で・最新で・抜き出しやすい)を整えることが、引用獲得に直結する点。
ただし「取得されること」と「引用されること」は別物で、取得されても引用されないページが大多数だという調査もあります。
この記事の結論
RAG時代の引用は、取得されたうえで「選ばれる」設計が分かれ目だと考えています
今日からやること
- 各見出しの直下に結論を1〜2文で置く
- 主題の周辺質問まで1記事で答える
- 数字に出典と日付を添えて更新する
こんな人向け:AI検索の仕組みから引用対策を組み立てたいWeb担当の方数値の出典:Search Engine Land(AirOps調査、2026年3月)
RAGとは:AIが「検索しながら答える」仕組み
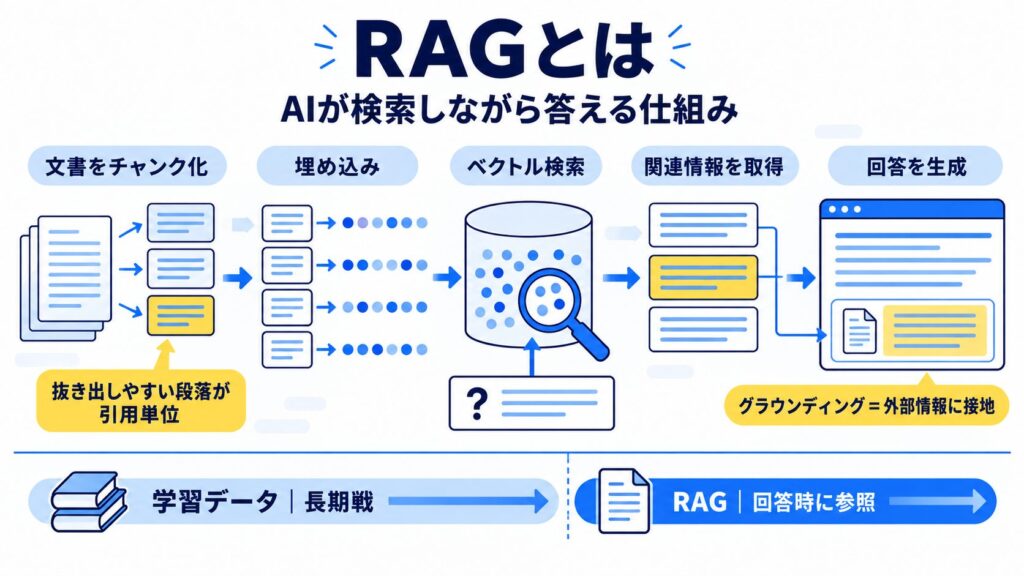
RAG(Retrieval-Augmented Generation:検索拡張生成)とは、AIが回答を生成する前に外部情報を検索・取得し、その内容を根拠に回答を作る仕組みです。
「検索(Retrieval)→取得→拡張(Augmented)→生成(Generation)」の流れで動きます。
LLMが学習済み知識だけで答えるのではなく、最新のWeb情報を参照して回答する点が特徴で、LLMOの引用獲得はこのRAG経路が中心になります。
RAGの基本ステップ:チャンク化・埋め込み・ベクトル検索・生成
RAGは検索→取得→拡張→生成という流れで動き、その内部では文書のチャンク化・ベクトル化・近傍検索が行われます。
技術的には、まず文書を段落やセクション単位の「チャンク(小片)」に分割し、各チャンクを意味を表す数値ベクトル(埋め込み)に変換してベクトルデータベースに格納します。
ユーザーの質問もベクトル化し、意味的に近いチャンクを高速に検索(近傍検索)して上位を取り出す。
最後に、取り出したチャンクをプロンプトに付加し、それを根拠にLLMが回答を生成します(IBMによるRAG解説)。
Web検索型のRAGでは、このチャンクが「検索インデックス上のページの一部(パッセージ)」に相当します。だから、ページ全体ではなく「抜き出しやすい段落」が引用の単位になるのです。
RAGの前提となるLLMの動き方は、LLMの仕組み4ステップで整理しています。
「グラウンディング」という別名と公式の説明
RAGは「グラウンディング(grounding)」とも呼ばれます。AIの回答を、検証可能な外部情報に「接地させる」という意味です。
Google検索セントラルの生成AI最適化ガイドも、生成AI機能は「コアの検索ランキングシステムを使って関連性が高く最新のWebページを取得」し、根拠となるページへの「目立つクリック可能なリンク」を伴って回答を合成すると説明し、これをグラウンディングと呼んでいます(Google検索セントラルの生成AI最適化ガイド)。
グラウンディングにより、AIは「学習データの記憶」だけでなく「リアルタイムの事実」に基づいて回答できます。RAGこそが、引用される側に回るための主戦場です。

「グラウンディング=接地」。回答を事実に足をつけさせる、というイメージです
学習データとRAGの違い:長期戦と短期戦
LLMが情報を得る経路は「学習データ」と「RAG」の2つに大別できます。学習データは事前学習時に取り込まれた情報で、定着には時間がかかり、モデルが更新されるまで反映されません。
対してRAGは回答時にリアルタイムで参照するため即効性があります。LLMOで早く効果を出したいなら、まずRAGで参照されるコンテンツ(最新・信頼性・構造化)を整えるのが近道です。
学習データへの定着は長期戦、RAGは短期戦。この使い分けを意識すると、施策の優先順位がはっきりします。
RAGの起源:2020年のNeurIPS論文
用語としての「Retrieval-Augmented Generation」は、2020年にPatrick Lewis氏らがMeta AI(当時Facebook AI Research)・UCL・NYUの共同で発表したNeurIPS論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」で提唱されました(Meta AIによるRAG解説)。
情報検索(密パッセージ検索)と生成(seq2seq)を組み合わせ、パラメータだけに頼る生成より具体的・多様・事実に即した出力が得られることを示しました。
今日のAI検索が当たり前のように「検索して答える」背景には、この5年あまりの技術的蓄積があります。歴史を知ると、なぜ各社が一斉にRAGへ寄せたかが腑に落ちます。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
RAGがハルシネーションを抑える仕組みと、その限界
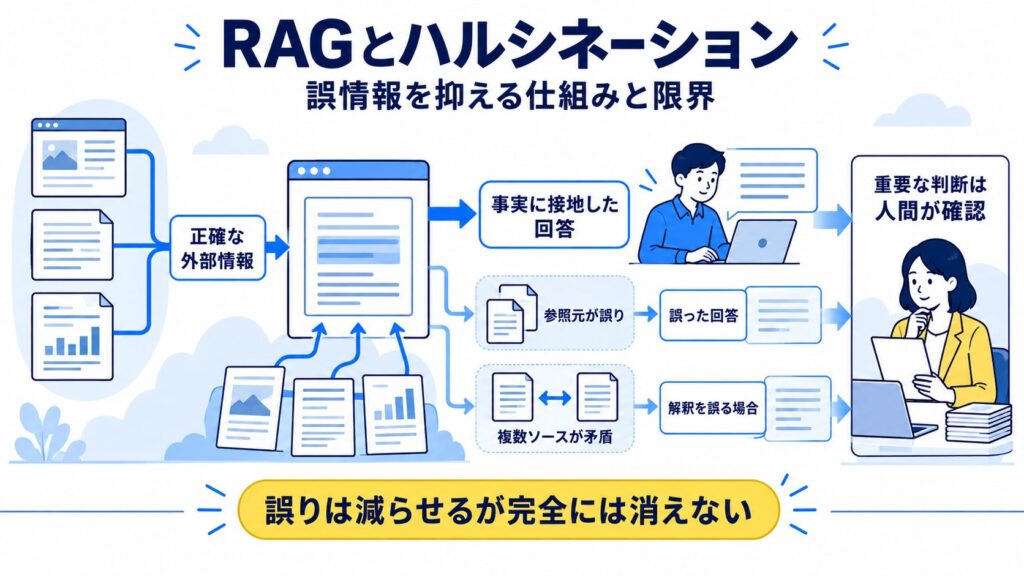
RAGの重要な役割の一つが、ハルシネーション(誤情報生成)の抑制です。LLMは確率的に次の単語を選ぶため、学習データに乏しい領域では誤った内容を自信を持って出力します。
RAGで外部の正確な情報を参照させることで、この誤りを減らせます。日本のIPAのガイドラインでも、RAGはハルシネーション対策の文脈で扱われています。
ただし万能ではなく、限界も正しく押さえる必要があります。
なぜRAGで誤情報が減るのか
LLM単体は学習時点の知識しか持たず、知らないことを「もっともらしく」作り出します。
RAGは回答前に最新の外部情報を取得し、それを根拠にするため、事実に接地した回答が生成されやすくなります。
IPA「テキスト生成AIの導入・運用ガイドライン」(2024年、同年7月更新)でも、RAGを企業導入する際の考慮事項やリスク管理が詳述され、ハルシネーションは「学習データに情報があっても確実に学習できるとは限らない」現象として整理されています(IPAのテキスト生成AI導入・運用ガイドライン)。
LLMOの観点では、自社の正確な一次情報がRAGで参照されれば、AIが自社について誤って語るのを防げます。これはハルシネーション対策という「守り」のLLMOです。
DAMEMOTO代表鈴木自社のことをAIに間違って語られない——これも立派なLLMOの効果です
RAGでも誤りは完全には消えない
RAGは万能ではありません。参照したページ自体が誤っていれば、AIも誤った回答をします。また、複数ソースの矛盾を統合する際に解釈を誤ることもあります。
だからこそ、自社の情報を正確かつ一貫した形で発信し、RAGで参照される情報源の質を高めることが重要です。
AIの出力は最終的に「参考情報」として扱い、重要な判断は人間が確認するのが基本。自社情報の正確性と一貫性が、巡り巡ってAIの回答精度を左右します。
自社情報を一貫して伝える方法は、エンティティ最適化の実装チェックリストもあわせて確認しておきたいところです。
正直なところ、RAGの理解はLLMOの「腑に落ち度」を一気に上げます。
なぜ最新性が効くのか、なぜ表示速度が引用に関わるのか——RAGがリアルタイムでWebを取りに行く仕組みだと分かれば、すべてが一本の線でつながる。
仕組みを知らずに施策リストを暗記するより、RAGを1つ理解したほうが、応用が効くと考えています。
RAGを知れば施策が腑に落ちる
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
クエリファンアウト:1つの質問が複数のクエリに分かれる
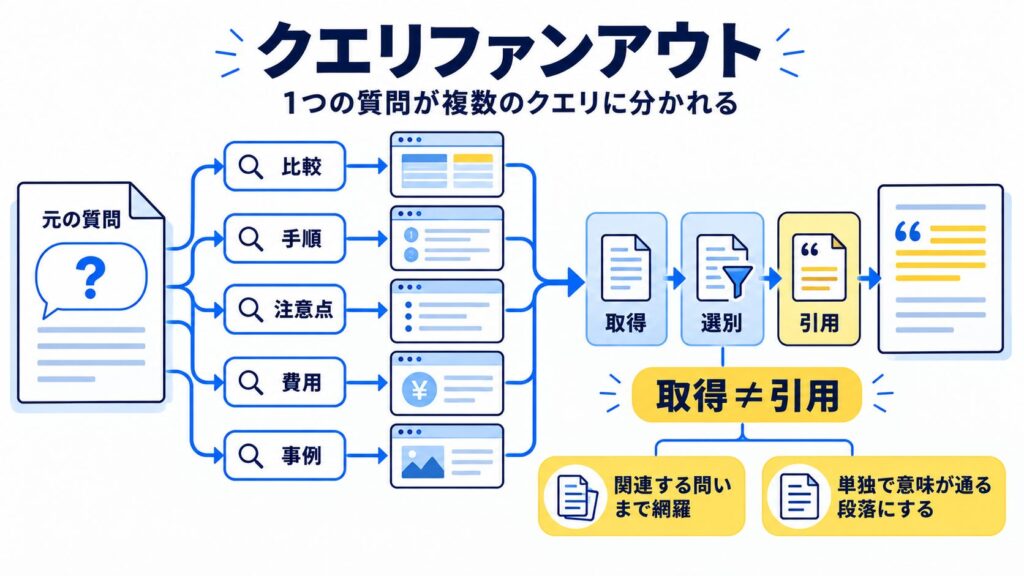
RAGを語るうえで欠かせないのが「クエリファンアウト(query fan-out)」です。
AI検索は、ユーザーの1つの質問をそのまま検索するのではなく、複数のサブクエリに分解して並行検索します。これがLLMOの戦い方を大きく変えます。
「狙ったキーワードで上位を取る」だけでは届かず、AIが裏で生成するサブクエリ群に答えられる網羅性が問われるのです。
クエリファンアウトとは何か(Google公式の説明)
クエリファンアウトは、1つの質問を複数のサブクエリへ展開し、Webやナレッジグラフなど多様なソースから並行して情報を集める情報検索の手法です。
Googleは公式に、AIモードがこの手法で質問をサブトピックに分解し、同時に多数のクエリを発行して通常検索より深くWebを探索すると説明しています。
さらにファンアウトは「パッセージ単位」の検索に焦点を当て、ページ全体ではなく特定の箇所を評価するとされます(Search Engine Landのクエリファンアウト解説)。
標準的な質問では8〜12のサブクエリを生成し、Deep Search的な深掘りでは数百に及ぶこともあるとされます。
ファンアウトを使う検索体験の中身は、Google AIモードの特徴とSEO対策を読むとつかみやすくなるはずです。
1問が8〜12問に分裂する。狙いKWだけ見ても勝てない理由はここです
取得≠引用:取得ページの大多数は引用されない
ここで決定的に重要なのが、「取得されること」と「引用されること」は別物だという事実です。
AirOpsが実施しALM Corp等が分析した調査では、ChatGPTが回答生成時に取得した548,534ページのうち、最終回答に引用されたのはわずか約15%でした(Search Engine Landが報じたChatGPTの取得・引用調査)。
つまり取得された85%は引用されずに捨てられており、「取得される」だけでは不十分で「選ばれる」設計が要るのです。
同調査では、15,000件の元プロンプトのうち89.6%が2つ以上のファンアウトクエリを誘発し、クエリ総数は43,233件へと約3倍に膨らみ、引用ページの32.9%は元の質問ではなくファンアウト経由だけで登場したと報告されています。
狙ったキーワードの周辺にある「関連する問い」に答えておくことが、引用率を押し上げます。
ファンアウトを踏まえたコンテンツ設計
ファンアウトと「取得≠引用」を踏まえると、コンテンツ設計の方向性が定まります。
第一に、メインの問いだけでなく、その周辺の関連質問(比較・手順・注意点・費用・事例など)を1記事ないしクラスター内で網羅すること。
第二に、各論点を「単独で抜き出しても意味が通る」パッセージとして書くこと。第三に、結論を冒頭に置き、AIが要約段階で拾いやすくすること。
これは小手先のテクニックではなく、ファンアウトという仕組みから逆算した必然です。
\ AI活用、何から始めればいいか迷ったら /
初回相談無料|「何を相談すればいいか分からない」段階でもお気軽にどうぞ
RAGがLLMOに与える4つの示唆
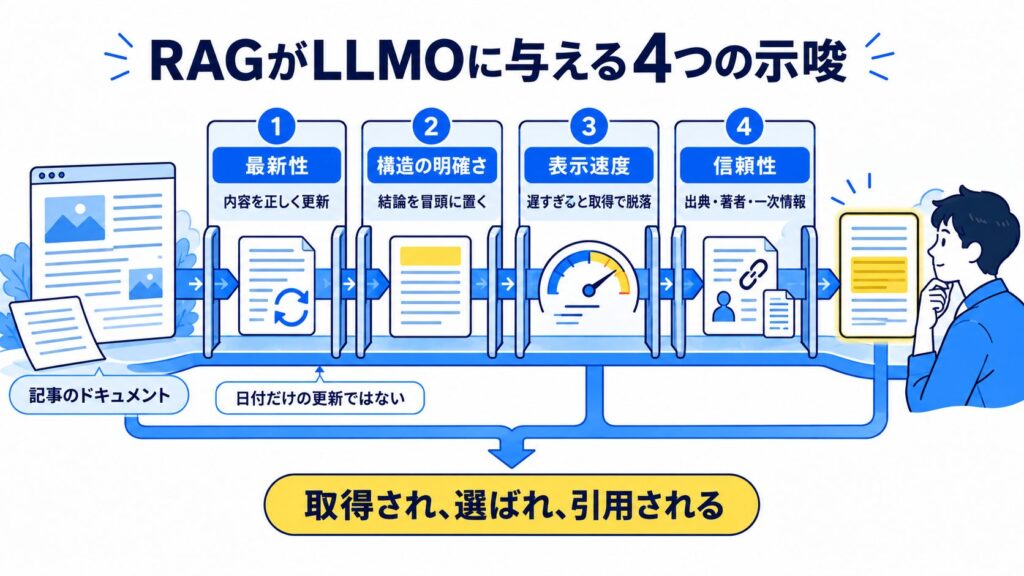
RAGの仕組みから、LLMOの施策は逆算できます。示唆は大きく4つ。
最新性が効く(RAGは新しい情報を優先取得)、構造の明確さが効く(要約段階で抽出しやすい)、信頼性が効く(信頼できるページを優先取得)、表示速度が効く(遅いページはタイムアウトでスキップ)。
これらはすべて、RAGの動作から導かれる必然です。順に見ていきます。
示唆1・2:最新性と構造の明確さ
RAGはリアルタイムで最新情報を取得するため、最新性が引用に直結します。情報の更新は、内容の変更や誤りの訂正があるときに行います。
AI引用に一律の有効期限や更新周期はなく、日付だけを新しくして引用増を期待しないでください。
また別の分析では、ChatGPT引用の約44%がコンテンツの最初の約3割の部分から来ているとされ、結論ファーストの重要性を裏づけます(Search Engine Landが報じたChatGPT引用位置の調査)。
古い情報や結論が後ろに埋もれた記事は取得・抽出されにくい。最新に保ち、答えを冒頭に置くことが、RAGで引用される前提条件です。
示唆3:表示速度(タイムアウトでスキップされる)
見落とされがちなのが表示速度です。
SEM Plusの解説によれば、RAGを使う生成AIはユーザーの質問に数秒以内で外部ページを取得・要約するため、バックエンドにフェッチタイムアウトを設けており、応答が一定時間内に返らないURLはスキップされ、回答内で引用されないとされます(SEM PlusのLLMO対策解説)。
極端に読み込みが遅いページは、内容が良くても取得段階で脱落しうるということです。ただし過度に身構える必要はありません。
Core Web Vitalsの合格目安(LCP2.5秒以内/INP200ms以内/CLS0.1以下)を満たし、体感的に遅くなければ特別な対応は不要です(web.devのCore Web Vitals解説)。
表示速度の改善手順は、Core Web Vitals改善マニュアルでまとめています。
DAMEMOTO代表鈴木速度は「速ければ加点」ではなく「遅すぎると脱落」。守りの指標です
示唆4:信頼性と一次情報が優先取得される
RAGは信頼できるページを優先的に取得・選別します。E-E-A-Tシグナル(著者情報・出典・運営者情報)が整ったページ、独自の一次情報を持つページが選ばれやすくなります。
「他では読めない一次情報」と「結論先出しの明確な構造」が、RAGで取得され、かつ引用される最大の条件です。
取得段階で候補に入り、選別・要約段階で残るには、信頼性と独自性の両方が要ります。前述のとおり取得された大多数は引用されないからこそ、ここで差がつきます。
RAGを踏まえたLLMO実装と効果測定
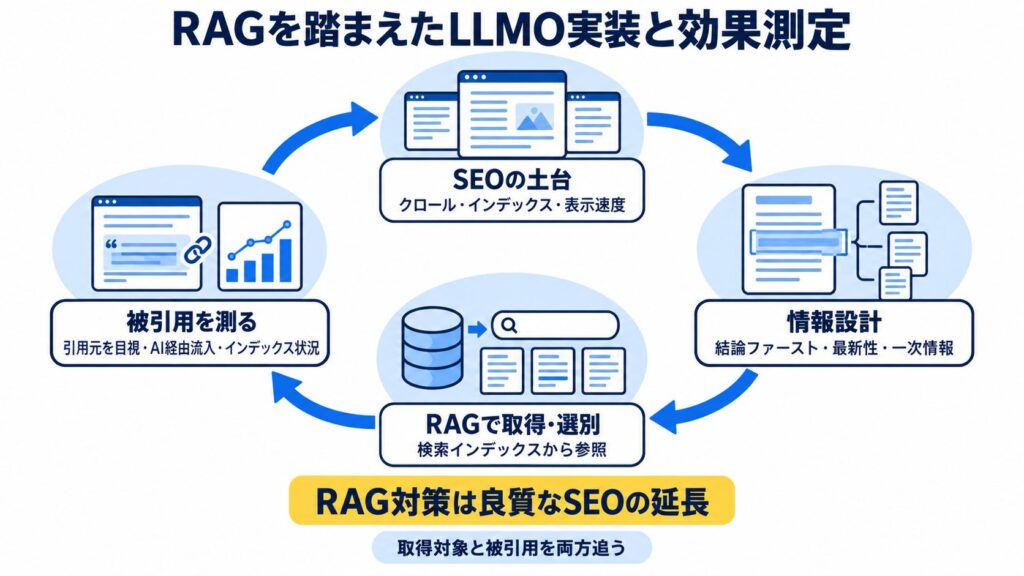
RAGを踏まえると、LLMO実装の優先順位が見えてきます。
SEOの土台(クロール・インデックス・表示速度)を整え、結論ファースト構造で答えを冒頭に置き、最新性を保ち、E-E-A-Tと一次情報を備える。
これらはすべて、RAGの動作に最適化された施策です。RAGはSEOで評価される良質なページを参照するため、SEOの土台がそのまま効きます。
実装の優先順位は、LLMO対策完全ガイドの実装チェックリストで一覧にしています。
SEOの土台がRAGに直結する
RAGはGoogleやBingの検索インデックスから情報を取得するため、SEOで評価される良質なページがそのままRAGで参照されます。
Google公式も「生成AI機能はコアの検索ランキング・品質システムに根ざしている」と明言し、AI専用ファイル(llms.txt等)・AI向けの細切れチャンク・AI専用の書き換え・特殊な構造化データはいずれも不要だとしています。
クロール可能性・インデックス・表示速度というSEOの土台がないサイトは、そもそもRAGの取得対象に入れません。RAG対策は、結局のところ良質なSEOの延長線上にあります。
RAG時代の被引用を測る
RAGで引用されているかは、各AIで主要クエリを実際に検索し、回答内の引用元を目視で確認するのが基本です。
RAGは引用元リンクを表示するため、自社が含まれているか、競合は載っているかを把握できます。加えてアクセス解析でAI経由の流入を計測し、引用率や指名検索の推移と組み合わせます。
「取得対象になっているか(インデックス状況)」と「要約に引用されているか(被引用)」の両方を追うのが、RAG時代の効果測定です。
前述のとおり取得≠引用なので、インデックスされているのに引用されない場合は、網羅性・鮮度・構造を見直します。
RAG対策は良質なSEOの延長
正直なところ:RAGを学んでも「特別な裏技」は出てこない
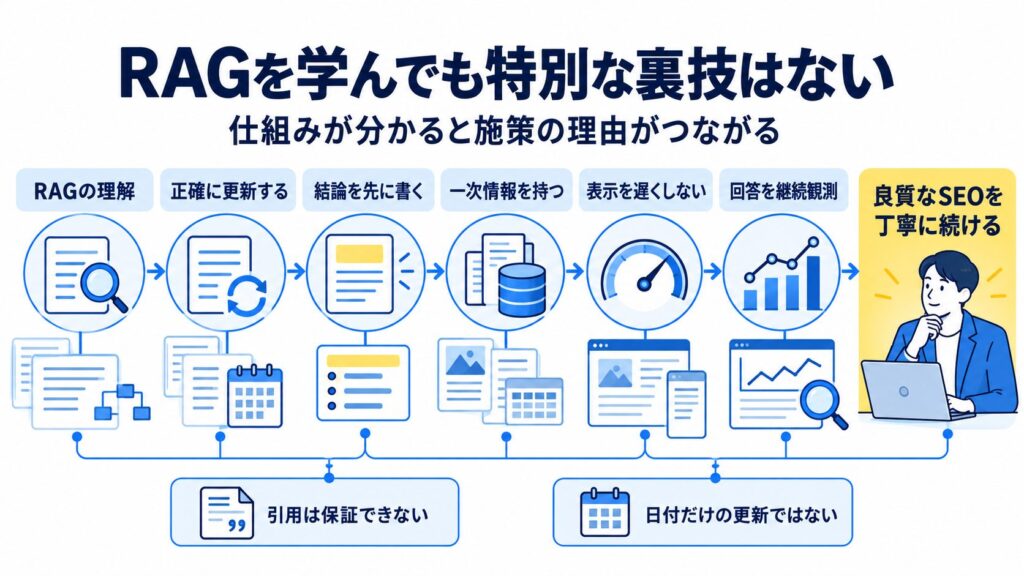
期待を裏切るようですが、正直に書きます。RAGの仕組みを深く理解しても、そこから出てくる結論は「良質なSEOを丁寧にやる」に収束します。
最新に保つ、結論を先に書く、一次情報を持つ、表示を遅くしない——どれも目新しい裏技ではありません。
RAGの知識は「なぜそれが効くのか」を腑に落とすためのもので、魔法のショートカットを与えてはくれない。ここは正直にお伝えしておきます。
また、この記事で扱えていないこともあります。情報の更新は、内容の変更や誤りの訂正があるときに行います。
AI引用に一律の有効期限や更新周期はなく、日付だけを新しくして引用増を期待しないでください。プラットフォームやクエリ、時期で挙動は変わり、再現性は保証されません。
引用先の選定はAIサービス側が行うため、掲載を保証することはできません。内容の正確さと取得可能性を整え、回答を継続観測します。
DAMEMOTO代表鈴木裏技はありません。でも「なぜ効くか」が分かると、迷いが消えます
置き土産:RAGの段階別「効く対策」対応表
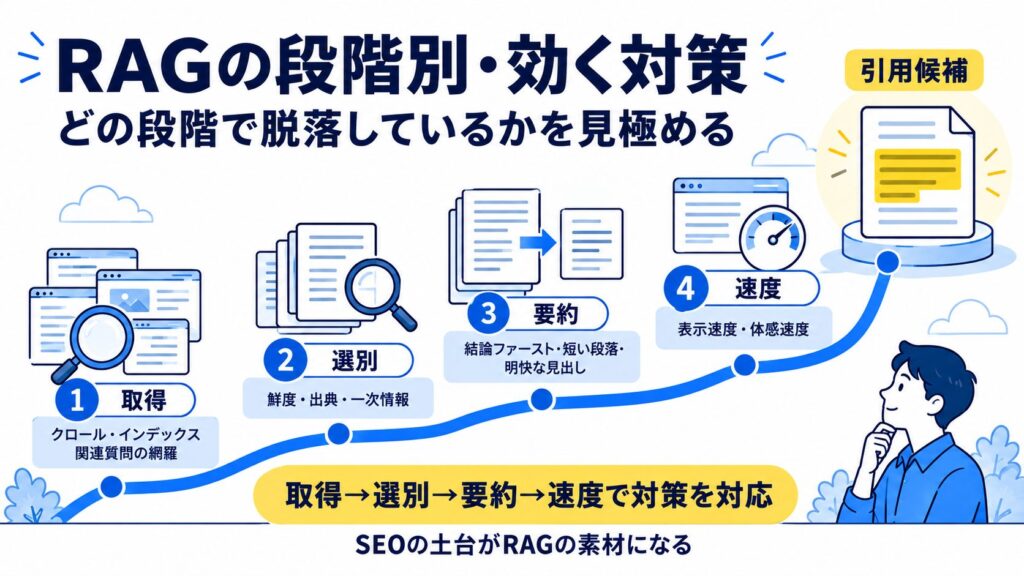
RAG(検索しながら答える仕組み)を理解すると、なぜAIが“古い記事”と“曖昧な記事”を嫌うかが腑に落ちます。
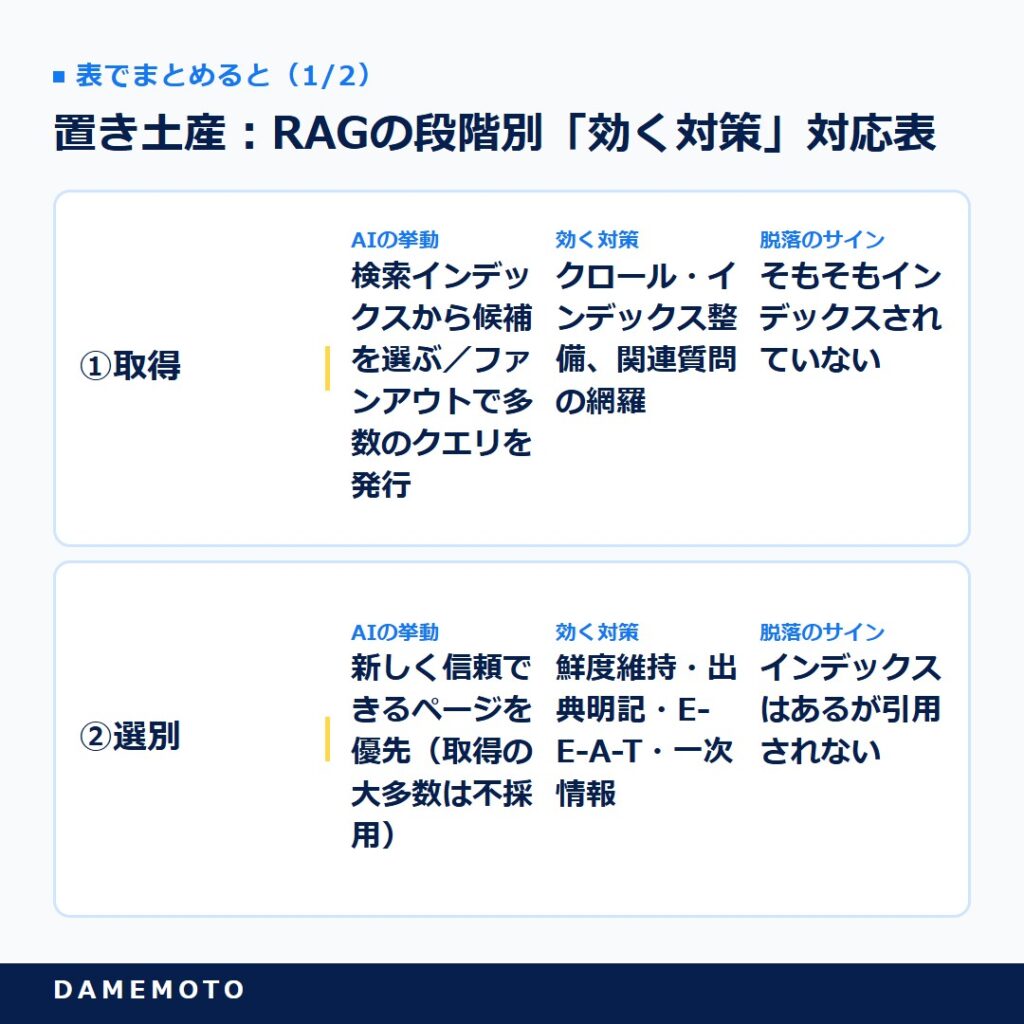
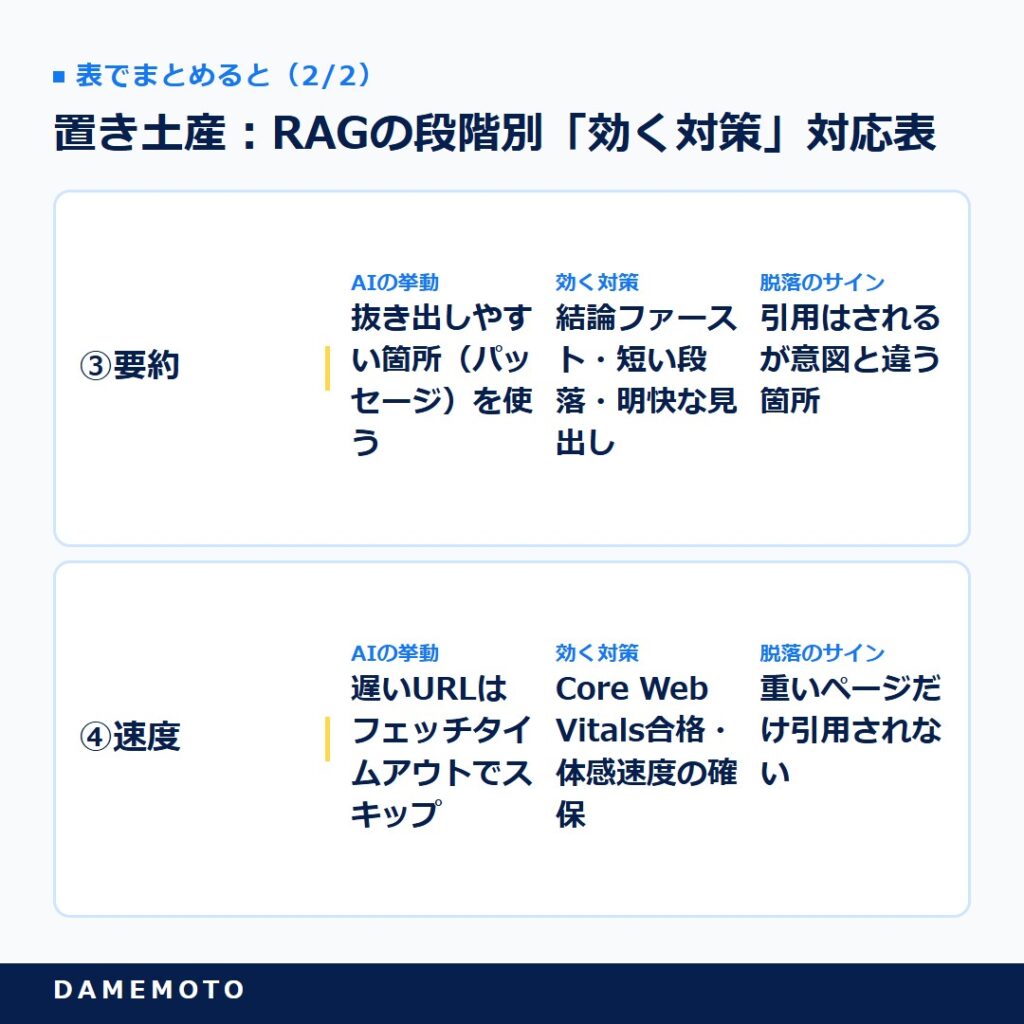
RAGは回答のたびに外部ページを取得・選別・要約するため、各段階で「効く対策」が違う。下表は、RAGの各段階・AIの挙動・打ち手を独自に対応づけた早見表です。
施策に迷ったら、自社のコンテンツがどの段階で脱落しているかをこの表で当ててみてください。保存して、改善の地図として使えます。
表で詳しく見る
| RAGの段階 | AIの挙動 | 効く対策 | 脱落のサイン |
|---|---|---|---|
| ①取得 | 検索インデックスから候補を選ぶ/ファンアウトで多数のクエリを発行 | クロール・インデックス整備、関連質問の網羅 | そもそもインデックスされていない |
| ②選別 | 新しく信頼できるページを優先(取得の大多数は不採用) | 鮮度維持・出典明記・E-E-A-T・一次情報 | インデックスはあるが引用されない |
| ③要約 | 抜き出しやすい箇所(パッセージ)を使う | 結論ファースト・短い段落・明快な見出し | 引用はされるが意図と違う箇所 |
| ④速度 | 遅いURLはフェッチタイムアウトでスキップ | Core Web Vitals合格・体感速度の確保 | 重いページだけ引用されない |
見落としがちなのは、RAGを「難しい技術」として知識のまま終わらせること。
RAGが「取得→選別→要約(+速度の足切り)」だと分かれば、対策は「①インデックスされる②鮮度と信頼性で選ばれる③抜き出しやすく書く④遅くしない」に集約できます。
SEOで評価される良質なページがそのままRAGの素材になる——だからLLMOはSEOの土台の上に成り立つのです。仕組みの理解が、小手先でない本質的な対策につながります。
よくある質問
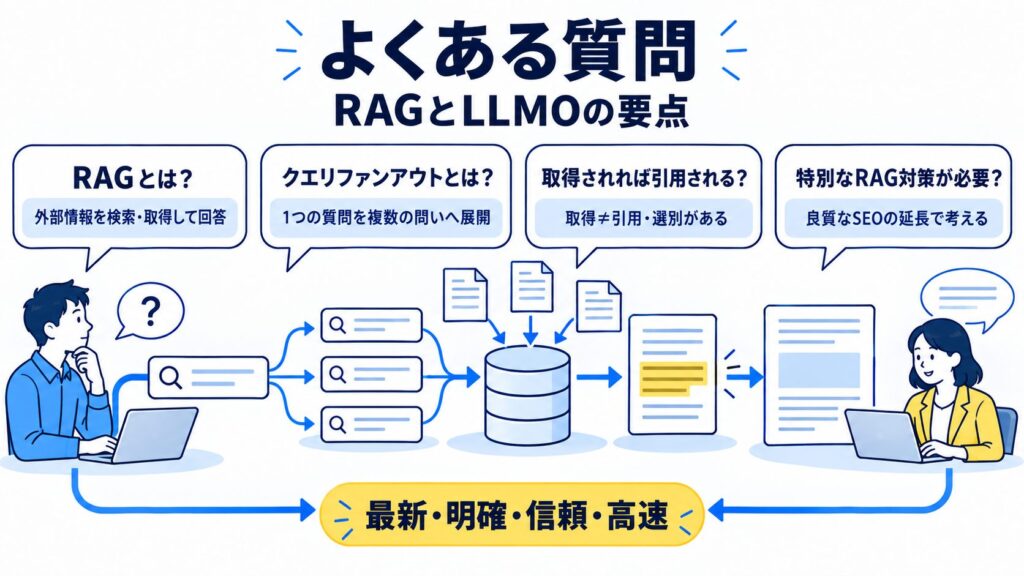
- RAGとは何ですか?
-
検索拡張生成の略で、AIが回答時に外部情報を検索・取得し、それを根拠に回答を生成する仕組みです。グラウンディングとも呼ばれます。
- RAGはどのAIが使っていますか?
-
Google AI Overviews・AIモード・ChatGPT検索・Perplexityなど主要AI検索が採用しています。Google公式も生成AI機能がRAGとクエリファンアウトに基づくと明言しています。
- RAGのクエリファンアウトとは何ですか?
-
1つの質問を複数のサブクエリに分解して並行検索する手法です。標準的な質問で8〜12のサブクエリを生成するとされ、狙ったキーワードの周辺質問への網羅性が引用率を左右します。
- RAGで取得されれば引用されますか?
-
いいえ。ある調査ではChatGPTが取得した548,534ページのうち引用は約15%でした。取得は前提条件にすぎず、鮮度・信頼性・構造で「選ばれる」設計が別途必要です。
- RAGでハルシネーションは防げますか?
-
抑制できますが完全には防げません。外部の正確な情報を参照させると誤りは減りますが、参照ページ自体が誤っていれば誤答もあり得ます。IPAのガイドラインでも対策の文脈で扱われています。
- 表示速度はRAGでの引用に影響しますか?
-
します。RAGはフェッチタイムアウトを設けるため、極端に遅いページはスキップされ引用されません。ただしCore Web Vitalsを満たし体感的に遅くなければ問題ありません。
- RAGで最新性がなぜ重要なのですか?
-
RAGがリアルタイムで新しい情報を取得するためです。情報の更新は、内容の変更や誤りの訂正があるときに行います。AI引用に一律の有効期限や更新周期はなく、日付だけを新しくして引用増を期待しないでください。
- 学習データとRAGはどちらが効きますか?
-
即効性ならRAGです。学習データは定着に時間がかかりモデル更新まで反映されません。早く引用を得たいなら、まずRAGで参照されるコンテンツを整えるのが近道です。
- RAG対策に特別なことは必要ですか?
-
不要です。RAGはSEOで評価される良質なページを参照します。SEOの土台+結論ファースト+最新性+一次情報+関連質問の網羅で十分で、AI専用ファイルや特殊schemaは不要だとGoogleも明言しています。
まとめ:RAGは引用の最大経路、SEOの土台が効く
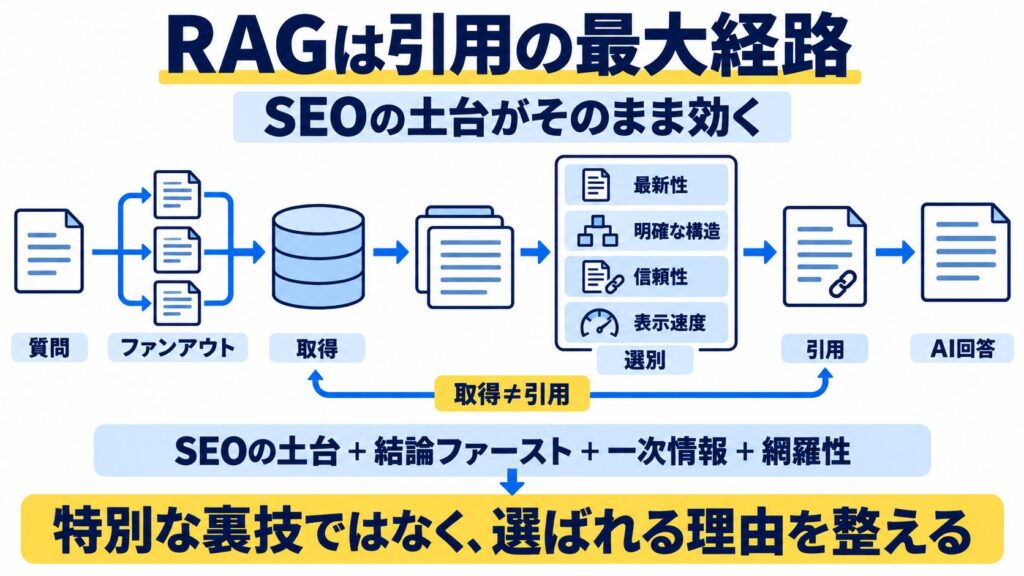
RAGは、AIが検索しながら答える仕組みで、LLMOの引用獲得の最大経路です。最新性・構造の明確さ・信頼性・表示速度という4つの示唆は、すべてRAGの動作から導かれます。
さらにクエリファンアウトと「取得≠引用」という事実から、狙ったキーワードの周辺質問まで網羅し、各論点を抜き出しやすいパッセージとして書くことが重要だと分かります。
RAGはSEOで評価される良質なページを参照するため、SEOの土台+結論ファースト+一次情報+網羅性を整えることが、RAG時代に引用される王道です。
特別な裏技はありませんが、仕組みの理解が、迷わない施策設計につながります。
- RAGは引用の最大経路
- 取得≠引用、網羅性で差がつく
- SEOの土台がそのまま効く
参考URL一覧
- Google検索セントラル・生成AI機能向け最適化ガイド(グラウンディング・RAG・ファンアウト):https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=ja
- IBM・What is Retrieval-Augmented Generation (RAG)(チャンク化・埋め込み・検索):https://www.ibm.com/think/topics/retrieval-augmented-generation
- Meta AI・Retrieval Augmented Generation(RAGの起源・2020年論文):https://ai.meta.com/blog/retrieval-augmented-generation-streamlining-the-creation-of-intelligent-natural-language-processing-models/
- Search Engine Land・クエリファンアウト解説:https://searchengineland.com/guide/query-fan-out
- Search Engine Land・ChatGPT取得ページの15%のみ引用(取得≠引用):https://searchengineland.com/chatgpt-retrieved-vs-citations-study-471606
- Ahrefs・ChatGPT被引用上位ページの調査(76.4%が30日以内更新):https://ahrefs.com/blog/chatgpts-most-cited-pages
- Search Engine Land・ChatGPT引用位置の調査(約44%が冒頭部から):https://searchengineland.com/chatgpt-citations-content-study-469483
- IPA・テキスト生成AIの導入・運用ガイドライン(RAG・ハルシネーション):https://www.ipa.go.jp/jinzai/ics/core_human_resource/final_project/2024/generative-ai-guideline.html
- web.dev・Core Web Vitals(表示速度の合格目安):https://web.dev/articles/vitals?hl=ja
- SEM Plus・LLMOとは(フェッチタイムアウトとスキップ):https://white-link.com/sem-plus/llmo